

In der sich ständig weiterentwickelnden Landschaft der Large Language Models (LLMs) wird das Bereitstellungsmuster „ein Modell pro Maschine“ zu einem erheblichen Engpass für die Kosteneffizienz der LLM Bereitstellung in Unternehmen. LLMs erfordern oft erhebliche Hardware-Reservierungen, z. B. vollständige 8x H100-GPU Knoten, um Spitzenlasten zu bewältigen. Im Standardbetrieb sind diese teuren Ressourcen jedoch oft unterlastet, was zu hohen Gesamtbetriebskosten führt.
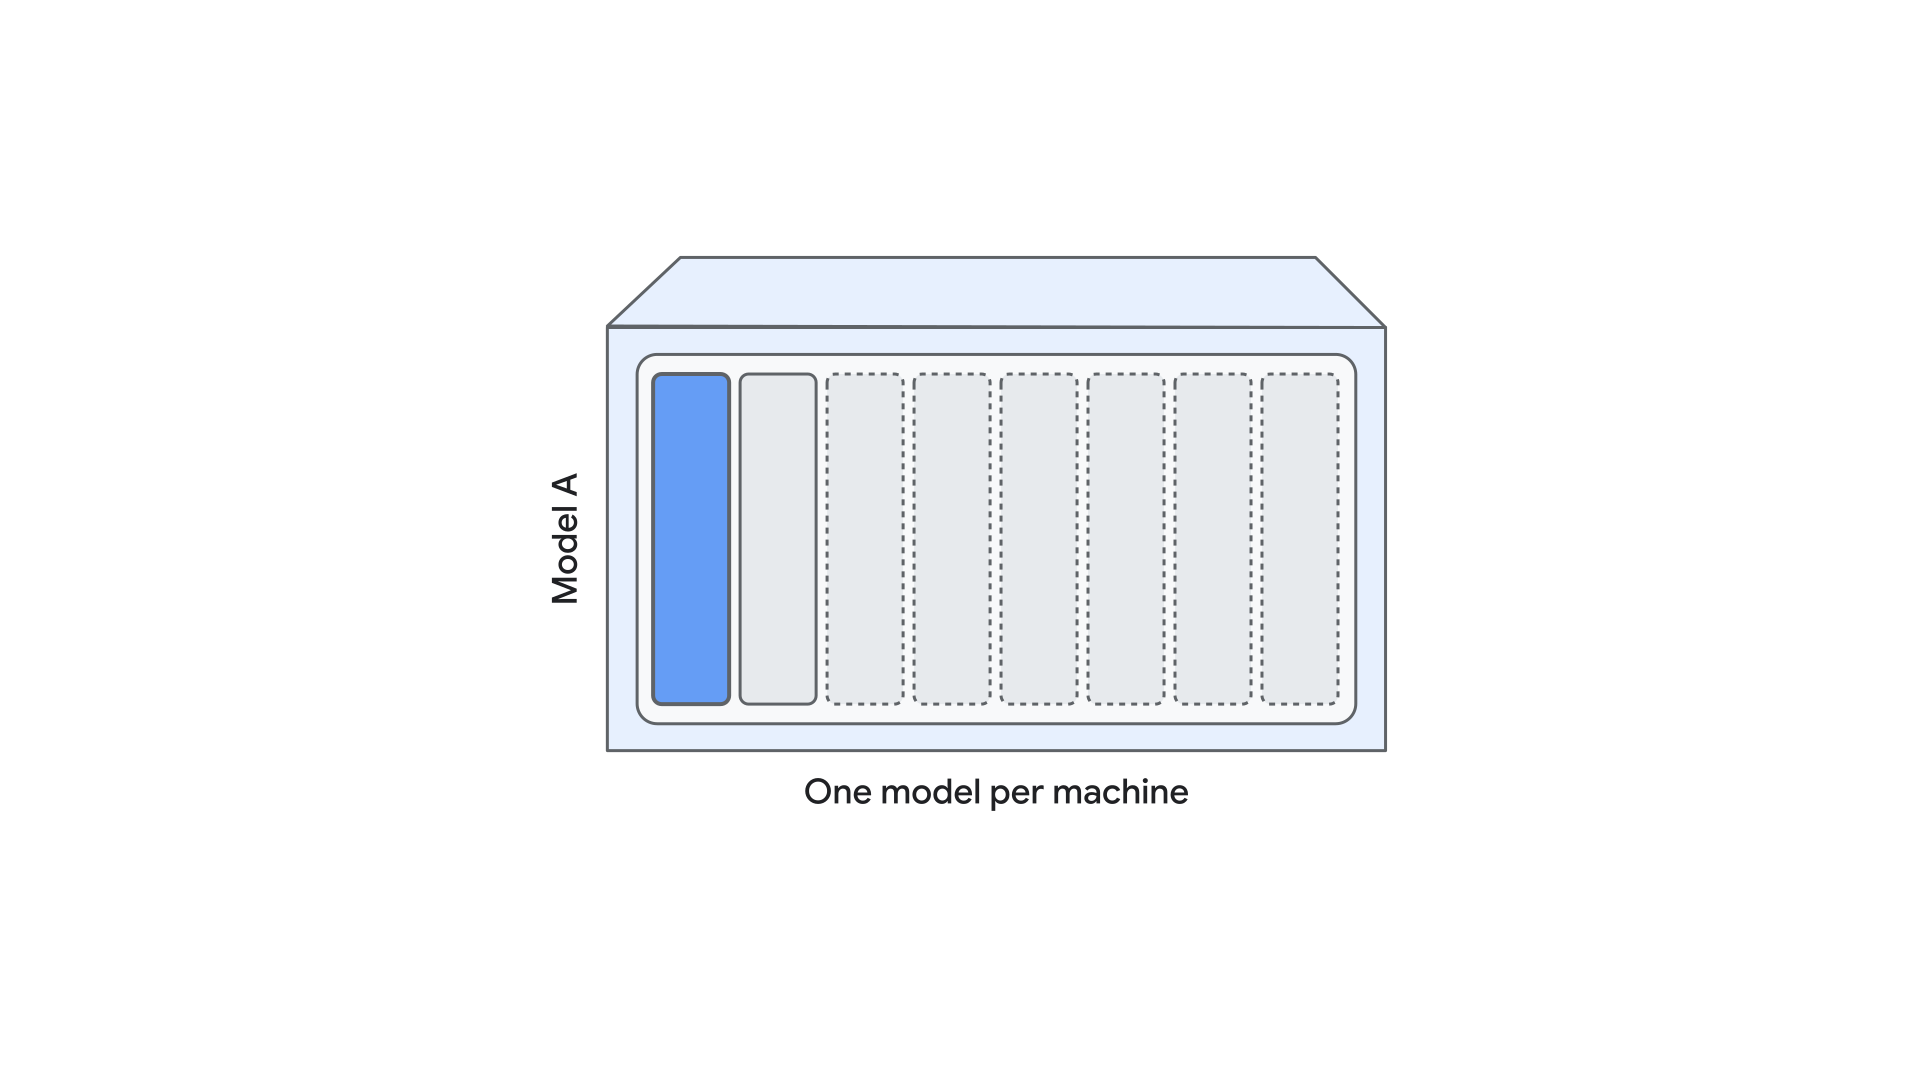
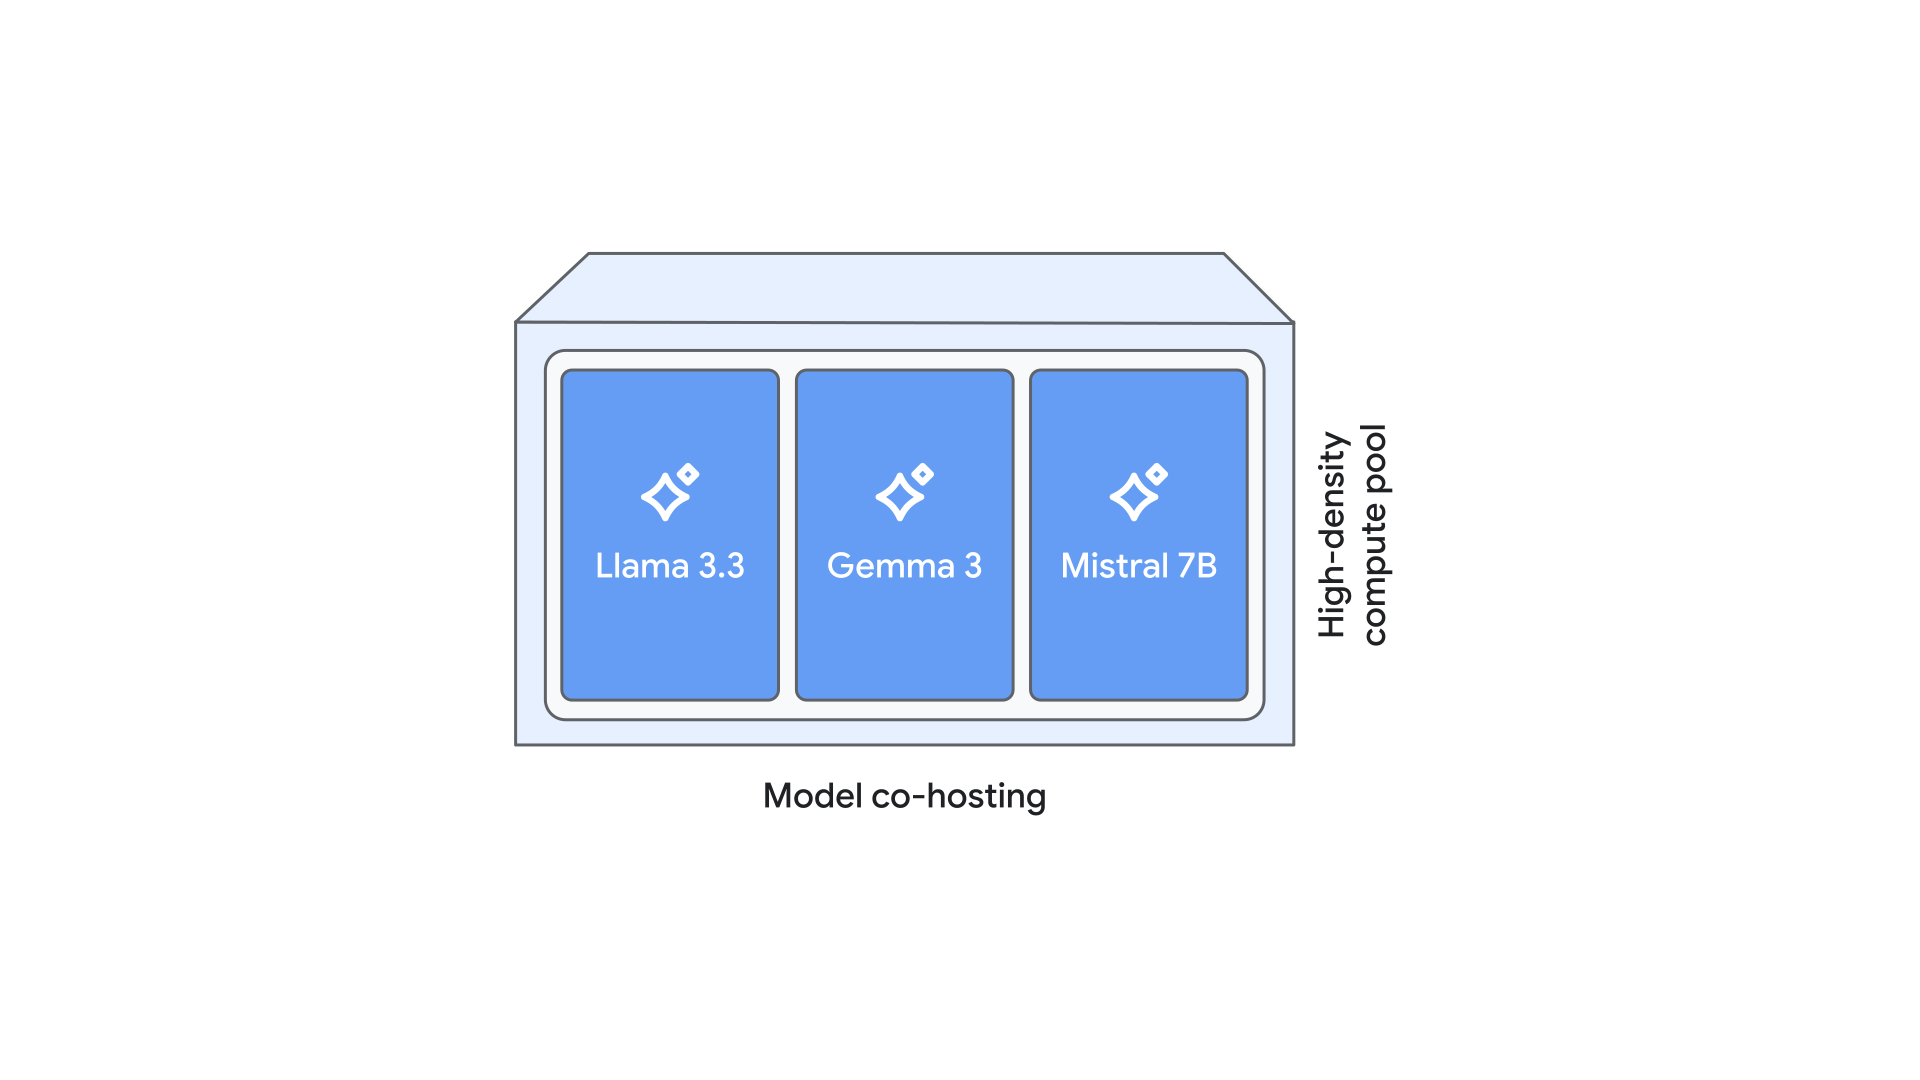
Modell-Co-Hosting schließt diese Effizienzlücke, indem es mehreren Modellinstanzen ermöglicht, dieselbe virtuelle Maschine und dieselben GPU-Ressourcen gemeinsam zu nutzen. Dazu gehören auch völlig unterschiedliche Modelle wie Llama 3.3 und Gemma 3. Durch die Nutzung von GPU-Arbeitsspeicher Slicing und intelligenter Ressourcenpartitionierung wandelt Vertex AI Model Garden statische Hardware-Reservierungen in flexible, hochdichte Computing-Pools um.
In diesem technischen Blog wird der Prozess von Vertex AI Engineering beschrieben, mit dem Modell-Co-Hosting zu einem produktionsreifen Clouddienst gemacht wird. Wir stellen unsere Methodik für unsere Implementierungsstrategien auf Containerebene vor, ermitteln optimale Bereitstellungskonfigurationen und präsentieren wichtige Ergebnisse aus unserer umfangreichen Benchmark-Studie für mehrere Modelle, damit Sie die Kosteneffizienz Ihrer LLM-Bereitstellung maximieren können.
Modell-Co-Hosting: Konzept und Architektur
Modell-Co-Hosting ist eine Bereitstellungsstrategie mit hoher Dichte, die es mehreren Large Language Model-Instanzen (LLM) oder verschiedenen Modellarchitekturen ermöglicht, dieselben physischen Hardware-Ressourcen innerhalb einer einzelnen virtuellen Maschine (VM) gemeinsam zu nutzen. Im Gegensatz zu herkömmlichen Bereitstellungsmodellen, bei denen eine vollständige VM oder GPU einem einzelnen Modell zugewiesen wird, nutzt Co-Hosting eine granulare Ressourcenpartitionierung, um den ROI der Hardware zu maximieren und die Auslastung von Arbeitsspeicher- und Rechenressourcen zu verbessern.
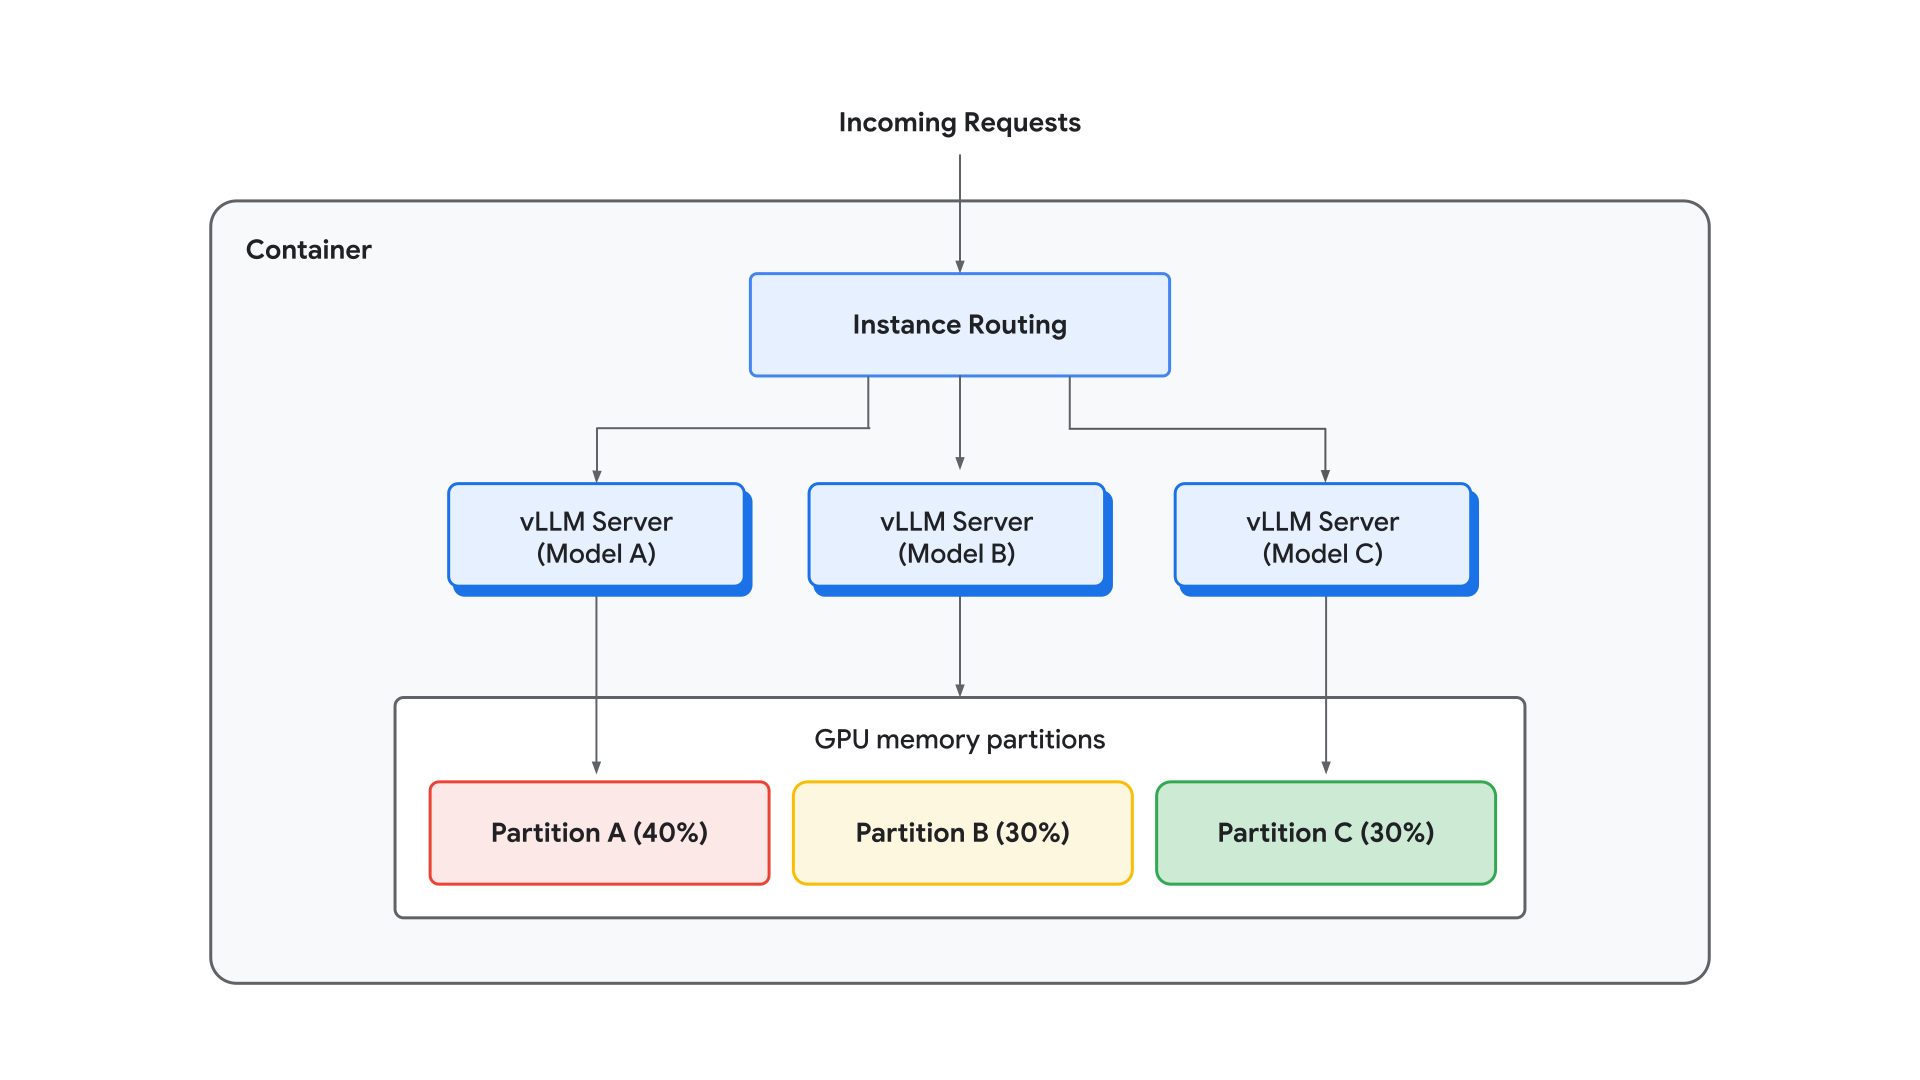
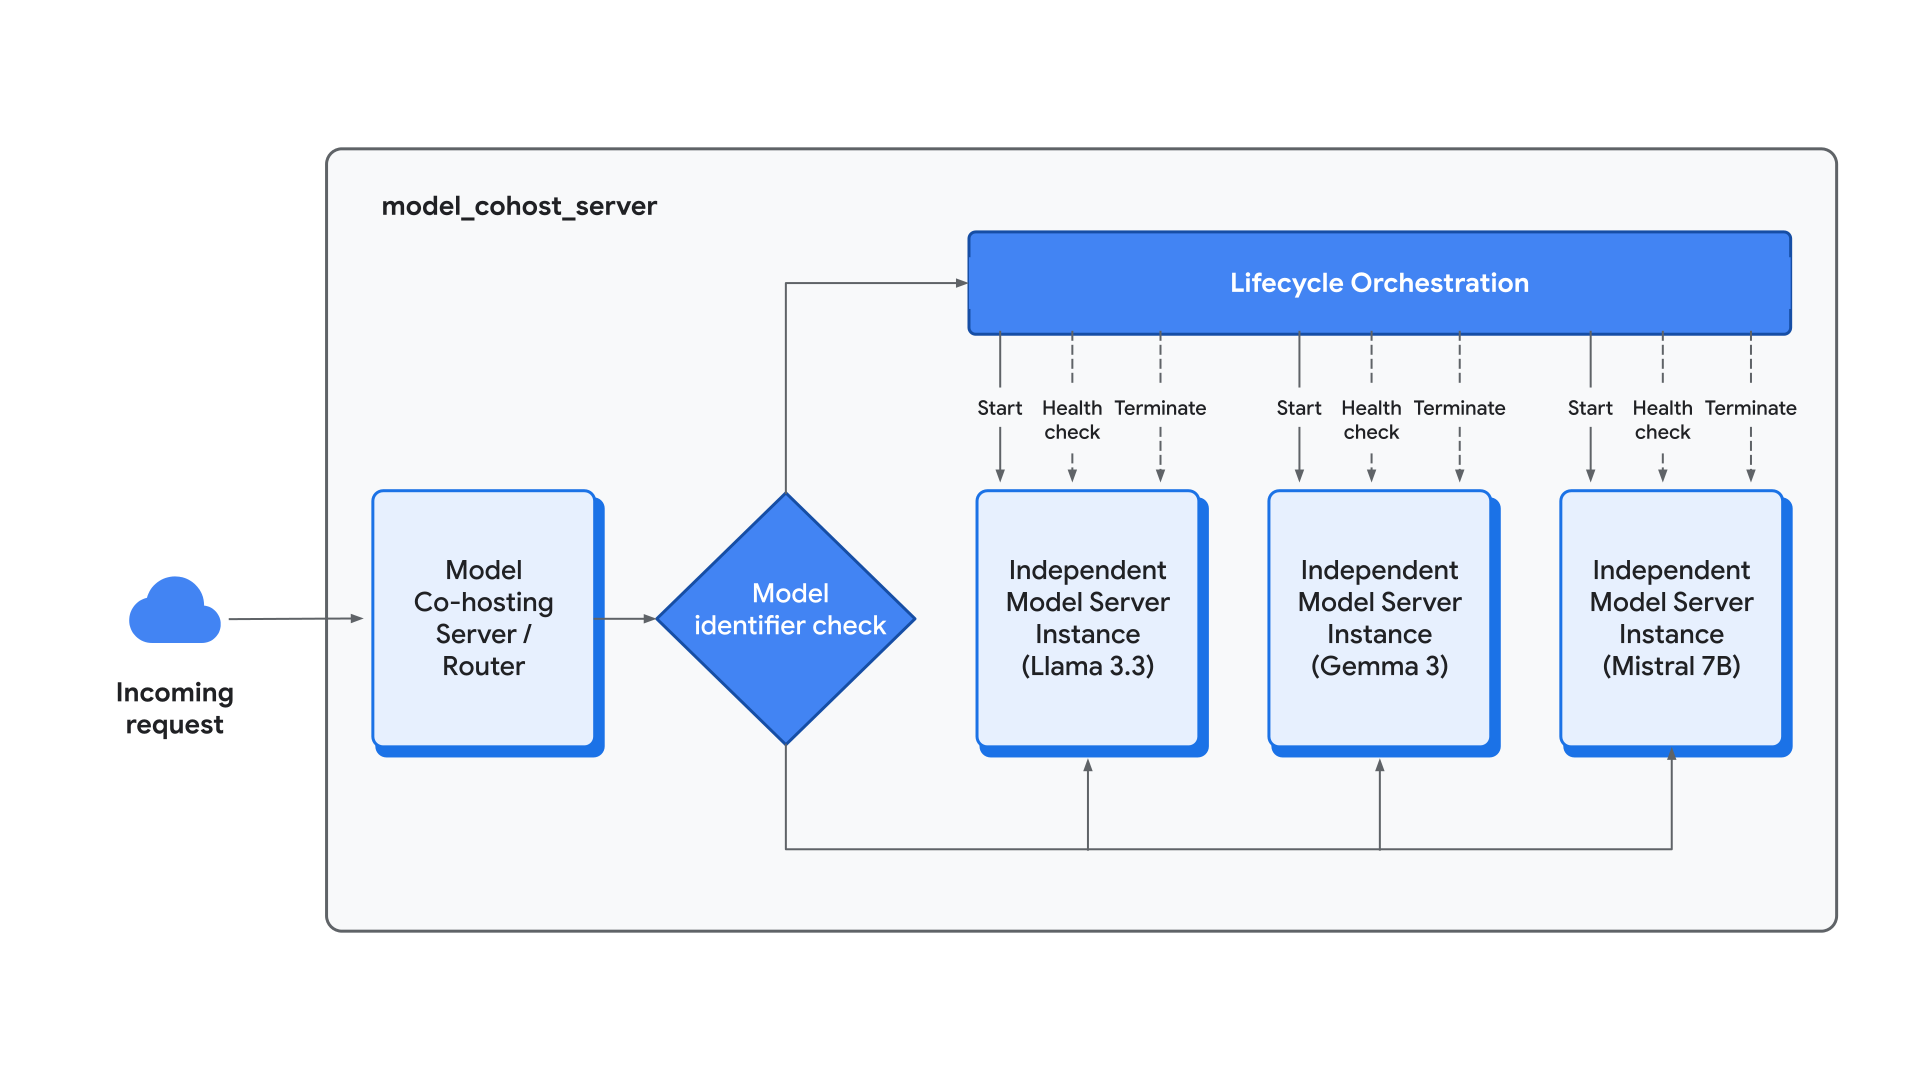
Unsere Implementierung konzentriert sich auf eine Lösung auf Containerebene, die die gleichzeitige Bereitstellung mehrerer Modelle mit unabhängigen Konfigurationen ermöglicht. Diese Architektur funktioniert über mehrere integrierte technische Mechanismen, beginnend mit der Bereitstellung mehrerer unabhängiger Modellserverinstanzen innerhalb eines einzelnen Containers. Jede dieser Instanzen dient als vollständige, unabhängige Kopie des Modellservers, was die gleichzeitige Verarbeitung von Anfragen auf der gesamten virtuellen Maschine ermöglicht. Um diesen Traffic zu verwalten, haben wir eine Instanz-Routing-Ebene innerhalb des Containers implementiert, die eingehende Anfragen effizient auf die aktiven Instanzen verteilt.
Dieses Design bietet eine granulare Parallelität, da jedes Co-Hosting-Modell eine eigene Bereitstellungskonfiguration nutzen kann, mit eindeutigen Einstellungen für Tensor Parallelism (TP), Pipeline Parallelism (PP)und die spezifische Anzahl der Modellinstanzen. Ergänzt wird dies durch das Ressourcen-Slicing, bei dem jedem Modell bestimmte GPU-Arbeitsspeicherpartitionen zugewiesen werden, z. B. eine 0,4-GPU-Arbeitsspeicherpartition pro Modell. So können verschiedene Arbeitslasten auf demselben Beschleuniger ausgeführt werden, ohne dass eine Arbeitslast die andere von kritischen Arbeitsspeicherressourcen ausschließt. Dieser architektonische Ansatz wandelt eine statische Hardware-Reservierung, z. B. einen vollständigen 8x H100-GPU-Knoten, in einen flexiblen Computing-Pool um, der ein vielfältiges Portfolio bereitstellen kann – von großen Modellen für logische Schlussfolgerungen bis hin zu kleinen Chatmodellen mit niedriger Latenz.
Prototyping und Benchmark-Studie
Bevor wir unseren produktionsreifen Orchestrator entwickelt haben, haben wir eine umfassende Benchmark-Studie durchgeführt, um die theoretische Effizienz des Modell-Co-Hostings zu validieren. In dieser Phase sollten die native Parallelität von vLLMgründlich getestet und der Grad der „Interferenz“ genau quantifiziert werden, wenn Modelle denselben Chip gemeinsam nutzen.
Untersuchung der Parallelität: Ermittlung des „Crossover-Punkts“
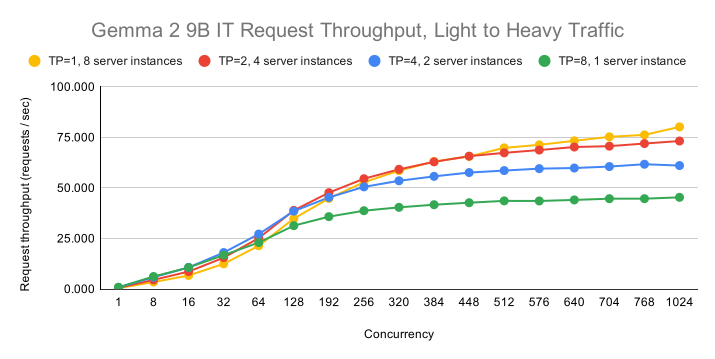
Unsere erste Analyse konzentrierte sich auf die native Tensor Parallelism (TP) und Vertex-Implementierung von Modellinstanzen als mehrere vLLM-Server Instanzen, um zu ermitteln, wie diese Strategien mit unterschiedlichen Nutzerlasten interagieren. Wir haben festgestellt, dass die optimale Konfiguration stark von der Nebenläufigkeit abhängt. Bei geringerer Nebenläufigkeit bietet eine hohe Tensor Parallelism (z. B. TP=8) die niedrigste Latenz für einzelne Anfragen, indem die Ebenen auf alle verfügbaren Beschleuniger verteilt werden. Mit zunehmendem parallelen Traffic verschiebt sich jedoch der Engpass. Um den Durchsatz bei hoher Last zu maximieren, ändert sich die optimale Konfiguration von TP=8 zu TP=4, TP=2 und schließlich TP=1, während gleichzeitig die Anzahl der unabhängigen Modellinstanzen erhöht wird. Dieser Übergang definiert einen „Crossover-Punkt“, an dem die Vorteile der reduzierten Latenz bei der Kommunikation zwischen GPUs in Setups mit niedriger TP die Rohgeschwindigkeit der Ausführung mit hoher TP überwiegen. Im Folgenden sehen Sie ein Diagramm mit dem Crossover-Punkt für das Gemma 2 9B IT-Modell.
Optimale Skalierung: Einzelnes Modell, mehrere Replikate
Um eine strenge Baseline für die Skalierbarkeit zu schaffen, haben wir die Bereitstellung mehrerer Instanzen desselben Modells auf einem einzelnen Knoten verglichen. Unter Bedingungen mit hohem Traffic (2048 parallele Anfragen pro GPU) führte das Starten von acht unabhängigen vLLM-Serverinstanzen auf einem 8xH100-Knoten zu einer 7,8-fachen Verbesserung des Durchsatzes bei nahezu keiner Latenzregression im Vergleich zu einer einzelnen GPU-Baseline.
Infrastrukturvergleich: Container- vs. Pod-Co-Scheduling
Wir haben unsere Orchestrierung auf Containerebene auch mit nativen Lösungen auf Infrastrukturebene verglichen, insbesondere mit Pod Co-Scheduling. Beide Lösungen lieferten eine vergleichbare Leistung für die Bereitstellung mit mehreren Replikaten. Wir haben uns jedoch letztendlich für den Ansatz auf Containerebene für unser Minimum Viable Product (MVP) entschieden. Diese Entscheidung wurde durch die überlegene Flexibilität der Lösung auf Containerebene für das heterogene Co-Hosting beeinflusst. So können Entwickler verschiedene Modellarchitekturen nebeneinander mit granularen, softwaredefinierten Arbeitsspeicherpartitionen bereitstellen, die nicht durch die zugrunde liegenden Kubernetes-Scheduling Einschränkungen begrenzt sind. Außerdem ermöglicht die Orchestrierung auf Containerebene viel schnellere Iterationen und lässt sich leichter anpassen und innovieren.
Der Interferenztest: Co-Hosting verschiedener Modelle
Der letzte Meilenstein des Prototypings war der „Interferenztest“, bei dem wir Gemma-3n-E2B-it und Llama-3.1-8B-Instruct auf derselben VM gehostet haben. Da jedem Modell eine 0,4-GPU-Arbeitsspeicherpartition zugewiesen wurde, blieb die Bereitstellungsleistung nahezu identisch mit den Benchmarks für einzelne Modelle. Gemma-3n erreichte beispielsweise 30,21 Anfragen in einer Co-Hosting-Umgebung im Vergleich zu 30,96 Anfragen in Isolation. Diese Ergebnisse bestätigen, dass es zwischen Co-Hosting Modellen kaum oder keine Recheninterferenzen gibt, selbst bei hohem Traffic, vorausgesetzt, die Arbeitsspeicherressourcen sind entsprechend partitioniert, um einen KV Cache Mangel zu verhindern.
MVP-Containerimplementierung
Der Übergang von einem validierten Benchmark zu einem produktionsreifen System erforderte die Entwicklung eines robusten, containerisierten Orchestrators. In dieser Entwicklungsphase ging es darum, eine Softwareebene auf hoher Ebene zu erstellen, die die Komplexität mehrerer Modelllebenszyklen verwalten und gleichzeitig eine deterministische Ressourcenisolation gewährleisten kann.
Serverdesign für Modell-Co-Hosting
Das Herzstück unserer Implementierung ist der model_cohost_server, ein benutzerdefinierter Einstiegspunkt, der als Master-Orchestrator innerhalb des Containers fungiert. Im Gegensatz zum Standardmodell mit einem einzelnen Prozess implementiert dieser Server die Unterprozessverwaltung, wodurch die gleichzeitige Ausführung mehrerer unabhängiger Modellserverinstanzen wie vLLM als isolierte Unterprozesse ermöglicht wird. Um eingehenden Traffic zu verwalten, verwendet der Orchestrator ein Routing auf hoher Ebene, bei dem Anfragen anhand ihrer eindeutigen Modell-IDs über Argumente wie --served-model-name identifiziert und an die entsprechende interne Serverinstanz weitergeleitet werden. Neben dem Routing bietet der Server eine umfassende Lebenszyklus
Orchestrierung, die die Initialisierung, die Zustandsüberwachung und die Beendigung
aller Co-Hosting-Instanzen verwaltet. Diese zentralisierte Verwaltung bietet einen einzelnen, einheitlichen Endpunkt für externen Traffic und behält gleichzeitig die unterschiedlichen Betriebsgrenzen der einzelnen Unterprozesse bei.
GPU-Ressourcenpartitionierung: Deterministisches Slicing
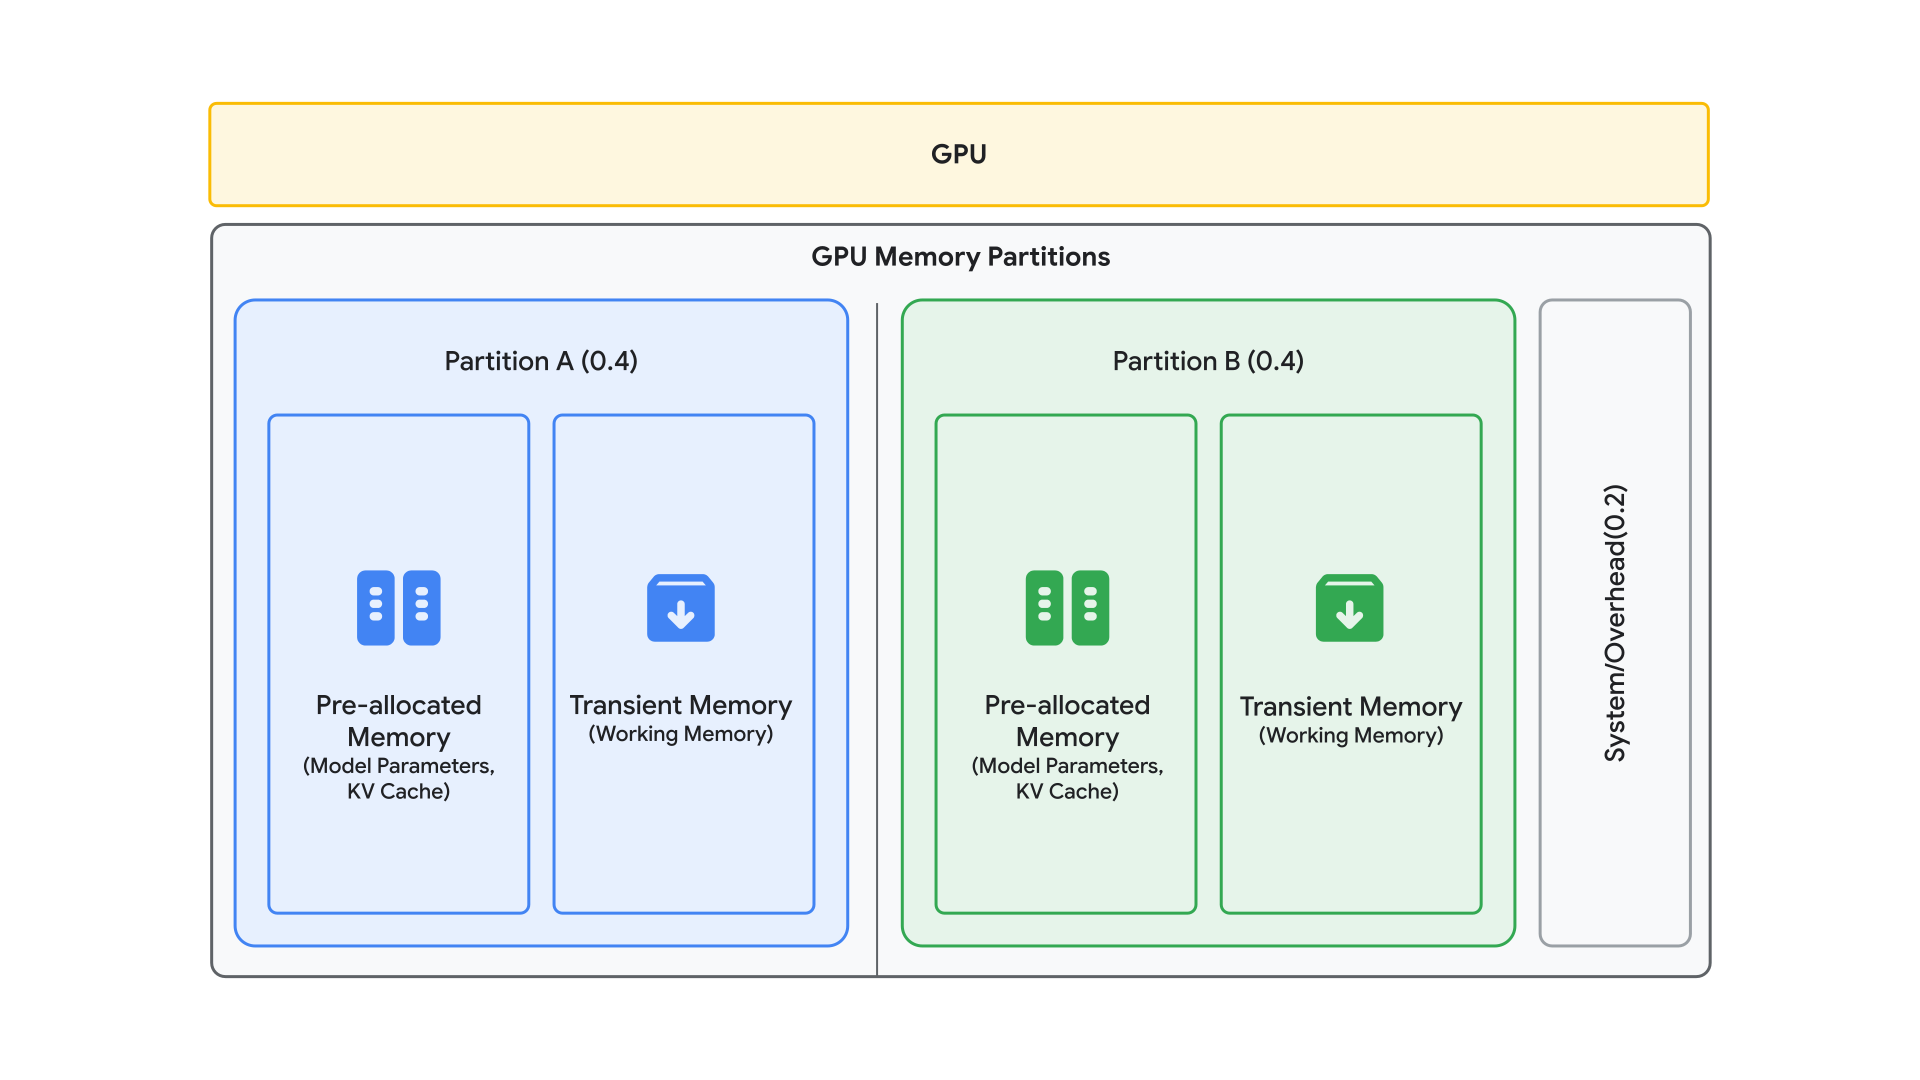
Um das Risiko zu vermeiden, dass die Arbeitslast eines einzelnen Modells einen Fehler wegen Arbeitsspeichermangel in der gesamten Co-Hosting-Umgebung auslöst, haben wir einen strengen Mechanismus für das Ressourcen-Slicing implementiert. Dies wird über das Argument gpu-memory-partition umgesetzt, mit dem Entwickler explizite Arbeitsspeicherverhältnisse definieren können (z. B. 0,4, 0,4), um einen festen Prozentsatz des gesamten GPU-Arbeitsspeichers eines Knotens für jede einzelne Modellinstanz zu reservieren.
Um diese Zuweisung zu steuern, verwenden wir ein "Arbeitsspeichermodell mit vorab zugewiesenem und temporärem Arbeitsspeicher"
modell, das zwischen statischen und dynamischen Ressourcenanforderungen unterscheidet.
Der „vorab zugewiesene“ Arbeitsspeicher besteht aus Arbeitsspeicher, der für die Modellgewichte und den KV-Cache verwendet wird. Die Menge des für die Modellgewichte verwendeten Arbeitsspeichers hängt von der Anzahl der Parameter und der Genauigkeit des Modells ab. Ein Modell mit 8 Milliarden Parametern in BF16 erfordert beispielsweise etwa 16 GB statischen Speicher. Die Menge des für den KV-Cache verwendeten Arbeitsspeichers hängt von den Modelldimensionen, der Genauigkeit, der Kontextlänge und der Anzahl der Sequenzen ab. "Temporärer Arbeitsspeicher" besteht aus Zwischenberechnungen und
Arbeitsspeicher für die Inferenz. Das Argument gpu-memory-partition berücksichtigt den „vorab zugewiesenen“ Arbeitsspeicher. Wir empfehlen, Puffer für den „temporären“ Arbeitsspeicher zu lassen, indem Sie die Summe der gpu-memory-partitions kleiner als 1,0 festlegen.
Produktentwicklung
Die Produktentwicklungsphase des Modell-Co-Hostings mit Vertex AI war darauf ausgerichtet, eine nahtlose, produktionsreife Umgebung für Bereitstellungskonfigurationen mit einem einzelnen Modell und mehreren Replikaten sowie mit mehreren Modellen zu schaffen. Bei diesem Übergang wurden empirische Benchmark-Ergebnisse in vereinfachte Bereitstellungsworkflows und tief integrierte Infrastruktur-Supportstrukturen umgesetzt.
Vereinfachte Bereitstellungsworkflows
Um die Einstiegshürde für die Bereitstellung mit hoher Dichte zu senken, haben wir Co-Hosting-Konfigurationen mit benutzerdefinierten Containerargumenten standardisiert, die nativ in bestehende Vertex AI APIs integriert sind. Für virtuelle Maschinen mit vollständiger Form, z. B. einen 8x H100-Knoten, haben wir ein Benchmark-Tool entwickelt, mit dem Sie die besten Rezepte für Ihre spezifischen Anwendungsfälle anpassen können. Mit diesem Benchmark Tool können Sie die Konfiguration finden, die Tensor Parallelism (TP), Pipeline Parallelism (PP), und die Anzahl der Modellinstanzen automatisch basierend auf der spezifischen Anzahl der Parameter und der Genauigkeit des Modells ausgleicht. Ergänzt wird dies durch eine robuste Unterstützung der Deployment API , mit der Entwickler diese detaillierten Parameter, einschließlich der genauen GPU-Arbeitsspeicherpartitionen, direkt in einer Standardanfrage vom Typ „deployModel“ angeben und Modelle bereitstellen können.
Dynamische Bereitstellung mehrerer Modelle
Ein bedeutender Fortschritt auf unserem technischen Weg war der Übergang von statischen Konfigurationen zu einer dynamischen Bereitstellungsarchitektur. Diese Funktion ist entscheidend für Produktionsumgebungen, die durch schnell wechselnde Traffic-Muster gekennzeichnet sind, da die Möglichkeit, Modelle ohne einen vollständigen Containerneustart zu laden oder zu entfernen, für die Aufrechterhaltung der Infrastrukturagilität und Hochverfügbarkeit unerlässlich ist.
Die Dynamic Update API (update_models)
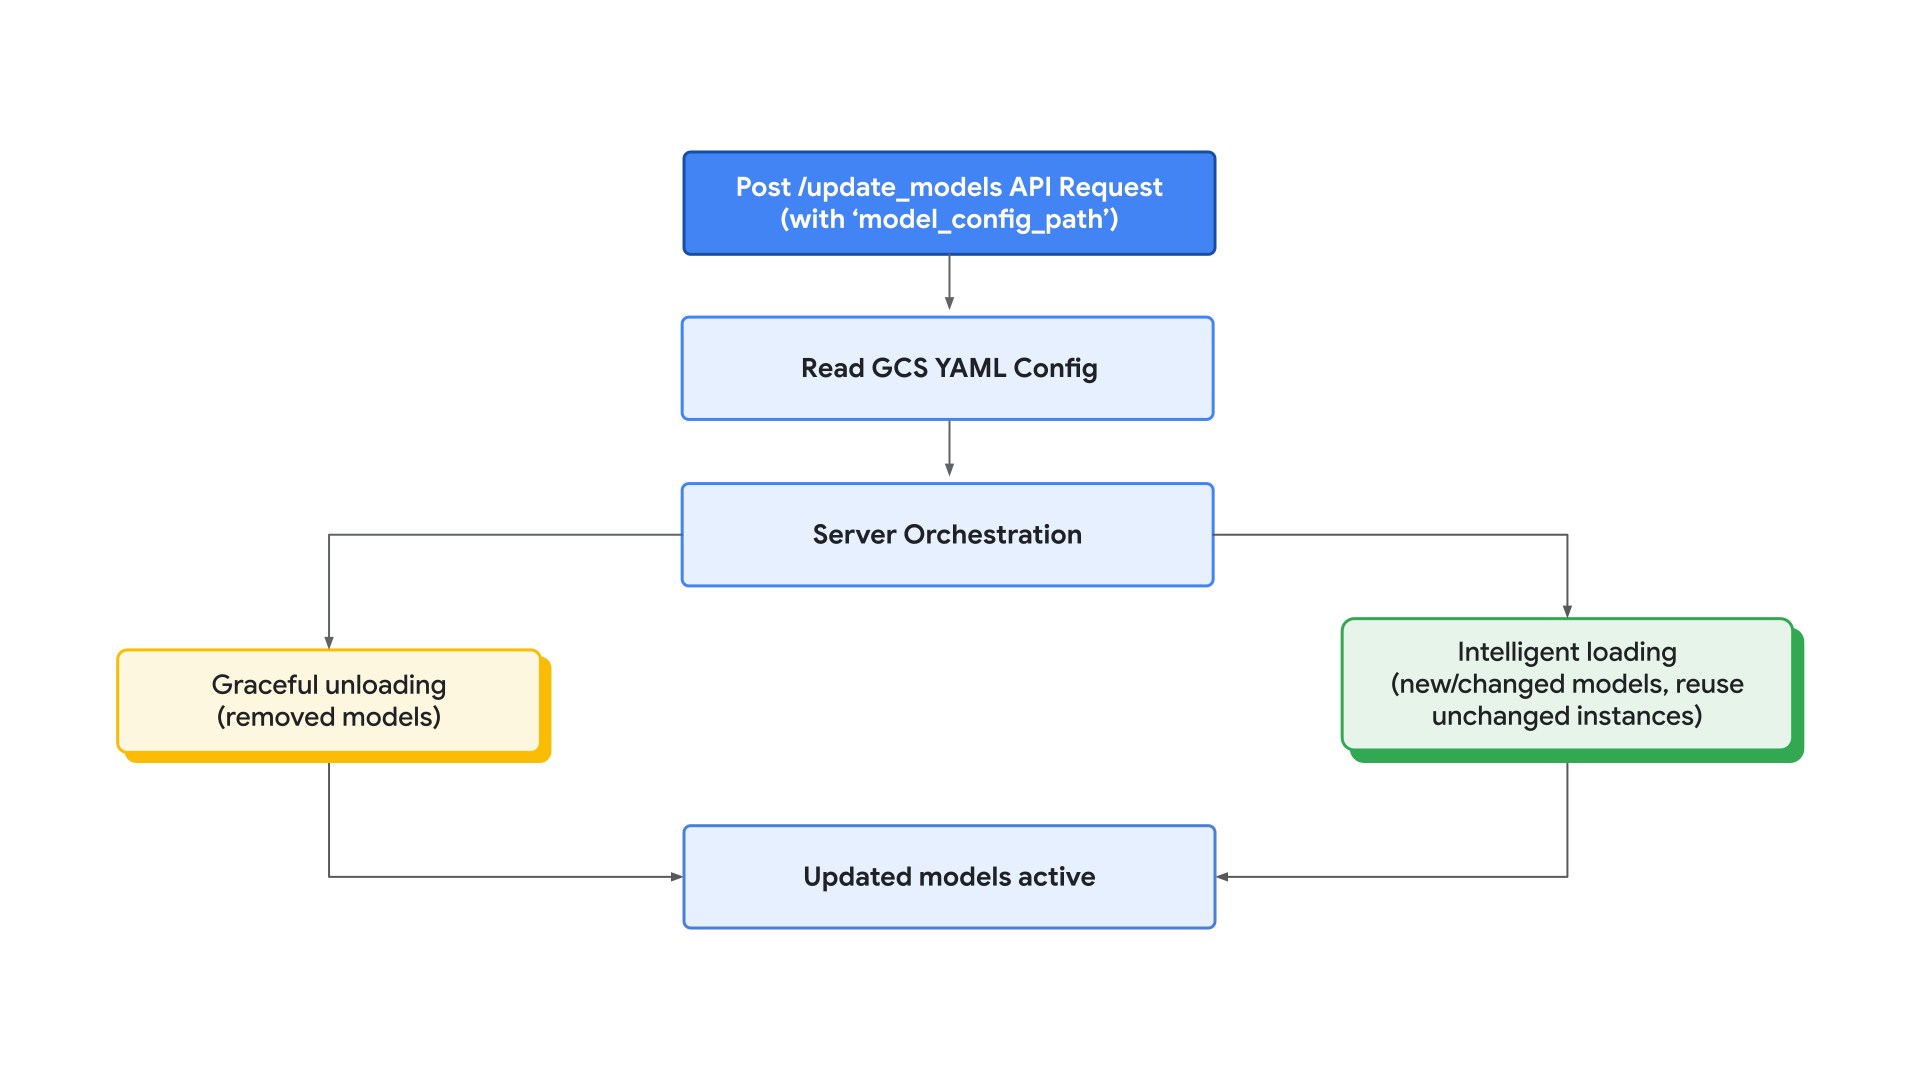
Um die inhärenten Einschränkungen unveränderlicher Bereitstellungen zu beheben, haben wir eine spezielle API für Modellupdates im Vertex Model Garden-Container für das vLLM-Modell-Co-Hosting implementiert. Diese API ermöglicht das Hot-Reloading, sodass der Server sein Portfolio an gehosteten Modellen spontan basierend auf einer zentralen Konfigurationsdatei anpassen kann, die in einem Cloud Storage Bucket gespeichert ist.
Der Updateprozess wird über eine POST-Anfrage an den Endpunkt update_models initiiert, die den model_config_path enthält, der auf die YAML-Datei in Cloud Storage verweist.
Nachdem der Server diese Anfrage erhalten hat, führt er eine mehrstufige Orchestrierungssequenz aus, die für minimale Ausfallzeiten optimiert ist:
- Schonendes Entfernen: Das System identifiziert Modelle, die in der neuen Konfiguration nicht vorhanden sind, und beendet zuerst ihre Unterprozesse, wodurch GPU-Arbeitsspeicher und Rechenressourcen sofort freigegeben werden.
- Intelligentes Laden und Wiederverwenden: Der Server initialisiert dann neue Modell instanzen. Wenn sich die Parallelitätseinstellungen eines Modells, z. B. Tensor Parallelism (TP) oder Pipeline Parallelism (PP), und die zugewiesene Arbeitsspeicherpartition nicht ändern, verwendet der Orchestrator die vorhandene aktive Instanz wieder. Durch diese Optimierung wird die kostspielige Reinitialisierungsphase umgangen und sichergestellt, dass aktive Dienste während Konfigurationsänderungen nicht unterbrochen werden.
Latenz- und Leistungsanalyse
Die empirische Analyse dieser Updatestrategien zeigt, dass das dynamische Hot-Reloading die mit der groß angelegten LLM-Bereitstellung häufig verbundene „Kaltstart“-Strafe erheblich reduziert.
Fazit
Das Modell-Co-Hosting mit Vertex AI stellt einen grundlegenden Paradigmenwechsel dar, der von starren, hardwareintensiven monolithischen Bereitstellungen zu einer flexiblen und effizienten Bereitstellungsarchitektur führt. Durch die Weiterentwicklung über den Standard „ein Modell pro VM“ hinaus zu einem Computing-Poolmodell mit hoher Dichte können Unternehmen ihre Gesamtbetriebskosten erheblich senken und gleichzeitig die Leistungsbenchmarks beibehalten und oft sogar verbessern.
Unsere Entwicklung und umfangreichen Benchmark-Studien für mehrere Modelle haben eine definitive Reihe von Produktionsrichtlinien für diese Architektur ergeben:
- Es gibt keine einheitliche Konfiguration. Wir empfehlen, das beste Bereitstellungsrezept für einen bestimmten Anwendungsfall (Modell, Hardware, Traffic) zu finden, und entwickeln Tools dafür.
- Durchsatz mit Replikaten skalieren.
- Die Ressourcenauslastung verbessern, indem Hardwaregrenzen aufgehoben und der Arbeitsspeicher auf einer granulareren Ebene aufgeteilt wird.
Für die erfolgreiche Implementierung einer Co-Hosting-Architektur empfehlen wir den folgenden technischen Workflow:
- Explizite Partitionierung: Verwenden Sie das
--gpu-memory-partitionsArgument, um Arbeitsspeicherressourcen für einzelne Modelle zuzuweisen. - Iteratives Benchmarking: Verwenden Sie das bereitgestellte Benchmark-Tool, um den spezifischen „Concurrency Crossover“-Punkt für Ihre Arbeitslast zu ermitteln – die optimale Konfiguration für die Anzahl der Instanzen, TP und PP.
Die Implementierung des Co-Hostings in Google Cloud Model Garden bietet eine skalierbare Vorlage für die Entwicklung von KI-Anwendungen mit hoher Dichte. Entwickler sollten diese Funktionen nutzen und unsere Benchmarks mit dem bereitgestellten Notebook mit Tutorial reproduzieren, um die Bereitstellungskonfigurationen für ihre spezifischen Unternehmensanforderungen zu optimieren.
Vielen Dank für Ihr Interesse
Wir freuen uns auf Ihr Feedback und Ihre Fragen zu Vertex AI.
Danksagungen
Wir möchten dem Google Cloud Vertex AI-Team unseren aufrichtigen Dank aussprechen. Insbesondere danken wir Bo Wu und Ting Yu für ihre Führung und Anleitung sowie Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur und Luis Rizo für ihre unschätzbaren Beiträge während dieses Projekts.