

En el panorama en evolución de los modelos de lenguaje grandes (LLM), el patrón de implementación de "un modelo por máquina" se está convirtiendo en un cuello de botella importante para la rentabilidad de la entrega de LLM en las empresas. Los LLM suelen requerir reservas de hardware sustanciales, como nodos de GPU H100 de 8x completos, para administrar las cargas máximas. Sin embargo, durante las operaciones estándar, estos recursos costosos suelen estar subutilizados, lo que genera un costo total de propiedad (TCO) alto.
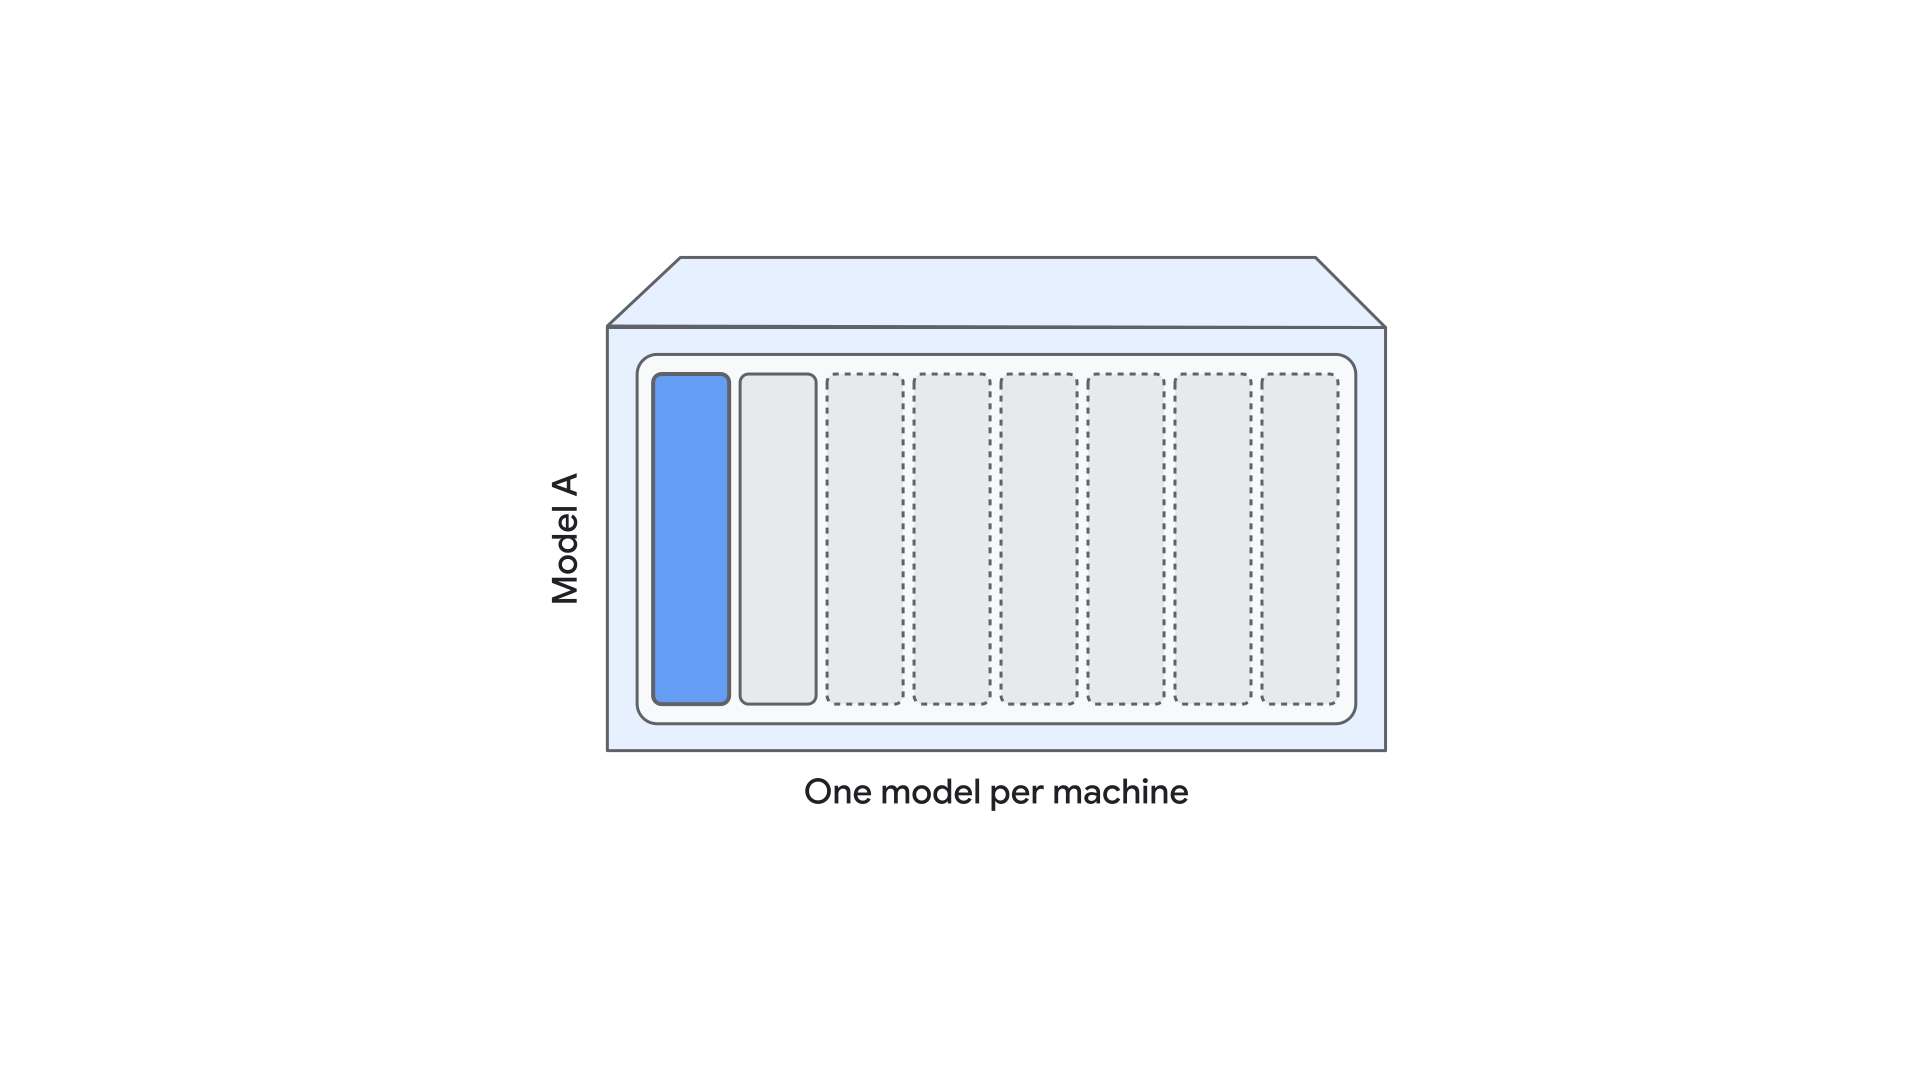
Haz clic para ampliar la imagen
El hosting compartido de modelos aborda esta brecha de eficiencia, ya que permite que varias instancias de modelos compartan la misma máquina virtual y los mismos recursos de GPU. Esto incluye modelos completamente diferentes, como Llama 3.3 y Gemma 3. Mediante el uso de la segmentación de memoria de la GPU y la partición inteligente de recursos, Vertex AI Model Garden transforma las reservas de hardware estáticas en grupos de procesamiento flexibles y de alta densidad.
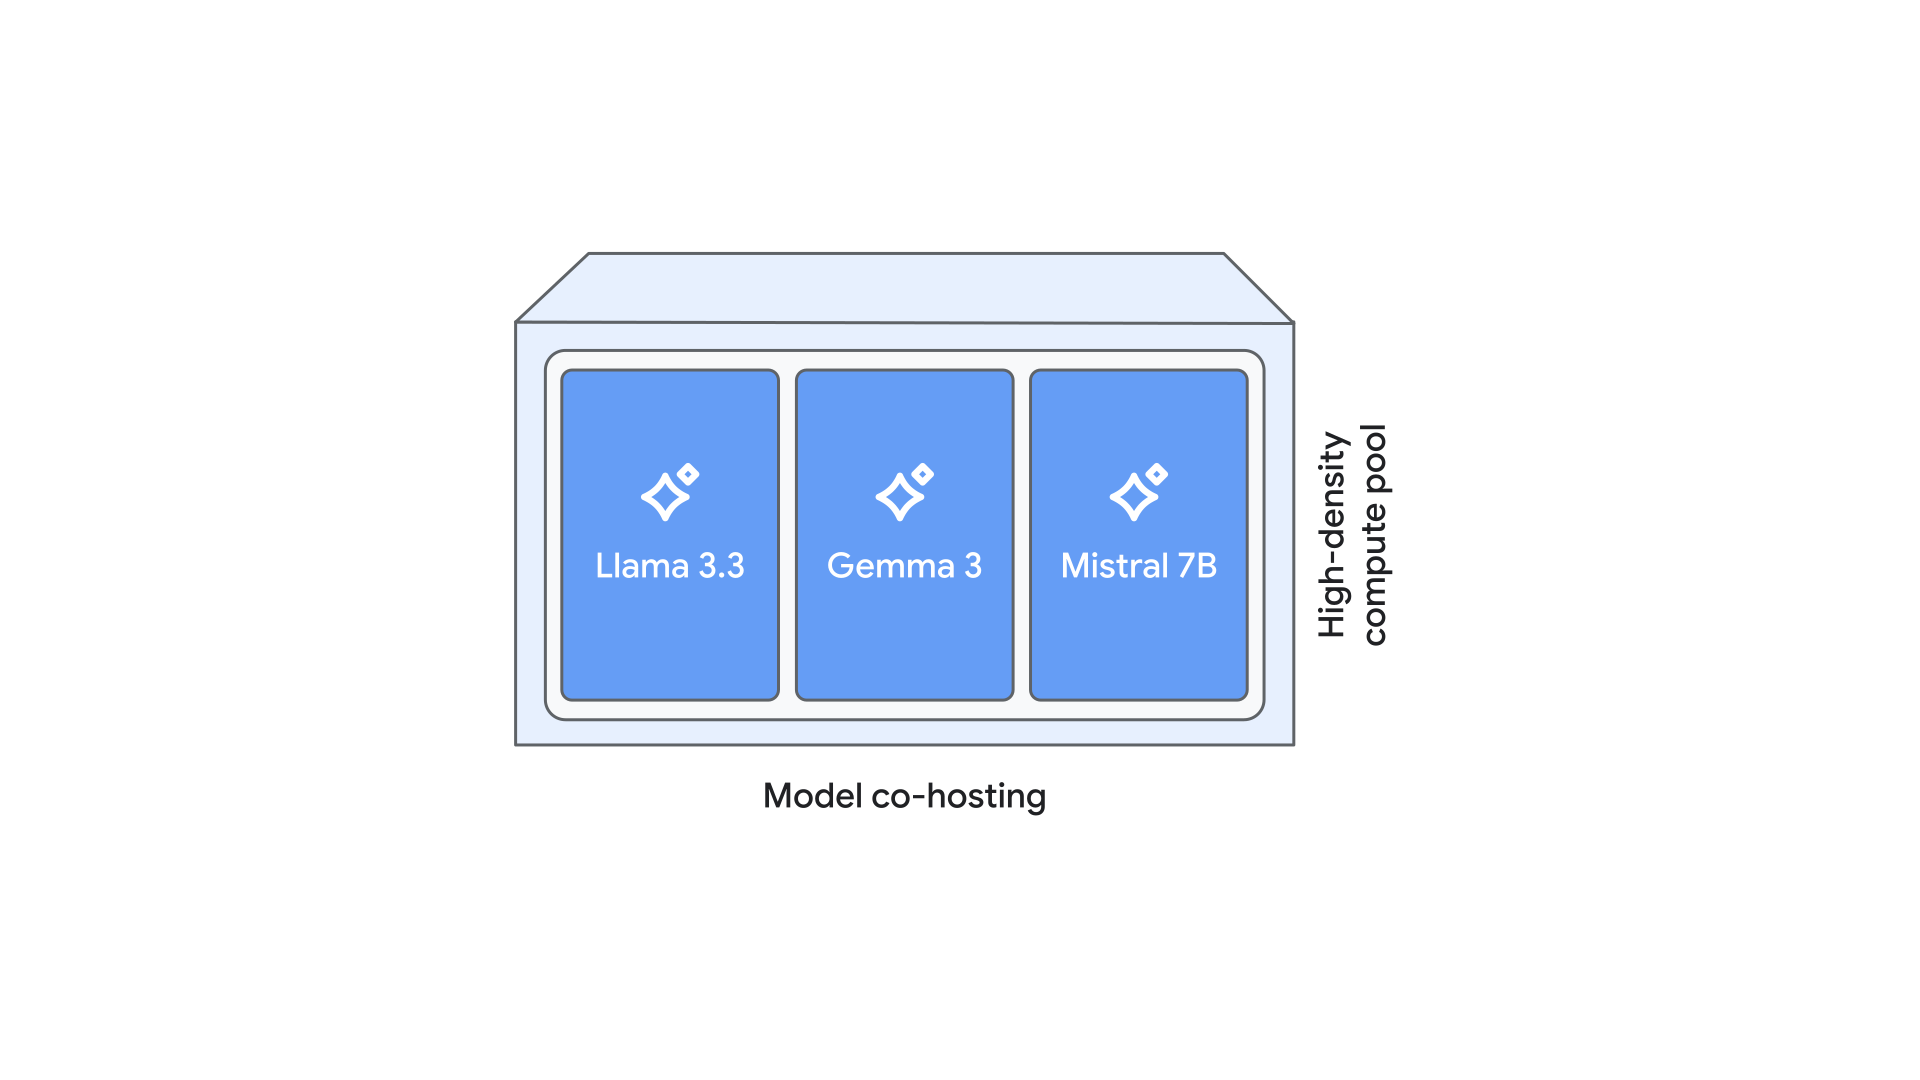
Haz clic para ampliar la imagen
En este blog técnico, se detalla el proceso de Vertex AI Engineering para llevar el hosting compartido de modelos a un servicio en la nube listo para producción. Compartiremos nuestra metodología para nuestras estrategias de implementación a nivel de contenedor, identificaremos las configuraciones de entrega óptimas y las conclusiones clave de nuestro extenso estudio comparativo de varios modelos, lo que te permitirá maximizar la rentabilidad de la entrega de LLM.
Información sobre el hosting compartido de modelos: concepto y arquitectura
El hosting compartido de modelos es una estrategia de entrega de alta densidad que permite que varias instancias de modelos de lenguaje grandes (LLM) o diferentes arquitecturas de modelos compartan los mismos recursos de hardware físico dentro de una sola máquina virtual (VM). A diferencia de los modelos de implementación tradicionales que dedican una VM o GPU completa a un solo modelo, el hosting compartido utiliza la partición de recursos detallada para maximizar el ROI del hardware y mejorar el uso de la memoria y los recursos de procesamiento.
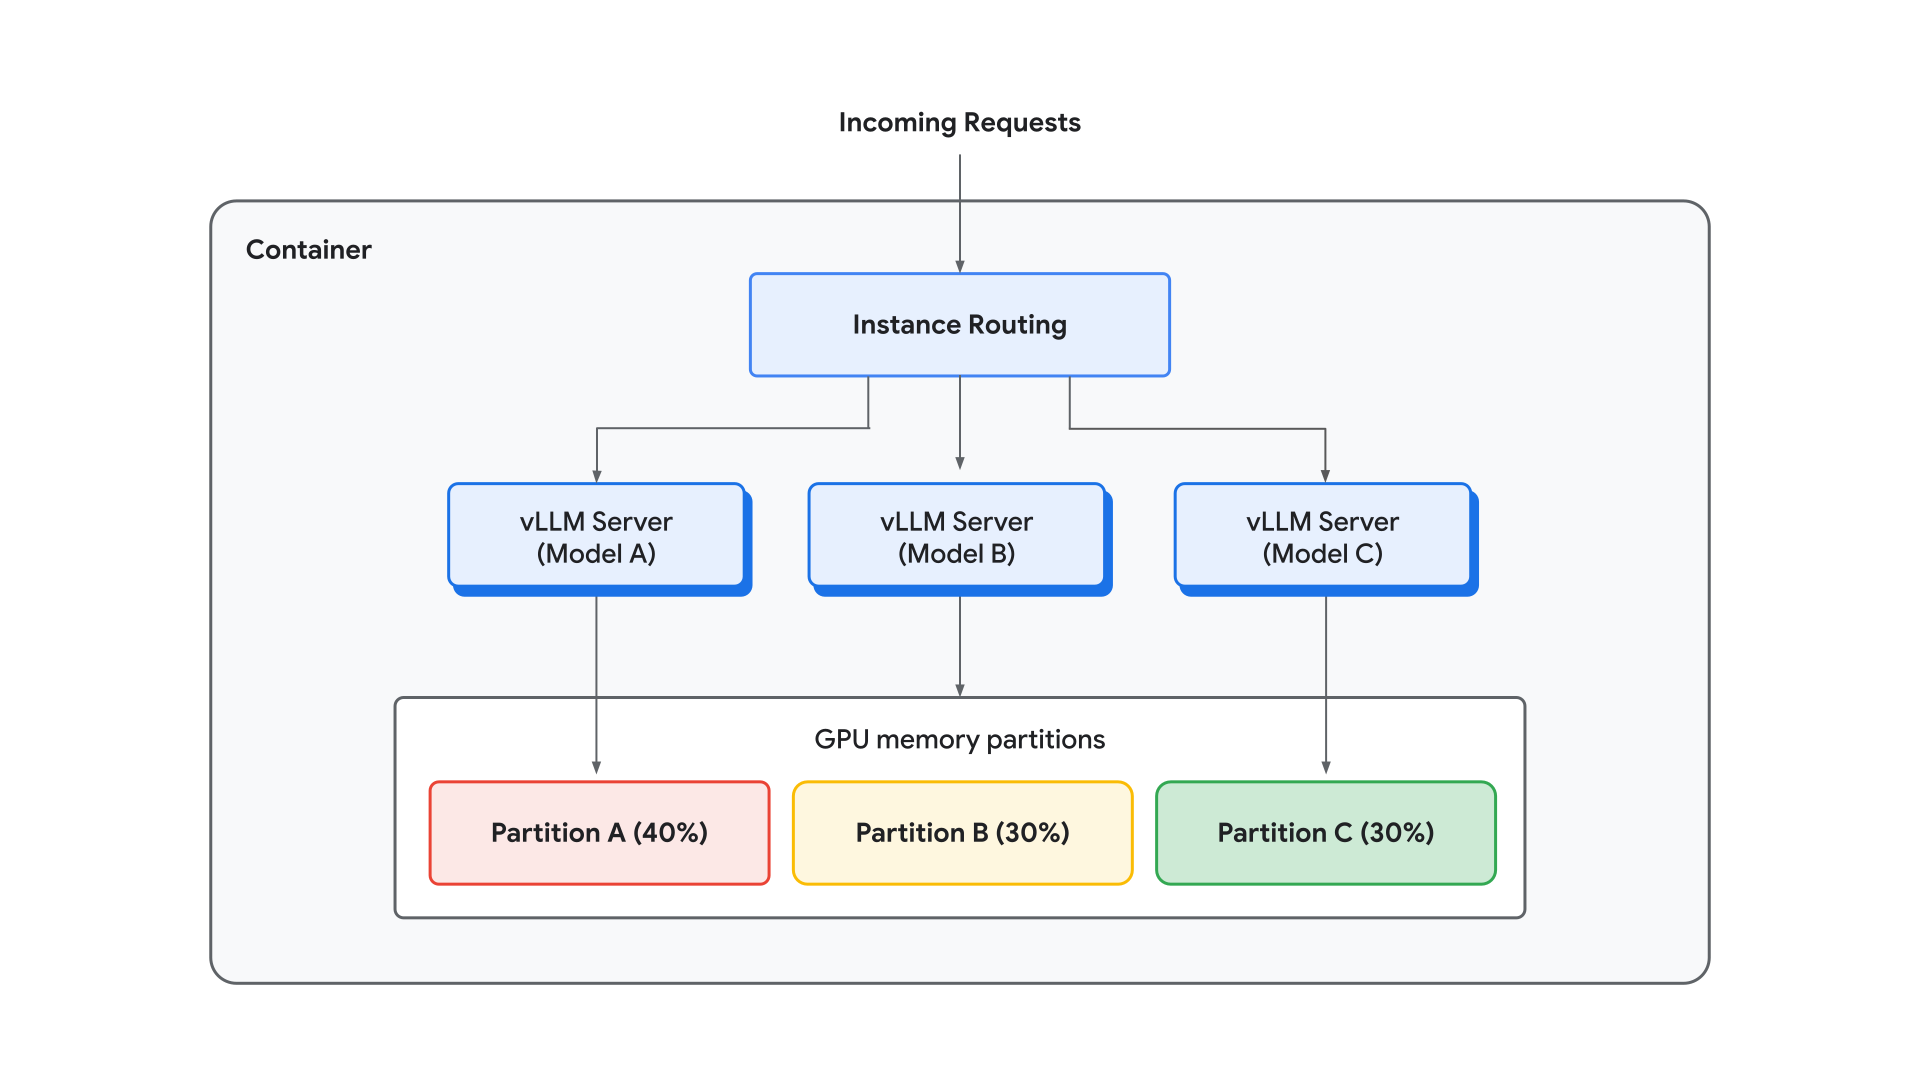
Nuestra implementación se centra en una solución a nivel de contenedor que permite la entrega simultánea de varios modelos con configuraciones independientes. Esta arquitectura opera a través de varios mecanismos técnicos integrados, comenzando con la implementación de varias instancias de servidores de modelos independientes dentro de un solo contenedor. Cada una de estas instancias funciona como una copia completa e independiente del servidor de modelos, lo que permite el procesamiento simultáneo de solicitudes en la máquina virtual. Para administrar este tráfico, implementamos una capa de enrutamiento de instancias dentro del contenedor que distribuye de manera eficiente las solicitudes entrantes entre las instancias activas.
Este diseño proporciona un paralelismo detallado, ya que permite que cada modelo alojado de forma compartida utilice una configuración de entrega dedicada, con parámetros de configuración únicos para el paralelismo de tensores (TP), el paralelismo de canalización (PP) y la cantidad específica de instancias de modelos. Esto se complementa con la segmentación de recursos, en la que se asignan particiones de memoria de GPU específicas a cada modelo, como una partición de memoria de GPU de 0.4 por modelo, para garantizar que las diversas cargas de trabajo coexistan en el mismo acelerador sin privarse mutuamente de recursos de memoria críticos. Este enfoque arquitectónico transforma una reserva de hardware estática, como un nodo de GPU H100 de 8x completo, en un grupo de procesamiento flexible capaz de entregar una cartera diversa, desde modelos de razonamiento grandes hasta modelos de chat pequeños y de baja latencia.
Haz clic para ampliar la imagen
Estudio comparativo y de creación de prototipos
Antes de desarrollar nuestro orquestador listo para producción, realizamos un estudio comparativo integral para validar la eficiencia teórica del hosting compartido de modelos. El objetivo de esta fase era probar minuciosamente vLLM's paralelismo nativo y cuantificar con precisión el grado de "interferencia" cuando los modelos comparten el mismo chip.
Investigación de paralelismo: Cómo encontrar el "punto de cruce"
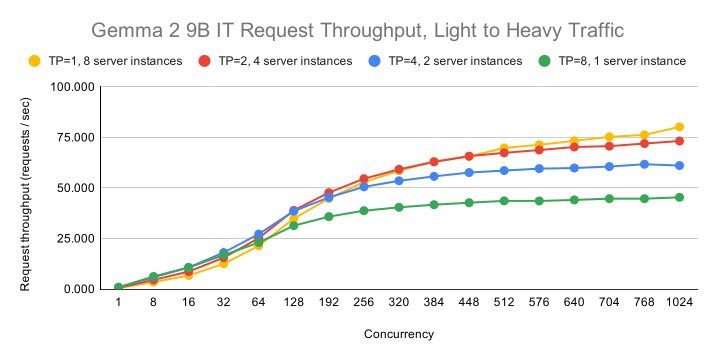
Nuestro análisis inicial se centró en el paralelismo de tensores (TP) nativo de vLLM y la implementación de Vertex de instancias de modelos como varias instancias de servidores vLLM para determinar cómo interactúan estas estrategias con cargas de usuarios variables. Descubrimos que la configuración óptima depende en gran medida de la simultaneidad. En simultaneidades más bajas, un paralelismo de tensores alto (p. ej., TP=8) proporciona la latencia más baja para las solicitudes individuales, ya que distribuye las capas en todos los aceleradores disponibles. Sin embargo, a medida que aumenta el tráfico simultáneo, el cuello de botella cambia. Para maximizar la capacidad de procesamiento en condiciones de carga alta, la configuración óptima pasa de TP=8 a TP=4, TP=2 y, finalmente, TP=1, mientras que aumenta la cantidad de instancias de modelos independientes. Esta transición define un "punto de cruce" en el que los beneficios de la latencia reducida de comunicación entre GPU en configuraciones de TP bajas superan la velocidad sin procesar de la ejecución de TP altas. A continuación, se muestra un gráfico de puntos de cruce con el modelo Gemma 2 9B IT.
Haz clic para ampliar la imagen
Escalamiento óptimo: Un solo modelo, varias réplicas
Para establecer una línea de base rigurosa para la escalabilidad, comparamos la entrega de varias instancias del mismo modelo en un solo nodo. En condiciones de tráfico saturado (2048 solicitudes simultáneas por GPU), el lanzamiento de ocho instancias de servidores vLLM independientes en un nodo de 8xH100 produjo una mejora de la capacidad de procesamiento de aproximadamente 7.8 veces con una regresión de latencia prácticamente nula en comparación con una línea de base de una sola GPU.
Comparación de la infraestructura: Programación conjunta de contenedores vs. pods
Además, evaluamos nuestra orquestación a nivel de contenedor en comparación con las soluciones nativas a nivel de infraestructura, específicamente la programación conjunta de pods. Si bien ambas soluciones ofrecieron un rendimiento comparable para la entrega de varias réplicas, finalmente seleccionamos el enfoque a nivel de contenedor para nuestro producto mínimo viable (MVP). Esta decisión se basó en la flexibilidad superior que ofrece la solución a nivel de contenedor para el hosting compartido heterogéneo, lo que permite a los desarrolladores entregar diferentes arquitecturas de modelos en paralelo con particiones de memoria definidas por software y detalladas que no están restringidas por las restricciones de programación de Kubernetes subyacentes. Además, la orquestación a nivel de contenedor permite iterar mucho más rápido y es más fácil personalizar e innovar.
La prueba de interferencia: Hosting compartido de diferentes modelos
El hito final de la creación de prototipos fue la "prueba de interferencia", en la que alojamos de forma compartida Gemma-3n-E2B-it y Llama-3.1-8B-Instruct en la misma VM. Con cada modelo asignado a una partición de memoria de GPU de 0.4, el rendimiento de la entrega se mantuvo casi idéntico a los comparativos de un solo modelo. Por ejemplo, Gemma-3n alcanzó 30.21 solicitudes en un entorno alojado de forma compartida en comparación con 30.96 solicitudes de forma aislada. Estos resultados confirman que hay poca o ninguna interferencia de procesamiento entre los modelos alojados de forma compartida, incluso con tráfico intenso, siempre que los recursos de memoria estén particionados de forma adecuada para evitar la falta de caché de pares clave-valor.
Implementación de contenedores de MVP
La transición de un comparativo validado a un sistema listo para producción requirió la ingeniería de un orquestador sólido y en contenedores. Esta fase de desarrollo se centró en la creación de una capa de software de alto nivel capaz de administrar las complejidades de varios ciclos de vida de modelos y, al mismo tiempo, garantizar el aislamiento determinista de los recursos.
Diseño del servidor de hosting compartido de modelos
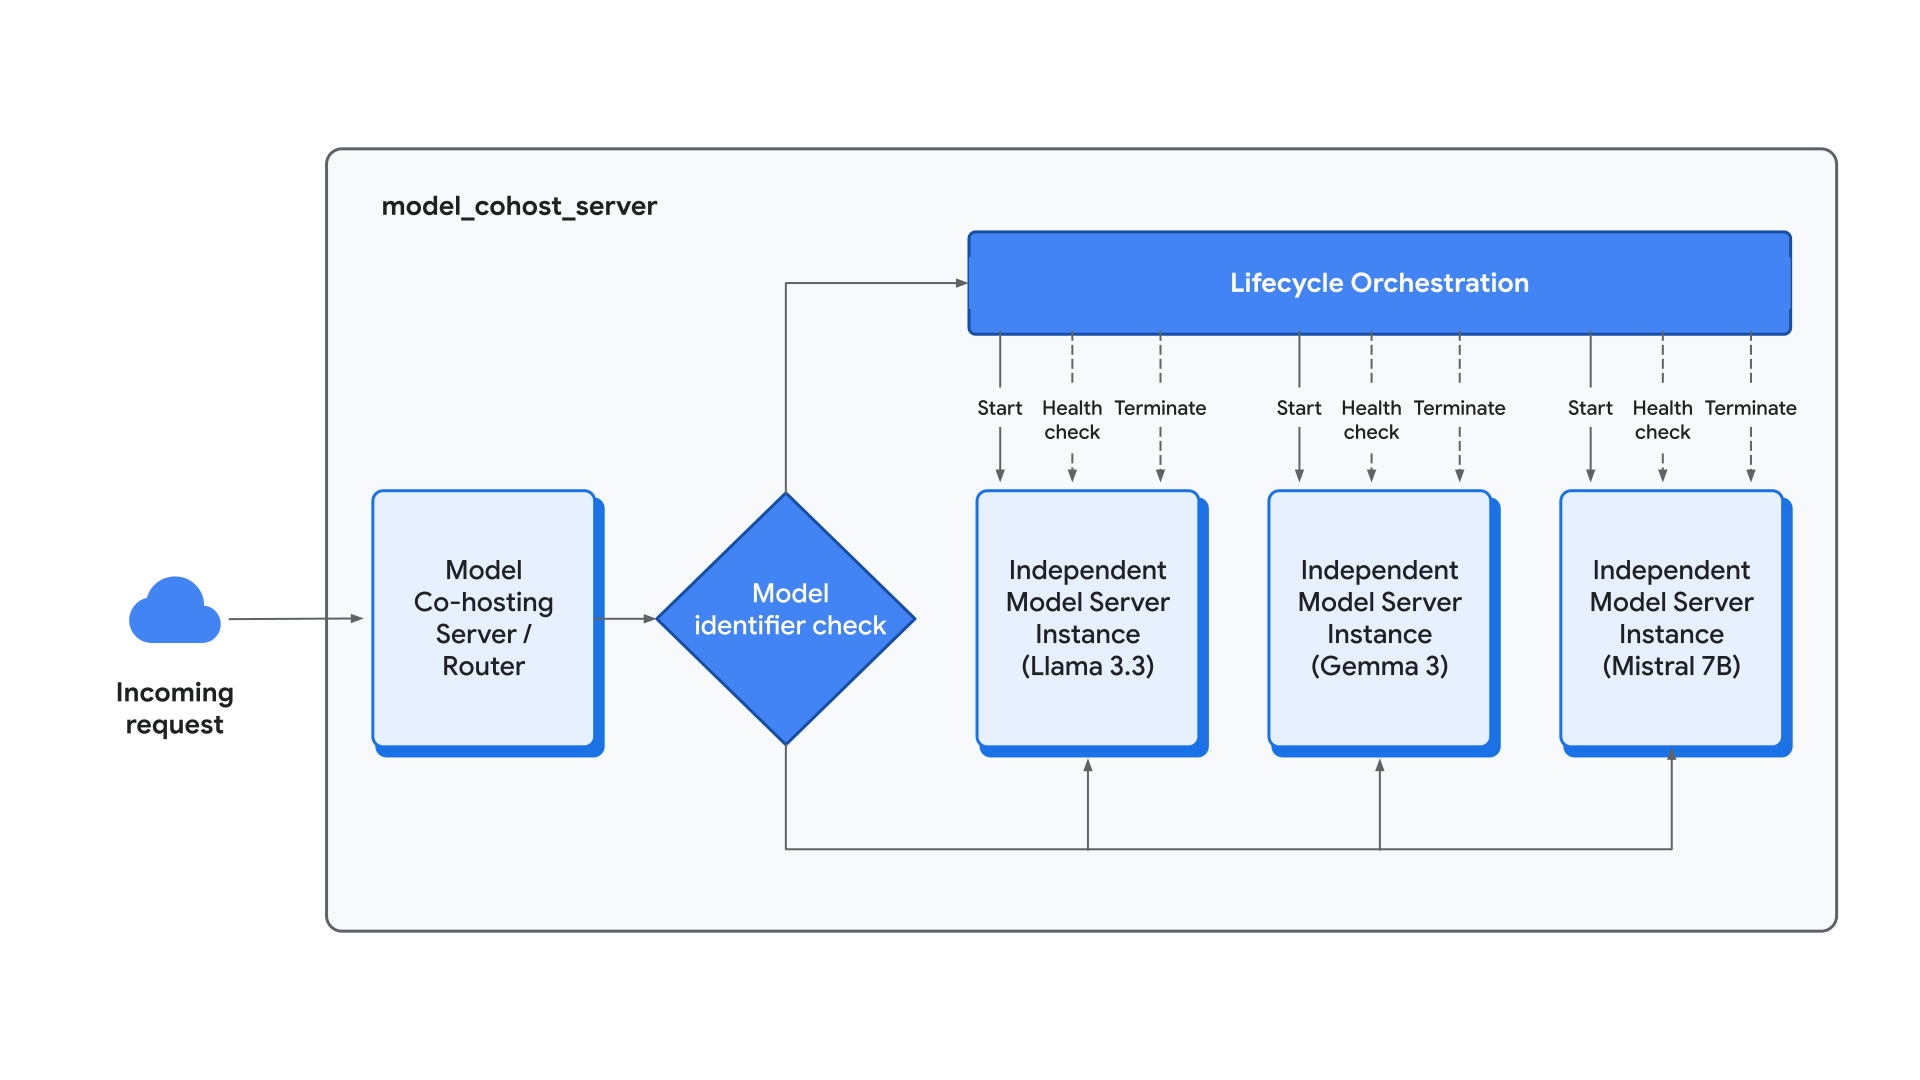
El núcleo de nuestra implementación es model_cohost_server, un punto de entrada personalizado diseñado para actuar como un orquestador maestro dentro del contenedor. A diferencia del modelo estándar de un solo proceso, este servidor implementa la administración de subprocesos, lo que facilita la ejecución simultánea de varias instancias de servidores de modelos independientes, como vLLM, como subprocesos aislados. Para administrar el tráfico entrante, el orquestador emplea el enrutamiento de solicitudes de alto nivel, identifica las solicitudes por sus identificadores de modelos únicos a través de argumentos como --served-model-name y las dirige a la instancia del servidor interno correspondiente. Además del enrutamiento, el servidor proporciona una orquestación
integral del ciclo de vida, que administra la inicialización, la supervisión del estado y la finalización
de todas las instancias alojadas de forma compartida. Esta administración centralizada proporciona un solo extremo unificado para el tráfico externo, mientras mantiene los límites operativos distintos de cada subproceso.
Haz clic para ampliar la imagen
Partición de recursos de GPU: Segmentación determinista
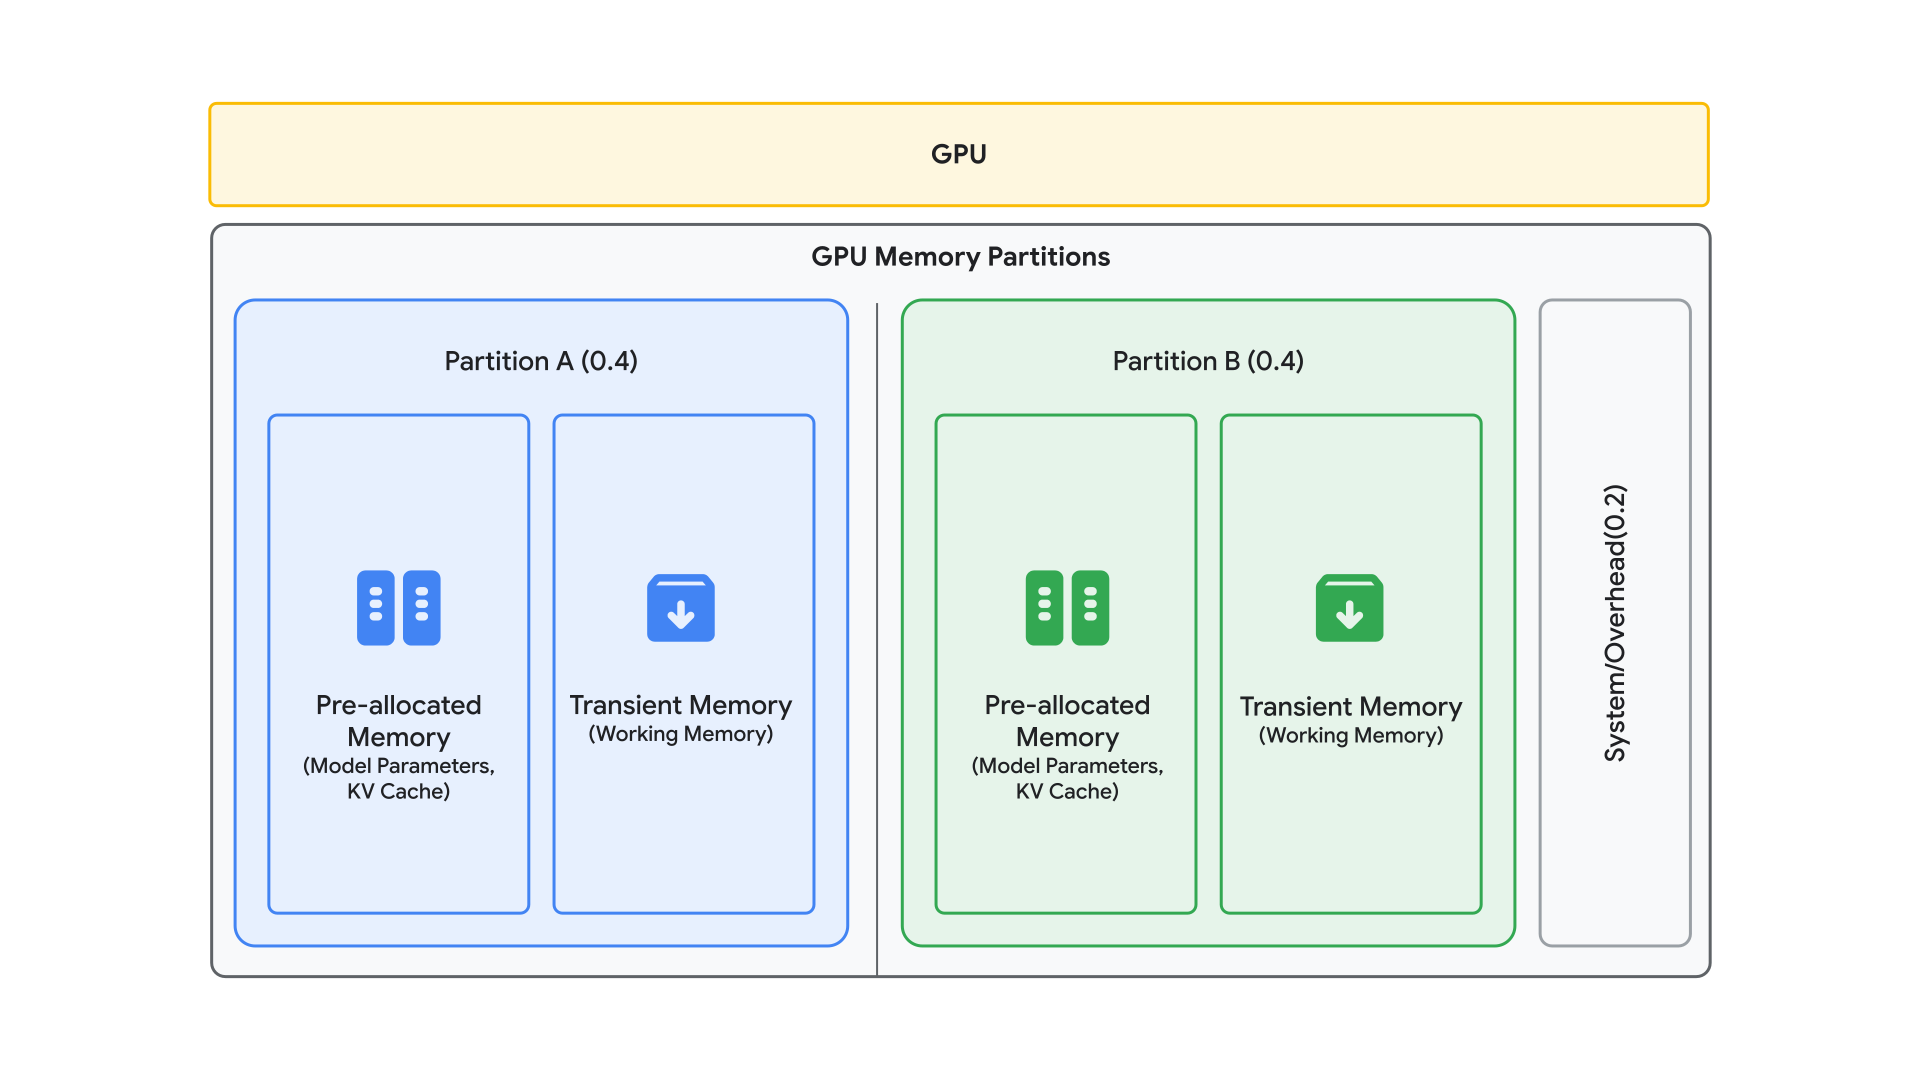
Para eliminar el riesgo de que la carga de trabajo de un solo modelo active un error de memoria insuficiente (OOM) en el entorno alojado de forma compartida, implementamos un mecanismo estricto de segmentación de recursos. Esto se opera a través del argumento gpu-memory-partition, que permite a los desarrolladores definir proporciones de memoria explícitas (p.ej., 0.4, 0.4) para reservar un porcentaje fijo de la memoria total de la GPU de un nodo para cada instancia de modelo individual.
Para guiar esta asignación, adoptamos un "modelo de memoria preasignada vs. transitoria", que distingue entre los requisitos de recursos estáticos y dinámicos.
La memoria "preasignada" consiste en la memoria que se usa para los pesos del modelo y la caché de pares clave-valor. La cantidad de memoria que se usa para los pesos del modelo depende del recuento de parámetros y la precisión del modelo. Por ejemplo, un modelo de parámetros de 8B en BF16 requiere aproximadamente 16 GB de almacenamiento estático. La cantidad de memoria que se usa para la caché de pares clave-valor depende de las dimensiones, la precisión, la longitud del contexto y la cantidad de secuencias del modelo. La memoria"transitoria" consiste en cálculos intermedios y
memoria de trabajo de inferencia. El argumento gpu-memory-partition representa la memoria "preasignada". Recomendamos dejar espacio de búfer para la memoria "transitoria" configurando la suma de gpu-memory-partition para que sea menor que 1.0.
Haz clic para ampliar la imagen
Producción
La fase de producción del hosting compartido de modelos con Vertex AI se dedicó a establecer un entorno fluido y listo para producción para las configuraciones de entrega de un solo modelo con varias réplicas y de varios modelos. Esta transición tradujo de manera eficaz las conclusiones empíricas de los comparativos en flujos de trabajo de implementación simplificados y estructuras de asistencia de infraestructura profundamente integradas.
Flujos de trabajo de implementación simplificados
Para reducir la barrera de entrada para la entrega de alta densidad, estandarizamos las configuraciones de hosting compartido con argumentos de contenedores personalizados que se integran de forma nativa con las APIs de Vertex AI existentes. Para las máquinas virtuales de forma completa, como un nodo de 8x H100, desarrollamos una utilidad de comparativos para personalizar las mejores recetas para tus casos de uso específicos. Esta utilidad de comparativos te permitiría encontrar la configuración que equilibra automáticamente el paralelismo de tensores (TP), el paralelismo de canalización (PP), y la cantidad de instancias de modelos en función del recuento de parámetros y la precisión específicos del modelo. Esto se complementa con la compatibilidad sólida con la API de Deployment , lo que permite a los desarrolladores especificar estos parámetros detallados, incluidas las particiones exactas de memoria de GPU, directamente dentro de una solicitud deployModel estándar y, luego, implementar modelos.
Entrega dinámica de varios modelos
Un avance significativo en nuestro recorrido técnico fue la transición de configuraciones estáticas a una arquitectura de entrega dinámica. Esta capacidad es fundamental para los entornos de producción que se caracterizan por patrones de tráfico que cambian rápidamente, ya que la capacidad de cargar o descargar modelos sin reiniciar el contenedor completo es esencial para mantener la agilidad de la infraestructura y la alta disponibilidad.
La API de actualización dinámica (update_models)
Para abordar las limitaciones inherentes de las implementaciones inmutables, implementamos una API de actualización de modelos especializada dentro del contenedor de hosting compartido de modelos vLLM de Vertex Model Garden. Esta API facilita la recarga en caliente, lo que permite que el servidor ajuste su cartera de modelos alojados sobre la marcha en función de un archivo de configuración centralizado almacenado en un bucket de Cloud Storage.
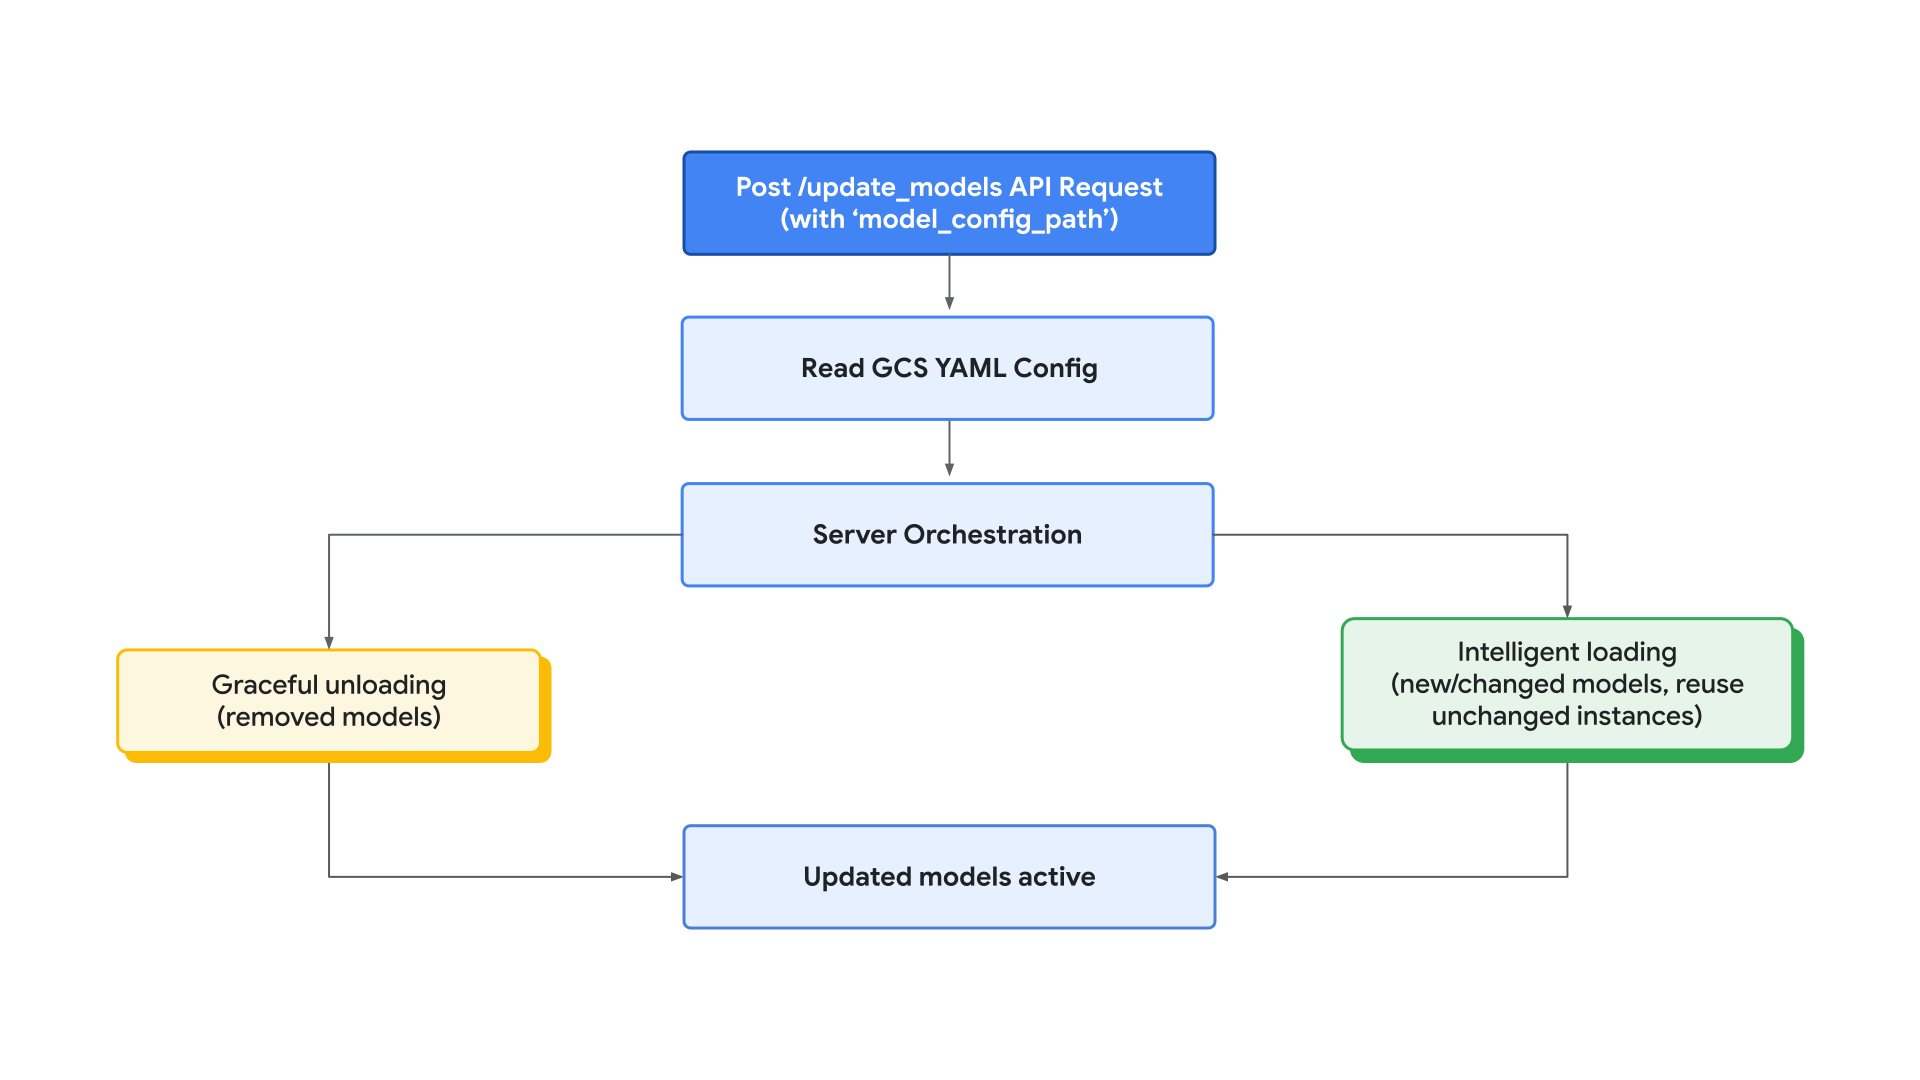
El proceso de actualización se inicia a través de una solicitud POST al extremo update_models, que incluye model_config_path que apunta al archivo YAML de Cloud Storage.
Cuando recibe esta solicitud, el servidor ejecuta una secuencia de orquestación de varias etapas optimizada para un tiempo de inactividad mínimo:
- Descarga correcta: El sistema identifica los modelos que no están en la configuración nueva y finaliza sus subprocesos primero, lo que recupera de inmediato la memoria de la GPU y los recursos de procesamiento.
- Carga y reutilización inteligentes: Luego, el servidor inicializa nuevas instancias de modelos. Es fundamental que, si la configuración de paralelismo de un modelo, como el paralelismo de tensores (TP) o el paralelismo de canalización (PP), y su partición de memoria asignada permanecen sin cambios, el orquestador reutilice la instancia en ejecución existente. Esta optimización omite la costosa fase de reinicialización, lo que garantiza que los servicios activos permanezcan ininterrumpidos durante los cambios de configuración.
Haz clic para ampliar la imagen
Análisis de latencia y rendimiento
El análisis empírico de estas estrategias de actualización revela que la recarga en caliente dinámica mitiga de manera sustancial la penalización de "inicio en frío" que suele asociarse con la entrega de LLM a gran escala.
Conclusión
El hosting compartido de modelos con Vertex AI representa un cambio de paradigma fundamental, que pasa de implementaciones monolíticas rígidas y pesadas de hardware a una arquitectura de entrega fluida y eficiente. Al evolucionar más allá del estándar de "un modelo por VM" a un modelo de grupo de procesamiento de alta densidad, las organizaciones pueden reducir de manera significativa su costo total de propiedad (TCO) y, al mismo tiempo, mantener y, a menudo, mejorar los comparativos de rendimiento.
Nuestro recorrido de ingeniería y los extensos estudios comparativos de varios modelos establecieron un conjunto definitivo de lineamientos de producción para esta arquitectura:
- No existe una configuración única para todo. Recomendamos encontrar la mejor receta de entrega para un caso de uso específico (modelo, hardware, tráfico) y crear herramientas para hacerlo.
- Escalar la capacidad de procesamiento con réplicas.
- Mejorar el uso de recursos mediante la ruptura de los límites de hardware y la división de la memoria en un nivel más detallado.
Para implementar correctamente una arquitectura alojada de forma compartida, recomendamos el siguiente flujo de trabajo técnico:
- Partición explícita: Usa el argumento
--gpu-memory-partitionspara asignar recursos de memoria a modelos individuales. - Comparativos iterativos: Usa la utilidad de comparativos proporcionada para identificar el punto específico de "cruce de simultaneidad" para tu carga de trabajo, la configuración óptima de la cantidad de instancias, TP y PP.
La implementación del hosting compartido en Google Cloud Model Garden proporciona un plano escalable para compilar aplicaciones de IA de alta densidad. Se recomienda a los desarrolladores que exploren estas capacidades y reproduzcan nuestros comparativos con el notebook del instructivo proporcionado para optimizar las configuraciones de entrega para sus requisitos empresariales específicos.
Gracias por leer
Agradecemos tus comentarios y preguntas sobre Vertex AI.
Agradecimientos
Queremos expresar nuestro más sincero agradecimiento al equipo de Vertex AI de Google Cloud. En particular, agradecemos a Bo Wu y Ting Yu por su liderazgo y orientación, así como a Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur y Luis Rizo por sus valiosas contribuciones a lo largo de este proyecto.