

Dans le paysage en constante évolution des grands modèles de langage (LLM), le modèle de déploiement "un modèle par machine" devient un goulot d'étranglement important pour l'efficacité des coûts de diffusion des LLM dans les entreprises. Les LLM nécessitent souvent des réservations matérielles importantes, telles que des nœuds GPU 8x H100 complets, pour gérer les pics de charge. Toutefois, lors des opérations standard, ces ressources coûteuses sont souvent sous-utilisées, ce qui entraîne un coût total de possession (TCO) élevé.
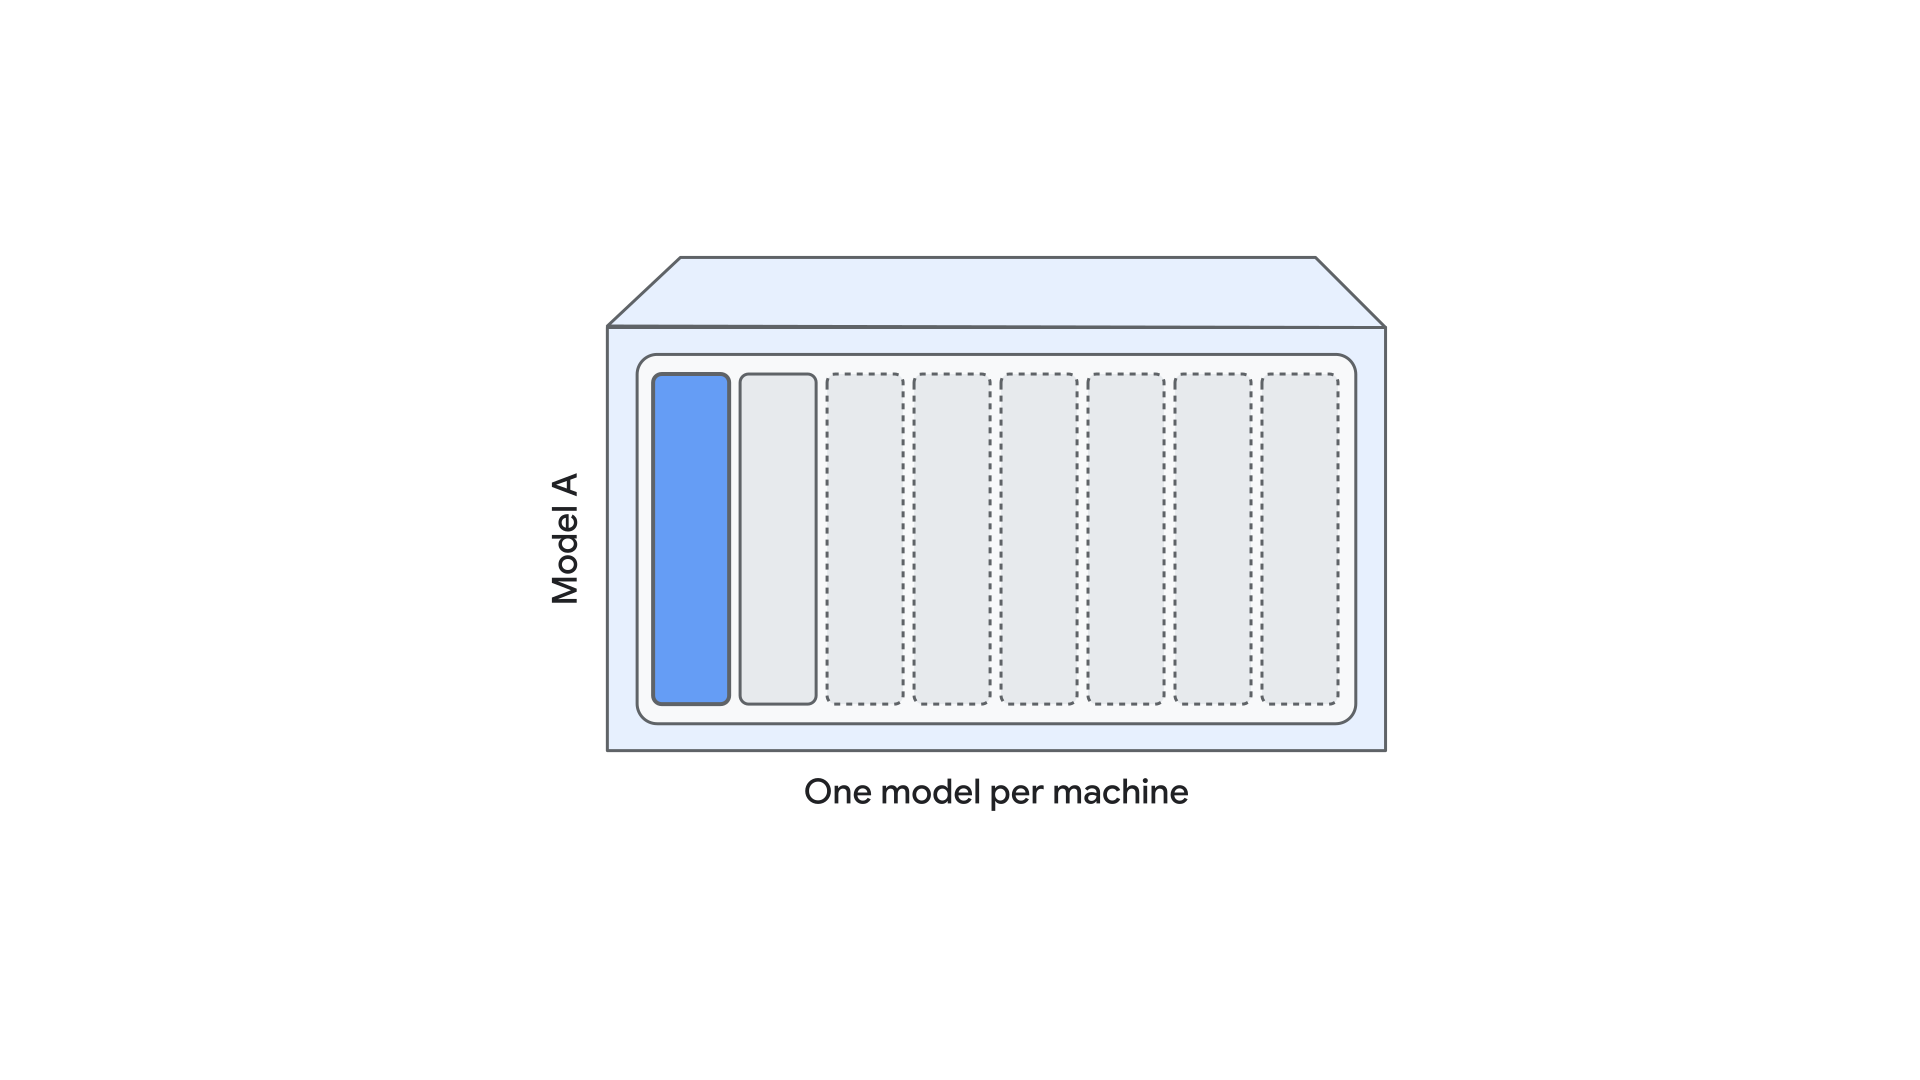
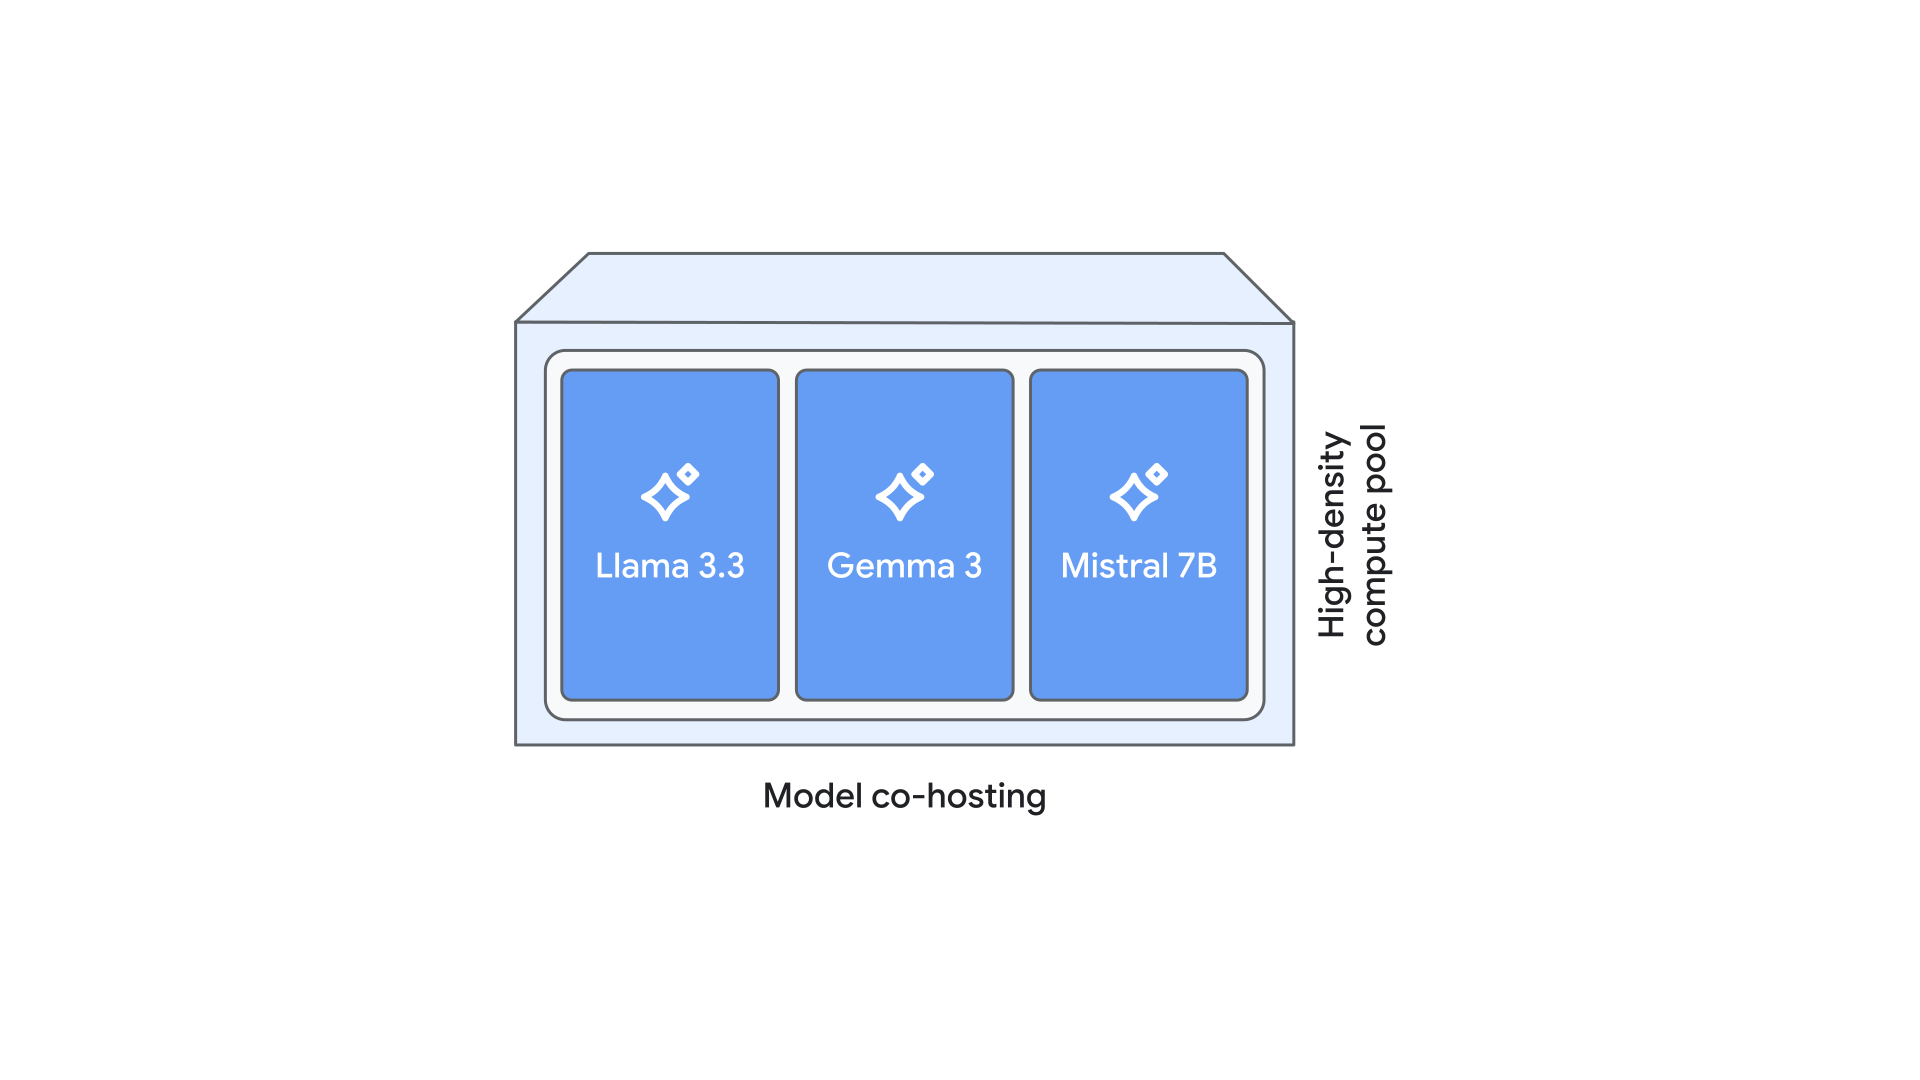
Le co-hébergement de modèles comble ce manque d'efficacité en permettant à plusieurs instances de modèle de partager les mêmes ressources de machine virtuelle et de GPU. Cela inclut des modèles entièrement différents, tels que Llama 3.3 et Gemma 3. En utilisant le découpage de la mémoire du sous-GPU et le partitionnement intelligent des ressources, Vertex AI Model Garden transforme les réservations matérielles statiques en pools de calcul flexibles à haute densité.
Cet article de blog technique décrit le processus d'ingénierie de Vertex AI pour proposer le co-hébergement de modèles en tant que service cloud prêt pour la production. Nous partagerons notre méthodologie pour nos stratégies d'implémentation au niveau du conteneur, l'identification des configurations de diffusion optimales et les principales conclusions de notre étude comparative multi-modèles approfondie, ce qui vous permettra de maximiser l'efficacité des coûts de diffusion de vos LLM.
Comprendre le co-hébergement de modèles : concept et architecture
Le co-hébergement de modèles est une stratégie de diffusion à haute densité qui permet à plusieurs instances de grands modèles de langage (LLM) ou à différentes architectures de modèles de partager les mêmes ressources matérielles physiques au sein d'une même machine virtuelle (VM). Contrairement aux modèles de déploiement traditionnels qui consacrent une VM ou un GPU complet à un seul modèle, le co-hébergement utilise un partitionnement précis des ressources pour maximiser le ROI matériel et améliorer l'utilisation de la mémoire et des ressources de calcul.
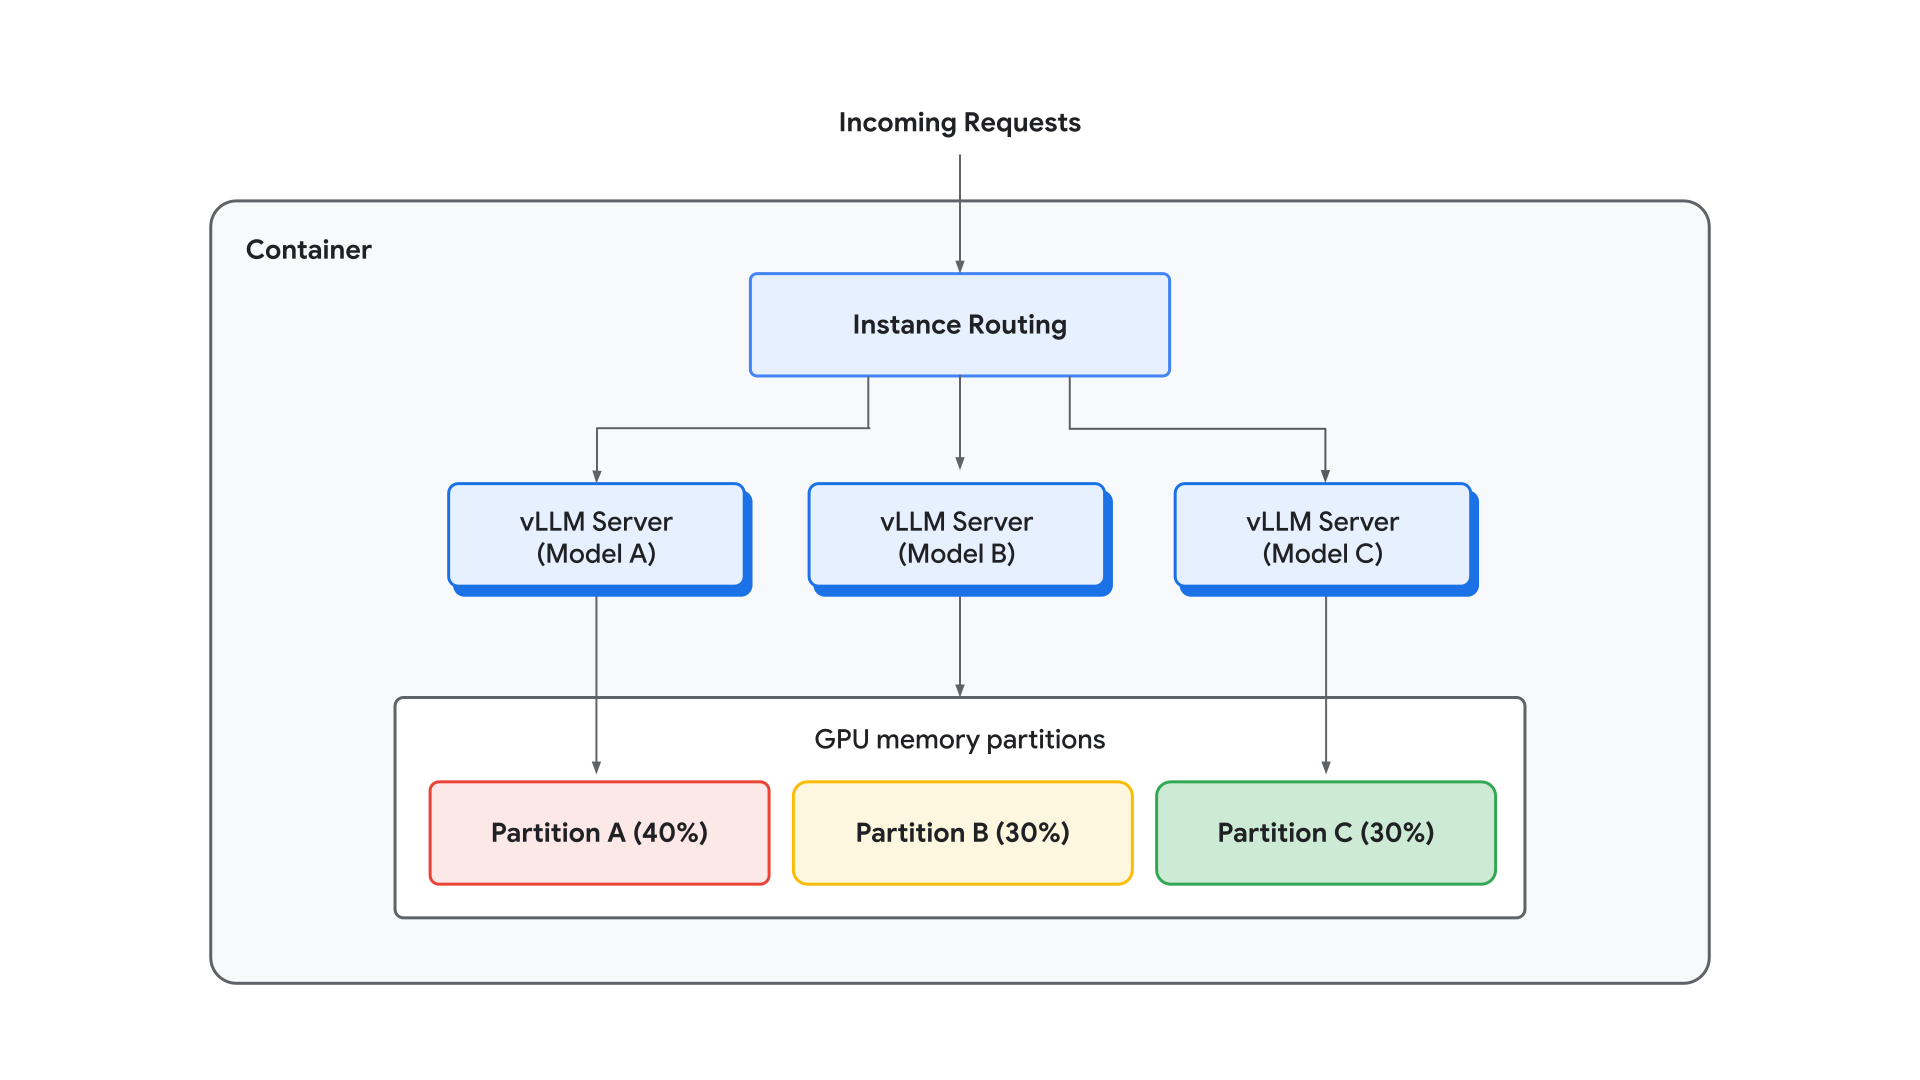
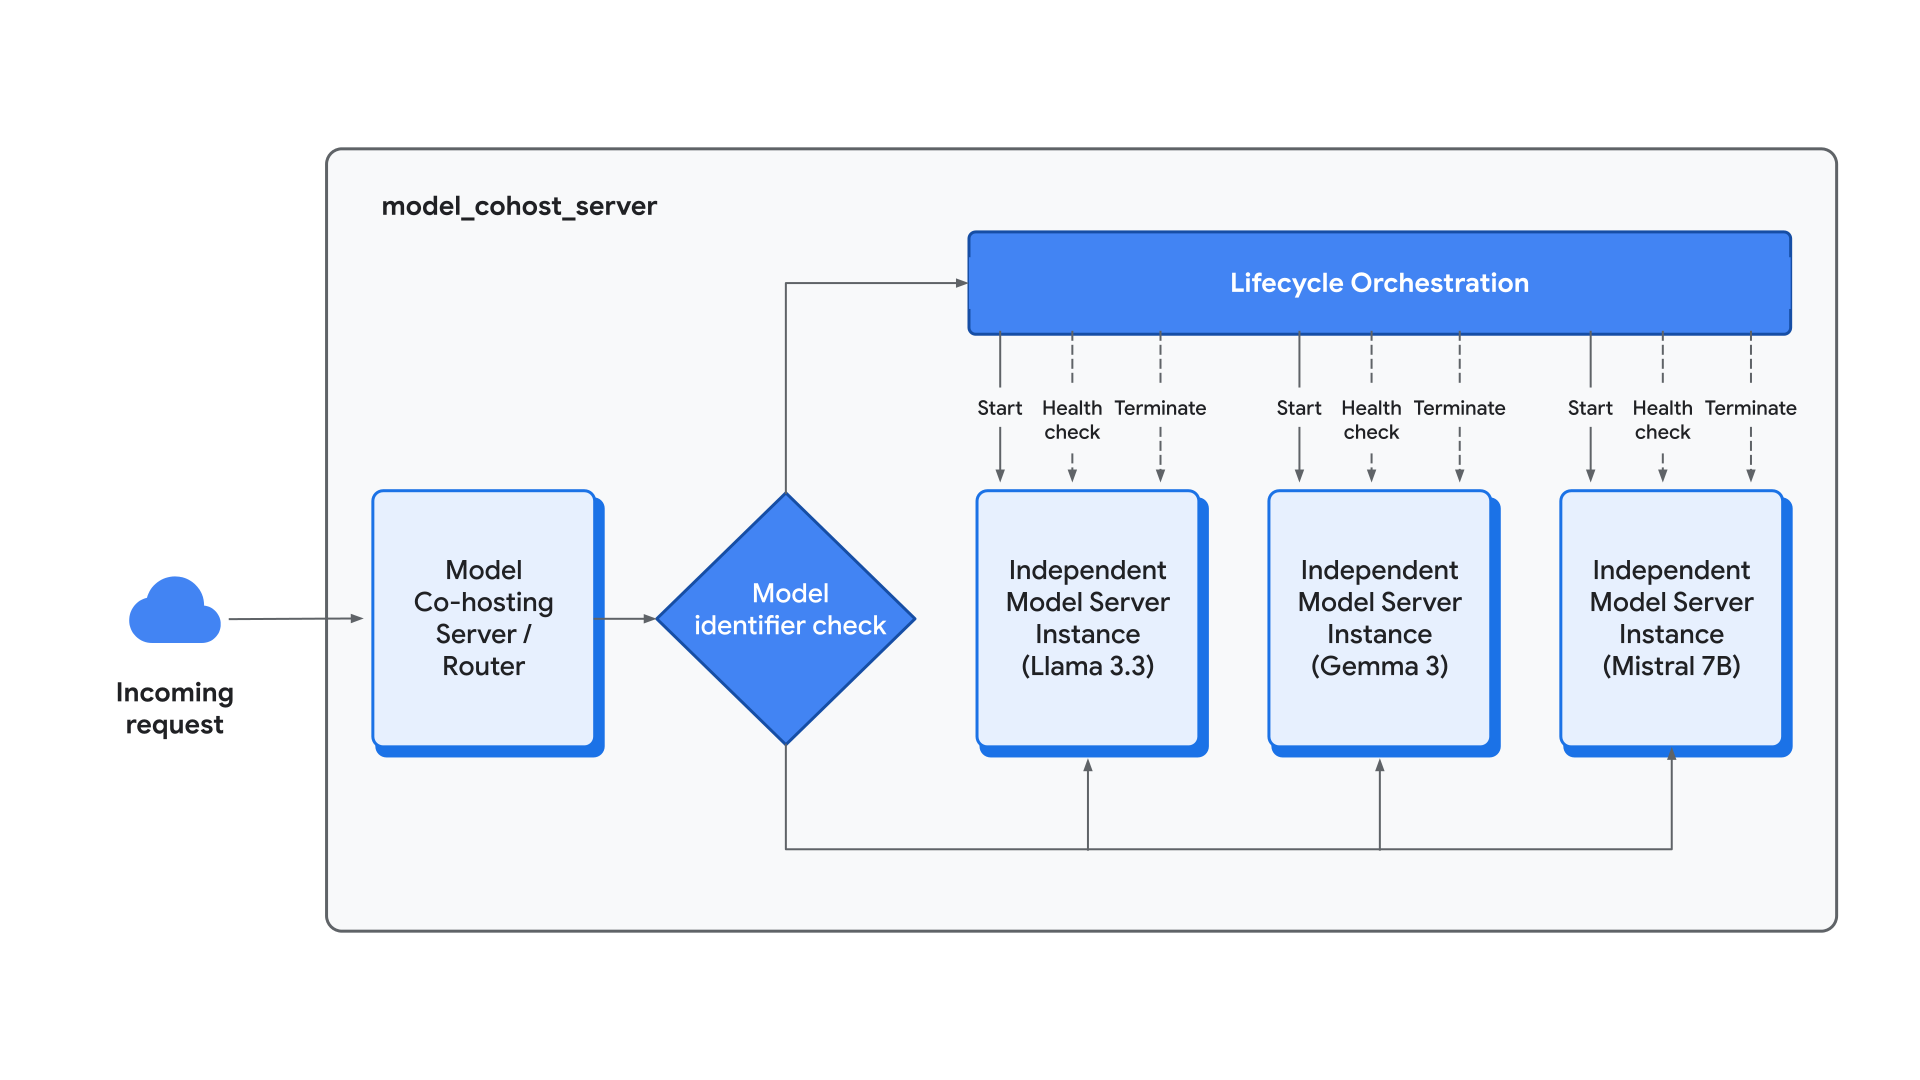
Notre implémentation se concentre sur une solution au niveau du conteneur qui permet la diffusion simultanée de plusieurs modèles avec des configurations indépendantes. Cette architecture fonctionne via plusieurs mécanismes techniques intégrés, à commencer par le déploiement de plusieurs instances de serveur de modèle indépendantes dans un seul conteneur. Chacune de ces instances sert de copie complète et indépendante du serveur de modèle, ce qui permet le traitement simultané des requêtes sur la machine virtuelle. Pour gérer ce trafic, nous avons implémenté une couche de routage d'instance dans le conteneur qui distribue efficacement les requêtes entrantes entre les instances actives.
Cette conception offre un parallélisme précis en permettant à chaque modèle co-hébergé d'utiliser une configuration de diffusion dédiée, avec des paramètres uniques pour le parallélisme tensoriel (TP), le parallélisme de pipeline (PP) et le nombre spécifique d'instances de modèle. Ceci est complété par le découpage des ressources, où des partitions de mémoire GPU spécifiques sont attribuées à chaque modèle (par exemple, une partition de mémoire GPU de 0,4 par modèle) pour garantir que différentes charges de travail coexistent sur le même accélérateur sans se priver mutuellement de ressources mémoire critiques. Cette approche architecturale transforme une réservation matérielle statique, telle qu'un nœud GPU 8x H100 complet, en un pool de calcul flexible capable de diffuser un portefeuille diversifié, allant des grands modèles de raisonnement aux petits modèles de chat à faible latence.
Prototypage et étude comparative
Avant de développer notre orchestrateur prêt pour la production, nous avons mené une étude comparative complète pour valider l'efficacité théorique du co-hébergement de modèles. Cette phase visait à tester en profondeur vLLM's parallélisme natif et à quantifier précisément le degré d'"interférence" lorsque les modèles partagent le même silicium.
Investigation sur le parallélisme : trouver le "point de croisement"
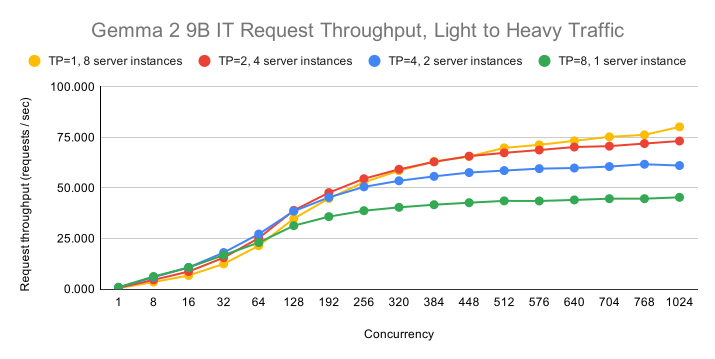
Notre analyse initiale s'est concentrée sur le parallélisme tensoriel (TP) natif de vLLM et sur l'implémentation Vertex des instances de modèle en tant que plusieurs instances de serveur vLLM afin de déterminer comment ces stratégies interagissent avec des charges utilisateur variables. Nous avons découvert que la configuration optimale dépend fortement de la simultanéité. À des simultanéités plus faibles, un parallélisme tensoriel élevé (par exemple, TP=8) offre la latence la plus faible pour les requêtes individuelles en distribuant les couches sur tous les accélérateurs disponibles. Toutefois, à mesure que le trafic simultané augmente, le goulot d'étranglement se déplace. Pour maximiser le débit dans des conditions de charge élevée, la configuration optimale passe de TP=8 à TP=4, TP=2, puis à TP=1, tout en augmentant simultanément le nombre d'instances de modèle indépendantes. Cette transition définit un "point de croisement" où les avantages d'une latence de communication inter-GPU réduite dans les configurations à faible TP l'emportent sur la vitesse brute d'exécution à TP élevé. Vous trouverez ci-dessous un graphique de point de croisement avec le modèle Gemma 2 9B IT.
Scaling optimal : modèle unique, plusieurs instances dupliquées
Pour établir une référence rigoureuse en matière d'évolutivité, nous avons comparé la diffusion de plusieurs instances du même modèle sur un seul nœud. Dans des conditions de trafic saturé (2 048 requêtes simultanées par GPU), le lancement de huit instances de serveur vLLM indépendantes sur un nœud 8xH100 a permis d'améliorer le débit d'environ 7,8 fois avec une régression de latence pratiquement nulle par rapport à une référence à un seul GPU.
Comparaison de l'infrastructure : co-planification des conteneurs et des pods
Nous avons ensuite évalué notre orchestration au niveau du conteneur par rapport aux solutions natives au niveau de l'infrastructure, en particulier la co-planification des pods. Bien que les deux solutions aient sans frais des performances comparables pour la diffusion multi-instances dupliquées, nous avons finalement sélectionné l'approche au niveau du conteneur pour notre produit minimum viable (MVP). Cette décision a été motivée par la flexibilité supérieure offerte par la solution au niveau du conteneur pour le co-hébergement hétérogène, qui permet aux développeurs de servir différentes architectures de modèles côte à côte avec des partitions de mémoire définies par logiciel précises qui ne sont pas limitées par les contraintes d'ordonnancement Kubernetes sous-jacentes. De plus, l'orchestration au niveau du conteneur permet d'itérer beaucoup plus rapidement et il est plus facile de personnaliser et d'innover.
Le test d'interférence : co-hébergement de différents modèles
La dernière étape de prototypage était le "test d'interférence", où nous avons co-hébergé Gemma-3n-E2B-it et Llama-3.1-8B-Instruct sur la même VM. Chaque modèle étant attribué à une partition de mémoire GPU de 0,4, les performances de diffusion sont restées presque identiques aux benchmarks à modèle unique. Par exemple, Gemma-3n a atteint 30,21 requêtes dans un environnement co-hébergé, contre 30,96 requêtes en isolation. Ces résultats confirment qu'il n'y a que peu ou pas d'interférence de calcul entre les modèles co-hébergés, même en cas de trafic intense, à condition que les ressources mémoire soient correctement partitionnées pour éviter la famine du cache KV.
Implémentation du conteneur MVP
La transition d'un benchmark validé à un système prêt pour la production a nécessité l'ingénierie d'un orchestrateur conteneurisé robuste. Cette phase de développement s'est concentrée sur la création d'une couche logicielle de haut niveau capable de gérer la complexité de plusieurs cycles de vie de modèles tout en garantissant une isolation déterministe des ressources.
Conception du serveur de co-hébergement de modèles
Le cœur de notre implémentation est model_cohost_server, un point d'entrée personnalisé conçu pour agir en tant qu'orchestrateur principal dans le conteneur. S'écartant du modèle standard à processus unique, ce serveur implémente la gestion des sous-processus, ce qui facilite l'exécution simultanée de plusieurs instances de serveur de modèle indépendantes, telles que vLLM, en tant que sous-processus isolés. Pour gérer le trafic entrant, l'orchestrateur utilise un routage de requêtes de haut niveau, en identifiant les requêtes par leurs identifiants de modèle uniques via des arguments tels que --served-model-name et en les dirigeant vers l'instance de serveur interne correspondante. Au-delà du routage, le serveur fournit une orchestration
complète du cycle de vie, en gérant l'initialisation, la surveillance de l'état et l'arrêt
de toutes les instances co-hébergées. Cette gestion centralisée fournit un point de terminaison unique et unifié pour le trafic externe tout en conservant les limites opérationnelles distinctes de chaque sous-processus.
Partitionnement des ressources GPU : découpage déterministe
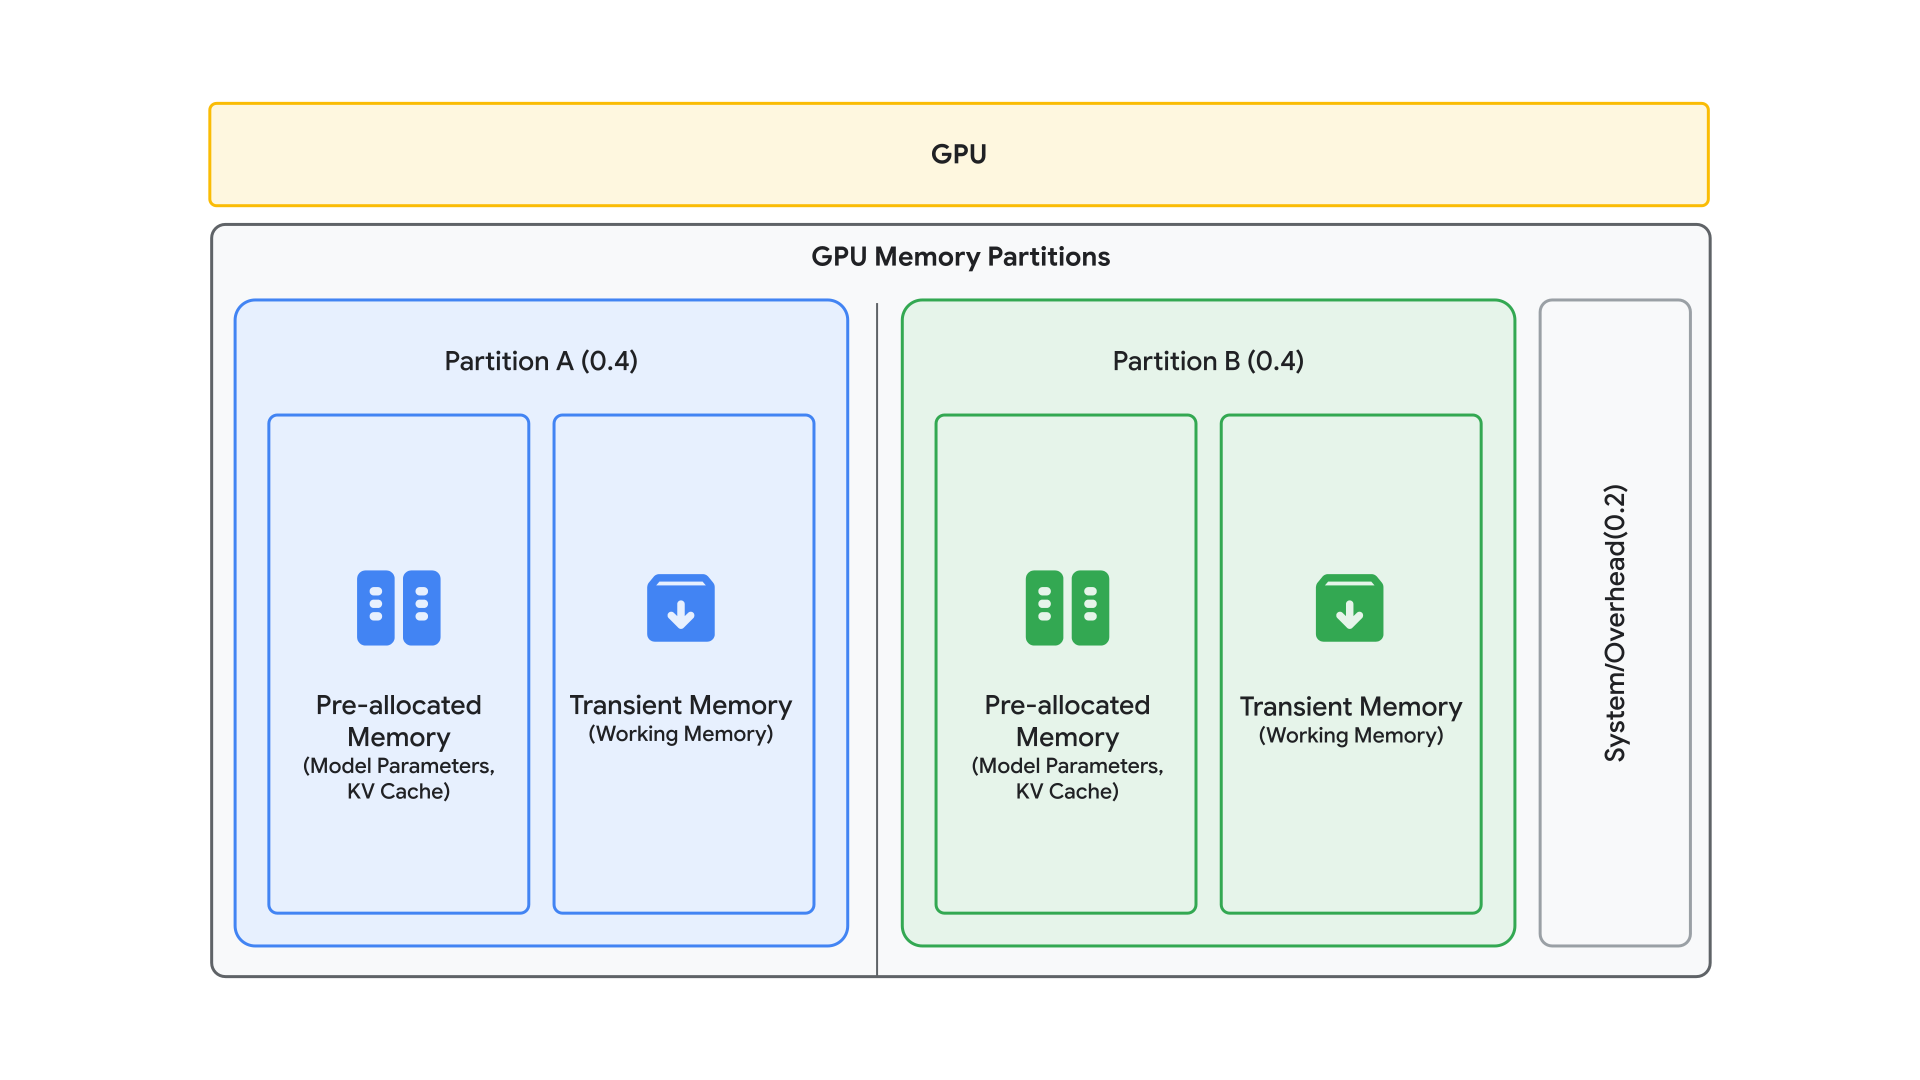
Pour éliminer le risque qu'une charge de travail d'un seul modèle déclenche une erreur de mémoire insuffisante (OOM) dans l'environnement co-hébergé, nous avons implémenté un mécanisme strict de découpage des ressources. Cela est opérationnalisé via l'argument gpu-memory-partition, qui permet aux développeurs de définir des ratios de mémoire explicites (par exemple, 0,4, 0,4) pour réserver un pourcentage fixe de la mémoire GPU totale d'un nœud pour chaque instance de modèle individuelle.
Pour guider cette allocation, nous adoptons un "pré-allouée par rapport à transitoire" mémoire
modèle, qui distingue les exigences de ressources statiques et dynamiques.
La mémoire "pré-allouée" est constituée de la mémoire utilisée pour les pondérations du modèle et le cache KV. La quantité de mémoire utilisée pour les pondérations du modèle dépend du nombre de paramètres et de la précision du modèle. Par exemple, un modèle de paramètre 8B en BF16 nécessite environ 16 Go de stockage statique. La quantité de mémoire utilisée pour le cache KV dépend des dimensions, de la précision, de la longueur de contexte et du nombre de séquences du modèle. "Transient" memory est constituée de calculs intermédiaires et de
mémoire de travail d'inférence. L'argument gpu-memory-partition tient compte de la mémoire "pré-allouée". Nous vous recommandons de laisser une marge de manœuvre pour la mémoire "transitoire" en définissant la somme des gpu-memory-partition sur une valeur inférieure à 1,0.
Produit
La phase de produit du co-hébergement de modèles avec Vertex AI était dédiée à l'établissement d'un environnement transparent et prêt pour la production pour les configurations de diffusion multi-instances dupliquées à modèle unique et multi-modèles. Cette transition a effectivement traduit les résultats empiriques des benchmarks en workflows de déploiement simplifiés et en structures de support d'infrastructure profondément intégrées.
Workflows de déploiement simplifiés
Pour réduire la barrière à l'entrée pour la diffusion à haute densité, nous avons standardisé les configurations de co-hébergement à l'aide d'arguments de conteneur personnalisés qui s'intègrent de manière native aux API Vertex AI existantes. Pour les machines virtuelles de forme complète, telles qu'un nœud 8x H100, nous avons développé un utilitaire de benchmark pour personnaliser les meilleures recettes pour vos cas d'utilisation spécifiques. Ces benchmark utilitaire vous permettrait de trouver la configuration qui équilibre automatiquement le parallélisme tensoriel (TP), le parallélisme de pipeline (PP), et le nombre d'instances de modèle en fonction du nombre de paramètres et de la précision spécifiques du modèle. Ceci est complété par une prise en charge robuste de l'API de déploiement , qui permet aux développeurs de spécifier ces paramètres précis, y compris les partitions exactes de mémoire GPU, directement dans une requête deployModel standard et de déployer des modèles.
Diffusion dynamique multi-modèles
Une avancée significative dans notre parcours technique a été la transition des configurations statiques à une architecture de diffusion dynamique. Cette fonctionnalité est essentielle pour les environnements de production caractérisés par des schémas de trafic en évolution rapide, car la possibilité de charger ou de décharger des modèles sans redémarrage complet du conteneur est essentielle pour maintenir l'agilité et la haute disponibilité de l'infrastructure.
L'API de mise à jour dynamique (update_models)
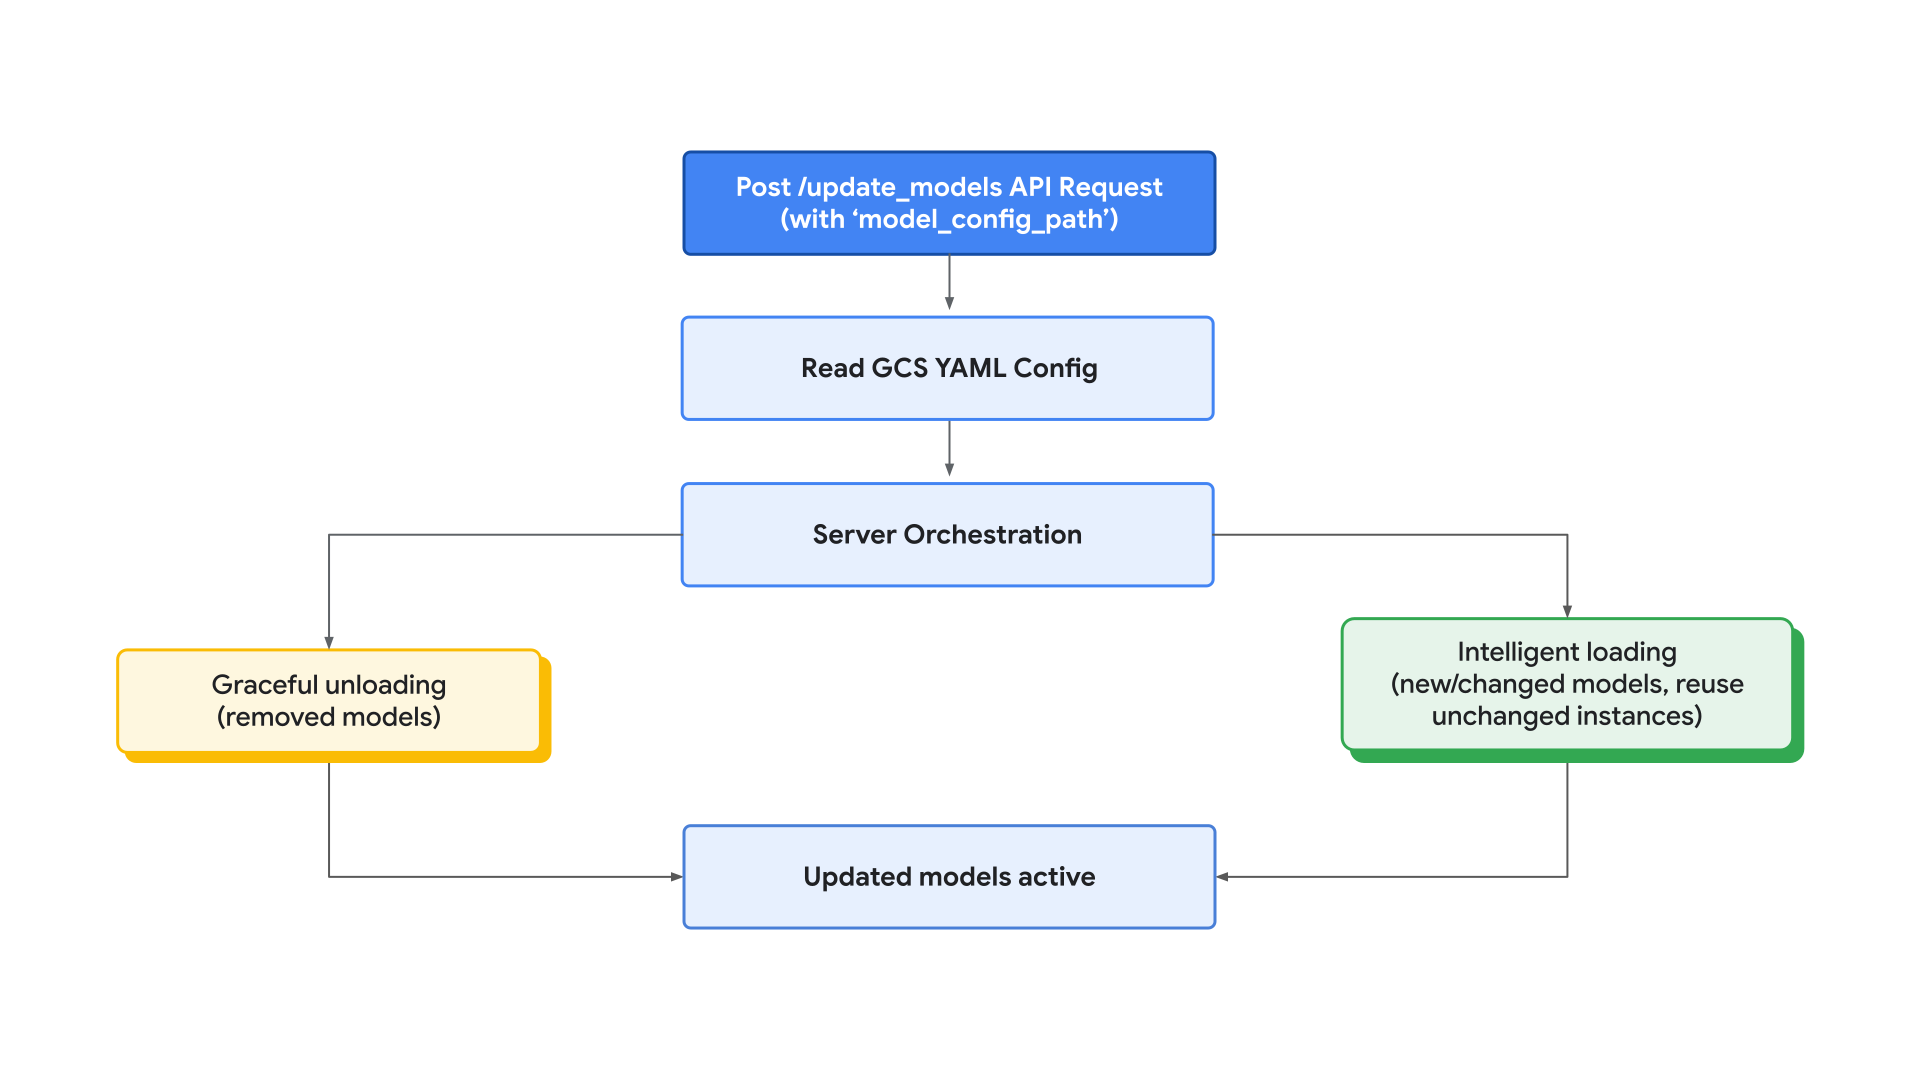
Pour résoudre les limites inhérentes aux déploiements immuables, nous avons implémenté une API de mise à jour de modèle spécialisée dans le conteneur de co-hébergement de modèles vLLM Vertex Model Garden. Cette API facilite le rechargement à chaud, ce qui permet au serveur d'ajuster son portefeuille de modèles hébergés à la volée en fonction d'un fichier de configuration centralisé stocké dans un bucket Cloud Storage.
Le processus de mise à jour est lancé via une requête POST au point de terminaison update_models, qui inclut le model_config_path pointant vers le fichier YAML Cloud Storage.
Lors de la réception de cette requête, le serveur exécute une séquence d'orchestration en plusieurs étapes optimisée pour un temps d'arrêt minimal :
- Déchargement progressif : le système identifie les modèles absents de la nouvelle configuration et arrête d'abord leurs sous-processus, en récupérant immédiatement la mémoire GPU et les ressources de calcul.
- Chargement et réutilisation intelligents : le serveur initialise ensuite de nouvelles instances de modèle. Il est essentiel de noter que si les paramètres de parallélisme d'un modèle, tels que le parallélisme tensoriel (TP) ou le parallélisme de pipeline (PP), et sa partition de mémoire allouée restent inchangés, l'orchestrateur réutilise l'instance en cours d'exécution existante. Cette optimisation contourne la phase de réinitialisation coûteuse, ce qui garantit que les services actifs restent ininterrompus lors des changements de configuration.
Analyse des performances et de la latence
L'analyse empirique de ces stratégies de mise à jour révèle que le rechargement à chaud dynamique atténue considérablement la pénalité de "démarrage à froid" couramment associée à la diffusion de LLM à grande échelle.
Conclusion
Le co-hébergement de modèles avec Vertex AI représente un changement de paradigme fondamental, passant de déploiements monolithiques rigides et lourds en matériel à une architecture de diffusion fluide et efficace. En évoluant au-delà de la norme "un modèle par VM" vers un modèle de pool de calcul à haute densité, les organisations peuvent réduire considérablement leur coût total de possession (TCO) tout en maintenant, voire en améliorant, les benchmarks de performances.
Notre parcours d'ingénierie et nos études comparatives multi-modèles approfondies ont établi un ensemble définitif de consignes de production pour cette architecture :
- Il n'existe pas de configuration universelle. Nous préconisons de trouver la meilleure recette de diffusion pour un cas d'utilisation spécifique (modèle, matériel, trafic) et de créer des outils pour ce faire.
- Scaling du débit avec des instances dupliquées.
- Améliorer l'utilisation des ressources en supprimant les limites matérielles et en divisant la mémoire à un niveau plus précis.
Pour implémenter correctement une architecture co-hébergée, nous vous recommandons le workflow technique suivant :
- Partitionnement explicite : utilisez l'argument
--gpu-memory-partitionspour allouer des ressources mémoire à des modèles individuels. - Benchmark itératif : utilisez l'utilitaire de benchmark fourni pour identifier le point de croisement de simultanéité spécifique à votre charge de travail, c'est-à-dire la configuration optimale du nombre d'instances, du TP et du PP.
L'implémentation du co-hébergement sur Google Cloud Model Garden fournit un plan évolutif pour la création d'applications d'IA à haute densité. Les développeurs sont encouragés à explorer ces fonctionnalités et à reproduire nos benchmarks à l'aide du notebook de tutoriel fourni pour optimiser les configurations de diffusion en fonction des exigences spécifiques de leur entreprise.
Merci pour votre attention
N'hésitez pas à nous faire part de vos commentaires et questions sur Vertex AI.
Remerciements
Nous tenons à exprimer notre sincère gratitude à l'équipe Google Cloud Vertex AI. Plus précisément, nous remercions Bo Wu et Ting Yu pour leur leadership et leurs conseils, ainsi que Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur et Luis Rizo pour leurs précieuses contributions tout au long de ce projet.