

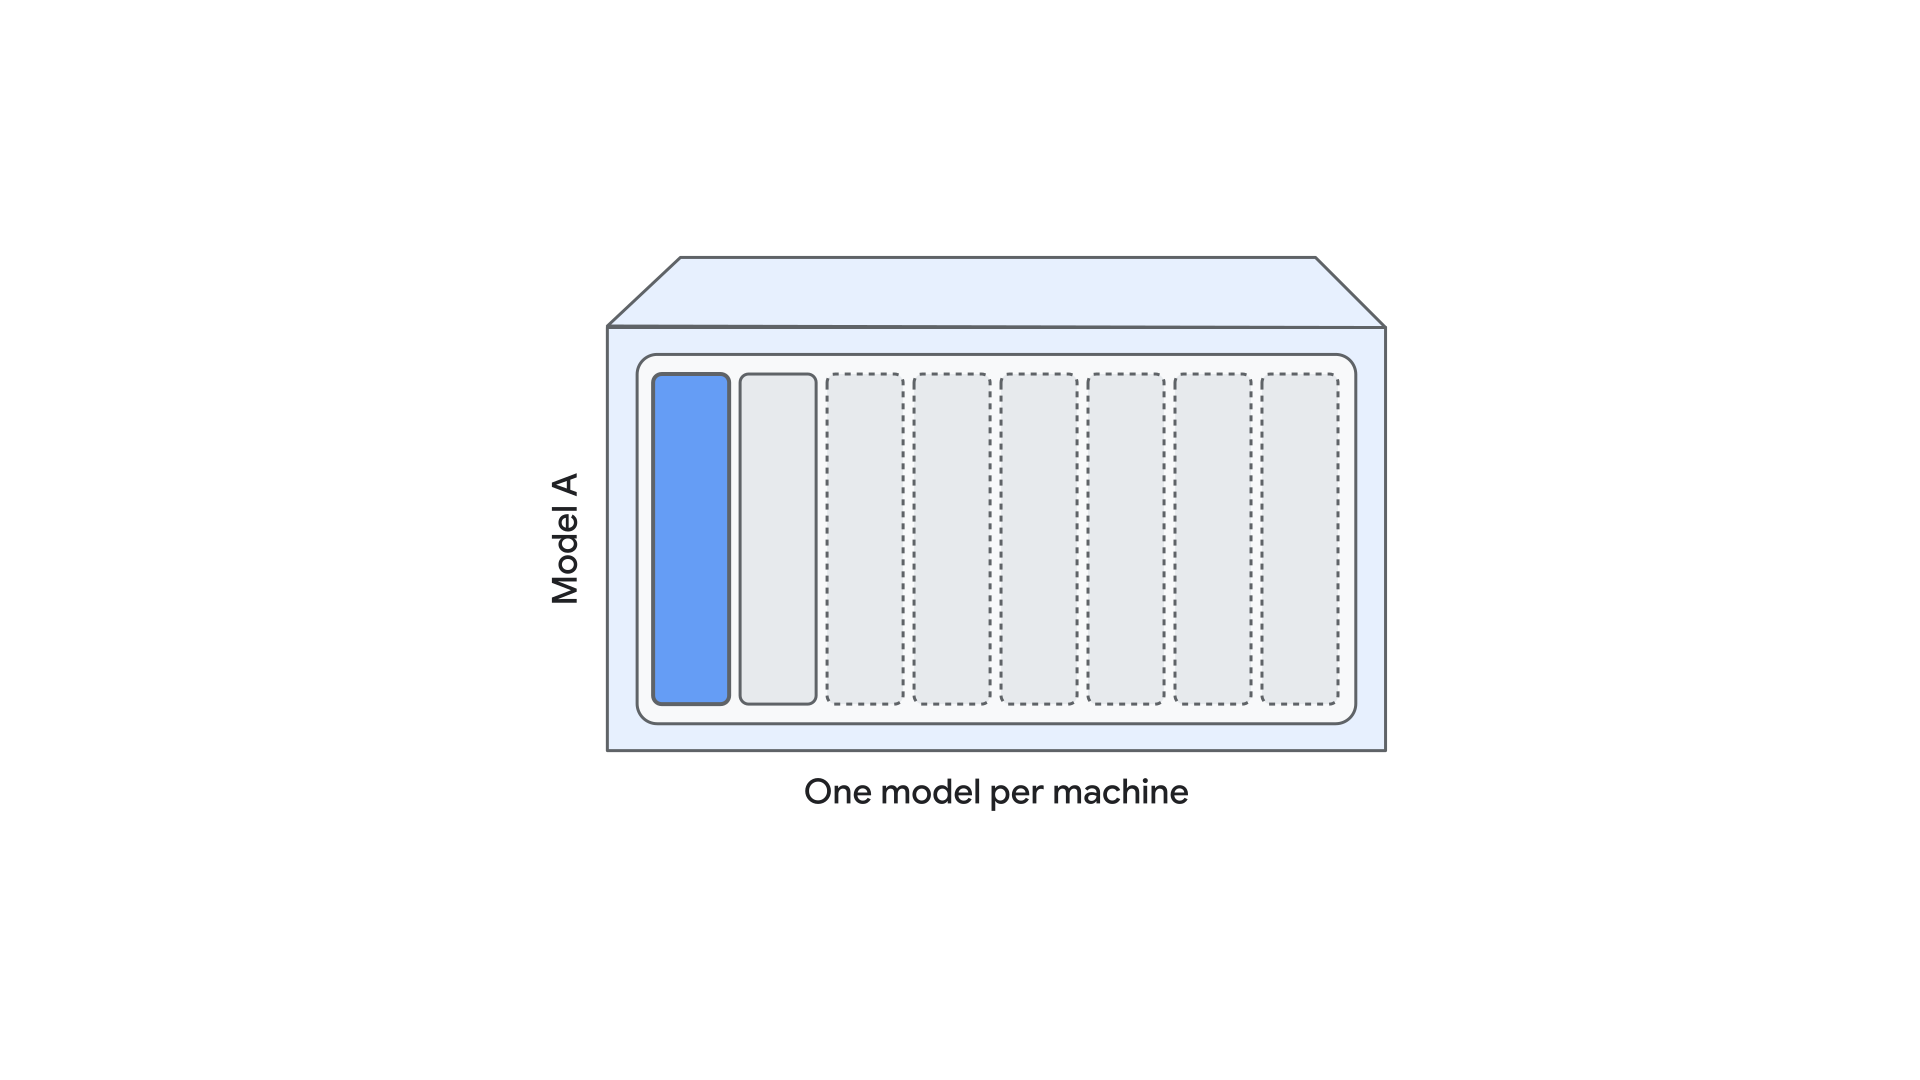
בנוף המתפתח של מודלים גדולים של שפה (LLM), דפוס הפריסה 'מודל אחד לכל מכונה' הופך לצוואר בקבוק משמעותי בהגשת LLM יעילה מבחינת עלויות בארגונים. מודלים גדולים של שפה (LLM) דורשים בדרך כלל הזמנות משמעותיות של חומרה, כמו צמתים מלאים של 8x H100 GPU, כדי לנהל עומסי שיא. אבל במהלך פעולות רגילות, המשאבים היקרים האלה לא מנוצלים מספיק, מה שמוביל לעלות כוללת גבוהה של הבעלות (TCO).
כדי להגדיל את התמונה, לוחצים עליה
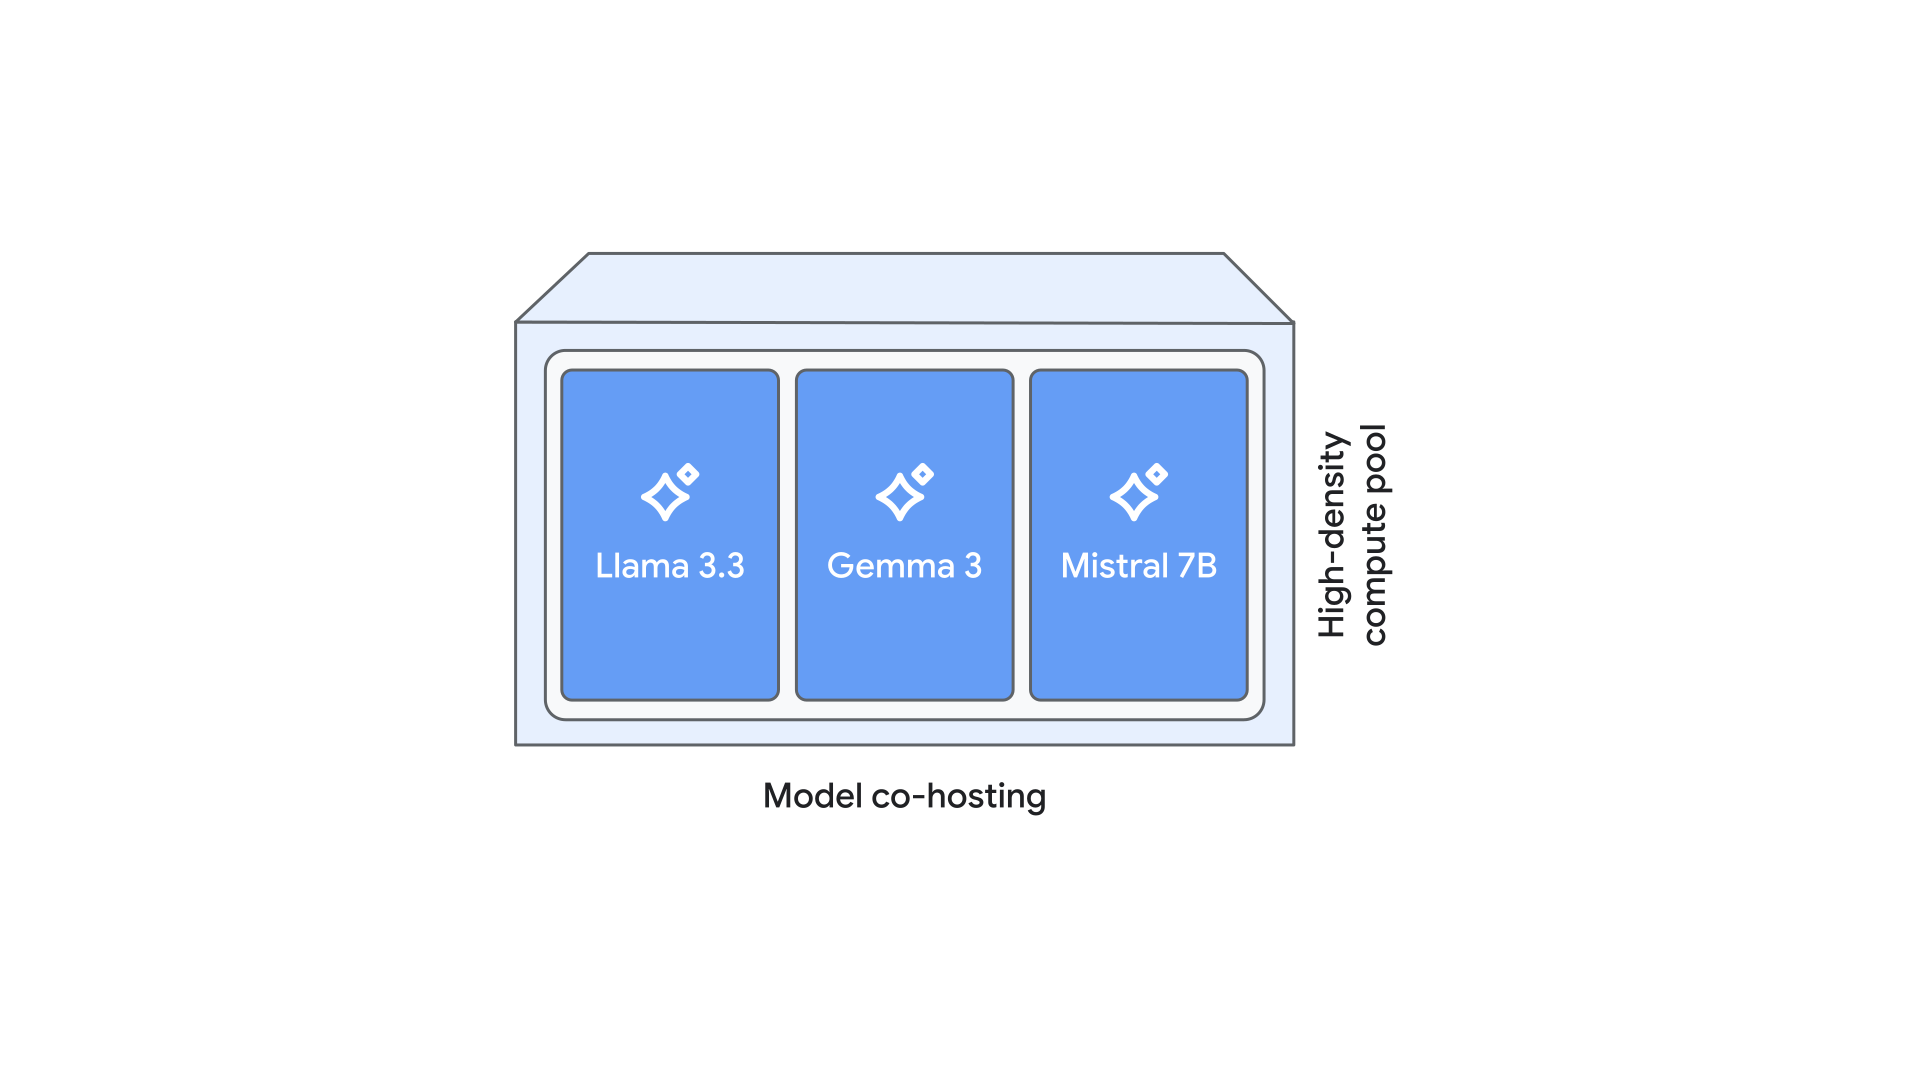
אירוח משותף של מודלים מאפשר לכמה מופעים של מודלים לחלוק את אותה מכונה וירטואלית ואת אותם משאבי GPU, וכך מצמצם את הפער הזה ביעילות. זה כולל מודלים שונים לחלוטין, כמו Llama 3.3 ו-Gemma 3. באמצעות חלוקת זיכרון ה-GPU וחלוקה חכמה של משאבים, Vertex AI Model Garden הופך הזמנות סטטיות של חומרה למאגרי מחשוב גמישים בצפיפות גבוהה.
כדי להגדיל את התמונה, לוחצים עליה
בבלוג הטכני הזה נסביר על התהליך של צוות Vertex AI Engineering בהוספת אירוח משותף של מודלים לשירות ענן שמוכן לייצור. נשתף את המתודולוגיה שלנו לגבי אסטרטגיות הטמעה ברמת הקונטיינר, נזהה הגדרות אופטימליות להצגת מודעות ונציג ממצאים מרכזיים ממחקר ההשוואה המקיף שלנו בין כמה מודלים, כדי שתוכלו למקסם את היעילות של עלויות ההצגה של מודלים גדולים של שפה (LLM).
הסבר על אירוח משותף של מודלים: קונספט וארכיטקטורה
אירוח משותף של מודלים הוא אסטרטגיית הגשה בצפיפות גבוהה שמאפשרת למספר מופעים של מודלים גדולים של שפה (LLM) או לארכיטקטורות שונות של מודלים לחלוק את אותם משאבי חומרה פיזיים במכונה וירטואלית (VM) אחת. בניגוד למודלים מסורתיים של פריסה שמקצים מכונה וירטואלית או GPU מלאים למודל יחיד, אירוח משותף משתמש בחלוקת משאבים מדויקת כדי למקסם את ההחזר על ההשקעה בחומרה ולשפר את השימוש בזיכרון ובמשאבי מחשוב.
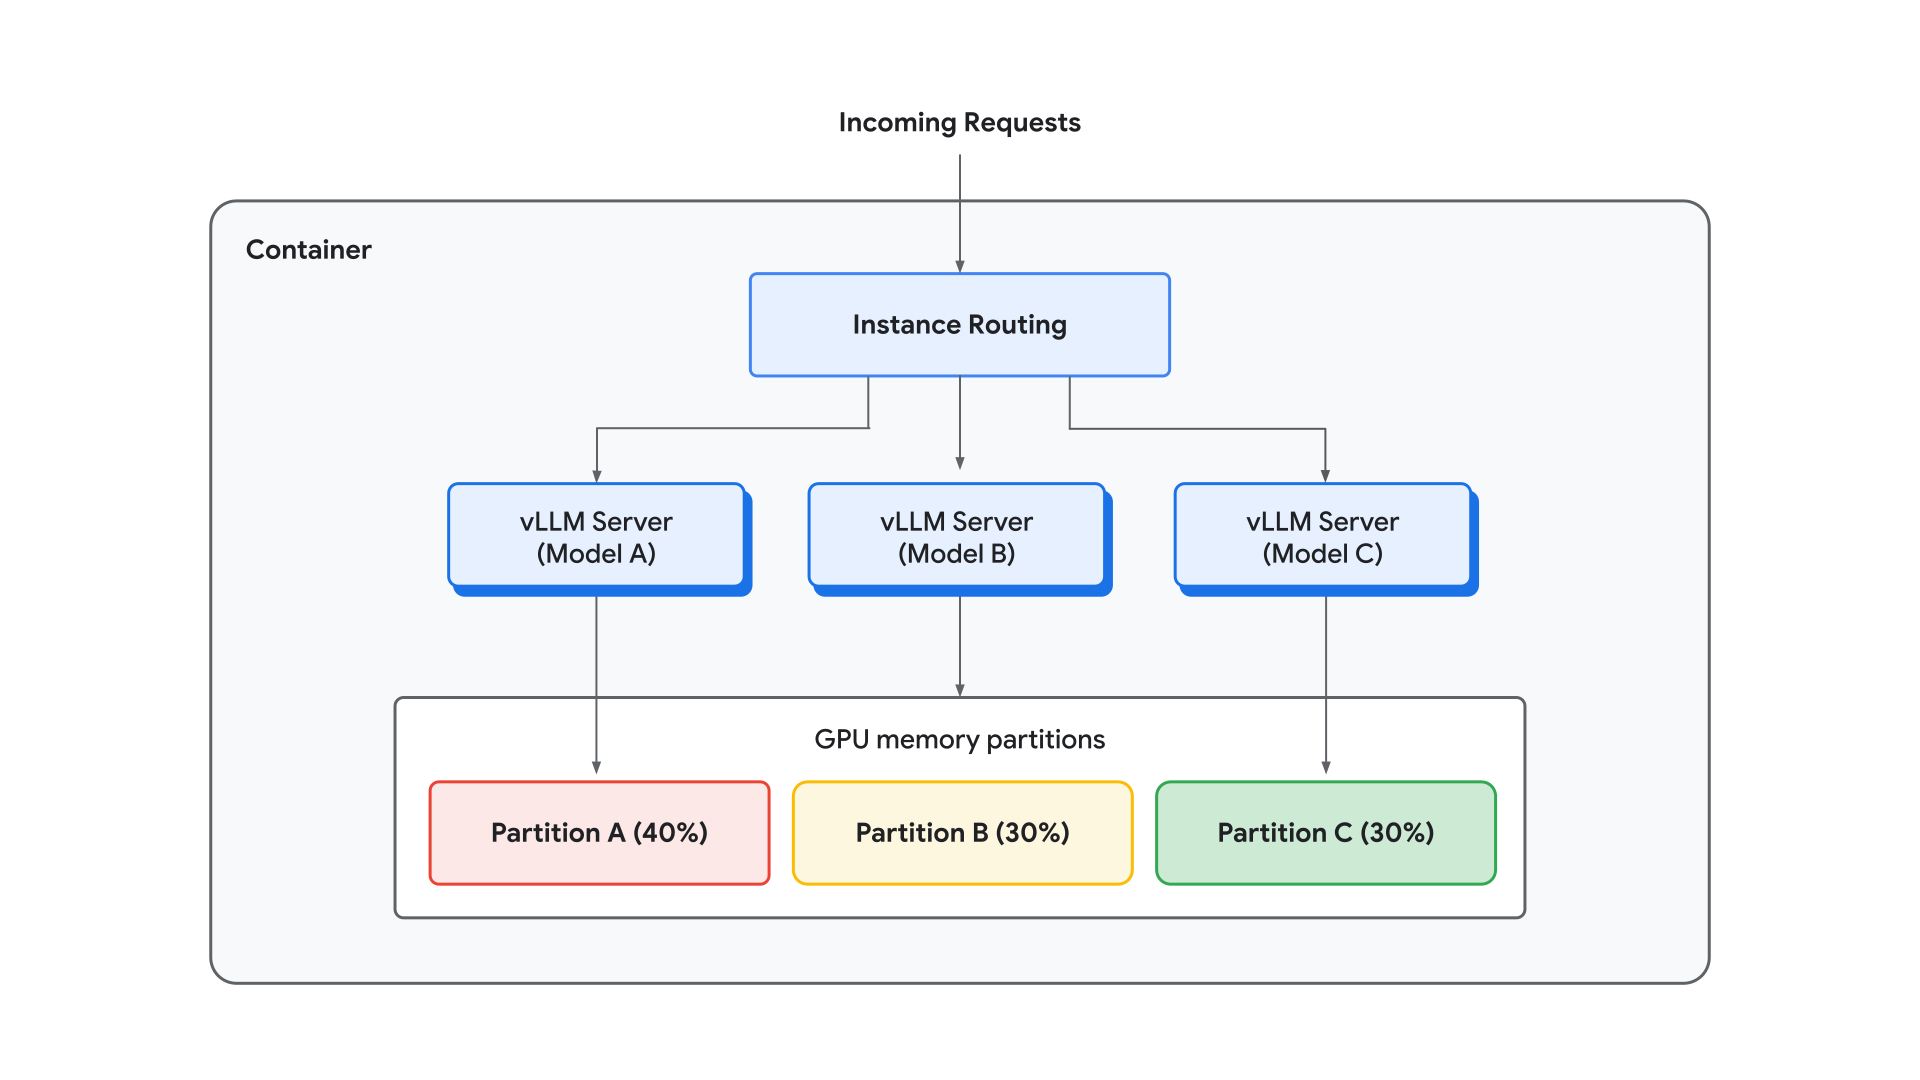
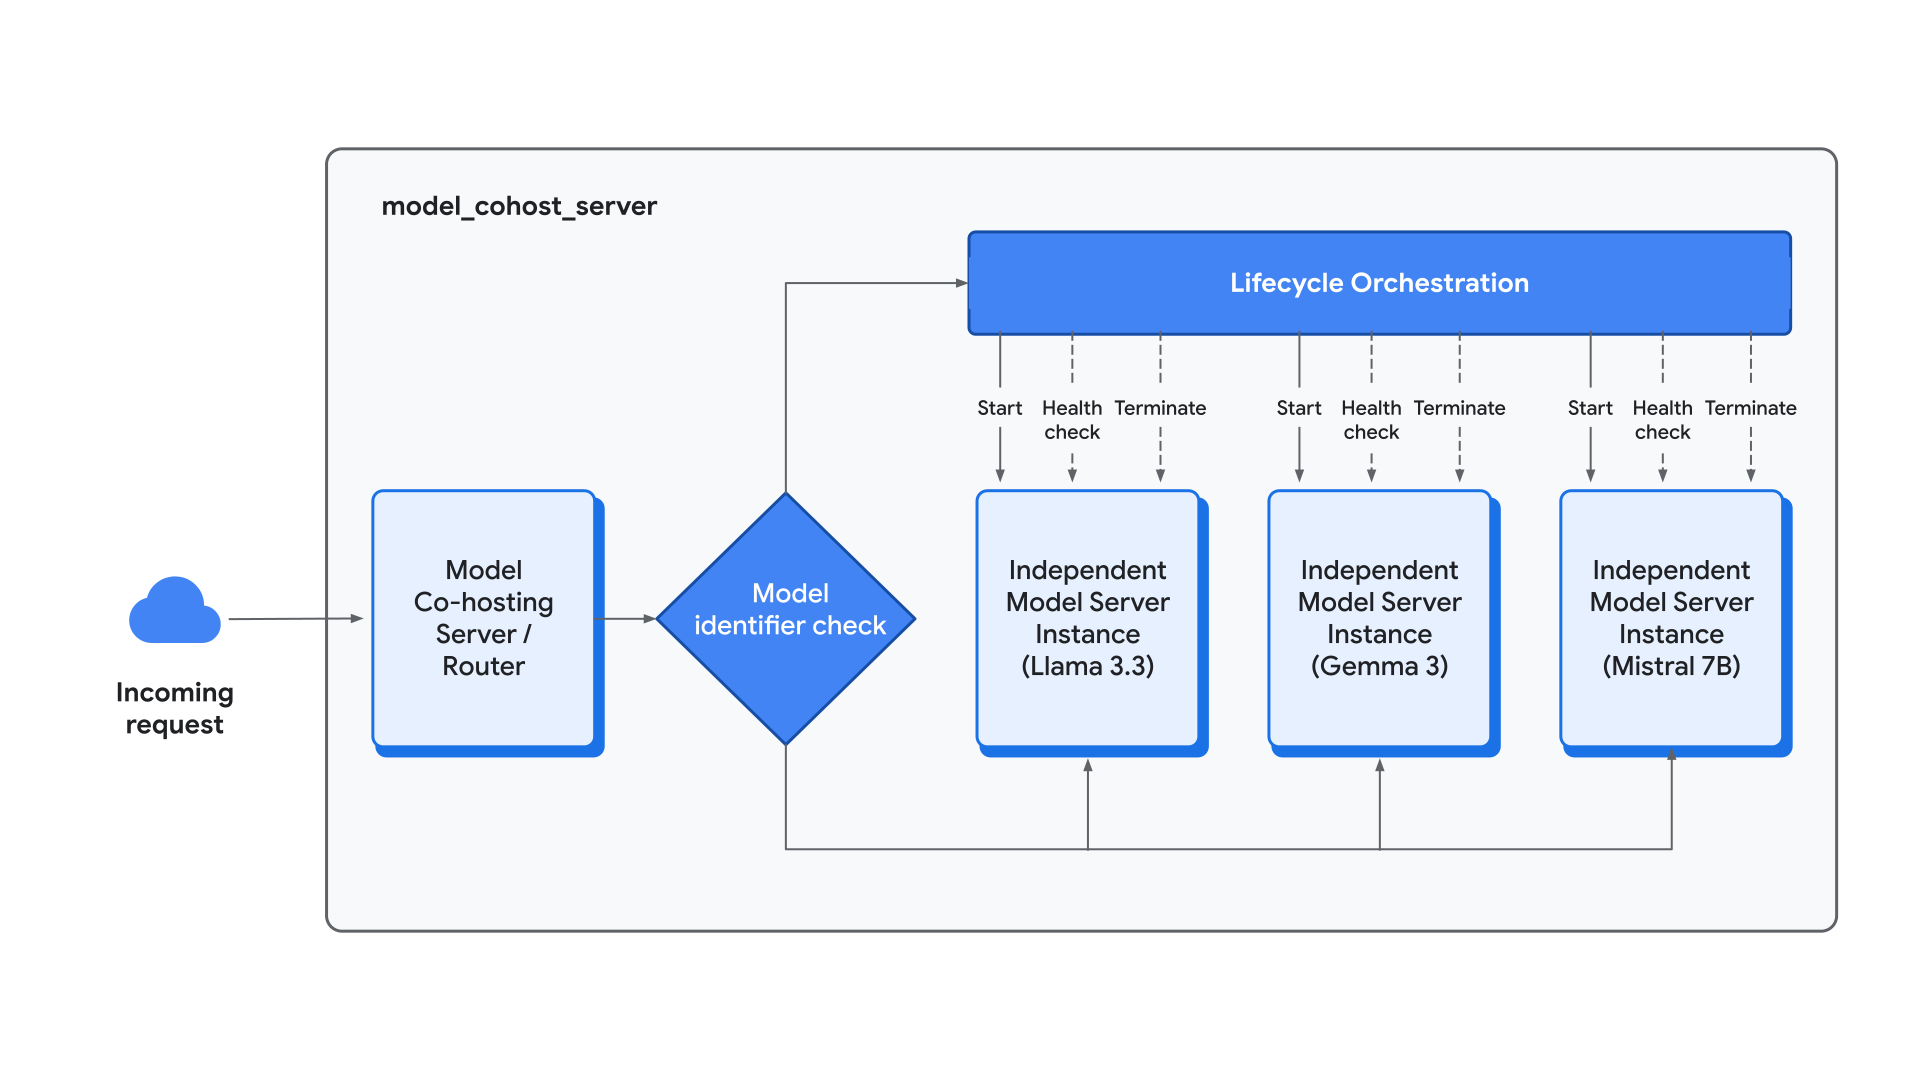
ההטמעה שלנו מתמקדת בפתרון ברמת מאגר התגים, שמאפשר הצגה בו-זמנית של כמה מודלים עם הגדרות נפרדות. הארכיטקטורה הזו פועלת באמצעות כמה מנגנונים טכניים משולבים, החל מפריסה של כמה מופעים עצמאיים של שרת מודלים בתוך מאגר תגים יחיד. כל אחד מהמופעים האלה משמש כעותק מלא ועצמאי של שרת המודל, מה שמאפשר עיבוד בו-זמני של בקשות במכונה הווירטואלית. כדי לנהל את התנועה הזו, הטמענו שכבת ניתוב מופעים בתוך המאגר שמפיצה ביעילות בקשות נכנסות בין המופעים הפעילים.
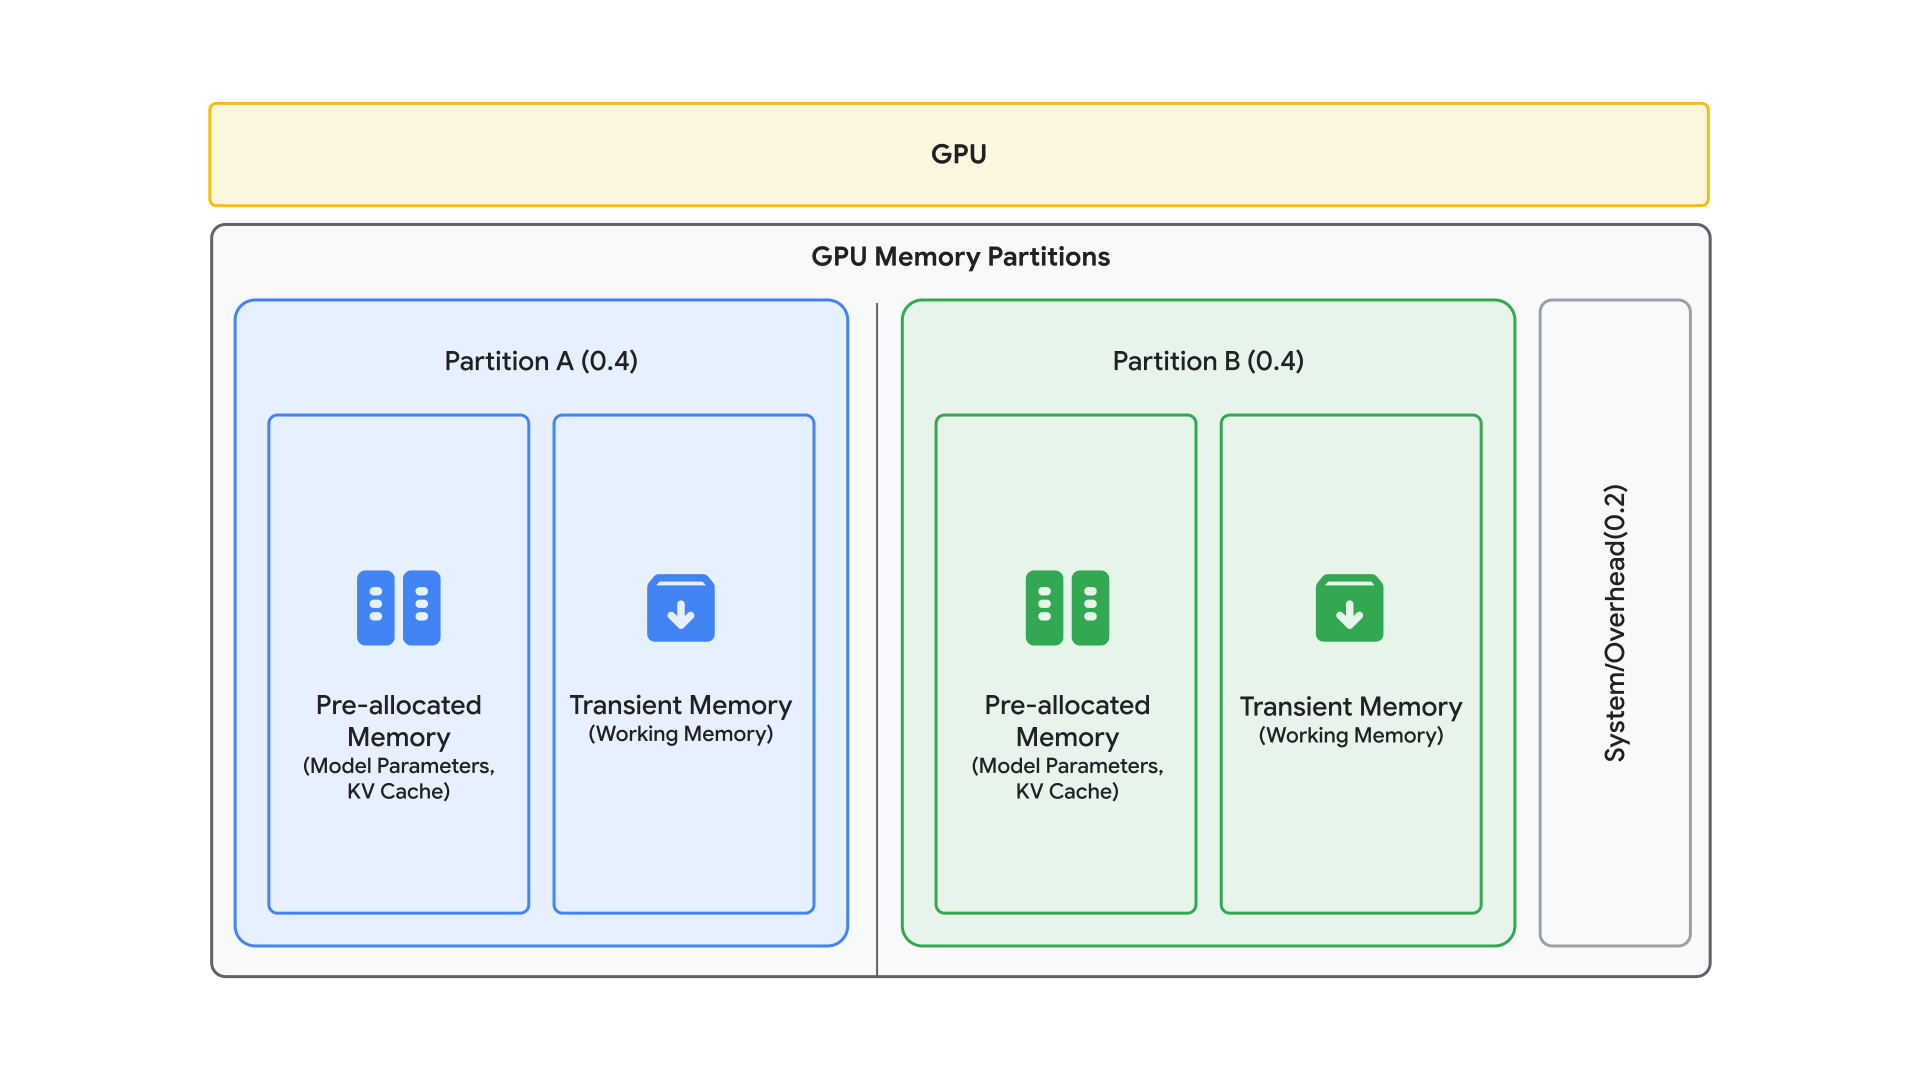
העיצוב הזה מאפשר מקביליות גרנולרית, כי כל מודל שמתארח במשותף יכול להשתמש בהגדרת הגשה ייעודית, עם הגדרות ייחודיות למקביליות טנסורית (TP), למקביליות צינורית (PP) ולמספר הספציפי של מופעי המודל. בנוסף, יש חלוקת משאבים, שבה מוקצות מחיצות זיכרון ספציפיות של GPU לכל מודל – למשל, מחיצת זיכרון של 0.4 GPU לכל מודל – כדי להבטיח שעומסי עבודה מגוונים יתקיימו במקביל באותו מאיץ בלי שאחד מהם ינצל את כל משאבי הזיכרון הקריטיים. הגישה הארכיטקטונית הזו הופכת הזמנת חומרה סטטית, כמו צומת GPU מלא של 8x H100, למאגר מחשוב גמיש שיכול לתת מענה למגוון רחב של מודלים – החל ממודלים גדולים של הסקה ועד למודלים קטנים של צ'אט עם זמן אחזור נמוך.
כדי להגדיל את התמונה, לוחצים עליה
יצירת אב טיפוס ומחקר השוואתי
לפני שפיתחנו את כלי התזמור שלנו שמוכן לייצור, ערכנו מחקר מקיף להשוואה כדי לאמת את היעילות התיאורטית של אירוח משותף של מודלים. בשלב הזה בדקנו באופן יסודי את vLLM, את המקביליות המובנית שלו ואת מידת ה"הפרעה" כשמודלים חולקים את אותו שבב סיליקון.
חקירת מקביליות: מציאת 'נקודת החיתוך'
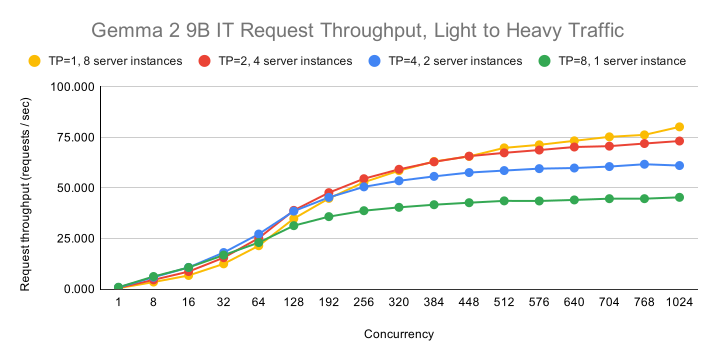
הניתוח הראשוני שלנו התמקד ב-Tensor Parallelism (TP) המקורי של vLLM וביישום של Vertex של מופעי מודל בתור כמה מופעי שרת vLLM, כדי לקבוע איך האסטרטגיות האלה פועלות עם עומסי משתמשים משתנים. גילינו שההגדרה האופטימלית תלויה מאוד בבו-זמניות (concurrency). בבו-זמניות נמוכות, Tensor Parallelism (למשל, TP=8) גבוה מספק את זמן הטעינה הנמוך ביותר לבקשות בודדות על ידי חלוקת השכבות בין כל המאיצים הזמינים. עם זאת, ככל שהתנועה בו-זמנית גדלה, צוואר הבקבוק משתנה. כדי למקסם את קצב העברת הנתונים בתנאי עומס גבוהים, ההגדרה האופטימלית עוברת מ-TP=8 ל-TP=4, ל-TP=2 ובסופו של דבר ל-TP=1, תוך הגדלת מספר המופעים העצמאיים של המודל בו-זמנית. המעבר הזה מגדיר 'נקודת הצלבה' שבה היתרונות של זמן האחזור המופחת בתקשורת בין יחידות GPU בהגדרות עם TP נמוך עולים על המהירות הגולמית של ביצוע עם TP גבוה. בדוגמה הבאה מוצג תרשים של נקודת מפגש עם מודל ה-IT של Gemma 2 9B.
כדי להגדיל את התמונה, לוחצים עליה
קביעת קנה מידה אופטימלית: מודל יחיד, כמה עותקים
כדי ליצור בסיס קפדני למדידת יכולת ההתאמה, ערכנו השוואה בין ביצועים של כמה מופעים של אותו מודל בצומת יחיד. בתנאים של תנועה רוויה (2,048 בקשות בו-זמנית לכל GPU), הפעלה של שמונה מופעי שרת vLLM עצמאיים בצומת 8xH100 הניבה שיפור משוער של פי 7.8 בתפוקה עם רגרסיה של זמן האחזור כמעט לא אפסית בהשוואה לערך בסיסי של GPU יחיד.
השוואת תשתית: קונטיינר לעומת תזמון משותף של pods
בנוסף, ביצענו הערכה של האורקסטרציה ברמת הקונטיינר בהשוואה לפתרונות מקוריים ברמת התשתית, במיוחד תזמון משותף של Pod. שני הפתרונות הניבו ביצועים דומים בהגשה של כמה עותקים, אבל בסופו של דבר בחרנו בגישה ברמת הקונטיינר למוצר המינימלי בר-הקיימא (MVP) שלנו. ההחלטה הזו התקבלה בעקבות הגמישות הגבוהה יותר שפתרון ברמת הקונטיינר מציע לאירוח משותף הטרוגני, שמאפשר למפתחים להציג ארכיטקטורות שונות של מודלים זו לצד זו עם מחיצות זיכרון גרנולריות שמוגדרות על ידי תוכנה, שלא מוגבלות על ידי אילוצי תזמון בסיסיים של Kubernetes. בנוסף, תזמור ברמת הקונטיינר מאפשר איטרציה מהירה יותר, וקל יותר לבצע התאמה אישית וחדשנות.
בדיקת ההפרעות: אירוח משותף של מודלים שונים
אבן הדרך האחרונה בתהליך יצירת אב הטיפוס הייתה 'בדיקת הפרעות', שבה אירחנו במשותף את Gemma-3n-E2B-it ו-Llama-3.1-8B-Instruct באותו מכונה וירטואלית. כשכל מודל מוקצה למחיצת זיכרון GPU של 0.4, ביצועי ההצגה נשארים כמעט זהים למדדי הביצועים של מודל יחיד. לדוגמה, Gemma-3n הגיע ל-30.21 reqs בסביבה שמתארחת במשותף לעומת 30.96 reqs בבידוד. התוצאות האלה מאשרות שיש מעט מאוד הפרעות בחישובים בין מודלים שמתארחים יחד, או שאין הפרעות כאלה בכלל, גם בתנאי עומס תנועה כבד, בתנאי שמשאבי הזיכרון מחולקים בצורה מתאימה כדי למנוע מחסור במטמון KV.
הטמעה של מאגר תגים ב-MVP
המעבר מנקודת השוואה מאומתת למערכת מוכנה לייצור הצריך תכנון של כלי תזמור חזק שמבוסס על קונטיינרים. בשלב הפיתוח הזה התמקדנו בבניית שכבת תוכנה ברמה גבוהה שיכולה לנהל את המורכבויות של מחזורי חיים של כמה מודלים, תוך הקפדה על בידוד דטרמיניסטי של משאבים.
עיצוב שרת לאירוח משותף של מודלים
הליבה של ההטמעה שלנו היא model_cohost_server, נקודת כניסה מותאמת אישית שנועדה לפעול כמתזמן ראשי בתוך הקונטיינר. בניגוד למודל הרגיל של תהליך יחיד, השרת הזה מטמיע ניהול של תהליכי משנה, ומאפשר ביצוע מקביל של כמה מופעים עצמאיים של שרת מודלים – כמו vLLM – כתהליכי משנה מבודדים. כדי לנהל תנועה נכנסת, האורקסטרטור משתמש בניתוב בקשות ברמה גבוהה, מזהה בקשות לפי מזהי המודל הייחודיים שלהן באמצעות ארגומנטים כמו --served-model-name ומפנה אותן למופע השרת הפנימי המתאים. בנוסף לניתוב, השרת מספק אורקסטרציה מקיפה של מחזור החיים, ומנהל את האתחול, את מעקב התקינות ואת הסיום של כל המופעים שמתארחים יחד. הניהול הריכוזי הזה מספק נקודת קצה אחת ומאוחדת לתעבורה חיצונית, תוך שמירה על הגבולות התפעוליים הנפרדים של כל תהליך משנה.
כדי להגדיל את התמונה, לוחצים עליה
חלוקת משאבי GPU: חיתוך דטרמיניסטי
כדי למנוע את הסיכון שעומס העבודה של מודל יחיד יפעיל שגיאת חוסר זיכרון (OOM) בסביבה שבה מתארחים כמה מודלים, הטמענו מנגנון חיתוך משאבים קפדני. ההגדרה הזו מיושמת באמצעות הארגומנט gpu-memory-partition, שמאפשר למפתחים להגדיר יחסי זיכרון מפורשים (לדוגמה, 0.4, 0.4) כדי לשריין אחוז קבוע מזיכרון ה-GPU הכולל של צומת לכל מופע מודל בנפרד.
כדי להקצות את המשאבים בצורה יעילה, אנחנו משתמשים במודל של זיכרון שהוקצה מראש לעומת זיכרון זמני, שמבחין בין דרישות משאבים סטטיות לבין דרישות משאבים דינמיות.
הזיכרון שמוקצה מראש כולל את הזיכרון שמשמש למשקלי המודל ולמטמון KV. נפח הזיכרון שמשמש למשקלי המודל תלוי במספר הפרמטרים ובדיוק של המודל. לדוגמה, מודל עם 8 מיליארד פרמטרים ב-BF16 דורש בערך 16GB של אחסון סטטי. כמות הזיכרון שמשמשת למטמון KV תלויה בממדי המודל, בדיוק, בחלון ההקשר ובמספר הרצפים. זיכרון זמני מורכב מחישובים ביניים ומזיכרון עבודה של הסקת מסקנות. הארגומנט gpu-memory-partition מייצג את הזיכרון שהוקצה מראש. מומלץ להשאיר מקום לזיכרון 'זמני' על ידי הגדרת הסכום של gpu-memory-partition כך שיהיה קטן מ-1.0.
כדי להגדיל את התמונה, לוחצים עליה
הפיכה למוצר
בשלב ההכנה לייצור של אירוח משותף של מודלים באמצעות Vertex AI, התמקדנו ביצירת סביבה חלקה ומוכנה לייצור עבור תצורות של הצגת מודל יחיד עם כמה רפליקות ושל הצגת כמה מודלים. במסגרת המעבר הזה, ממצאי מחקר אמפיריים תורגמו למעשה לתהליכי פריסה פשוטים ולמבני תמיכה בתשתית שמשולבים עמוק.
תהליכי עבודה פשוטים יותר לפריסה
כדי להקל על הכניסה לתחום של שרתים בצפיפות גבוהה, יצרנו סטנדרטיזציה של הגדרות אירוח משותף באמצעות ארגומנטים מותאמים אישית של קונטיינרים שמשולבים באופן טבעי עם ממשקי Vertex AI API הקיימים. למכונות וירטואליות מלאות, כמו צומת 8x H100, פיתחנו כלי להשוואה כדי להתאים אישית את המתכונים הטובים ביותר לתרחישי השימוש הספציפיים שלכם. הכלי הזה יאפשר לכם למצוא את ההגדרה שמאזנת באופן אוטומטי בין מקבילות של צינורות (PP), מקבילות של טנסורים (TP) ומספר המופעים של המודל, על סמך מספר הפרמטרים והדיוק הספציפיים של המודל. בנוסף, יש תמיכה חזקה ב-Deployment API, שמאפשרת למפתחים לציין את הפרמטרים המפורטים האלה – כולל חלוקות זיכרון מדויקות של GPU – ישירות בבקשת deployModel רגילה ולפרוס מודלים.
פרסום דינמי של כמה מודלים
התקדמות משמעותית בתהליך הטכני שלנו הייתה המעבר מהגדרות סטטיות לארכיטקטורה של הצגת מודעות דינמית. היכולת הזו חשובה מאוד לסביבות ייצור שמאופיינות בדפוסי תנועה שמשתנים במהירות, כי היכולת לטעון או לבטל טעינה של מודלים בלי להפעיל מחדש את כל הקונטיינר חיונית לשמירה על גמישות התשתית וזמינות גבוהה.
ממשק ה-API של עדכונים דינמיים (update_models)
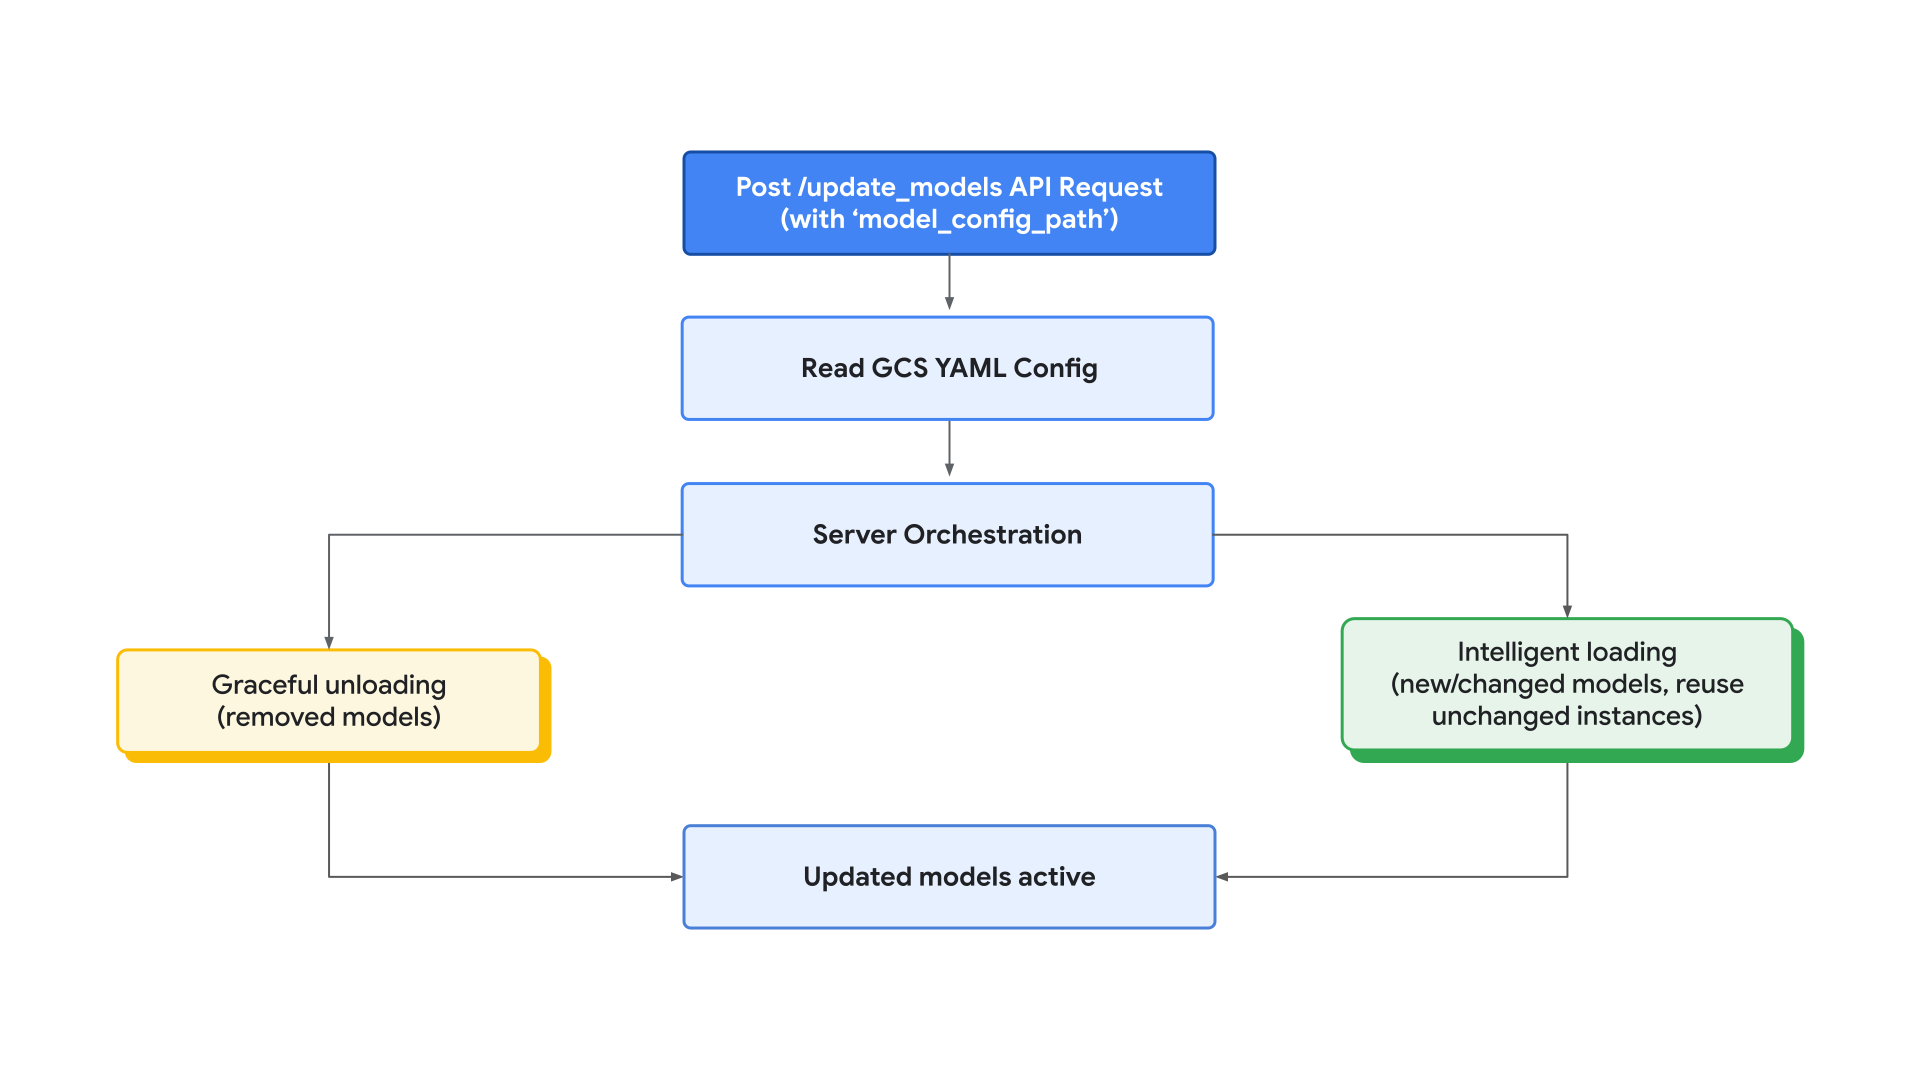
כדי לפתור את הבעיות שנובעות מפריסות שלא ניתן לשנות, הטמענו API מיוחד לעדכון מודלים בתוך קונטיינר של אירוח משותף של מודל vLLM ב-Vertex Model Garden. ממשק ה-API הזה מאפשר טעינה מחדש בזמן ריצה, כך שהשרת יכול לשנות את אוסף המודלים המתארחים שלו תוך כדי ריצה על סמך קובץ הגדרה מרכזי שמאוחסן בקטגוריה של Cloud Storage.
תהליך העדכון מתחיל באמצעות בקשת POST לנקודת הקצה update_models, שכוללת את model_config_path שמצביע על קובץ ה-YAML ב-Cloud Storage.
כשמתקבלת הבקשה הזו, השרת מבצע רצף של תזמור רב-שלבי שעבר אופטימיזציה כדי לצמצם את זמן ההשבתה:
- הסרת טעינה הדרגתית: המערכת מזהה מודלים שלא נכללים בהגדרה החדשה ומסיימת את תהליכי המשנה שלהם קודם, וכך משחררת מיד את זיכרון ה-GPU ואת משאבי המחשוב.
- טעינה חכמה ושימוש חוזר: השרת מאתחל מופעים חדשים של המודל. חשוב לדעת: אם הגדרות המקביליות של מודל מסוים – כמו Tensor Parallelism (TP) או Pipeline Parallelism (PP) – ומחיצת הזיכרון שהוקצתה לו נשארות ללא שינוי, כלי התזמור משתמש מחדש במופע הפעיל הקיים. האופטימיזציה הזו מדלגת על שלב האתחול מחדש היקר, וכך מוודאת שהשירותים הפעילים לא יופרעו במהלך שינויים בתצורה.
כדי להגדיל את התמונה, לוחצים עליה
ניתוח של זמן האחזור והביצועים
ניתוח אמפירי של אסטרטגיות העדכון האלה מגלה שהטעינה מחדש דינמית מתוך הזיכרון מפחיתה באופן משמעותי את העונש של 'הפעלה במצב התחלתי (cold start)' שקשור בדרך כלל להפעלת מודלים גדולים של שפה (LLM) בקנה מידה גדול.
סיכום
אירוח משותף של מודלים באמצעות Vertex AI מייצג שינוי פרדיגמה מהותי, ומעבר מפריסות מונוליטיות נוקשות שדורשות הרבה חומרה לארכיטקטורה גמישה ויעילה להצגת מודלים. המעבר מסטנדרט של 'מודל אחד לכל מכונה וירטואלית' למודל של מאגר מחשוב בצפיפות גבוהה מאפשר לארגונים להקטין באופן משמעותי את עלות הבעלות הכוללת (TCO), תוך שמירה על ביצועים גבוהים – ולעתים קרובות גם שיפור שלהם.
המסע ההנדסי שלנו ומחקרים מקיפים להשוואה בין מודלים הניבו קבוצה מוגדרת של הנחיות לייצור הארכיטקטורה הזו:
- אין הגדרה אחת שמתאימה לכולם. אנחנו ממליצים למצוא את המתכון הכי טוב להצגת מודל לתרחיש שימוש ספציפי (מודל, חומרה, תנועה), ולבנות כלים שיעזרו בכך.
- הגדלת התפוקה באמצעות רפליקות.
- שיפור ניצול המשאבים על ידי ביטול מגבלות החומרה ופיצול הזיכרון ברמה מפורטת יותר.
כדי להטמיע בהצלחה ארכיטקטורה של אירוח משותף, מומלץ לפעול לפי תהליך העבודה הטכני הבא:
- חלוקה מפורשת למחיצות: משתמשים בארגומנט
--gpu-memory-partitionsכדי להקצות משאבי זיכרון למודלים ספציפיים. - השוואה לשוק חוזרת: משתמשים בכלי ההשוואה לשוק כדי לזהות את נקודת ה-Concurrency Crossover הספציפית לעומס העבודה – ההגדרה האופטימלית של מספר המופעים, ה-TP וה-PP.
הטמעה של אירוח משותף ב-Model Garden ב-Google Cloud מספקת תוכנית פעולה ניתנת להרחבה לבניית אפליקציות AI בצפיפות גבוהה. אנחנו ממליצים למפתחים לבדוק את היכולות האלה ולשחזר את מדדי הביצועים שלנו באמצעות המדריך שסיפקנו, כדי לבצע אופטימיזציה של הגדרות ההצגה בהתאם לדרישות הספציפיות של הארגון שלהם.
תודה שקראת
נשמח לקבל משוב ולענות על שאלות בנושא Vertex AI.
תודות
אנחנו רוצים להודות מעומק הלב לצוות של Google Cloud Vertex AI. אנחנו רוצים להודות במיוחד לבו וו (Bo Wu) ולטינג יו (Ting Yu) על המנהיגות וההנחיה שלהם, וגם לדבורה הוא (Deborah He), שון מא (Shawn Ma), דזמונד ליו (Desmond Liu), יאנג פאן (Yang Pan), סוריה קיי ג'י טנגאטור (Surya K G Tangatur) ולואיס ריזו (Luis Rizo) על התרומות החשובות שלהם לאורך הפרויקט.