

Dalam lanskap model bahasa besar (LLM)yang terus berkembang, pola deployment "satu model per mesin" menjadi hambatan yang signifikan bagi efisiensi biaya penayangan LLM di perusahaan. LLM sering kali memerlukan reservasi hardware yang besar, seperti node GPU H100 8x penuh, untuk mengelola beban puncak. Namun, selama operasi standar, resource mahal ini sering kali kurang dimanfaatkan, sehingga menyebabkan total biaya kepemilikan (TCO) yang tinggi.
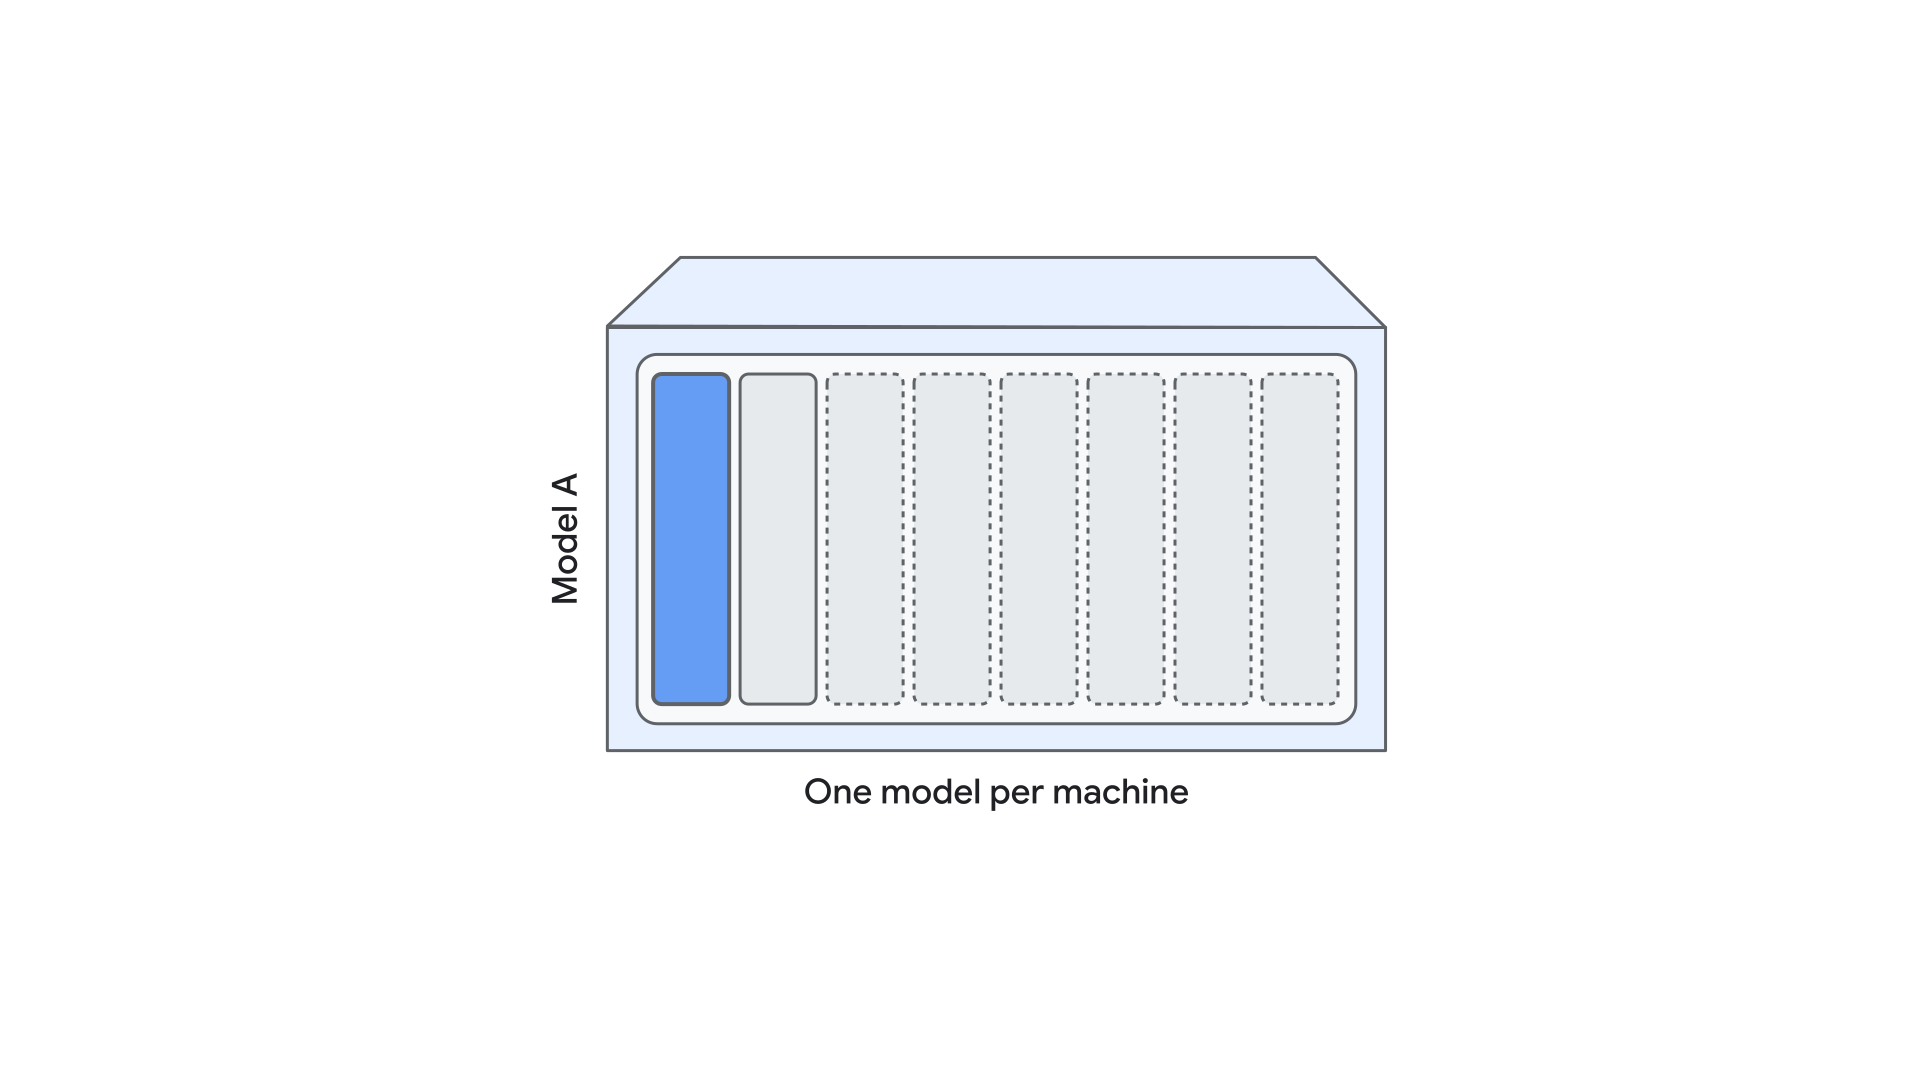
Dukungan hosting model bersama mengatasi kesenjangan efisiensi ini dengan memungkinkan beberapa instance model berbagi resource GPU dan mesin virtual yang sama. Hal ini mencakup model yang sama sekali berbeda, seperti Llama 3.3 dan Gemma 3. Dengan memanfaatkan pengirisan memori sub-GPU dan partisi resource yang cerdas, Vertex AI Model Garden mengubah reservasi hardware statis menjadi kumpulan komputasi yang fleksibel dan berdensitas tinggi.
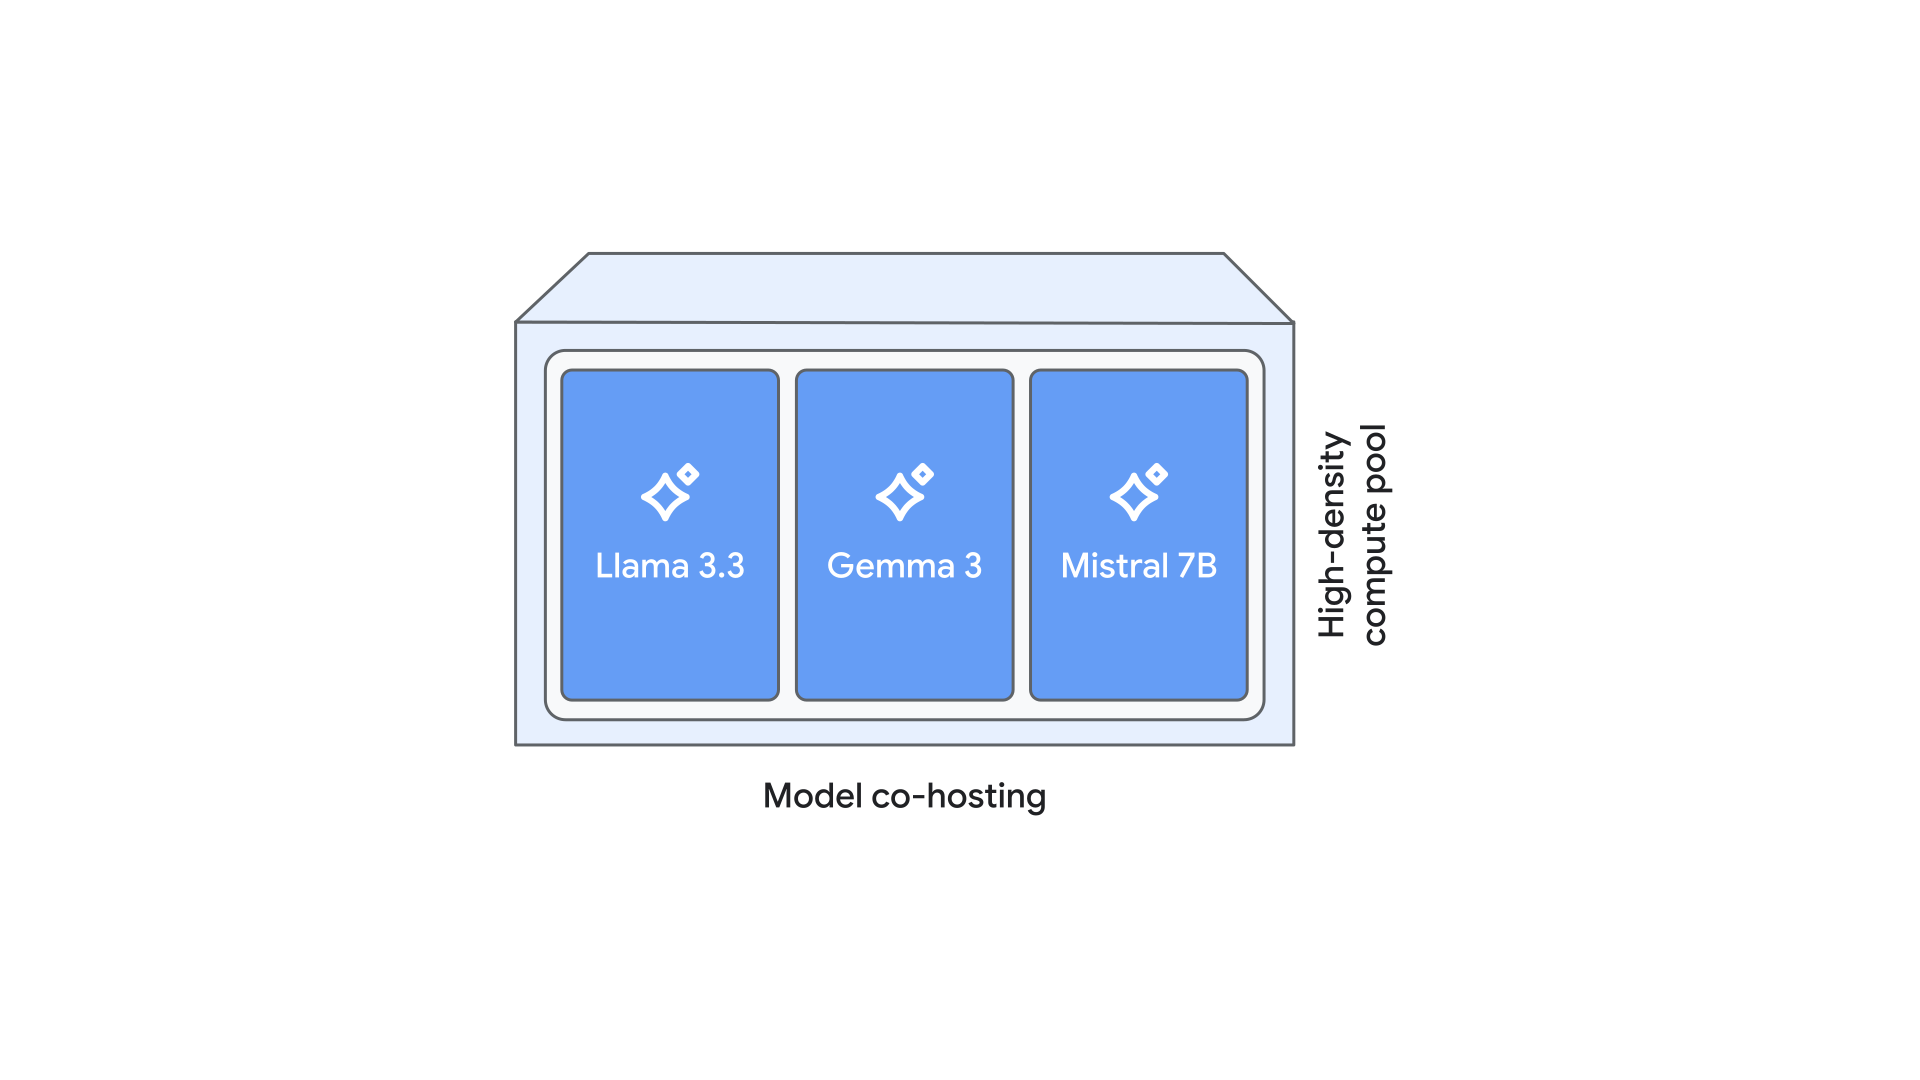
Blog teknis ini menjelaskan secara mendetail proses Engineering Vertex AI dalam menghadirkan layanan cloud yang siap produksi untuk model co-hosting. Kami akan membagikan metodologi kami untuk strategi penerapan tingkat penampung, mengidentifikasi konfigurasi penayangan yang optimal, dan temuan utama dari studi tolok ukur multi-model ekstensif kami, sehingga Anda dapat memaksimalkan efisiensi biaya penayangan LLM.
Memahami hosting bersama model: konsep dan arsitektur
Hosting bersama model adalah strategi penayangan dengan kepadatan tinggi yang memungkinkan beberapa instance model bahasa besar (LLM) atau arsitektur model yang berbeda untuk berbagi resource hardware fisik yang sama dalam satu mesin virtual (VM). Tidak seperti model deployment tradisional yang mendedikasikan VM atau GPU penuh untuk satu model, co-hosting menggunakan partisi resource terperinci untuk memaksimalkan ROI hardware dan meningkatkan pemanfaatan resource komputasi dan memori.
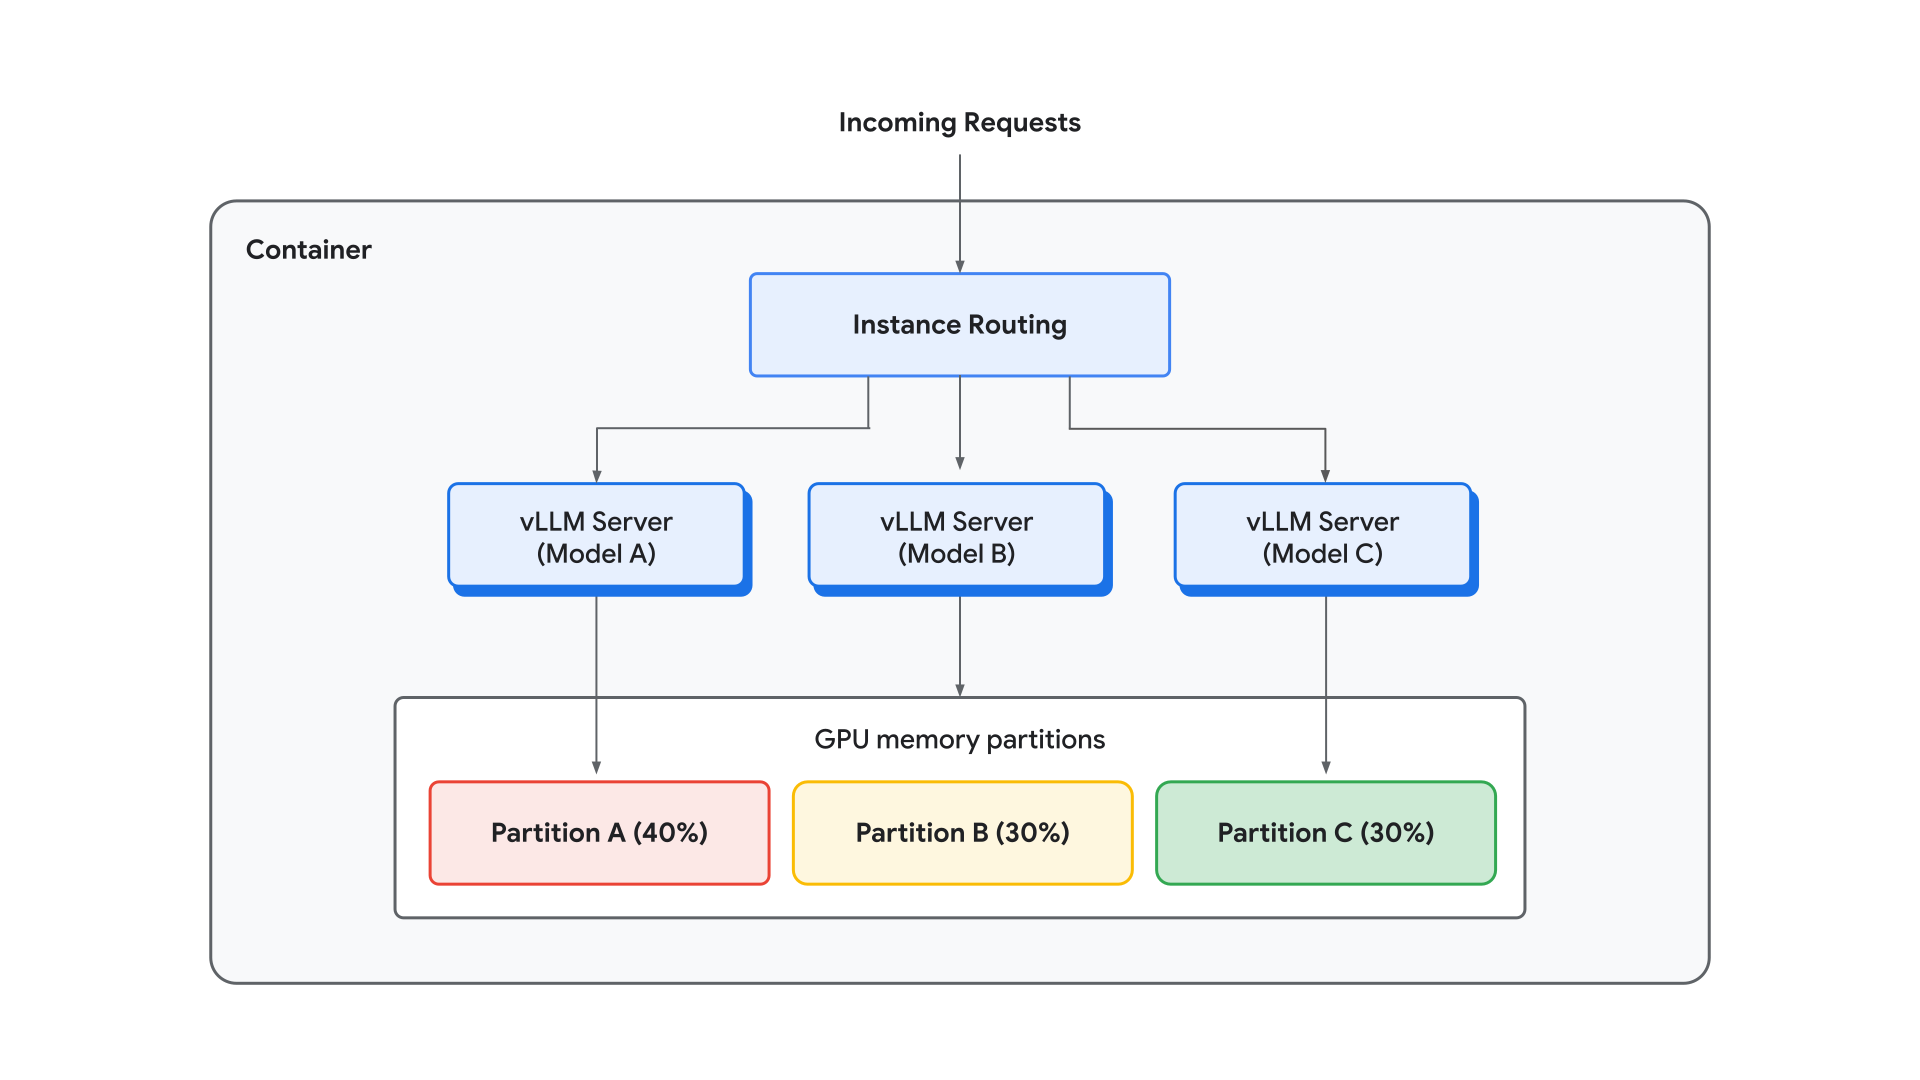
Implementasi kami berfokus pada solusi tingkat penampung yang memungkinkan penayangan beberapa model secara bersamaan dengan konfigurasi independen. Arsitektur ini beroperasi melalui beberapa mekanisme teknis terintegrasi, dimulai dengan deployment beberapa instance server model independen dalam satu container. Setiap instance ini berfungsi sebagai salinan lengkap dan independen dari server model, yang memungkinkan pemrosesan permintaan secara bersamaan di seluruh mesin virtual. Untuk mengelola traffic ini, kami menerapkan lapisan perutean instance dalam container yang mendistribusikan permintaan masuk secara efisien di antara instance aktif.
Desain ini menyediakan paralelisme terperinci dengan memungkinkan setiap model yang di-hosting bersama memanfaatkan konfigurasi penayangan khusus, yang menampilkan setelan unik untuk Paralelisme Tensor (TP), Paralelisme Pipeline (PP), dan jumlah spesifik instance model. Hal ini dilengkapi dengan pengirisan resource, di mana partisi memori GPU tertentu ditetapkan ke setiap model—seperti partisi memori GPU 0,4 per model—untuk memastikan bahwa beragam workload dapat berjalan bersama di akselerator yang sama tanpa saling kekurangan resource memori penting. Pendekatan arsitektur ini mengubah reservasi hardware statis, seperti node GPU H100 8x penuh, menjadi kumpulan komputasi fleksibel yang mampu melayani portofolio yang beragam—mulai dari model penalaran besar hingga model chat kecil dengan latensi rendah.
Studi pembuatan prototipe dan tolok ukur
Sebelum mengembangkan orkestrator siap produksi, kami melakukan studi tolok ukur komprehensif untuk memvalidasi efisiensi teoretis dari co-hosting model. Fase ini bertujuan untuk menguji secara menyeluruh paralelisme native vLLM dan mengukur secara tepat tingkat "interferensi" saat model berbagi silikon yang sama.
Penyelidikan paralelisme: Menemukan "titik persilangan"
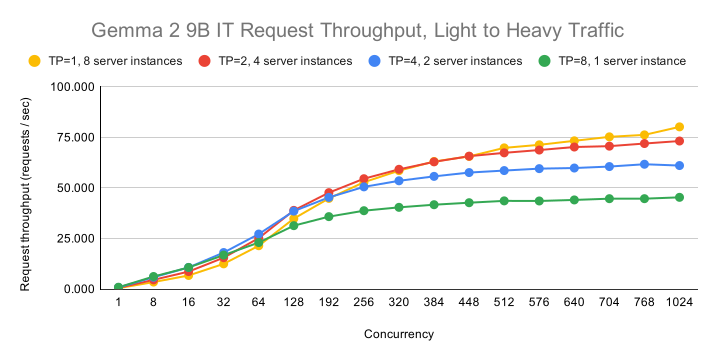
Analisis awal kami berfokus pada Tensor Parallelism (TP) bawaan vLLM dan penerapan instance model Vertex sebagai beberapa instance server vLLM untuk menentukan cara interaksi strategi ini dengan berbagai beban pengguna. Kami menemukan bahwa konfigurasi optimal sangat bergantung pada konkurensi; pada konkurensi yang lebih rendah, Tensor Parallelism (TP) yang tinggi (misalnya, TP=8) memberikan latensi terendah untuk setiap permintaan dengan mendistribusikan lapisan di semua akselerator yang tersedia. Namun, seiring peningkatan traffic serentak, hambatan berpindah. Untuk memaksimalkan throughput dalam kondisi beban tinggi, konfigurasi optimal bertransisi dari TP=8 ke TP=4, TP=2, dan akhirnya TP=1, sekaligus meningkatkan jumlah instance model independen. Transisi ini menentukan "titik persilangan" saat manfaat latensi komunikasi antar-GPU yang lebih rendah dalam penyiapan TP rendah lebih besar daripada kecepatan eksekusi TP tinggi. Berikut ini, Anda memiliki diagram titik persilangan dengan model IT 9B Gemma 2.
Penskalaan optimal: Model tunggal, multi-replika
Untuk menetapkan dasar yang ketat untuk skalabilitas, kami melakukan tolok ukur penayangan beberapa instance model yang sama pada satu node. Dalam kondisi traffic yang tidak jenuh (2048 permintaan serentak per GPU), meluncurkan delapan instance server vLLM independen pada node 8xH100 menghasilkan peningkatan throughput sekitar 7,8 kali lipat dengan regresi latensi yang hampir nol dibandingkan dengan dasar pengukuran GPU tunggal.
Perbandingan infrastruktur: Penjadwalan bersama container vs. pod
Kami selanjutnya mengevaluasi orkestrasi tingkat penampung terhadap solusi tingkat infrastruktur native, khususnya penjadwalan bersama Pod. Meskipun kedua solusi memberikan performa yang sebanding untuk penayangan multi-replika, kami akhirnya memilih pendekatan tingkat penampung untuk Produk dengan Kelayakan Minimal (MVP) kami. Keputusan ini didorong oleh fleksibilitas unggul yang ditawarkan solusi tingkat container untuk hosting bersama heterogen, yang memungkinkan developer menayangkan arsitektur model yang berbeda secara berdampingan dengan partisi memori yang software-defined dan terperinci yang tidak dibatasi oleh batasan penjadwalan Kubernetes pokok. Selain itu, orkestrasi tingkat container memungkinkan iterasi yang jauh lebih cepat dan lebih mudah untuk disesuaikan dan diinovasi.
Uji interferensi: Hosting bersama model yang berbeda
Tonggak pencapaian pembuatan prototipe terakhir adalah "Uji Interferensi", di mana kami meng-hosting bersama Gemma-3n-E2B-it dan Llama-3.1-8B-Instruct di VM yang sama. Dengan setiap model yang diberi partisi memori GPU 0,4, performa inferensi tetap hampir sama dengan tolok ukur model tunggal. Misalnya, Gemma-3n mencapai 30,21 reqs di lingkungan yang di-hosting bersama dibandingkan dengan 30,96 reqs secara terpisah. Hasil ini mengonfirmasi bahwa ada sedikit atau tidak ada gangguan komputasi antara model yang di-hosting bersama, bahkan di bawah traffic yang berat, asalkan resource memori dipartisi dengan tepat untuk mencegah kekurangan cache KV.
Implementasi penampung MVP
Transisi dari tolok ukur yang tervalidasi ke sistem yang siap produksi memerlukan rekayasa orkestrator dalam container yang andal. Fase pengembangan ini berfokus pada pembuatan lapisan software tingkat tinggi yang mampu mengelola kompleksitas beberapa siklus proses model sekaligus memastikan isolasi resource deterministik.
Desain server hosting bersama model
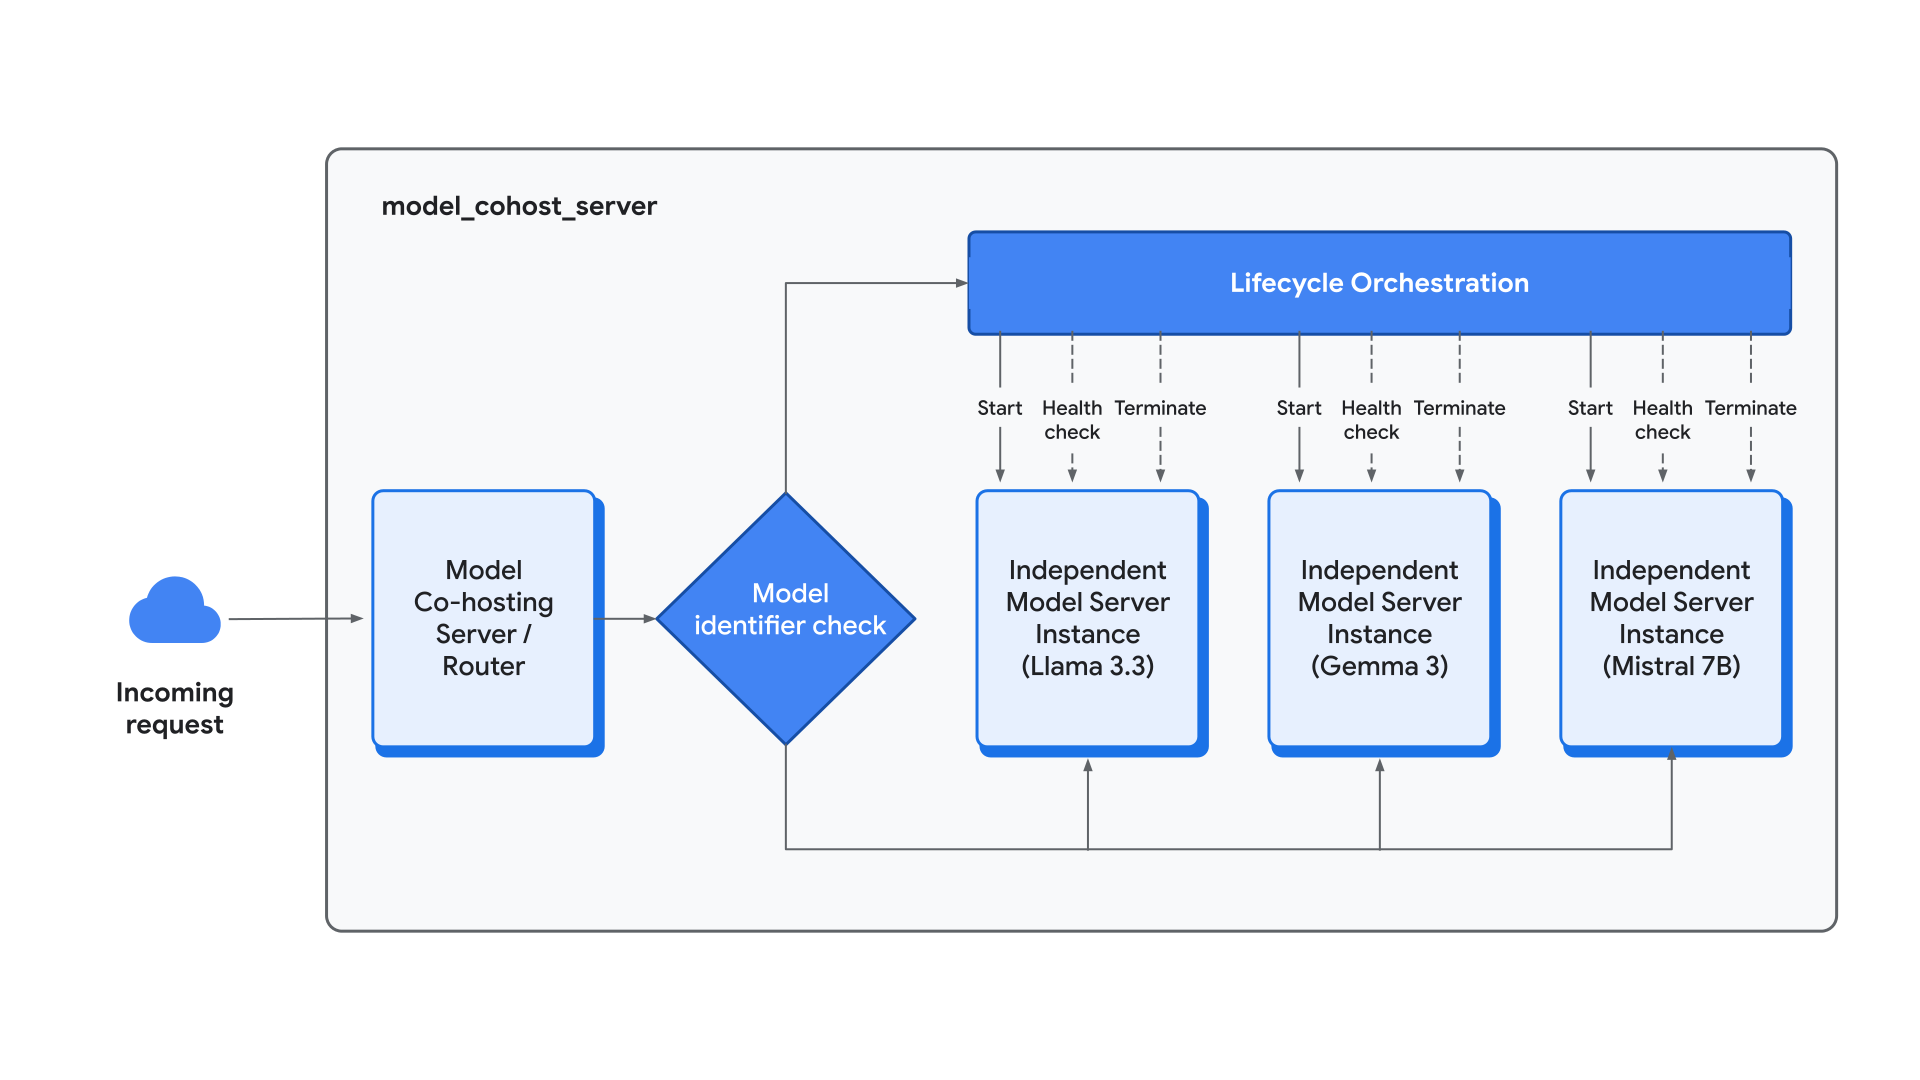
Inti dari implementasi kami adalah model_cohost_server, titik
entri kustom yang dirancang untuk bertindak sebagai pengelola utama dalam container. Dengan menyimpang dari model satu proses standar, server ini menerapkan pengelolaan sub-proses, yang memfasilitasi eksekusi serentak beberapa instance server model independen—seperti vLLM—sebagai sub-proses terisolasi. Untuk mengelola traffic masuk, orkestrator menggunakan perutean permintaan tingkat tinggi, mengidentifikasi permintaan berdasarkan ID model uniknya melalui argumen seperti --served-model-name dan mengarahkannya ke instance server internal yang sesuai. Selain perutean, server menyediakan orkestrasi siklus proses yang komprehensif, mengelola inisialisasi, pemantauan kondisi, dan penghentian semua instance yang di-co-host. Pengelolaan terpusat ini menyediakan satu endpoint terpadu untuk traffic eksternal sekaligus mempertahankan batas operasional yang berbeda dari setiap sub-proses.
Partisi resource GPU: Pengirisan deterministik
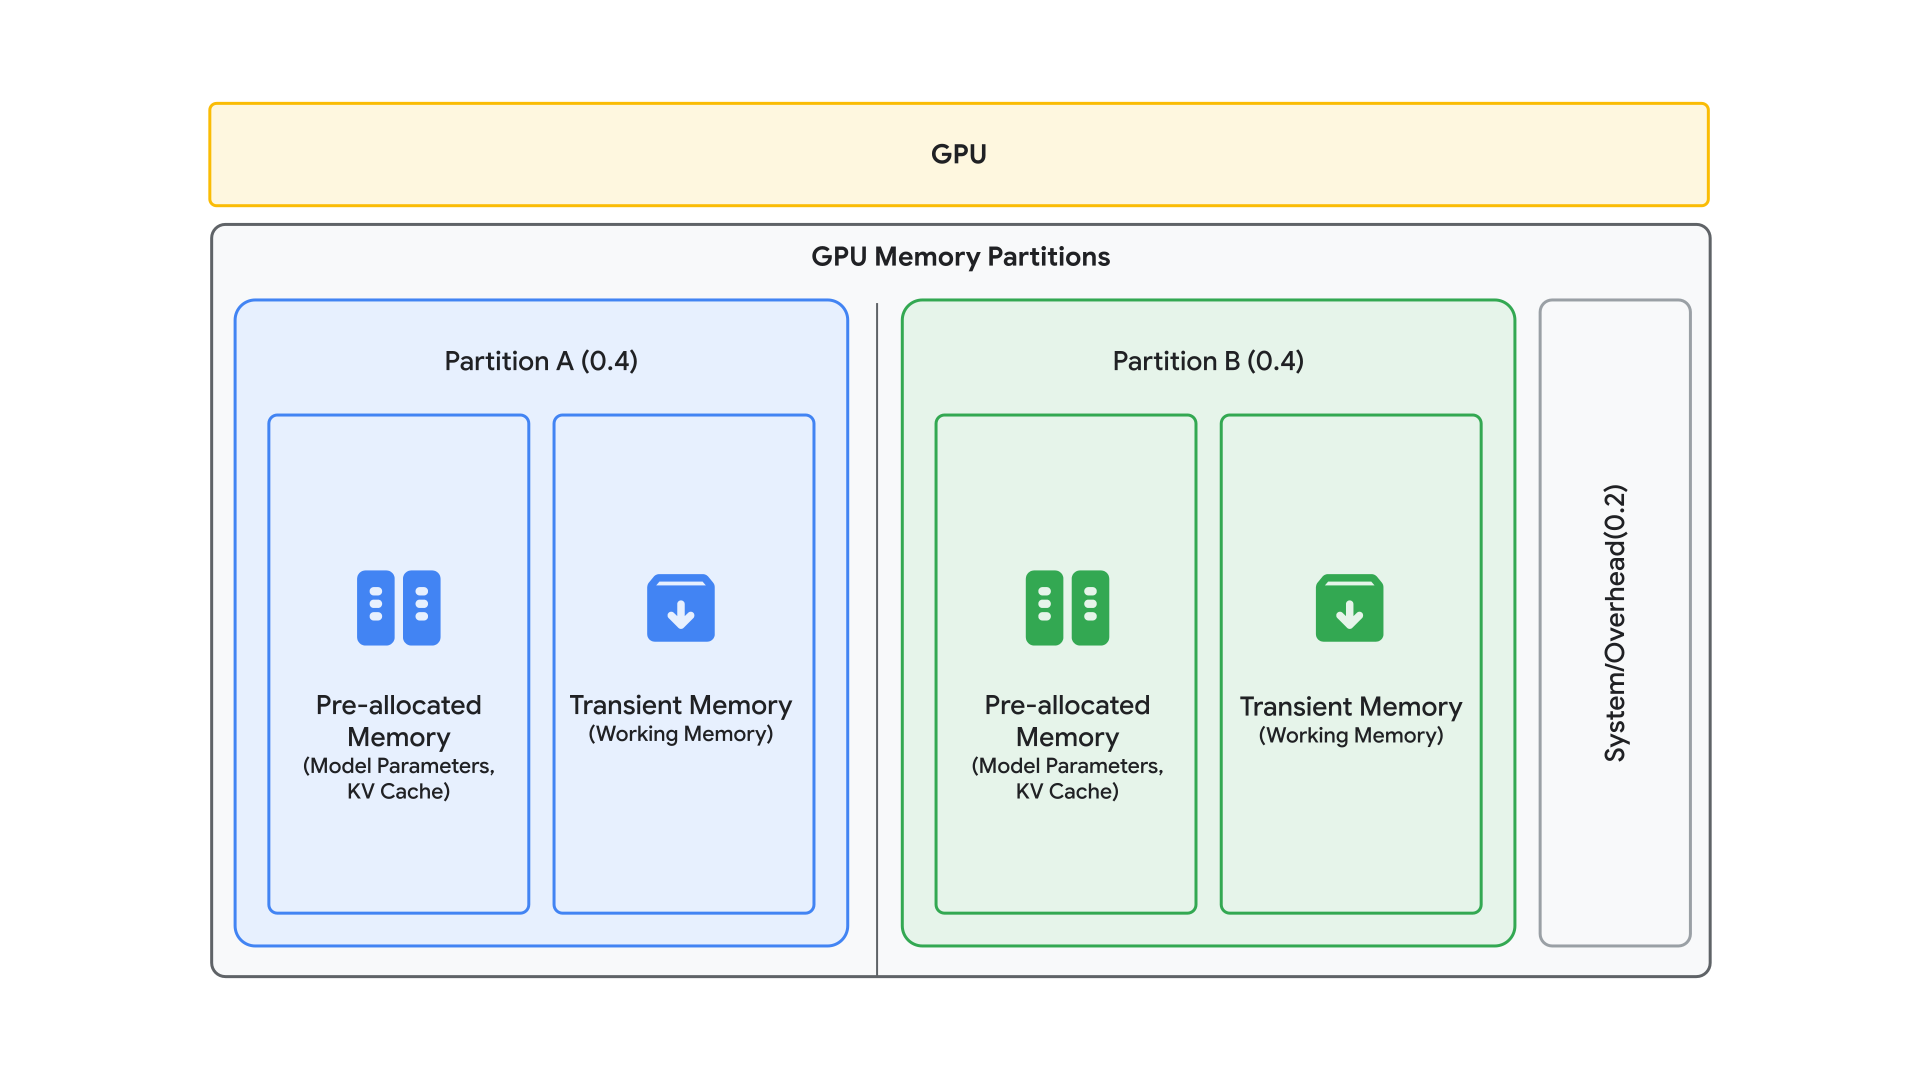
Untuk menghilangkan risiko beban kerja satu model memicu error Out-of-Memory (OOM) di seluruh lingkungan yang di-co-host, kami menerapkan mekanisme pengirisan resource yang ketat. Hal ini dioperasikan melalui argumen gpu-memory-partition, yang memungkinkan developer menentukan rasio memori eksplisit (misalnya, 0,4, 0,4) untuk mencadangkan persentase tetap dari total memori GPU node untuk setiap instance model.
Untuk memandu alokasi ini, kami mengadopsi model memori "Dialokasikan Sebelumnya vs. Sementara", yang membedakan antara persyaratan resource statis dan dinamis.
Memori "yang telah dialokasikan sebelumnya" terdiri dari memori yang digunakan untuk bobot model dan cache KV. Jumlah memori yang digunakan untuk bobot model bergantung pada jumlah parameter dan presisi model. Misalnya, model parameter 8B dalam BF16
memerlukan penyimpanan statis sekitar 16 GB. Jumlah memori yang digunakan untuk cache KV bergantung pada dimensi model, presisi, panjang konteks, dan jumlah urutan. Memori"sementara" terdiri dari komputasi perantara dan
memori aktif inferensi. Argumen gpu-memory-partition memperhitungkan memori "yang telah dialokasikan sebelumnya". Sebaiknya sisakan ruang buffer untuk memori "sementara"
dengan menetapkan jumlah gpu-memory-partition agar lebih kecil dari 1,0.
Produk
Fase produkisasi dari co-hosting model dengan Vertex AI ditujukan untuk membangun lingkungan yang lancar dan siap produksi untuk konfigurasi penyajian multi-model dan multi-replika model tunggal. Transisi ini secara efektif menerjemahkan temuan tolok ukur empiris ke dalam alur kerja deployment yang disederhanakan dan struktur dukungan infrastruktur yang terintegrasi secara mendalam.
Alur kerja deployment yang disederhanakan
Untuk menurunkan hambatan masuk bagi penayangan kepadatan tinggi, kami menstandardisasi konfigurasi hosting bersama menggunakan argumen container kustom yang terintegrasi secara native dengan Vertex AI API yang ada. Untuk mesin virtual bentuk penuh, seperti node H100 8x, kami mengembangkan utilitas benchmark untuk menyesuaikan resep terbaik untuk kasus penggunaan spesifik Anda. Utilitas tolok ukur ini memungkinkan Anda menemukan konfigurasi yang secara otomatis menyeimbangkan Paralelisme Tensor (TP), Paralelisme Pipeline (PP), dan jumlah instance model berdasarkan jumlah parameter dan presisi model tertentu. Hal ini dilengkapi dengan dukungan Deployment API yang andal, sehingga memungkinkan developer menentukan parameter terperinci ini—termasuk partisi memori GPU yang tepat—langsung dalam permintaan deployModel standar dan men-deploy model.
Penayangan multi-model dinamis
Kemajuan signifikan dalam perjalanan teknis kami adalah transisi dari konfigurasi statis ke arsitektur penayangan dinamis. Kemampuan ini sangat penting untuk lingkungan produksi yang ditandai dengan pola traffic yang berubah dengan cepat, karena kemampuan untuk memuat atau menghapus model tanpa memulai ulang container sepenuhnya sangat penting untuk mempertahankan ketangkasan infrastruktur dan ketersediaan tinggi.
Dynamic Update API (update_models)
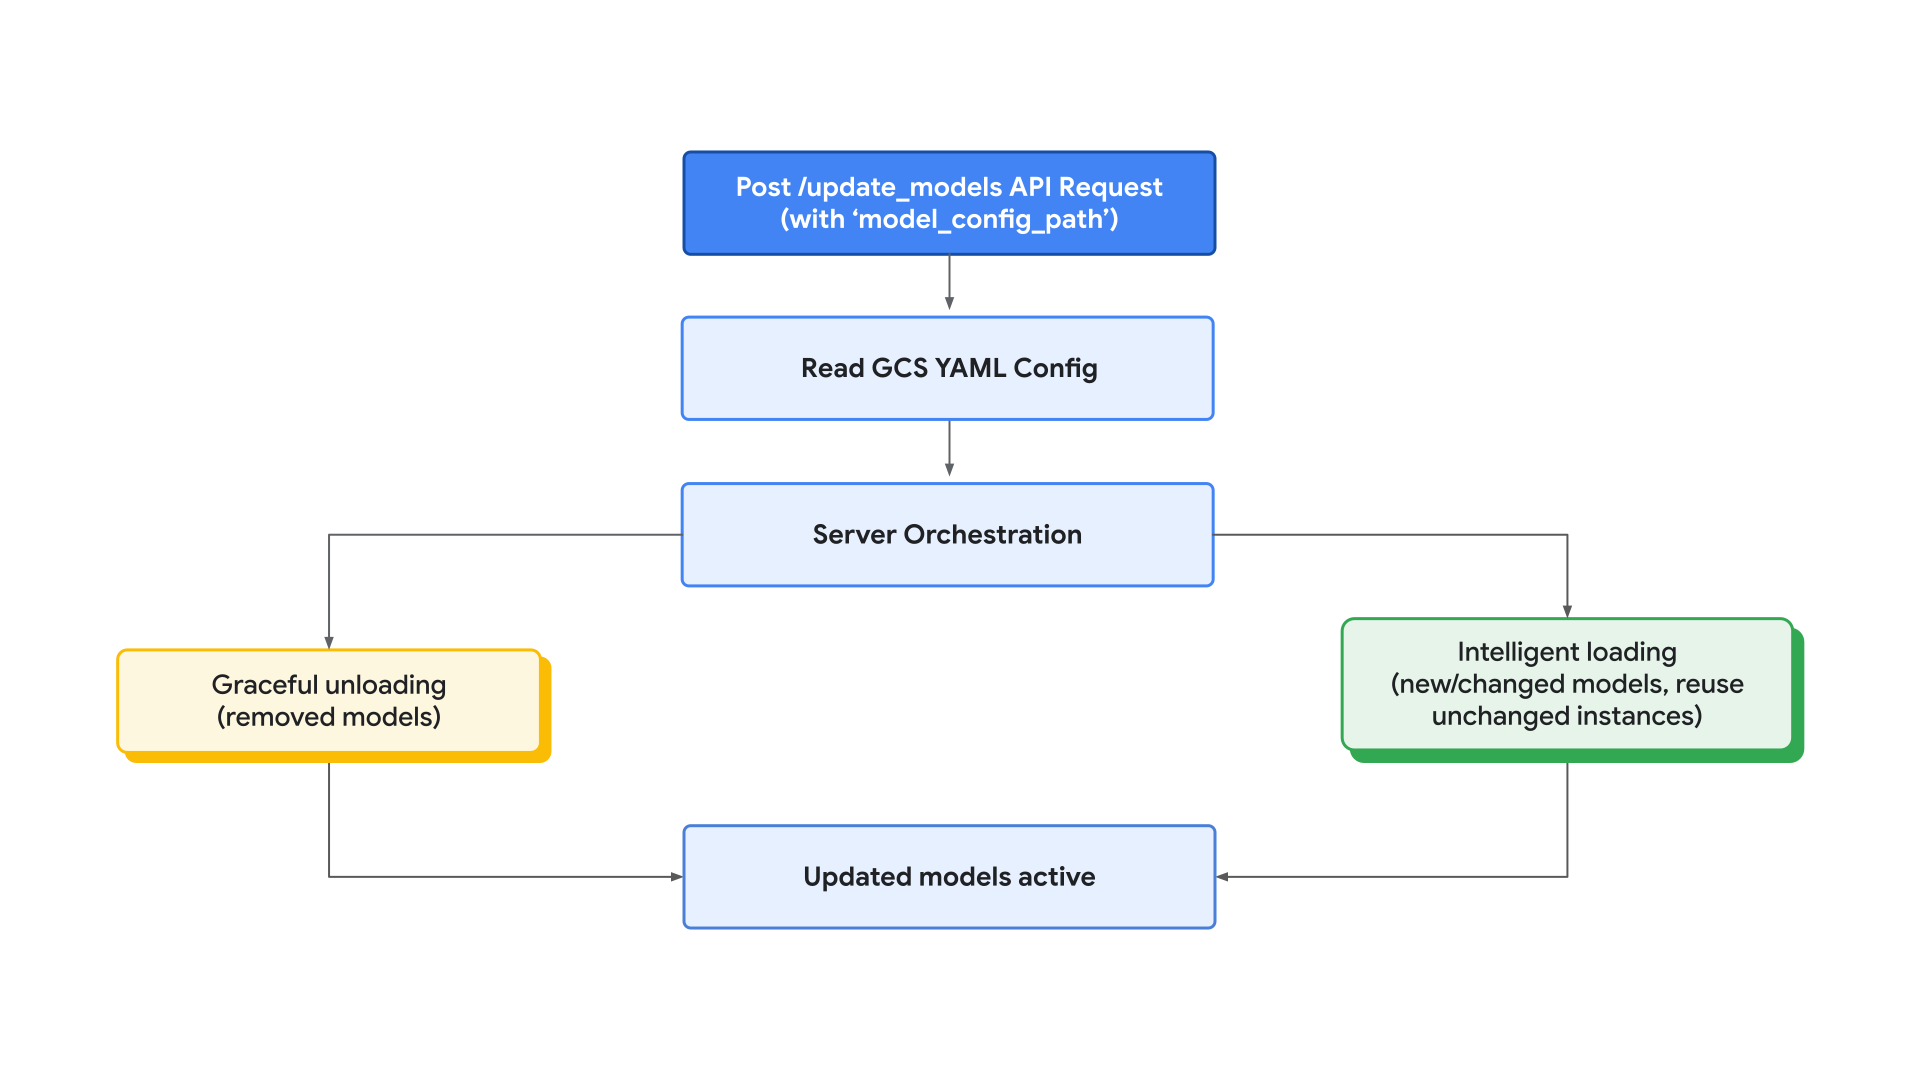
Untuk mengatasi batasan bawaan deployment yang tidak dapat diubah, kami menerapkan API update model khusus dalam container yang menghosting bersama model vLLM Vertex Model Garden. API ini memfasilitasi pemuatan ulang cepat, sehingga server dapat menyesuaikan portofolio model yang dihosting secara langsung berdasarkan file konfigurasi terpusat yang disimpan di bucket Cloud Storage.
Proses update dimulai melalui permintaan POST ke endpoint update_models, yang mencakup model_config_path yang mengarah ke file YAML Cloud Storage.
Setelah menerima permintaan ini, server akan menjalankan urutan orkestrasi multi-tahap yang dioptimalkan untuk periode nonaktif minimal:
- Pembongkaran yang lancar: Sistem mengidentifikasi model yang tidak ada dalam konfigurasi baru dan menghentikan sub-prosesnya terlebih dahulu, lalu segera merebut kembali memori GPU dan resource komputasi.
- Pemuatan dan penggunaan ulang yang cerdas: Server kemudian menginisialisasi instance model baru. Yang penting, jika setelan paralelisme model—seperti Paralelisme Tensor (TP) atau Paralelisme Pipeline (PP)—dan partisi memori yang dialokasikan tetap tidak berubah, orkestrator akan menggunakan kembali instance yang sedang berjalan. Pengoptimalan ini melewati fase inisialisasi ulang yang mahal, sehingga memastikan layanan aktif tetap berjalan tanpa gangguan selama perubahan konfigurasi.
Analisis latensi dan performa
Analisis empiris terhadap strategi update ini mengungkapkan bahwa pemuatan ulang cepat dinamis secara signifikan mengurangi penalti "cold start" yang biasanya terkait dengan penayangan LLM skala besar.
Kesimpulan
Penghostingan bersama model dengan Vertex AI merepresentasikan perubahan paradigma mendasar, yang bertransisi dari deployment monolitik yang kaku dan berat hardware ke arsitektur penayangan yang fleksibel dan efisien. Dengan berkembang melampaui standar "satu model per VM" menjadi model kumpulan komputasi kepadatan tinggi, organisasi dapat secara signifikan mengurangi Total Biaya Kepemilikan (TCO) sekaligus mempertahankan—dan sering kali meningkatkan—tolok ukur performa.
Perjalanan teknik kami dan studi tolok ukur multi-model yang ekstensif telah menetapkan serangkaian pedoman produksi yang pasti untuk arsitektur ini:
- Tidak ada konfigurasi yang cocok untuk semua. Kami menganjurkan untuk menemukan resep penayangan terbaik untuk kasus penggunaan tertentu (model, hardware, traffic), dan membuat alat untuk melakukannya.
- Menskalakan throughput dengan replika.
- Meningkatkan pemanfaatan resource dengan melampaui batas hardware dan membagi memori pada tingkat yang lebih terperinci.
Untuk berhasil menerapkan arsitektur yang dihosting bersama, sebaiknya ikuti alur kerja teknis berikut:
- Partisi eksplisit: Gunakan argumen
--gpu-memory-partitionsuntuk mengalokasikan resource memori untuk setiap model. - Tolok ukur iteratif: Gunakan Utilitas Tolok Ukur yang disediakan untuk mengidentifikasi titik "Persilangan Serentak" tertentu untuk workload Anda—konfigurasi "titik ideal" jumlah instance, TP, dan PP.
Penerapan co-hosting di Google Cloud Model Garden memberikan cetak biru yang dapat diskalakan untuk membangun aplikasi AI dengan kepadatan tinggi. Developer dianjurkan untuk mempelajari kemampuan ini dan mereproduksi tolok ukur kami menggunakan notebook tutorial yang disediakan untuk mengoptimalkan konfigurasi penayangan sesuai persyaratan perusahaan mereka.
Terima kasih telah membaca
Kami menerima masukan dan pertanyaan Anda tentang Vertex AI.
Ucapan terima kasih
Kami ingin menyampaikan rasa terima kasih yang tulus kepada tim Google Cloud Vertex AI. Secara khusus, kami berterima kasih kepada Bo Wu dan Ting Yu atas kepemimpinan dan bimbingan mereka, serta Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur, dan Luis Rizo atas kontribusi mereka yang sangat berharga selama proyek ini.