

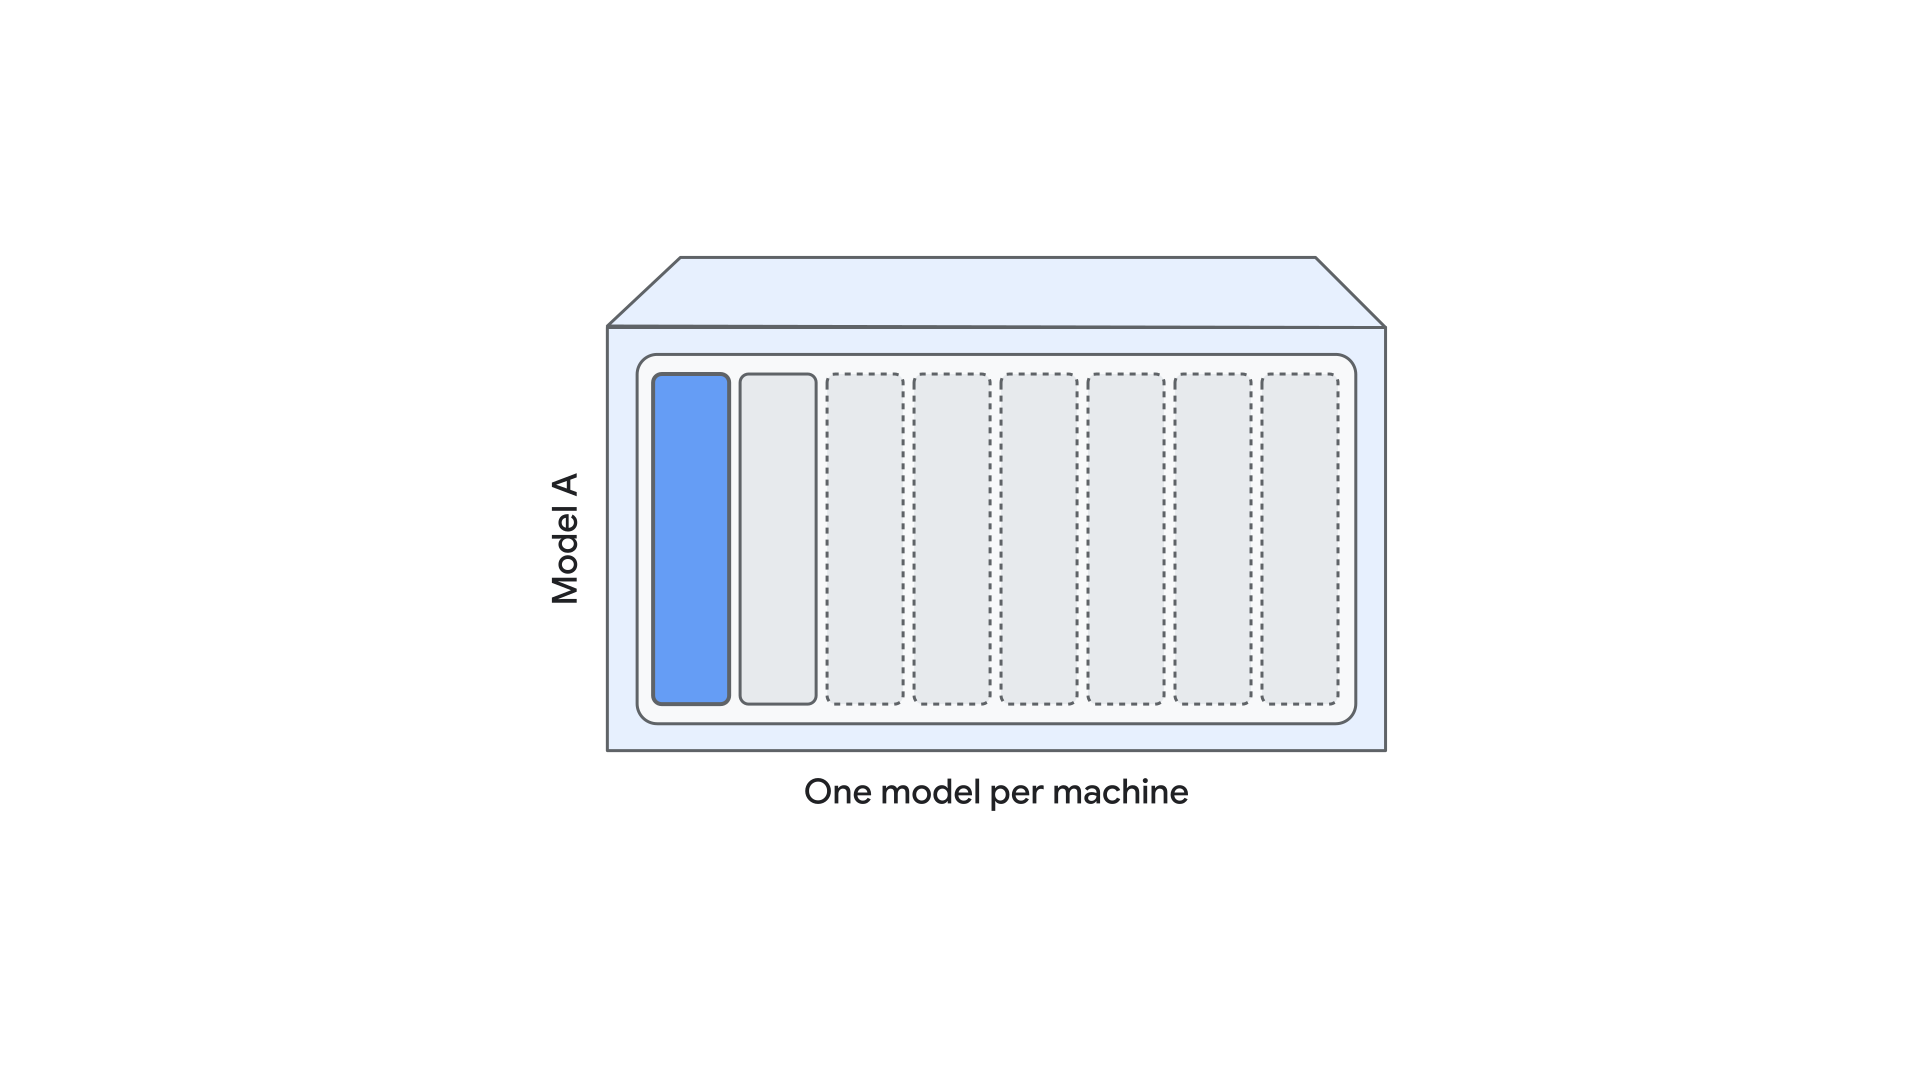
Nel panorama in continua evoluzione dei modelli linguistici di grandi dimensioni (LLMs), il pattern di deployment "un modello per macchina" sta diventando un collo di bottiglia significativo per l'efficienza dei costi di erogazione degli LLM nelle aziende. Gli LLM spesso richiedono prenotazioni hardware sostanziali, come nodi GPU 8x H100 completi, per gestire i carichi di picco. Tuttavia, durante le operazioni standard, queste risorse costose sono spesso sottoutilizzate, il che comporta un costo totale di proprietà (TCO) elevato.
Fai clic per ingrandire l'immagine
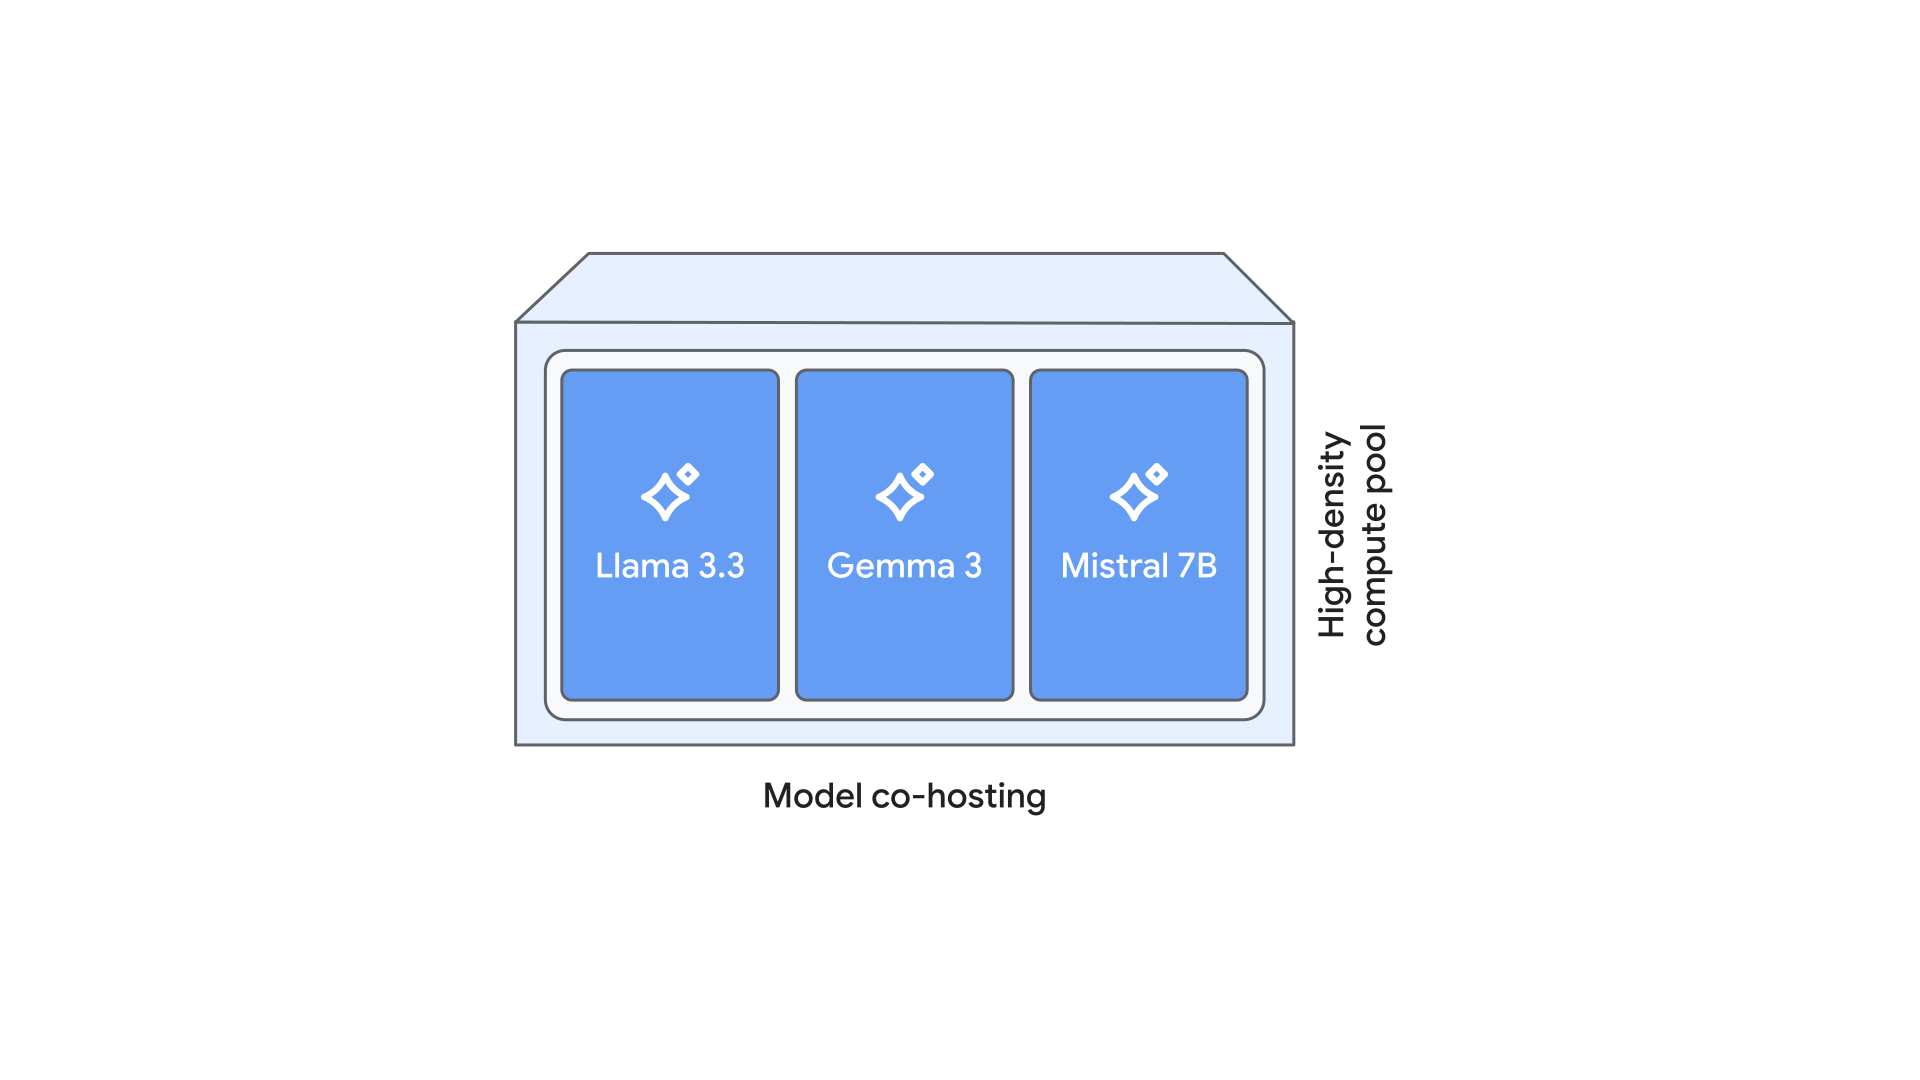
Il co-hosting dei modelli colma questa lacuna di efficienza consentendo a più istanze di modelli di condividere le stesse risorse di macchine virtuali e GPU. Sono inclusi modelli completamente diversi, come Llama 3.3 e Gemma 3. Utilizzando lo slicing della memoria della sotto-GPU e il partizionamento intelligente delle risorse, Vertex AI Model Garden trasforma le prenotazioni hardware statiche in pool di computing flessibili ad alta densità.
Fai clic per ingrandire l'immagine
Questo blog tecnico descrive in dettaglio il processo di Vertex AI Engineering per portare il co-hosting dei modelli a un servizio cloud pronto per la produzione. Condivideremo la nostra metodologia per le strategie di implementazione a livello di container, l'identificazione delle configurazioni di erogazione ottimali e i risultati chiave del nostro studio di benchmark multi-modello approfondito, che ti consentirà di massimizzare l'efficienza dei costi di erogazione degli LLM.
Informazioni sul co-hosting dei modelli: concetto e architettura
Il co-hosting dei modelli è una strategia di erogazione ad alta densità che consente a più istanze di modelli linguistici di grandi dimensioni (LLM) o a diverse architetture di modelli di condividere le stesse risorse hardware fisiche all'interno di una singola macchina virtuale (VM). A differenza dei modelli di deployment tradizionali che dedicano una VM o una GPU completa a un singolo modello, il co-hosting utilizza il partizionamento granulare delle risorse per massimizzare il ROI hardware e migliorare l'utilizzo della memoria e delle risorse di calcolo.
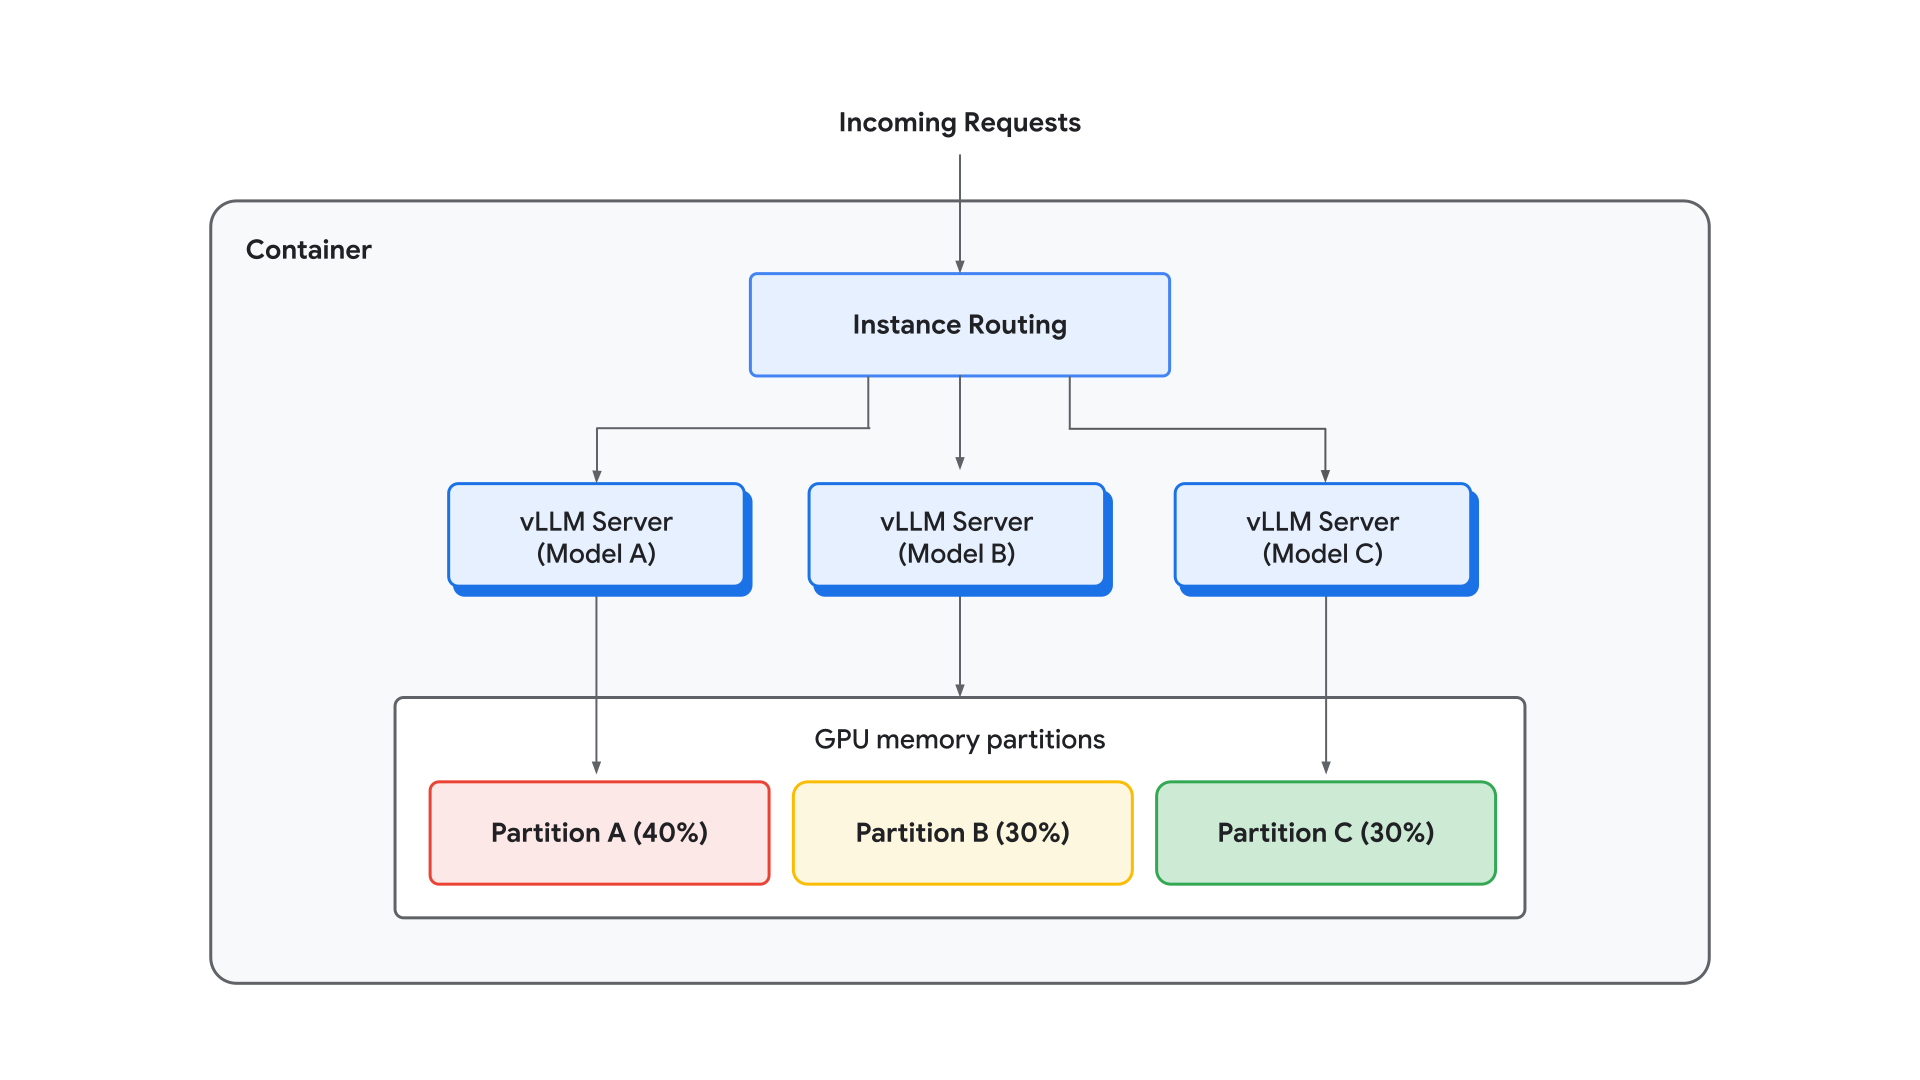
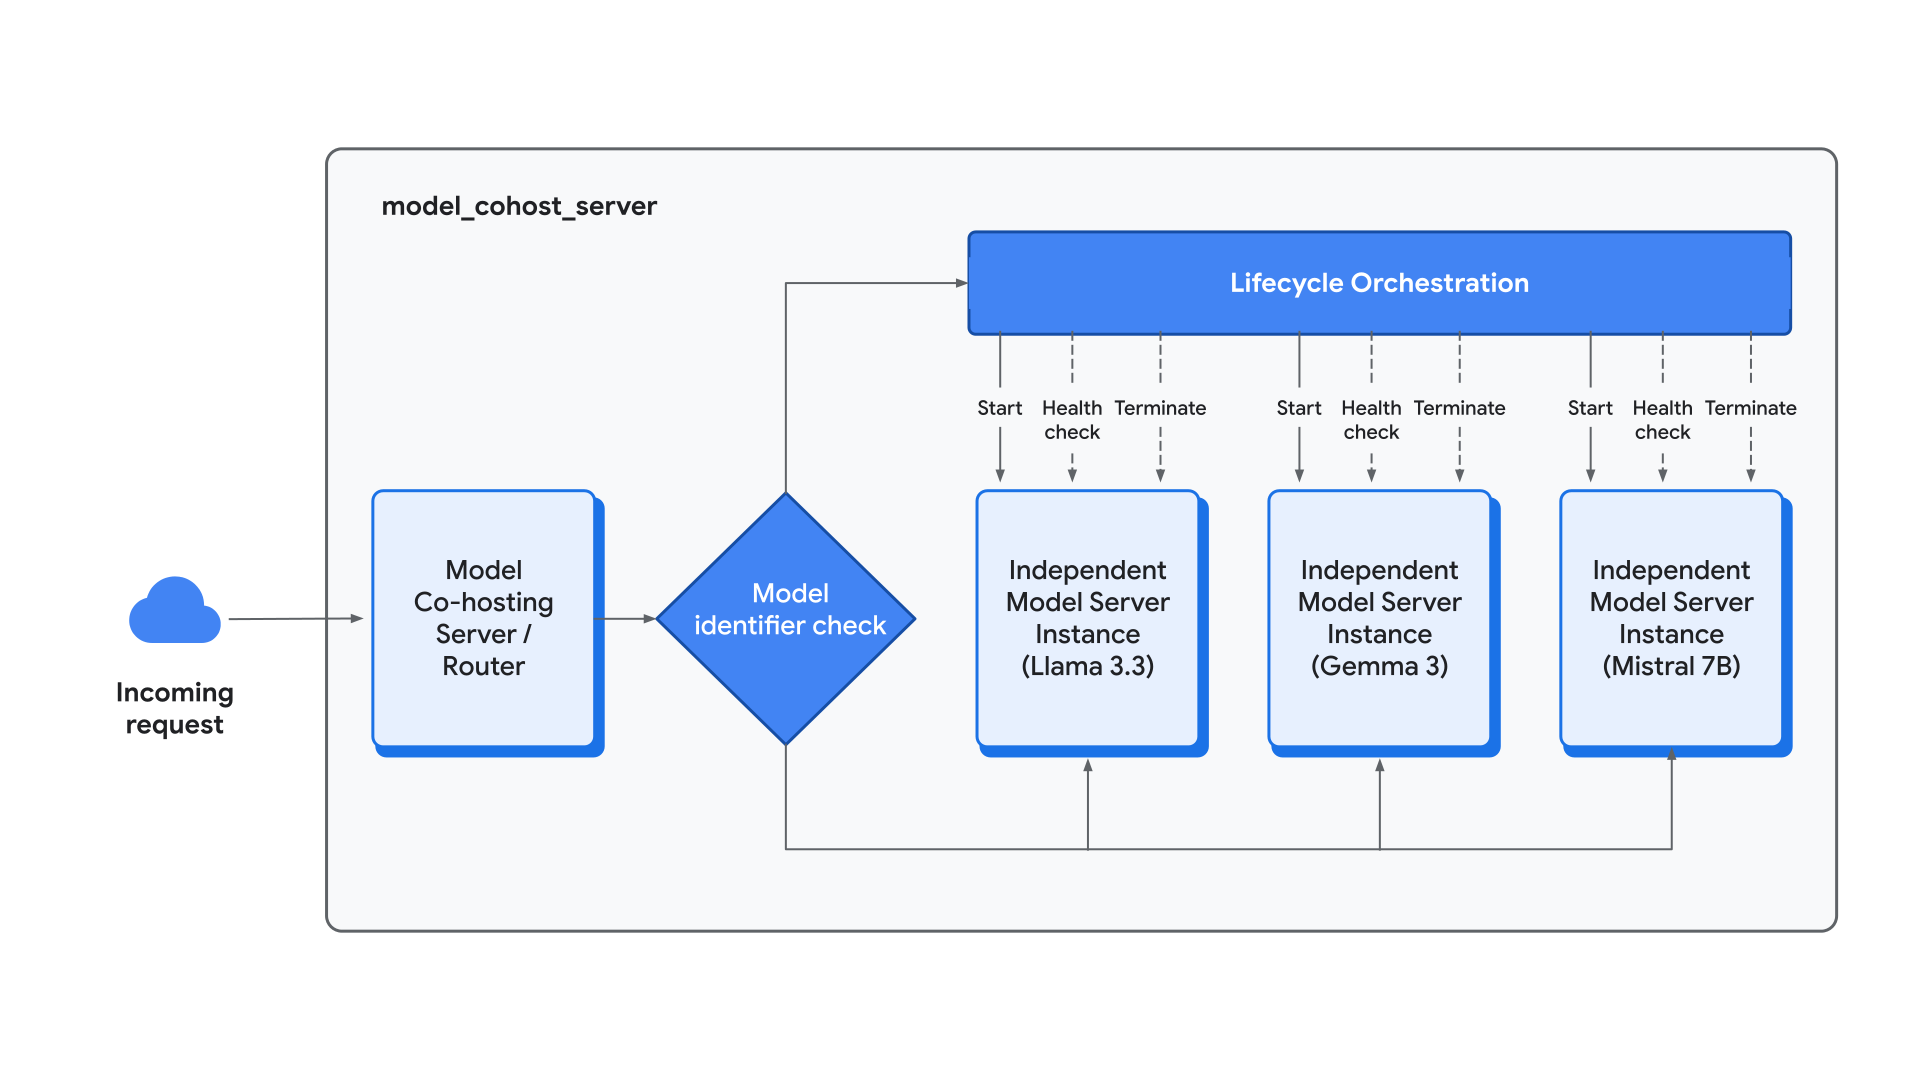
La nostra implementazione si concentra su una soluzione a livello di container che consente l'erogazione simultanea di più modelli con configurazioni indipendenti. Questa architettura funziona tramite diversi meccanismi tecnici integrati, a partire dal deployment di più istanze di server di modelli indipendenti all'interno di un singolo container. Ognuna di queste istanze funge da copia completa e indipendente del server di modelli, il che consente l'elaborazione simultanea delle richieste nella macchina virtuale. Per gestire questo traffico, abbiamo implementato un livello di routing delle istanze all'interno del container che distribuisce in modo efficiente le richieste in entrata tra le istanze attive.
Questa progettazione fornisce un parallelismo granulare consentendo a ogni modello di co-hosting di utilizzare una configurazione di erogazione dedicata, con impostazioni univoche per Tensor Parallelism (TP), Pipeline Parallelism (PP) e il numero specifico di istanze del modello. Questo è completato dallo slicing delle risorse, in cui a ogni modello vengono assegnate partizioni di memoria GPU specifiche, ad esempio una partizione di memoria GPU di 0,4 per modello, per garantire che carichi di lavoro diversi coesistano sullo stesso acceleratore senza privarsi a vicenda delle risorse di memoria critiche. Questo approccio architetturale trasforma una prenotazione hardware statica, come un nodo GPU 8x H100 completo, in un pool di computing flessibile in grado di erogare un portafoglio diversificato, che va dai modelli di ragionamento di grandi dimensioni ai modelli di chat piccoli e a bassa latenza.
Fai clic per ingrandire l'immagine
Prototipazione e studio di benchmark
Prima di sviluppare il nostro orchestratore pronto per la produzione, abbiamo condotto uno studio di benchmark completo per convalidare l'efficienza teorica del co-hosting dei modelli. Questa fase aveva lo scopo di testare a fondo vLLM's parallelismo nativo e precisamente quantificare il grado di "interferenza" quando i modelli condividono lo stesso silicio.
Indagine sul parallelismo: trovare il "punto di crossover"
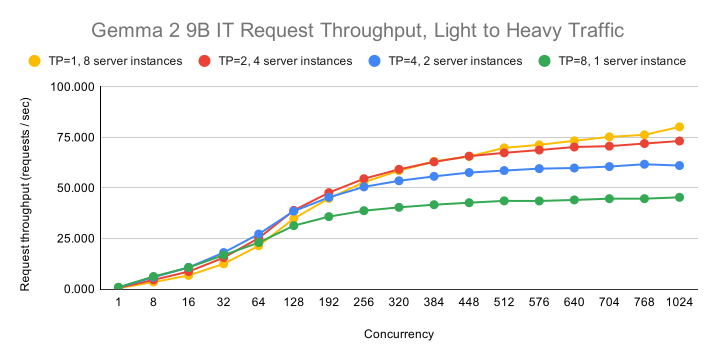
La nostra analisi iniziale si è concentrata sul parallelismo tensoriale (TP) nativo di vLLM e sull'implementazione di Vertex delle istanze di modelli come più istanze di server vLLM per determinare in che modo queste strategie interagiscono con carichi utente variabili. Abbiamo scoperto che la configurazione ottimale dipende molto dalla concorrenza; a concorrenze inferiori, un parallelismo tensoriale elevato (ad es. TP=8) fornisce la latenza più bassa per le singole richieste distribuendo i livelli su tutti gli acceleratori disponibili. Tuttavia, man mano che il traffico simultaneo aumenta, il collo di bottiglia si sposta. Per massimizzare la velocità effettiva in condizioni di carico elevato, la configurazione ottimale passa da TP=8 a TP=4, TP=2 e infine TP=1, aumentando contemporaneamente il numero di istanze di modelli indipendenti. Questa transizione definisce un "punto di crossover" in cui i vantaggi della latenza di comunicazione inter-GPU ridotta nelle configurazioni TP basse superano la velocità effettiva dell'esecuzione TP elevata. Di seguito è riportato un grafico del punto di crossover con il modello Gemma 2 9B IT.
Fai clic per ingrandire l'immagine
Scalabilità ottimale: modello singolo, più repliche
Per stabilire una baseline rigorosa per la scalabilità, abbiamo eseguito il benchmark dell'erogazione di più istanze dello stesso modello su un singolo nodo. In condizioni di traffico di saturazione (2048 richieste simultanee per GPU), l'avvio di otto istanze di server vLLM indipendenti su un nodo 8xH100 ha prodotto un miglioramento della velocità effettiva di circa 7,8 volte con una regressione della latenza praticamente nulla rispetto a una baseline a singola GPU.
Confronto dell'infrastruttura: co-scheduling di container e pod
Abbiamo inoltre valutato la nostra orchestrazione a livello di container rispetto alle soluzioni native a livello di infrastruttura, in particolare il co-scheduling dei pod. Sebbene entrambe le soluzioni abbiano fornito prestazioni comparabili per l'erogazione di più repliche, alla fine abbiamo selezionato l'approccio a livello di container per il nostro minimum viable product (MVP). Questa decisione è stata determinata dalla maggiore flessibilità offerta dalla soluzione a livello di container per il co-hosting eterogeneo, che consente agli sviluppatori di erogare diverse architetture di modelli affiancate con partizioni di memoria granulari software-defined che non sono limitate dai vincoli di pianificazione di Kubernetes sottostanti. Inoltre, l'orchestrazione a livello di container consente di eseguire iterazioni molto più rapidamente ed è più facile da personalizzare e innovare.
Il test di interferenza: co-hosting di modelli diversi
La pietra miliare finale della prototipazione è stata il "test di interferenza", in cui abbiamo eseguito il co-hosting di Gemma-3n-E2B-it e Llama-3.1-8B-Instruct sulla stessa VM. Con ogni modello assegnato a una partizione di memoria GPU di 0,4, le prestazioni di erogazione sono rimaste quasi identiche ai benchmark a modello singolo. Ad esempio, Gemma-3n ha raggiunto 30,21 richieste in un ambiente di co-hosting rispetto a 30,96 richieste in isolamento. Questi risultati confermano che l'interferenza di calcolo tra i modelli di co-hosting è minima o nulla, anche in caso di traffico intenso, a condizione che le risorse di memoria siano partizionate in modo appropriato per evitare la carenza di cache KV cache.
Implementazione del container MVP
La transizione da un benchmark convalidato a un sistema pronto per la produzione ha richiesto la progettazione di un orchestratore containerizzato e robusto. Questa fase di sviluppo si è concentrata sulla creazione di un livello software di alto livello in grado di gestire le complessità di più cicli di vita dei modelli garantendo al contempo l'isolamento deterministico delle risorse.
Progettazione del server di co-hosting dei modelli
Il cuore della nostra implementazione è model_cohost_server, un punto di ingresso personalizzato progettato per fungere da orchestratore principale all'interno del container. A differenza del modello standard a processo singolo, questo server implementa la gestione dei sottoprocessi, facilitando l'esecuzione simultanea di più istanze di server di modelli indipendenti, come vLLM, come sottoprocessi isolati. Per gestire il traffico in entrata, l'orchestratore utilizza il routing delle richieste di alto livello, identificando le richieste in base ai relativi identificatori di modelli univoci tramite argomenti come --served-model-name e indirizzandole all'istanza del server interno corrispondente. Oltre al routing, il server fornisce un'orchestrazione completa del ciclo
di vita, gestendo l'inizializzazione, il monitoraggio dello stato e la terminazione
di tutte le istanze di co-hosting. Questa gestione centralizzata fornisce un singolo endpoint unificato per il traffico esterno, mantenendo al contempo i limiti operativi distinti di ogni sottoprocesso.
Fai clic per ingrandire l'immagine
Partizionamento delle risorse GPU: slicing deterministico
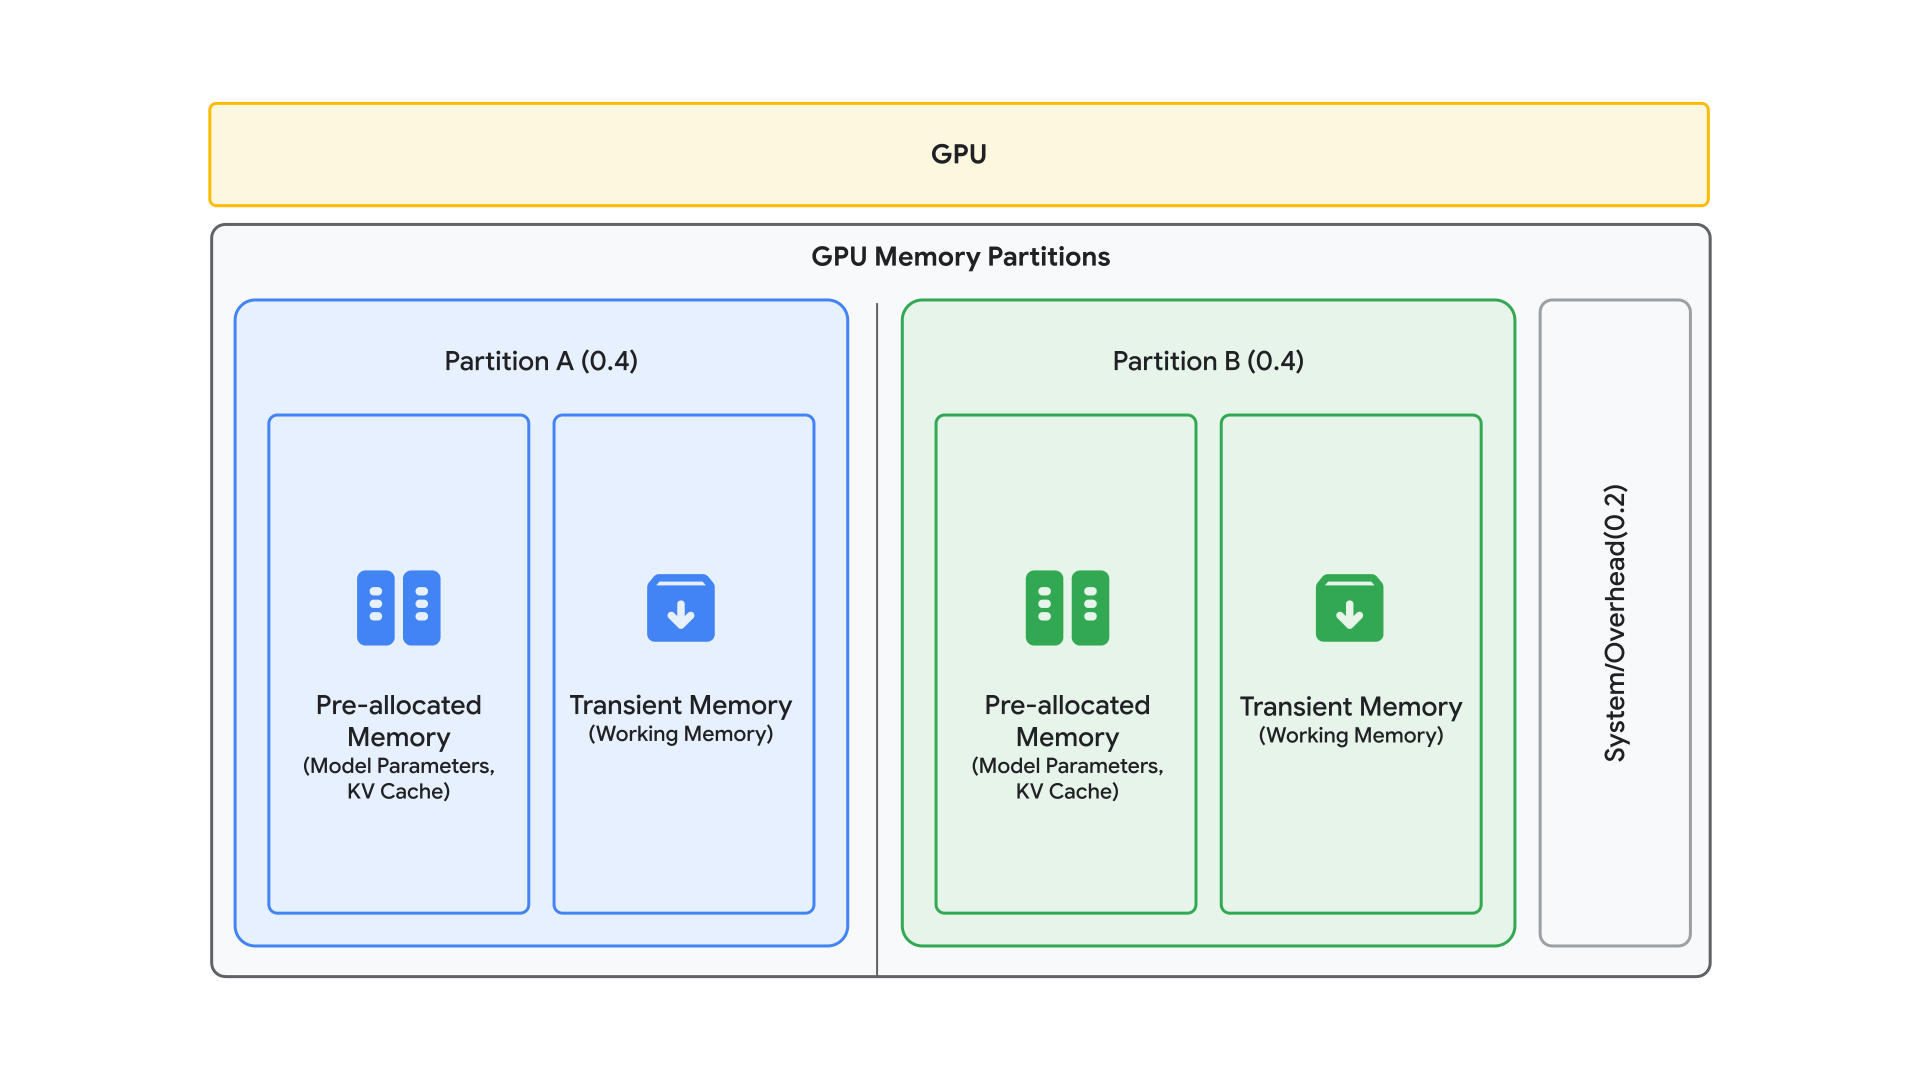
Per eliminare il rischio che il carico di lavoro di un singolo modello attivi un errore di memoria insufficiente (OOM) nell'ambiente di co-hosting, abbiamo implementato un meccanismo di slicing delle risorse rigoroso. Questa operazione viene eseguita tramite l'argomento gpu-memory-partition, che consente agli sviluppatori di definire rapporti di memoria espliciti (ad es. 0,4, 0,4) per riservare una percentuale fissa della memoria GPU totale di un nodo per ogni singola istanza del modello.
Per guidare questa allocazione, adottiamo un "memoria pre-allocata vs. temporanea"
modello, che distingue tra requisiti di risorse statici e dinamici.
La memoria "pre-allocata" è costituita dalla memoria utilizzata per i pesi del modello e la cache KV. La quantità di memoria utilizzata per i pesi del modello dipende dal numero di parametri e dalla precisione del modello. Ad esempio, un modello di parametri 8B in BF16 richiede circa 16 GB di spazio di archiviazione statico. La quantità di memoria utilizzata per la cache KV dipende dalle dimensioni del modello, dalla precisione, dalla finestra contestuale e dal numero di sequenze. La memoria"temporanea" è costituita da calcoli intermedi e
memoria di lavoro di inferenza. L'argomento gpu-memory-partition tiene conto della memoria "pre-allocata". Ti consigliamo di lasciare spazio di buffer per la memoria "temporanea" impostando la somma di gpu-memory-partition su un valore inferiore a 1,0.
Fai clic per ingrandire l'immagine
Produzione
La fase di produzione del co-hosting dei modelli con Vertex AI è stata dedicata alla creazione di un ambiente fluido e pronto per la produzione per le configurazioni di erogazione di più repliche a modello singolo e di più modelli. Questa transizione ha tradotto efficacemente i risultati empirici dei benchmark in workflow di deployment semplificati e strutture di supporto dell'infrastruttura profondamente integrate.
Workflow di deployment semplificati
Per ridurre la barriera all'ingresso per l'erogazione ad alta densità, abbiamo standardizzato le configurazioni di co-hosting utilizzando argomenti di container personalizzati che si integrano in modo nativo con le API Vertex AI esistenti. Per le macchine virtuali a forma completa, come un nodo 8x H100, abbiamo sviluppato un' utilità di benchmark per personalizzare le ricette migliori per i tuoi casi d'uso specifici. Questa utilità di benchmark ti consente di trovare la configurazione che bilancia automaticamente il parallelismo tensoriale (TP), il parallelismo della pipeline (PP), e il numero di istanze del modello in base al numero di parametri e alla precisione specifici del modello. Questo è completato dal supporto robusto dell'API Deployment , che consente agli sviluppatori di specificare questi parametri granulari, incluse le partizioni di memoria GPU esatte, direttamente all'interno di una richiesta deployModel standard ed eseguire il deployment dei modelli.
Erogazione dinamica di più modelli
Un progresso significativo nel nostro percorso tecnico è stata la transizione dalle configurazioni statiche a un'architettura di erogazione dinamica. Questa funzionalità è fondamentale per gli ambienti di produzione caratterizzati da pattern di traffico in rapida evoluzione, poiché la possibilità di caricare o scaricare i modelli senza un riavvio completo del container è essenziale per mantenere l'agilità e l'alta disponibilità dell'infrastruttura.
L'API Dynamic Update (update_models)
Per risolvere le limitazioni intrinseche dei deployment immutabili, abbiamo implementato un'API di aggiornamento dei modelli specializzata all'interno del container di co-hosting dei modelli vLLM di Vertex Model Garden. Questa API facilita il ricarico a caldo, consentendo al server di modificare il proprio portafoglio di modelli ospitati in tempo reale in base a un file di configurazione centralizzato archiviato in un bucket Cloud Storage.
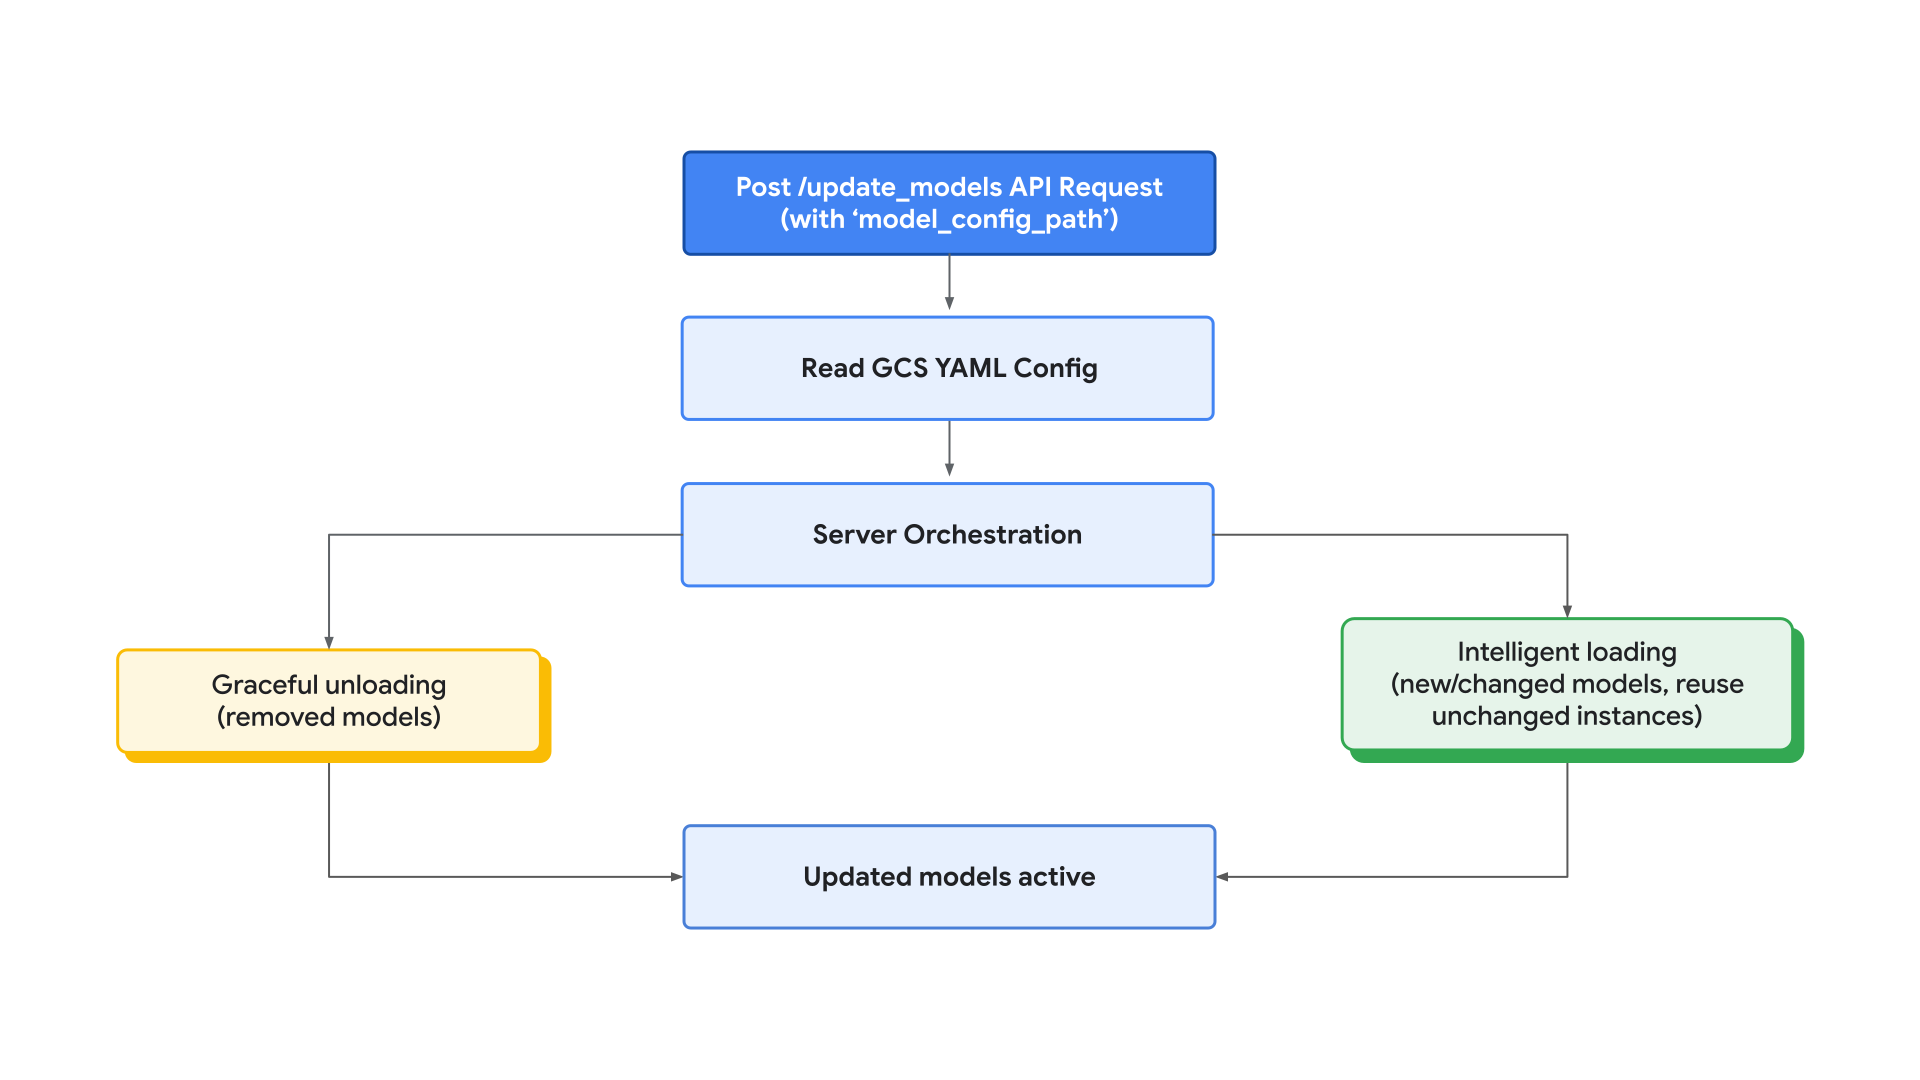
Il processo di aggiornamento viene avviato tramite una richiesta POST all'endpoint update_models, che include model_config_path che punta al file YAML di Cloud Storage.
Dopo aver ricevuto questa richiesta, il server esegue una sequenza di orchestrazione multifase ottimizzata per ridurre al minimo i tempi di inattività:
- Scarico graduale: il sistema identifica i modelli assenti dalla nuova configurazione e termina prima i relativi sottoprocessi, recuperando immediatamente la memoria GPU e le risorse di calcolo.
- Caricamento e riutilizzo intelligenti: il server inizializza quindi le nuove istanze del modello. È fondamentale che, se le impostazioni di parallelismo di un modello, come il parallelismo tensoriale (TP) o il parallelismo della pipeline (PP), e la partizione di memoria allocata rimangono invariate, l'orchestratore riutilizzi l'istanza in esecuzione esistente. Questa ottimizzazione bypassa la costosa fase di reinizializzazione, garantendo che i servizi attivi rimangano ininterrotti durante le modifiche alla configurazione.
Fai clic per ingrandire l'immagine
Analisi di latenza e prestazioni
L'analisi empirica di queste strategie di aggiornamento rivela che il ricarico a caldo dinamico riduce notevolmente la penalità di "avvio a freddo" comunemente associata all'erogazione di LLM su larga scala.
Conclusione
Il co-hosting dei modelli con Vertex AI rappresenta un cambio di paradigma fondamentale, passando da deployment monolitici rigidi e con un elevato utilizzo di hardware a un'architettura di erogazione fluida ed efficiente. Passando dallo standard "un modello per VM" a un modello di pool di computing ad alta densità, le organizzazioni possono ridurre significativamente il costo totale di proprietà (TCO) mantenendo, e spesso migliorando, i benchmark delle prestazioni.
Il nostro percorso di progettazione e gli studi di benchmark multi-modello approfonditi hanno stabilito un insieme definitivo di linee guida di produzione per questa architettura:
- Non esiste una configurazione universale. Consigliamo di trovare la ricetta di erogazione migliore per un caso d'uso specifico (modello, hardware, traffico) e di creare strumenti per farlo.
- Scalare la velocità effettiva con le repliche.
- Migliorare l'utilizzo delle risorse superando i limiti hardware e dividendo la memoria a un livello più granulare.
Per implementare correttamente un'architettura di co-hosting, consigliamo il seguente flusso di lavoro tecnico:
- Partizionamento esplicito: utilizza l'argomento
--gpu-memory-partitionsper allocare le risorse di memoria per i singoli modelli. - Benchmark iterativo: utilizza l'utilità di benchmark fornita per identificare il punto di "crossover di concorrenza" specifico per il tuo carico di lavoro, ovvero la configurazione "ottimale" del numero di istanze, TP e PP.
L'implementazione del co-hosting in Google Cloud Model Garden fornisce un progetto scalabile per la creazione di applicazioni AI ad alta densità. Gli sviluppatori sono invitati a esplorare queste funzionalità e a riprodurre i nostri benchmark utilizzando il notebook del tutorial fornito per ottimizzare le configurazioni di erogazione per i requisiti specifici della loro azienda.
Grazie per l'attenzione
Non esitare a inviarci feedback e domande su Vertex AI.
Ringraziamenti
Vogliamo esprimere la nostra sincera gratitudine al team di Google Cloud Vertex AI. In particolare, ringraziamo Bo Wu e Ting Yu per la loro leadership e la loro guida, nonché Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur e Luis Rizo per i loro preziosi contributi durante questo progetto.