

大規模言語モデル(LLM)の進化する状況において、「マシンごとに 1 つのモデル」というデプロイ パターンは、企業における LLM サービングの費用対効果の重大なボトルネックになりつつあります。LLM では、ピーク時の負荷を管理するために、8 個の H100 GPU ノードなどの大規模なハードウェア予約が必要になることがよくあります。しかし、標準的なオペレーションでは、これらの高価なリソースが十分に活用されず、総所有コスト(TCO)が高くなることがよくあります。
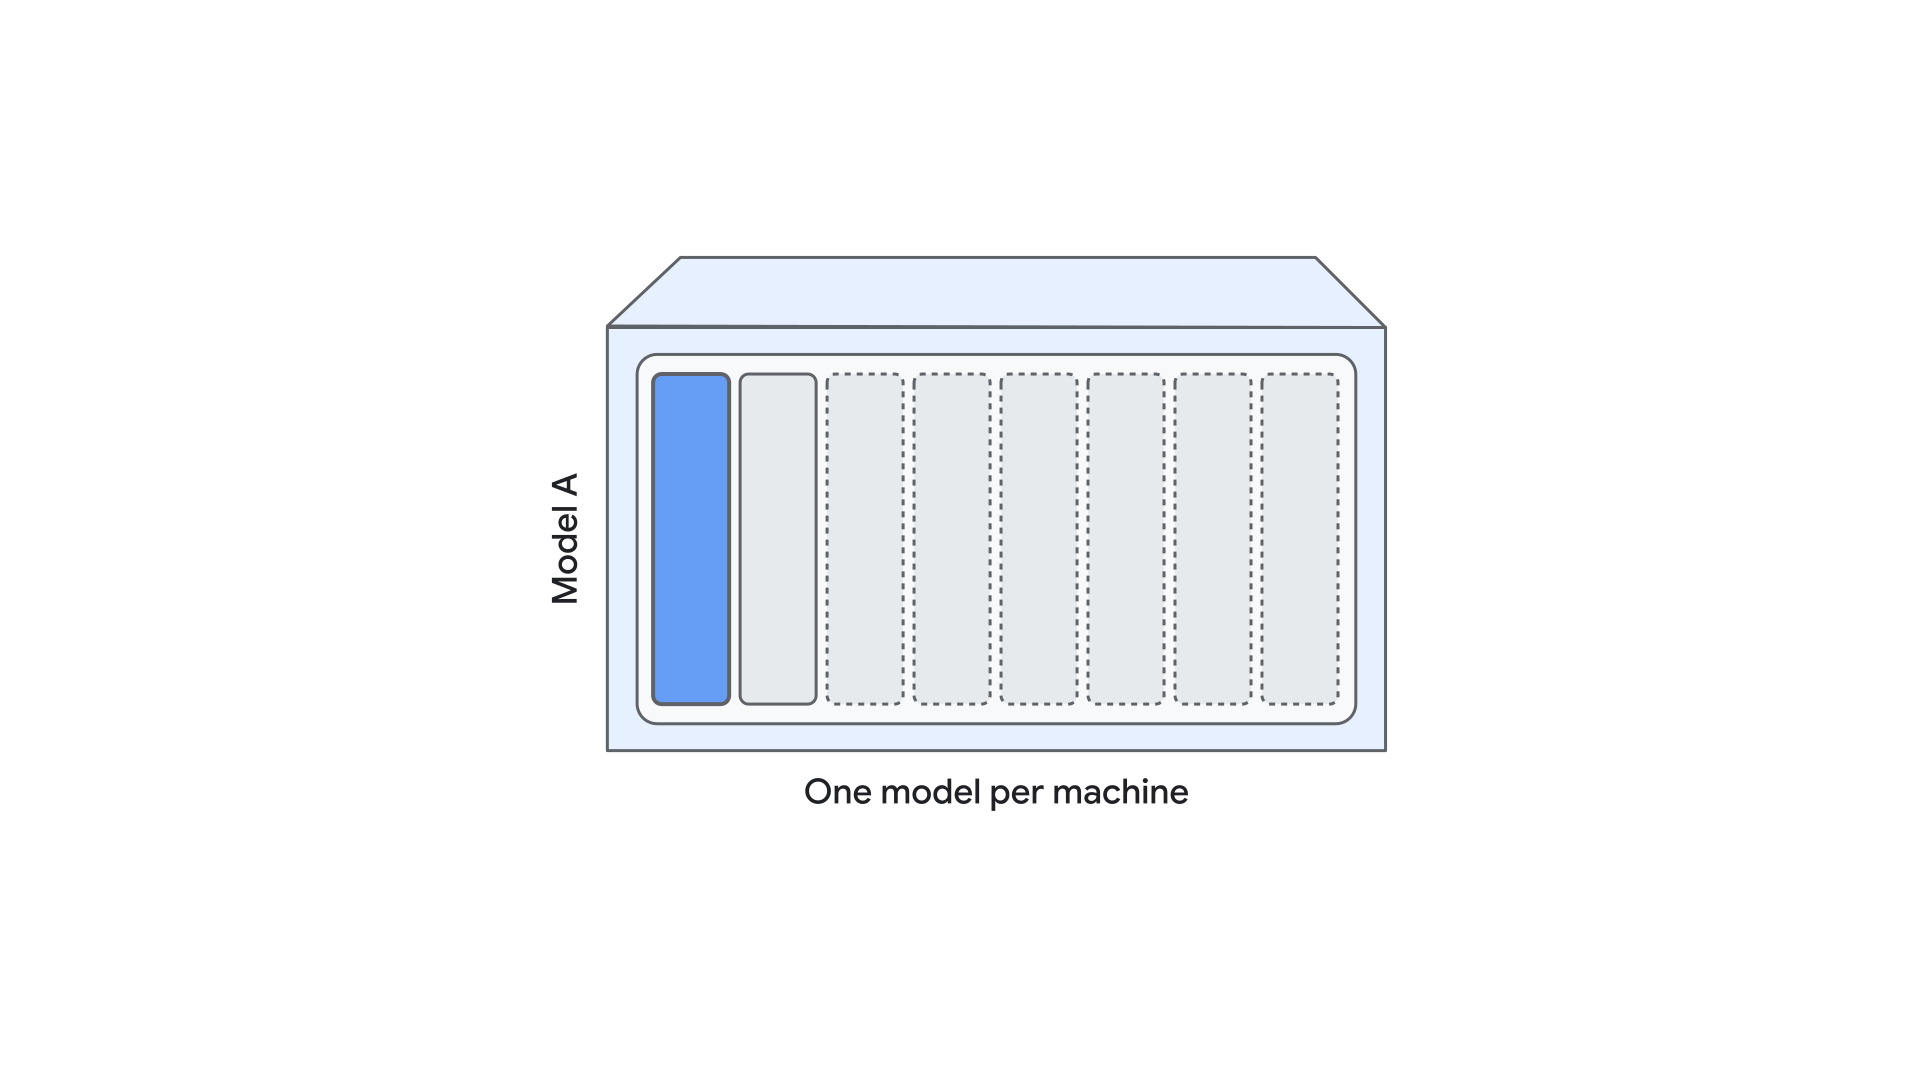
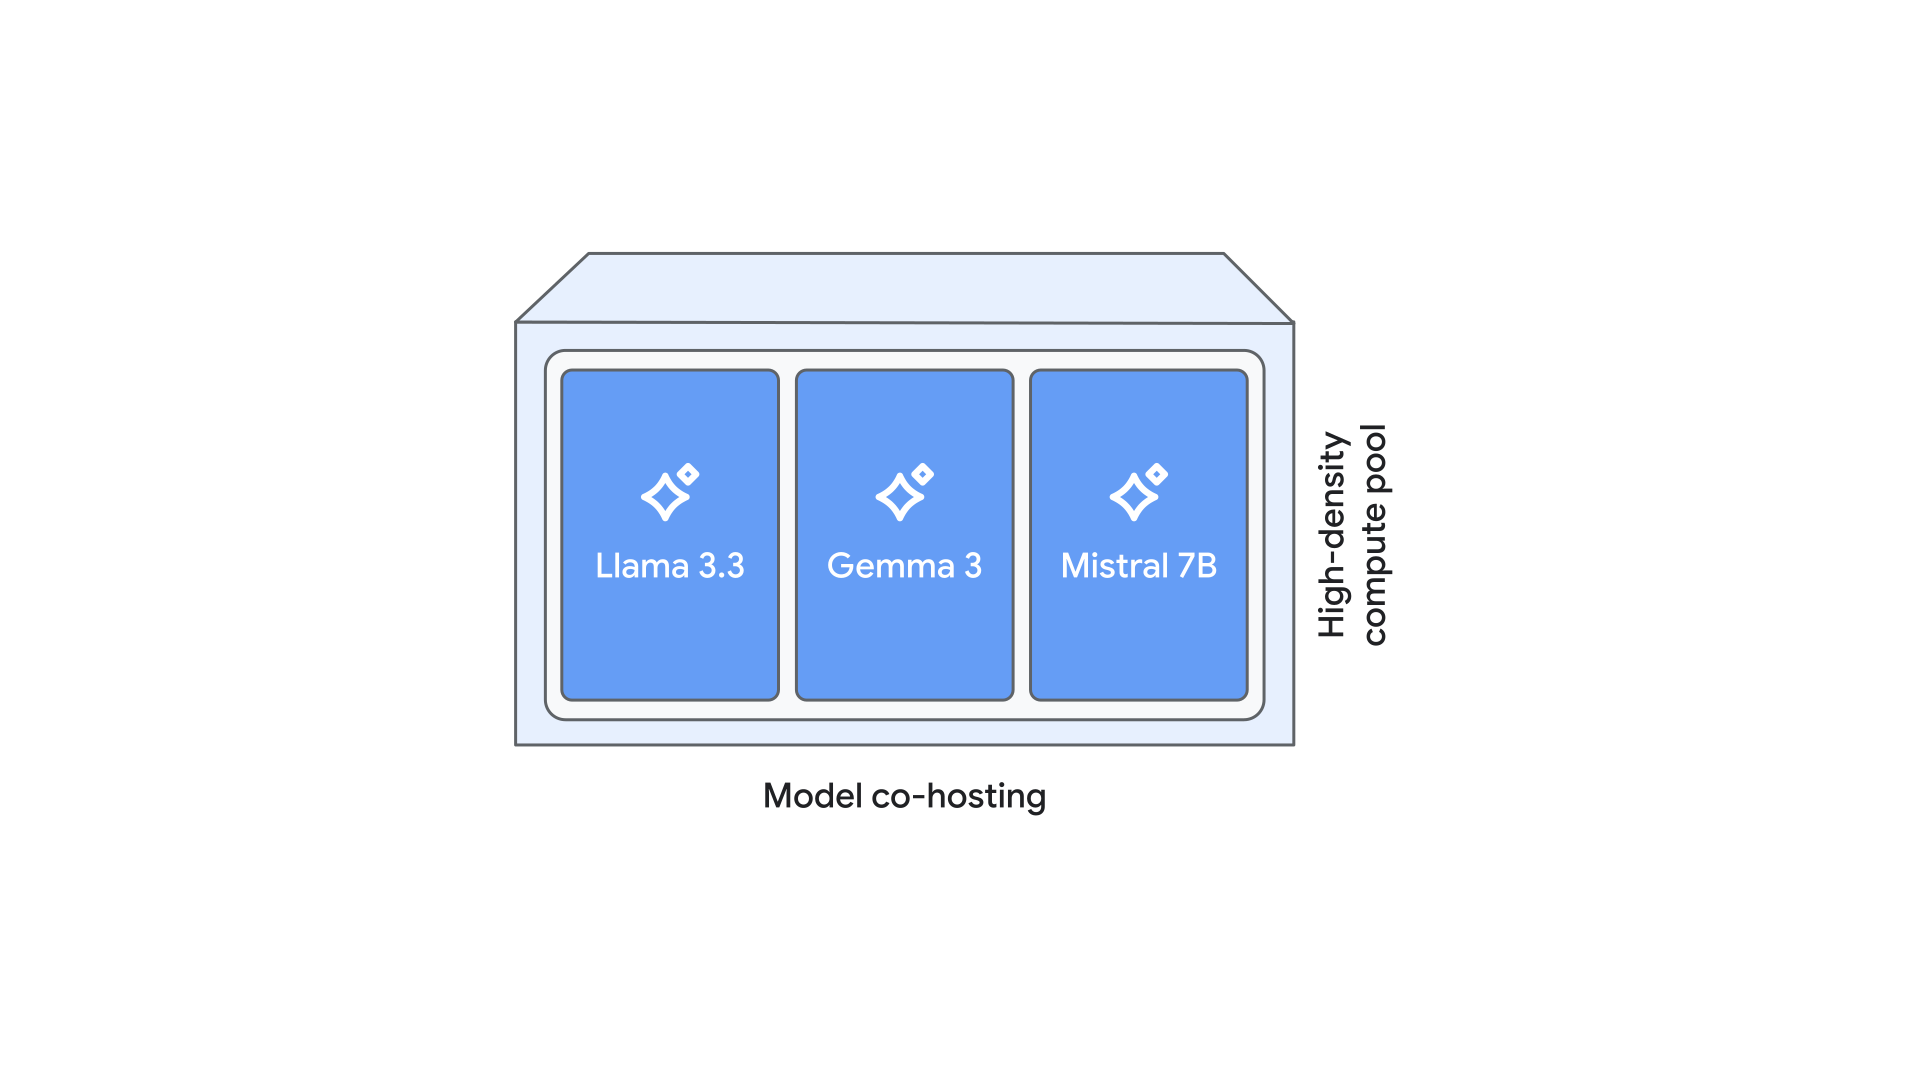
モデルの共同ホスティングは、複数のモデル インスタンスが同じ仮想マシンと GPU リソースを共有できるようにすることで、この効率性のギャップを解消します。これには、Llama 3.3 や Gemma 3 などのまったく異なるモデルも含まれます。サブ GPU メモリ スライスとインテリジェントなリソース パーティショニングを利用することで、Vertex AI Model Garden は静的ハードウェア予約を柔軟な高密度コンピューティング プールに変換します。
この技術ブログでは、Vertex AI Engineering がモデルの共存をプロダクション レディなクラウド サービスに導入するプロセスについて詳しく説明します。コンテナレベルの実装戦略、最適なサービング構成の特定、大規模なマルチモデル ベンチマーク調査の主な結果に関する Google の方法論を紹介します。これにより、LLM サービングの費用対効果を最大限に高めることができます。
モデルの共同ホスティングについて: コンセプトとアーキテクチャ
モデルの共同ホスティングは、複数の大規模言語モデル(LLM)インスタンスまたは異なるモデル アーキテクチャが単一の仮想マシン(VM)内で同じ物理ハードウェア リソースを共有できるようにする高密度サービング戦略です。完全な VM または GPU を単一のモデル専用にする従来のデプロイモデルとは異なり、コホスティングでは、きめ細かいリソース パーティショニングを利用して、ハードウェアの ROI を最大化し、メモリとコンピューティング リソースの使用率を向上させます。
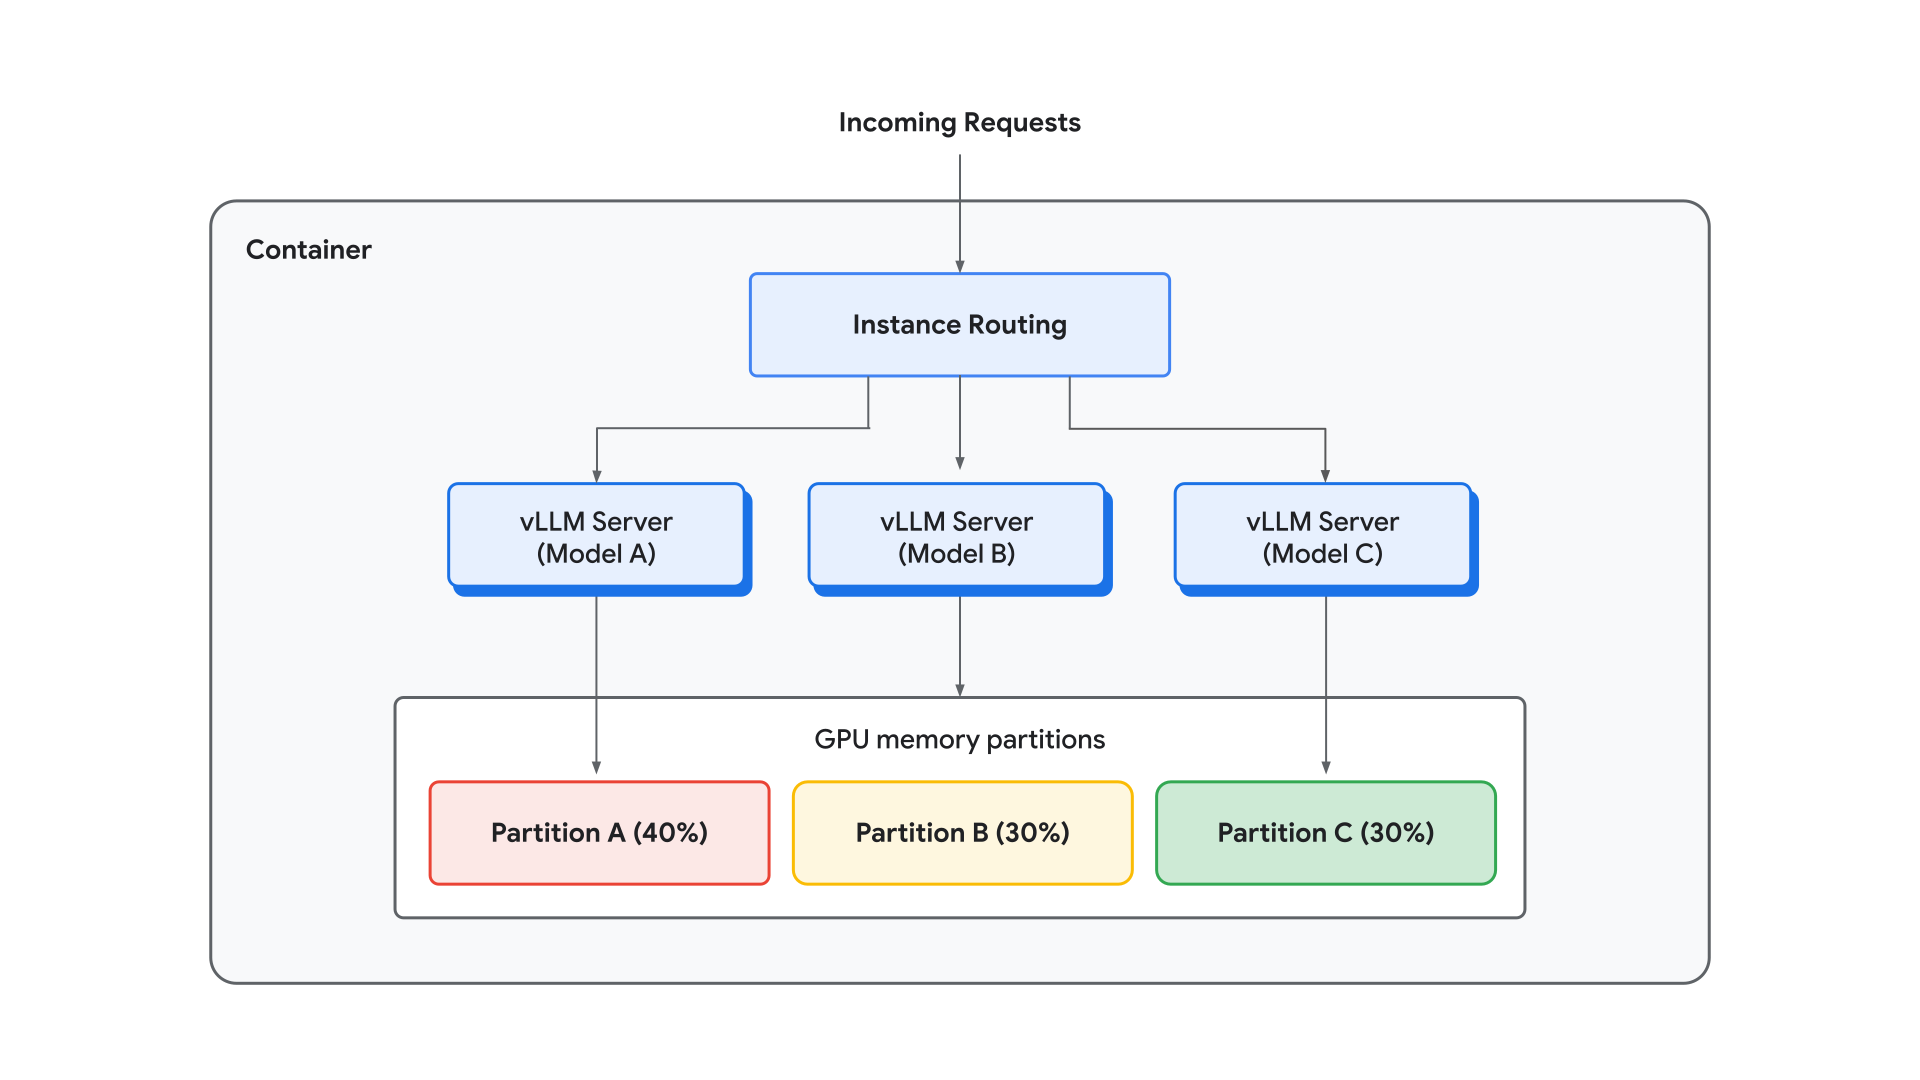
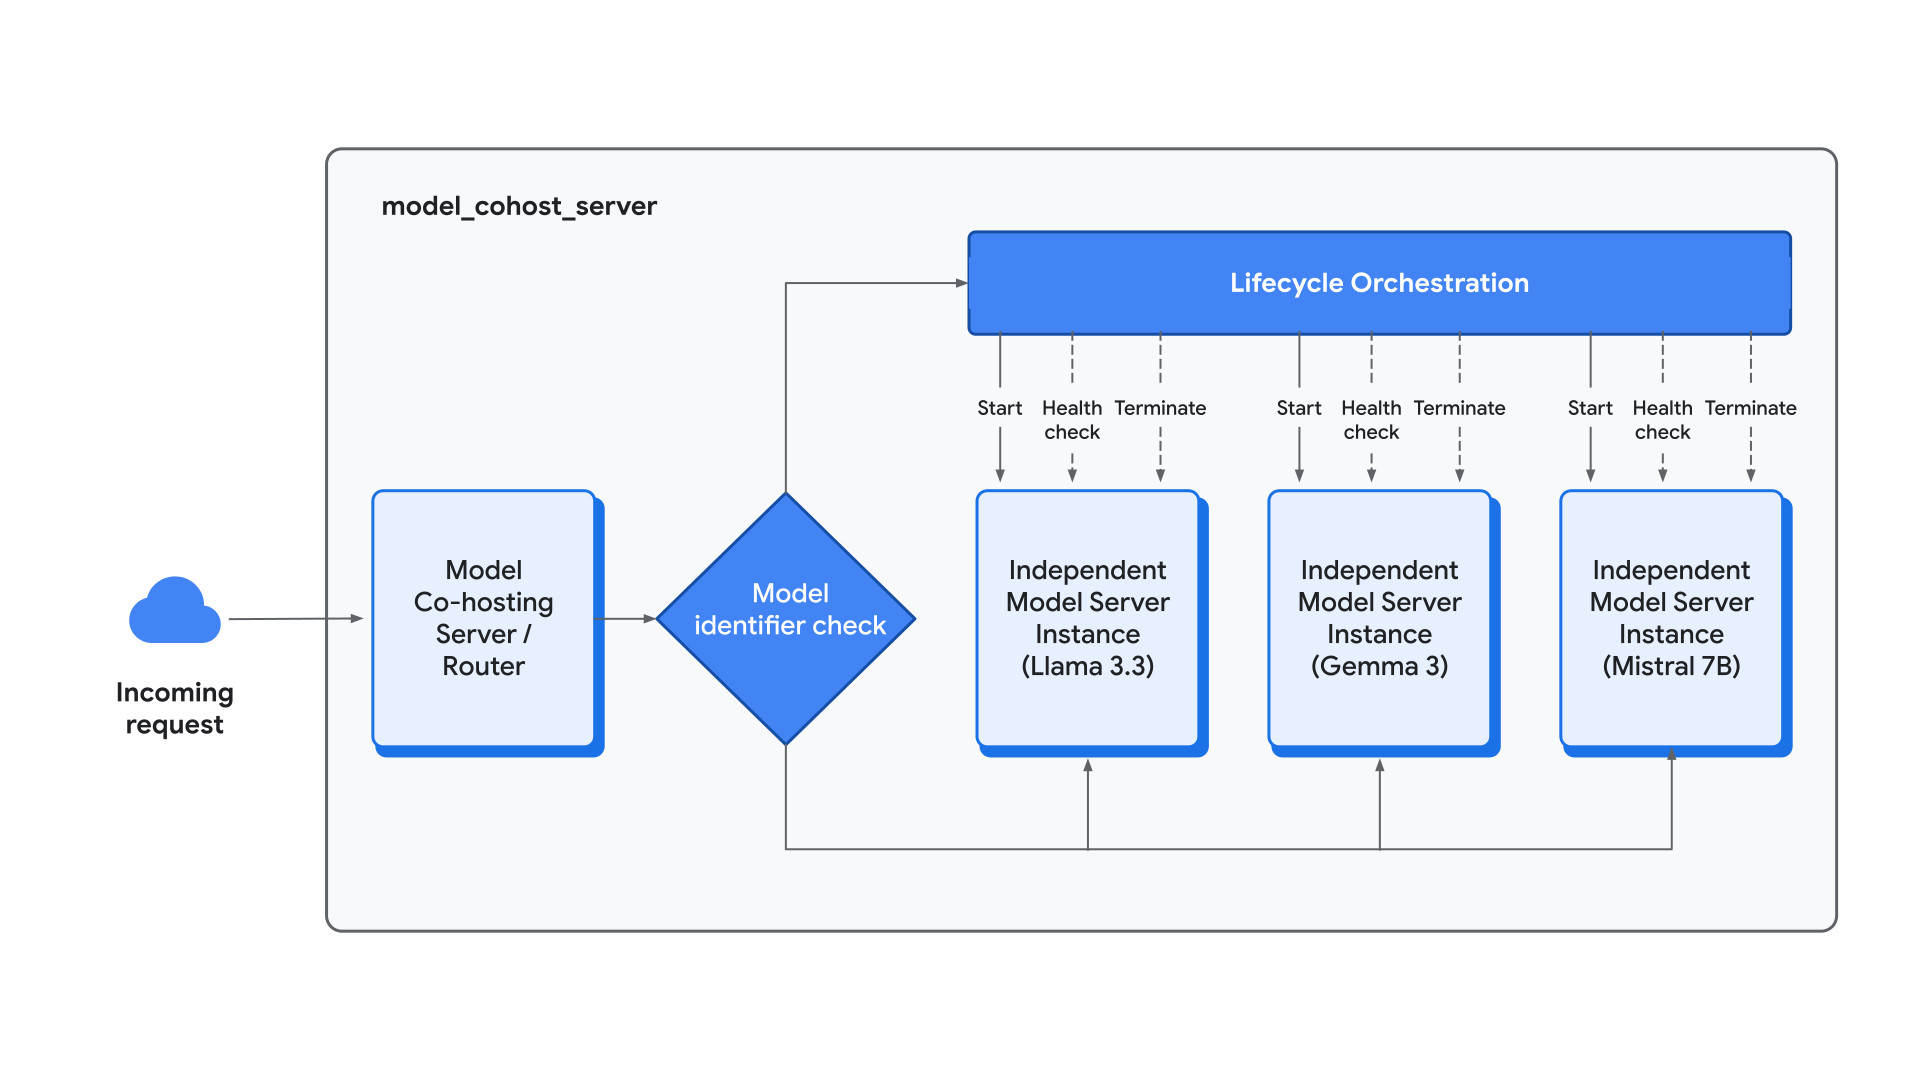
この実装は、独立した構成で複数のモデルを同時にサービングできるコンテナレベルのソリューションに重点を置いています。このアーキテクチャは、単一のコンテナ内に複数の独立したモデルサーバー インスタンスをデプロイすることから始まり、複数の統合された技術メカニズムを通じて動作します。これらの各インスタンスは、モデルサーバーの完全な独立したコピーとして機能し、仮想マシン全体でリクエストを同時に処理できます。このトラフィックを管理するために、コンテナ内にインスタンス ルーティング レイヤを実装し、受信リクエストをアクティブなインスタンス間で効率的に分散しました。
この設計では、各共存モデルが専用のサービング構成を利用できるようにすることで、きめ細かい並列処理を実現します。この構成では、テンソル並列処理(TP)、パイプライン並列処理(PP)、モデル インスタンスの特定の数に固有の設定が用意されています。これはリソース スライスによって補完されます。リソース スライスでは、特定の GPU メモリ パーティション(モデルあたり 0.4 GPU メモリ パーティションなど)が各モデルに割り当てられ、重要なメモリリソースを奪い合うことなく、多様なワークロードが同じアクセラレータ上で共存できるようになります。このアーキテクチャ アプローチにより、8 個の H100 GPU ノードなどの静的なハードウェア予約が、大規模な推論モデルから小規模で低レイテンシのチャットモデルまで、多様なポートフォリオをサービングできる柔軟なコンピューティング プールに変換されます。
プロトタイピングとベンチマーク調査
本番環境対応のオーケストレーターを開発する前に、モデルの共存の理論上の効率性を検証するための包括的なベンチマーク調査を実施しました。このフェーズでは、vLLM のネイティブ並列処理を徹底的にテストし、モデルが同じシリコンを共有する場合の「干渉」の程度を正確に定量化することを目的としていました。
並列処理の調査: 「クロスオーバー ポイント」を見つける
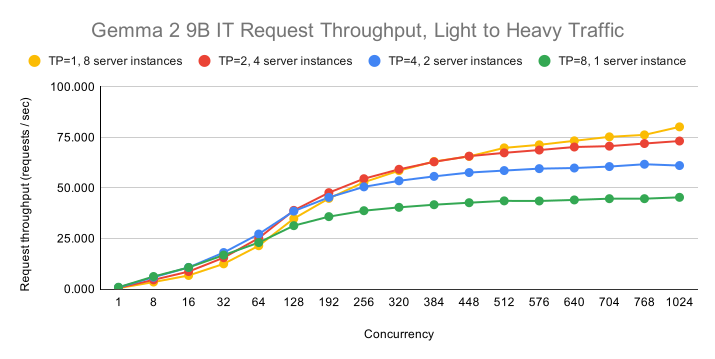
最初の分析では、vLLM のネイティブのテンソル並列処理(TP)と、複数の vLLM サーバー インスタンスとしてのモデル インスタンスの Vertex 実装に焦点を当て、これらの戦略がさまざまなユーザー負荷とどのように相互作用するかを特定しました。最適な構成は同時実行に大きく依存することがわかりました。同時実行が低い場合、高いテンソル並列処理(TP=8 など)では、使用可能なすべてのアクセラレータにレイヤを分散することで、個々のリクエストのレイテンシを最小限に抑えることができます。ただし、同時トラフィックが増加すると、ボトルネックがシフトします。高負荷条件でスループットを最大化するには、最適な構成が TP=8 から TP=4、TP=2、最終的に TP=1 に移行し、同時に独立したモデル インスタンスの数が増加します。この移行は、低 TP 設定での GPU 間の通信レイテンシの短縮というメリットが、高 TP 実行の生速度を上回る「クロスオーバー ポイント」を定義します。次の図は、Gemma 2 9B IT モデルのクロスオーバー ポイント グラフです。
最適なスケーリング: 単一モデル、複数レプリカ
スケーラビリティの厳密なベースラインを確立するため、単一ノードで同じモデルの複数のインスタンスをサービングするベンチマークを実施しました。トラフィックが飽和状態に達していない場合(GPU あたり 2,048 個の同時リクエスト)、8xH100 ノードで 8 個の独立した vLLM サーバー インスタンスを起動すると、単一 GPU のベースラインと比較して、レイテンシの回帰がほぼゼロで、スループットが約 7.8 倍向上しました。
インフラストラクチャの比較: コンテナと Pod の同時スケジューリング
また、コンテナレベルのオーケストレーションをネイティブ インフラストラクチャ レベルのソリューション(特に Pod の同時スケジューリング)と比較して評価しました。どちらのソリューションもマルチレプリカ サービングで同等のパフォーマンスを実現しましたが、最終的に実用最小限の製品(MVP)にはコンテナレベルのアプローチを選択しました。この決定は、コンテナレベルのソリューションが提供する異種共存の優れた柔軟性に基づいています。これにより、デベロッパーは、基盤となる Kubernetes のスケジューリング制約に制限されない、きめ細かいソフトウェア定義のメモリ パーティションを使用して、さまざまなモデル アーキテクチャを並行して提供できます。また、コンテナレベルのオーケストレーションにより、イテレーションを大幅に高速化し、カスタマイズとイノベーションを容易に行うことができます。
干渉テスト: 異なるモデルの共同ホスティング
最後のプロトタイピング マイルストーンは「干渉テスト」でした。このテストでは、Gemma-3n-E2B-it と Llama-3.1-8B-Instruct を同じ VM で共同ホストしました。各モデルに 0.4 GPU メモリ パーティションを割り当てると、サービング パフォーマンスは単一モデルのベンチマークとほぼ同じになりました。たとえば、Gemma-3n は、分離環境では 30.96 reqs に達しましたが、共存環境では 30.21 reqs に達しました。これらの結果は、メモリリソースが KV キャッシュの枯渇を防ぐために適切にパーティショニングされていれば、トラフィックが多い場合でも、同じホストに配置されたモデル間のコンピューティング干渉はほとんどないことを示しています。
MVP コンテナの実装
検証済みのベンチマークからプロダクション レディなシステムへの移行には、堅牢なコンテナ化されたオーケストレーターのエンジニアリングが必要でした。この開発フェーズでは、複数のモデルのライフサイクルの複雑さを管理し、決定論的なリソース分離を保証できる高レベルのソフトウェア レイヤの構築に重点が置かれました。
モデルの共同ホスティング サーバーの設計
実装の中核は model_cohost_server です。これは、コンテナ内のマスター オーケストレータとして機能するように設計されたカスタム エントリ ポイントです。このサーバーは、標準の単一プロセス モデルから逸脱して、サブプロセス管理を実装し、vLLM などの複数の独立したモデルサーバー インスタンスを分離されたサブプロセスとして同時実行できるようにします。受信トラフィックを管理するために、オーケストレーターは高レベルのリクエスト ルーティングを使用します。--served-model-name などの引数を使用して一意のモデル識別子でリクエストを識別し、対応する内部サーバー インスタンスにリクエストを転送します。ルーティング以外にも、サーバーは包括的なライフサイクル オーケストレーションを提供し、すべての共存インスタンスの初期化、ヘルス モニタリング、終了を管理します。この一元管理により、外部トラフィック用の単一の統合エンドポイントが提供され、各サブプロセスの個別の運用境界が維持されます。
GPU リソースのパーティショニング: 決定論的スライス
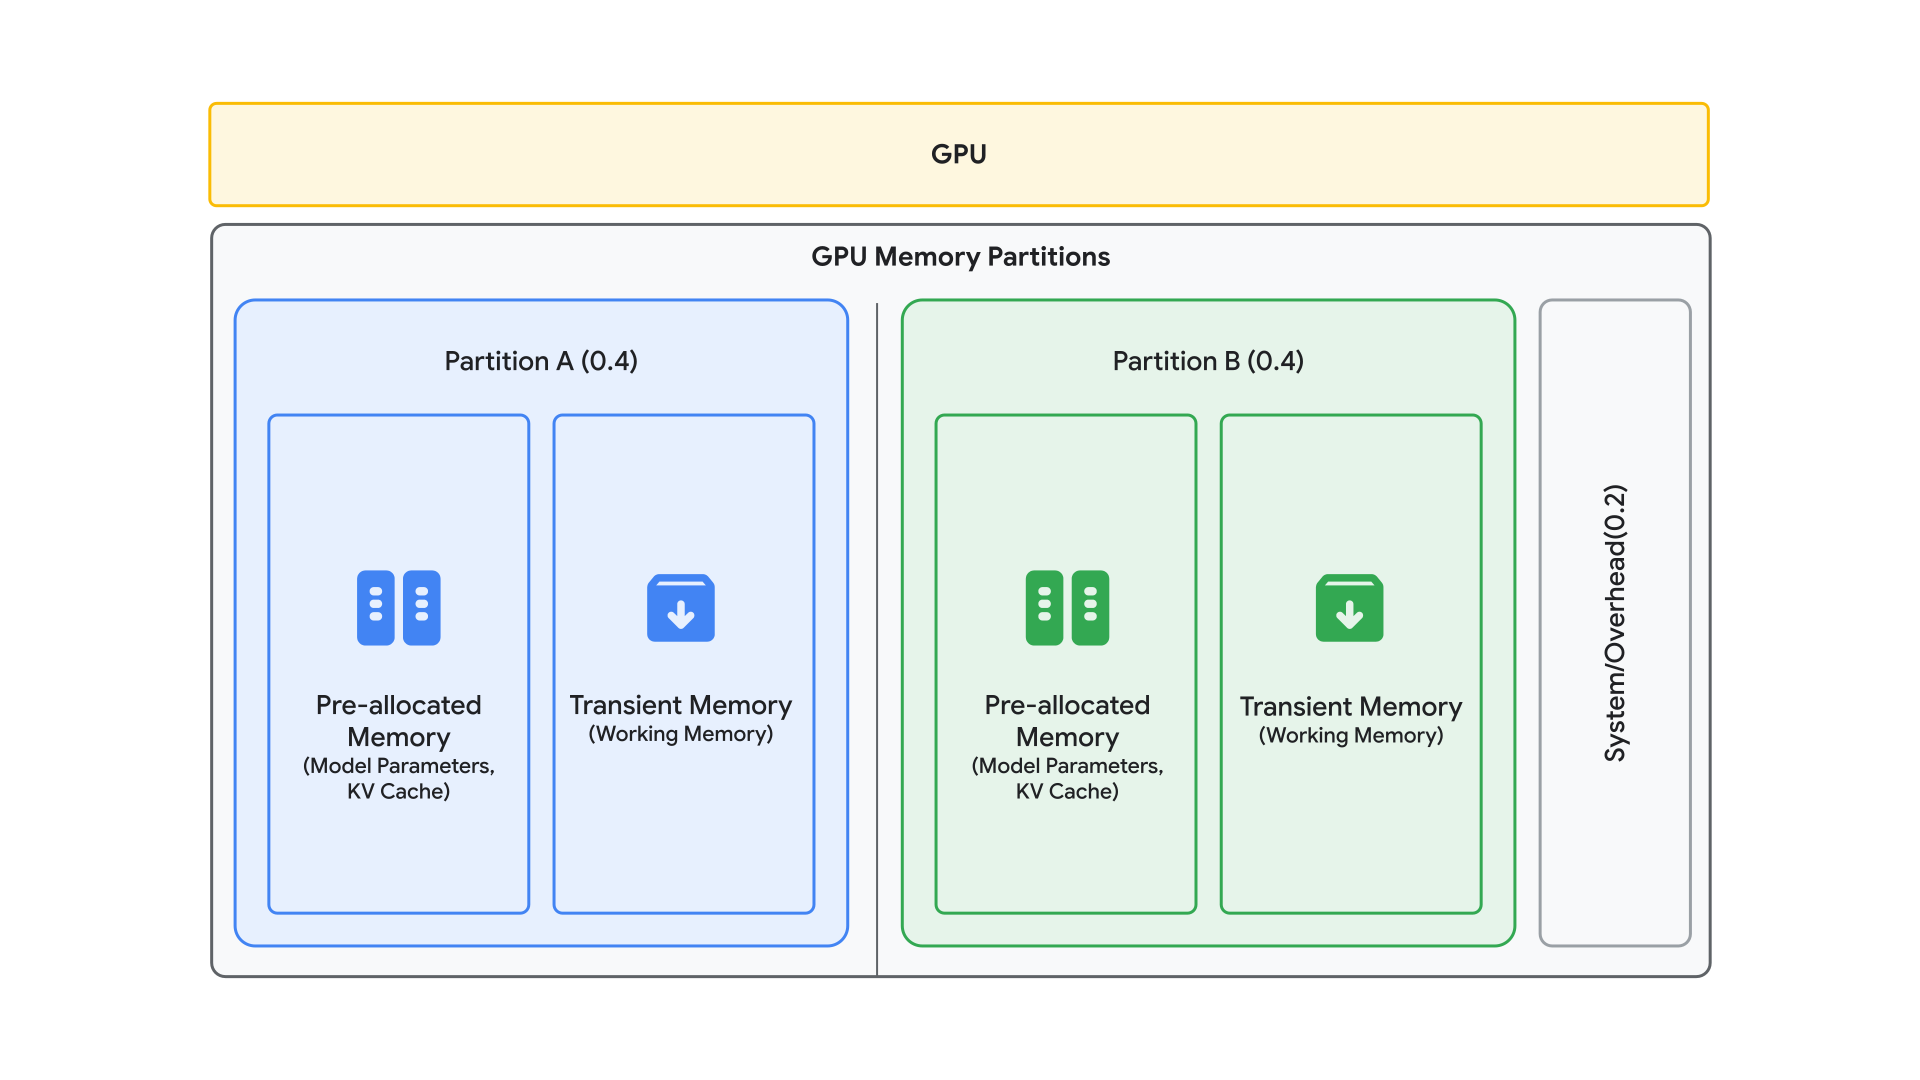
単一モデルのワークロードが共存環境全体でメモリ不足(OOM)エラーをトリガーするリスクを排除するため、厳格なリソース スライス メカニズムを実装しました。これは gpu-memory-partition 引数を使用して運用されます。これにより、デベロッパーは明示的なメモリ比率(0.4、0.4 など)を定義して、ノードの GPU メモリの合計の固定割合を個々のモデル インスタンスごとに予約できます。
この割り当てをガイドするために、静的リソース要件と動的リソース要件を区別する「事前割り当てと一時」メモリモデルを採用しています。「事前割り当て」メモリは、モデルの重みと KV キャッシュに使用されるメモリで構成されます。モデルの重みに使用されるメモリ量は、モデルのパラメータ数と精度によって異なります。たとえば、BF16 の 8B パラメータ モデルには約 16 GB の静的ストレージが必要です。KV キャッシュに使用されるメモリ量は、モデルのディメンション、精度、コンテキスト長、シーケンスの数によって異なります。「一時」メモリは、中間計算と推論の作業メモリで構成されます。gpu-memory-partition 引数は「事前割り当て」メモリを考慮します。gpu-memory-partition の合計を 1.0 より小さく設定して、「一時的な」メモリ用のバッファ領域を残すことをおすすめします。
製品化
Vertex AI を使用したモデルの共同ホスティングの製品化フェーズでは、単一モデルのマルチレプリカとマルチモデルのサービング構成の両方で、シームレスでプロダクション レディな環境の確立に重点が置かれました。この移行により、経験的なベンチマークの結果が、簡素化されたデプロイ ワークフローと高度に統合されたインフラストラクチャ サポート構造に効果的に変換されました。
デプロイ ワークフローの簡素化
高密度サービングの参入障壁を下げるため、既存の Vertex AI API とネイティブに統合されるカスタム コンテナ引数を使用して、共存構成を標準化しました。8x H100 ノードなどのフルシェイプの仮想マシンについては、特定のユースケースに最適なレシピをカスタマイズするためのベンチマーク ユーティリティを開発しました。このベンチマーク ユーティリティを使用すると、モデルの特定のパラメータ数と精度に基づいて、Tensor Parallelism(TP)、Pipeline Parallelism(PP)、モデル インスタンスの数を自動的にバランス調整する構成を見つけることができます。これに加えて、堅牢な Deployment API のサポートにより、開発者は正確な GPU メモリ パーティションなどの詳細なパラメータを標準の deployModel リクエスト内で直接指定して、モデルをデプロイできます。
動的マルチモデル サービング
技術的な取り組みにおける大きな進歩は、静的構成から動的サービング アーキテクチャへの移行でした。この機能は、トラフィック パターンが急速に変化する本番環境で重要です。コンテナを完全に再起動せずにモデルを読み込みまたは読み込み解除できる機能は、インフラストラクチャの俊敏性と高可用性を維持するために不可欠です。
Dynamic Update API(update_models)
不変デプロイの固有の制限に対処するため、Vertex Model Garden vLLM モデルの共同ホスティング コンテナ内に専用のモデル更新 API を実装しました。この API はホット再読み込みを容易にし、サーバーは Cloud Storage バケットに保存されている一元化された構成ファイルに基づいて、ホストされているモデルのポートフォリオをオンザフライで調整できます。
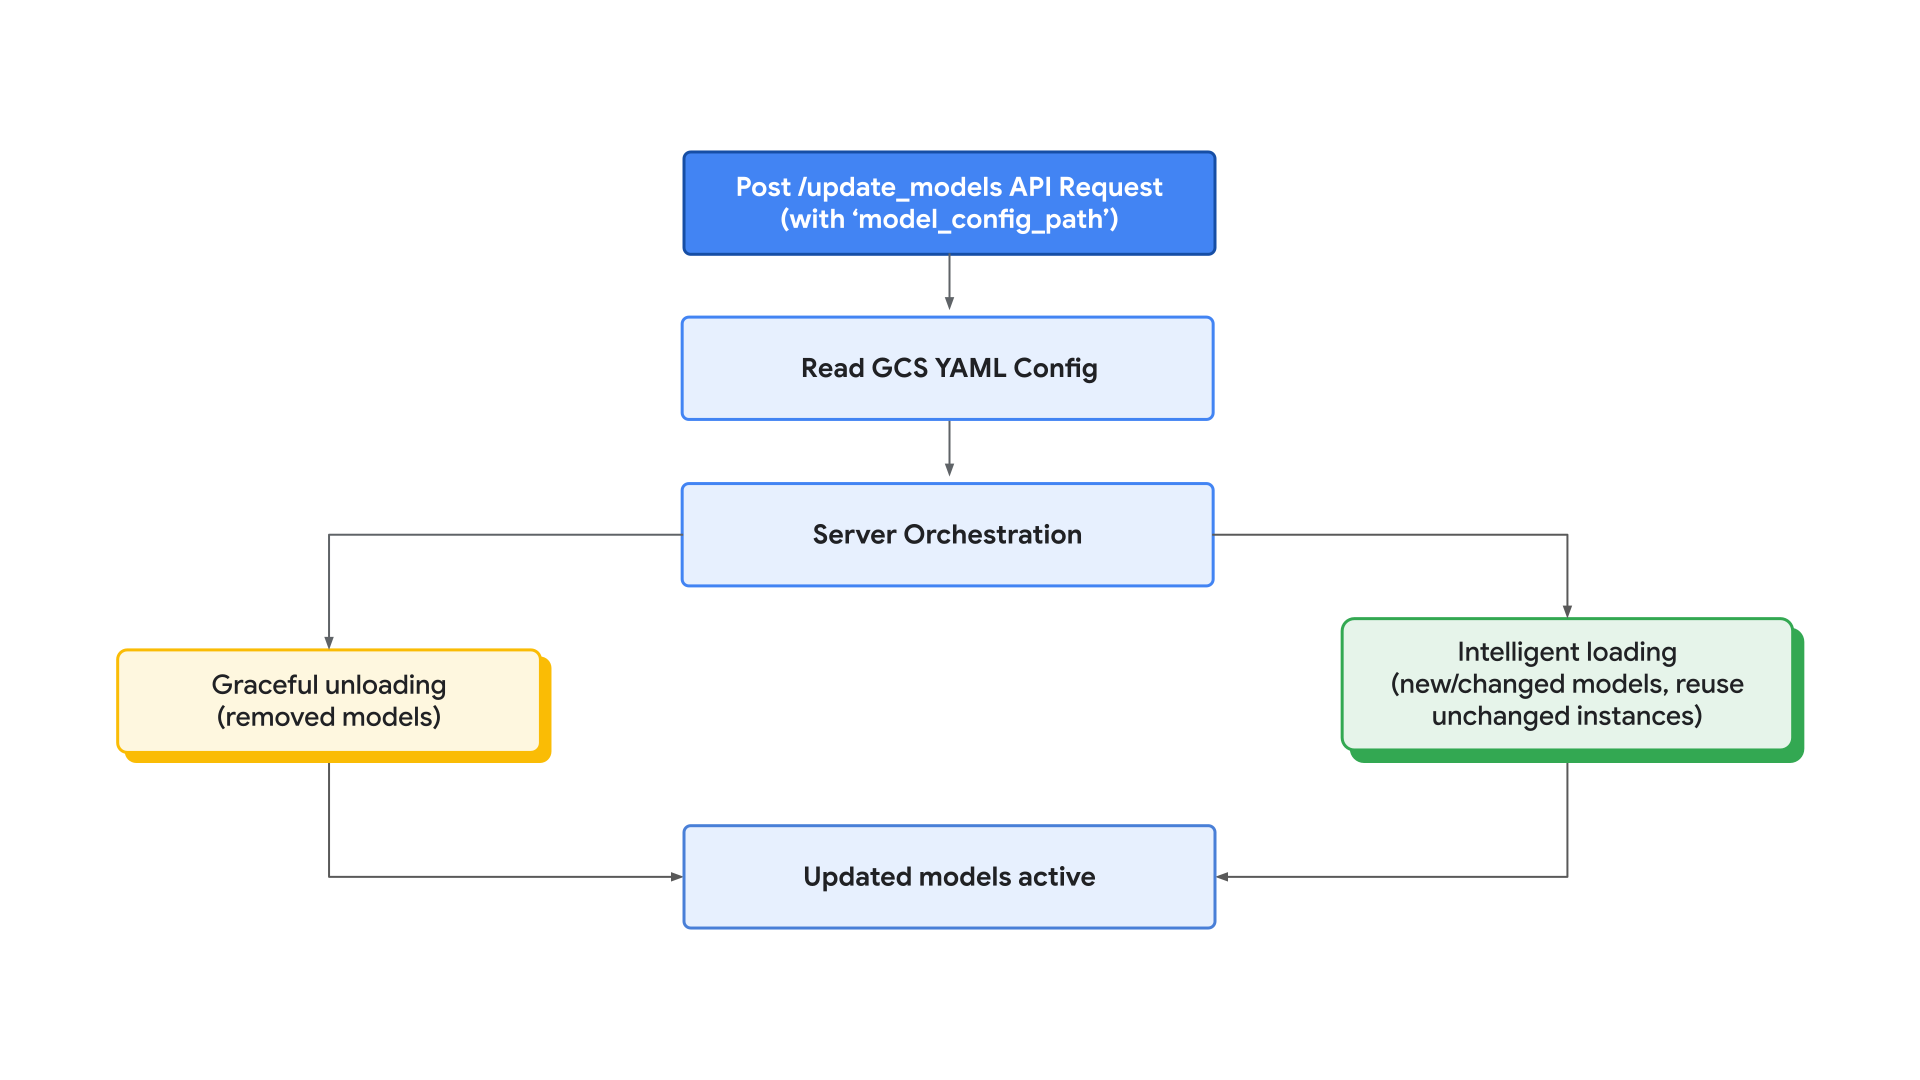
更新プロセスは、update_models エンドポイントへの POST リクエストによって開始されます。このリクエストには、Cloud Storage YAML ファイルを指す model_config_path が含まれています。このリクエストを受信すると、サーバーはダウンタイムを最小限に抑えるように最適化されたマルチステージ オーケストレーション シーケンスを実行します。
- グレースフル アンロード: システムは、新しい構成に存在しないモデルを特定し、最初にサブプロセスを終了して、GPU メモリとコンピューティング リソースを直ちに再利用します。
- インテリジェントな読み込みと再利用: サーバーは新しいモデル インスタンスを初期化します。重要なのは、モデルの並列処理設定(テンソル並列処理(TP)やパイプライン並列処理(PP)など)と割り当てられたメモリ パーティションが変更されない場合、オーケストレーターは既存の実行中のインスタンスを再利用することです。この最適化により、費用のかかる再初期化フェーズがバイパスされ、構成の変更中にアクティブなサービスが中断されないようになります。
レイテンシとパフォーマンスの分析
これらの更新戦略の実証分析により、動的ホット再読み込みは、大規模な LLM サービングに一般的に関連付けられている「コールド スタート」のペナルティを大幅に軽減することが明らかになりました。
まとめ
Vertex AI とのモデルの共存は、厳格でハードウェア依存のモノリシック デプロイから、柔軟で効率的なサービング アーキテクチャへの移行という根本的なパラダイム シフトを表しています。「VM ごとに 1 つのモデル」という標準から高密度コンピューティング プールモデルに進化することで、組織はパフォーマンス ベンチマークを維持(多くの場合、改善)しながら、総所有コスト(TCO)を大幅に削減できます。
Google のエンジニアリングの取り組みと広範なマルチモデル ベンチマーク調査により、このアーキテクチャの明確な本番環境ガイドラインが確立されました。
- 万能な構成はありません。特定のユースケース(モデル、ハードウェア、トラフィック)に最適なサービング レシピを見つけることと、そのためのツールを構築することを推奨します。
- レプリカによるスループットのスケーリング。
- ハードウェアの境界をなくし、メモリをより詳細なレベルで分割することで、リソースの使用率を改善します。
共存アーキテクチャを正常に実装するには、次の技術ワークフローをおすすめします。
- 明示的なパーティショニング:
--gpu-memory-partitions引数を使用して、個々のモデルにメモリリソースを割り当てます。 - 反復ベンチマーク: 提供されたベンチマーク ユーティリティを使用して、ワークロードの特定の「同時実行のクロスオーバー」ポイント(インスタンス数、TP、PP の「スイート スポット」構成)を特定します。
Google Cloud Model Garden での共存ホスティングの実装は、高密度の AI アプリケーションを構築するためのスケーラブルなブループリントを提供します。デベロッパーは、これらの機能を検討し、提供されたチュートリアル ノートブックを使用してベンチマークを再現し、特定のエンタープライズ要件に合わせてサービング構成を最適化することをおすすめします。
最後までお読みいただきありがとうございました
Vertex AI に関するご意見やご質問をお待ちしております。
謝辞
Google Cloud Vertex AI チームに心より感謝申し上げます。特に、このプロジェクト全体を通してリーダーシップと指導を発揮してくれた Bo Wu と Ting Yu、貴重な貢献をしてくれた Deborah He、Shawn Ma、Desmond Liu、Yang Pan、Surya K G Tangatur、Luis Rizo に感謝します。