

No cenário em evolução dos modelos de linguagem grandes (LLMs), o padrão de implantação de "um modelo por máquina" está se tornando um gargalo significativo para a eficiência de custos de veiculação de LLMs em empresas. Os LLMs geralmente exigem reservas de hardware substanciais, como nós de GPU 8x H100 completos, para gerenciar picos de carga. No entanto, durante as operações padrão, esses recursos caros costumam ficar subutilizados, levando a um alto custo total de propriedade (TCO).
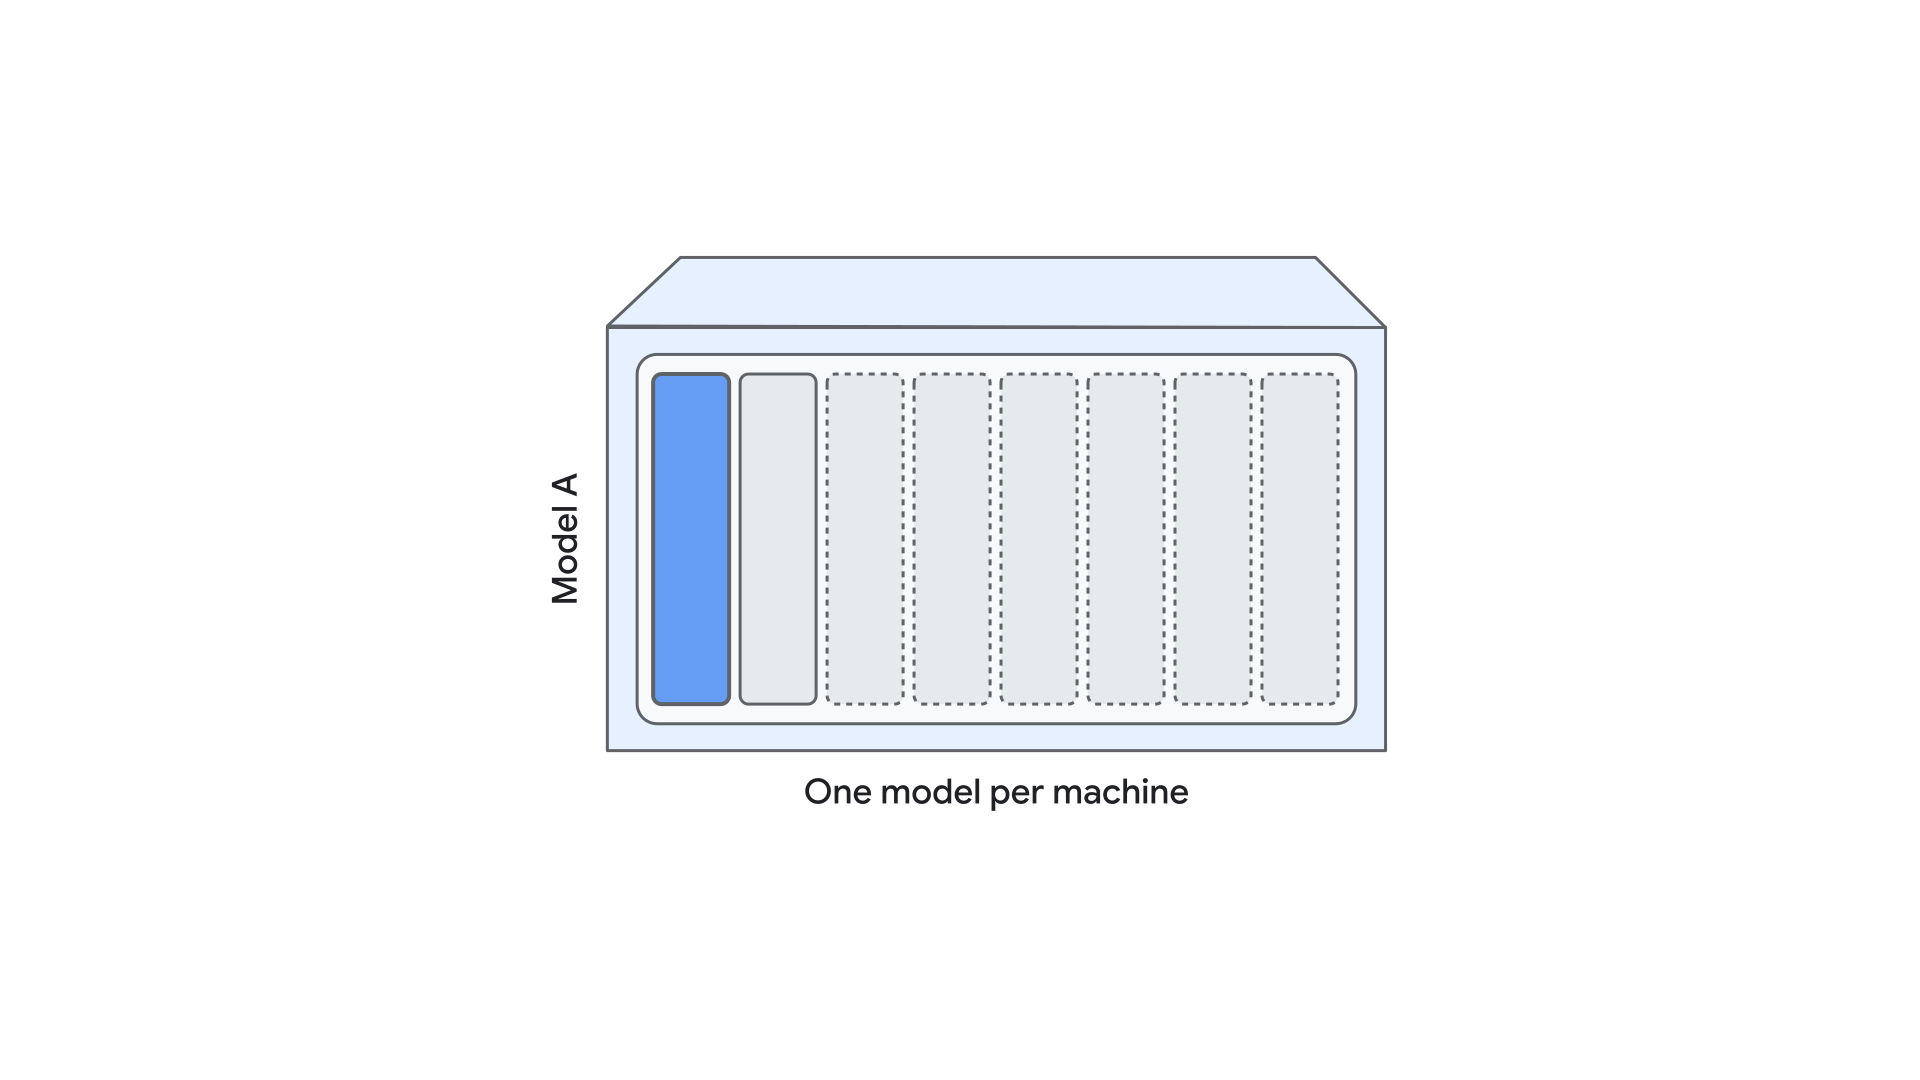
A co-hospedagem de modelos resolve essa lacuna de eficiência, permitindo que várias instâncias de modelo compartilhem os mesmos recursos de máquina virtual e GPU. Isso inclui modelos totalmente diferentes, como o Llama 3.3 e o Gemma 3. Ao utilizar o fatiamento de memória da sub-GPU e o particionamento inteligente de recursos, o Model Garden da Vertex AI transforma reservas de hardware estáticas em pools de computação flexíveis e de alta densidade.
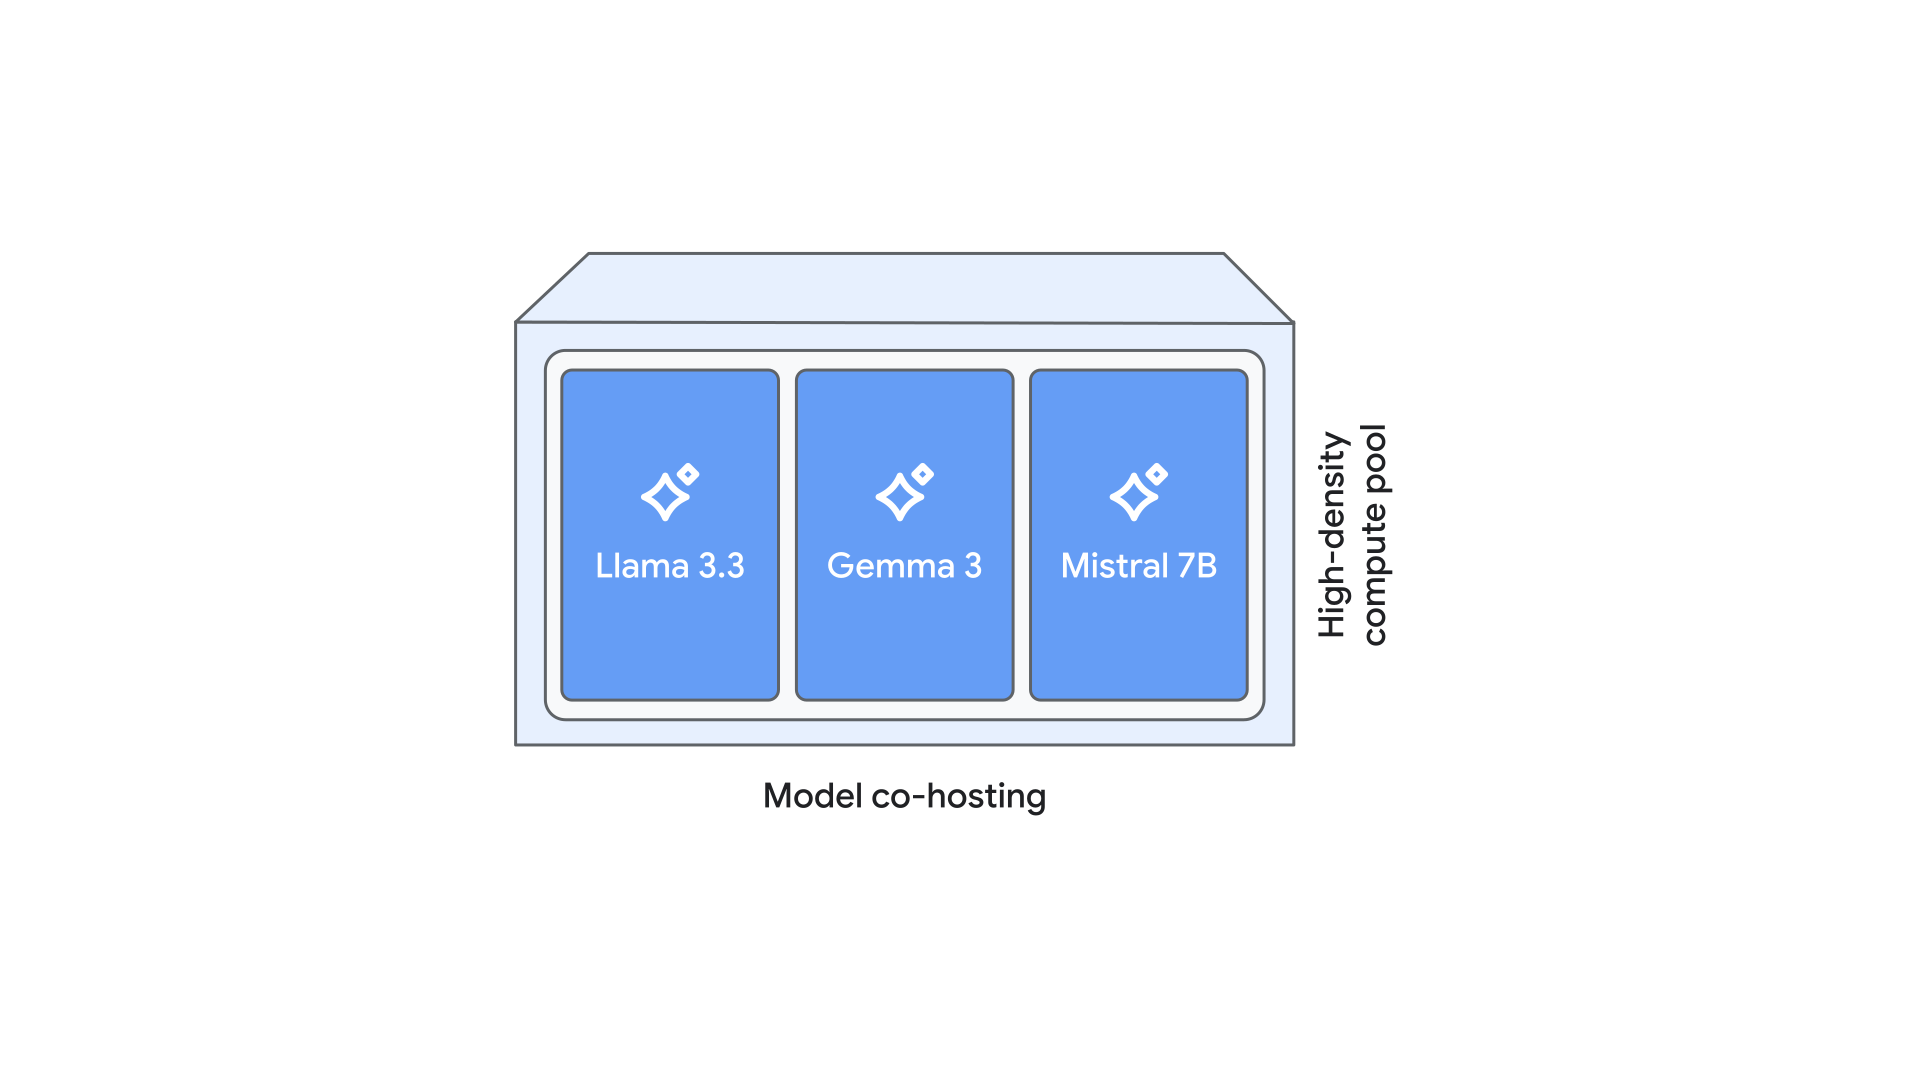
Este blog técnico detalha o processo de engenharia da Vertex AI para levar a co-hospedagem de modelos a um serviço de nuvem pronto para produção. Vamos compartilhar nossa metodologia para estratégias de implementação no nível do contêiner, identificando configurações de veiculação ideais e principais descobertas do nosso estudo de benchmark multimodelos, permitindo que você maximize a eficiência de custos de veiculação de LLMs.
Noções básicas sobre a co-hospedagem de modelos: conceito e arquitetura
A co-hospedagem de modelos é uma estratégia de veiculação de alta densidade que permite que várias instâncias de modelos de linguagem grandes (LLMs) ou arquiteturas de modelos diferentes compartilhem os mesmos recursos de hardware físico em uma única máquina virtual (VM). Ao contrário dos modelos de implantação tradicionais que dedicam uma VM ou GPU completa a um único modelo, a co-hospedagem utiliza o particionamento granular de recursos para maximizar o ROI de hardware e melhorar a utilização de memória e recursos computacionais.
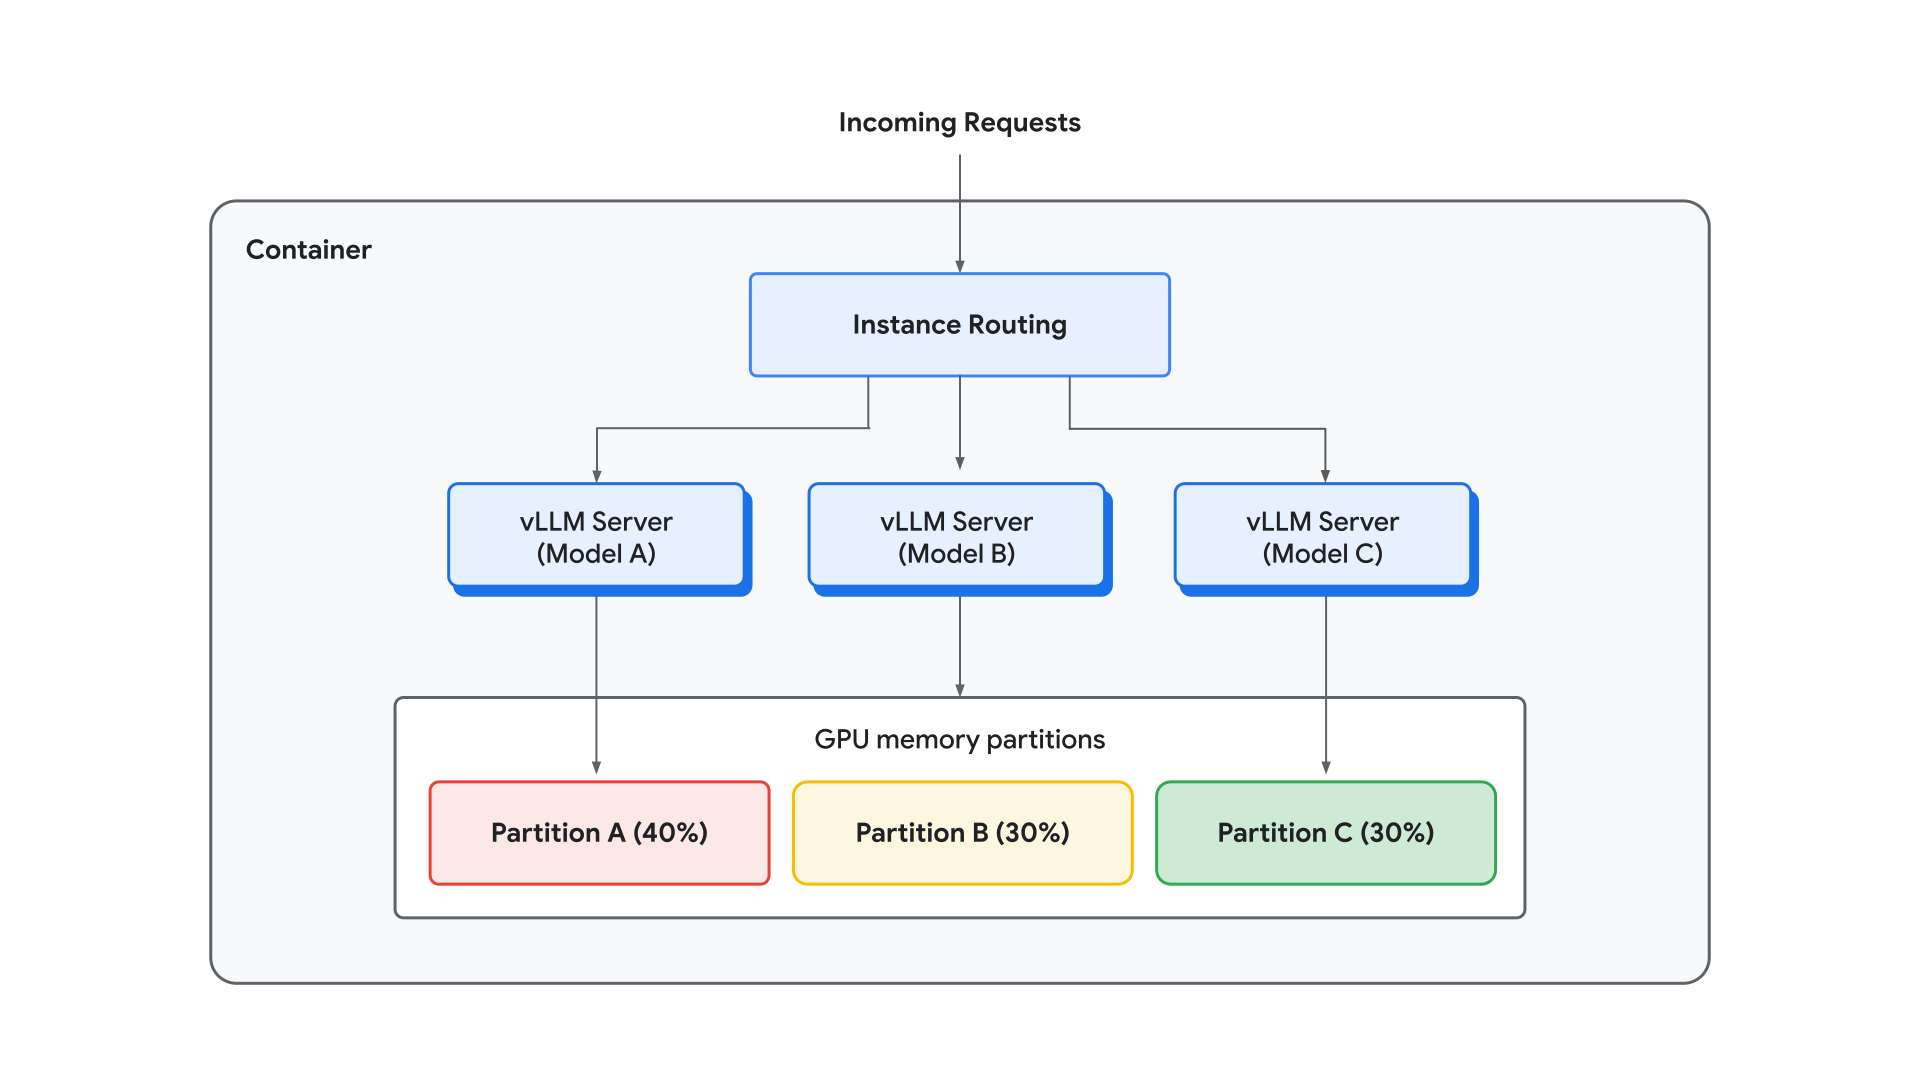
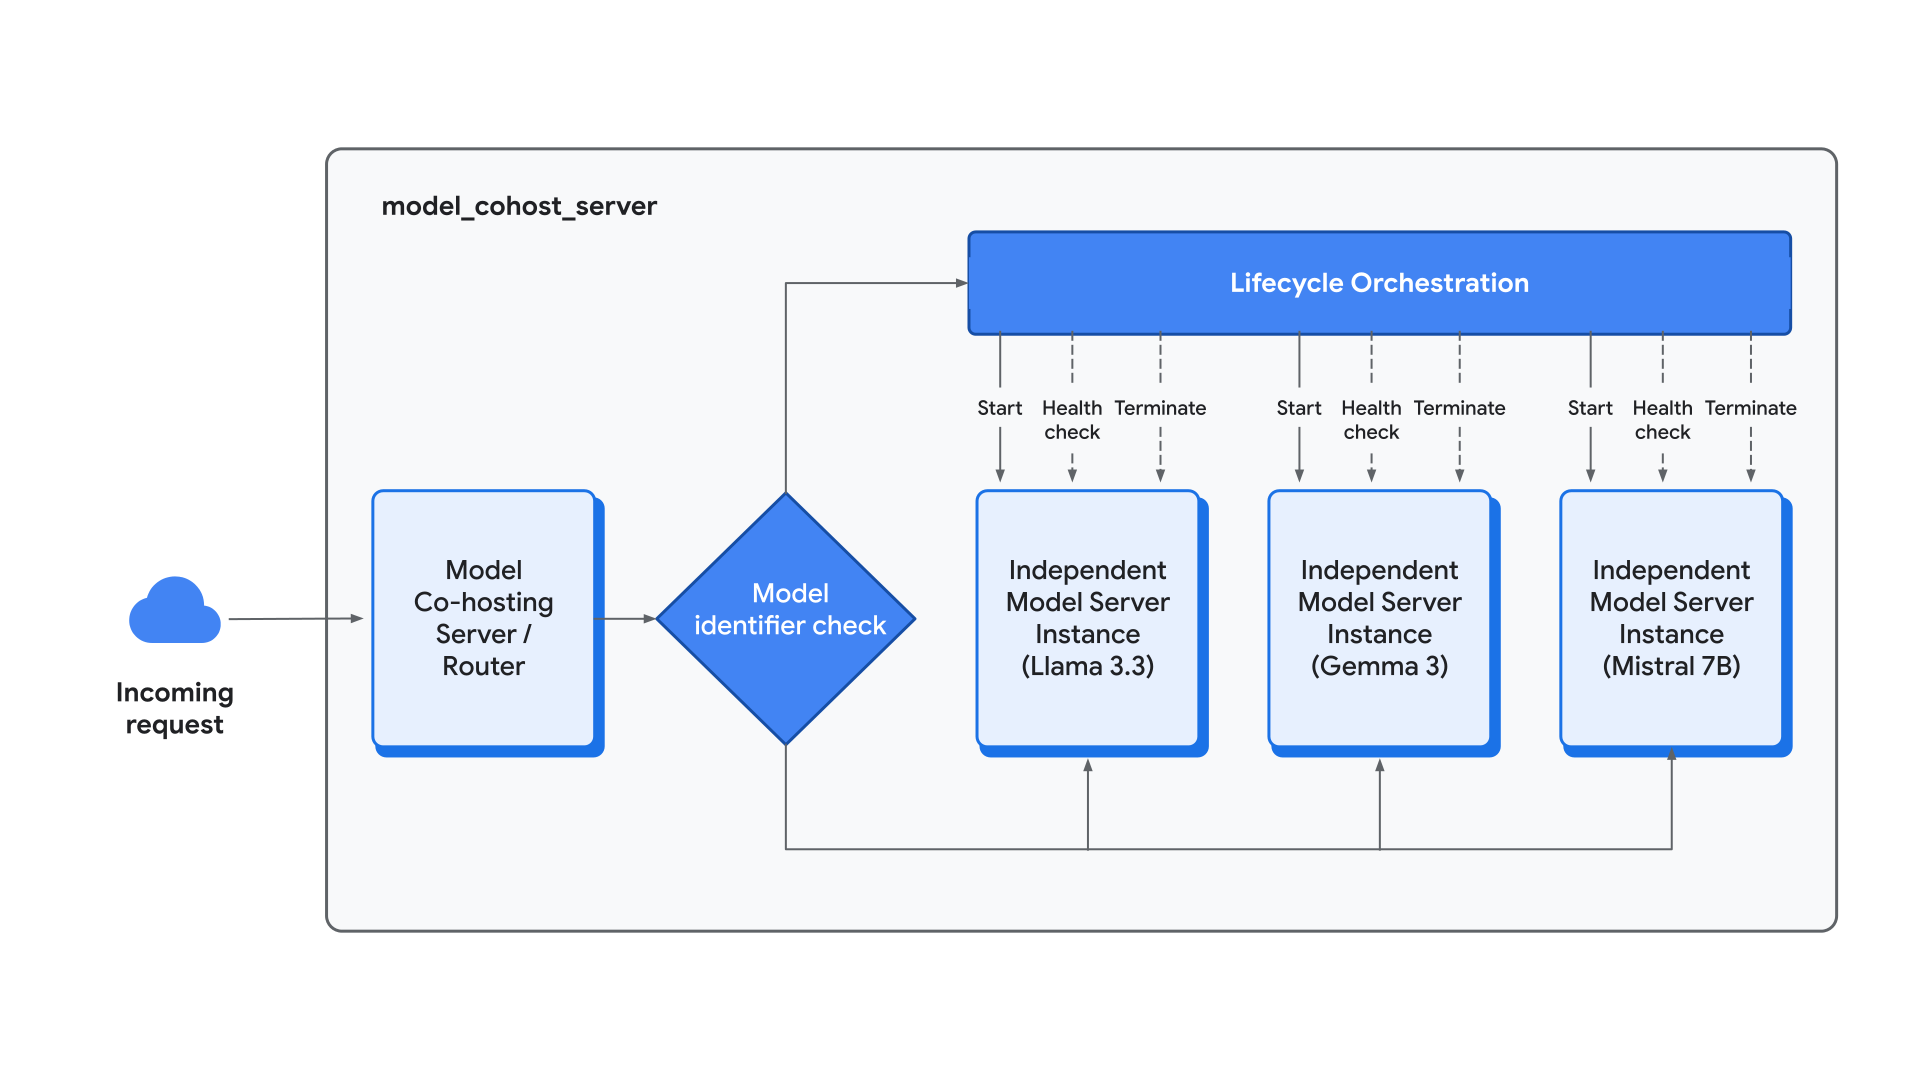
Nossa implementação se concentra em uma solução no nível do contêiner que permite a veiculação simultânea de vários modelos com configurações independentes. Essa arquitetura opera por vários mecanismos técnicos integrados, começando com a implantação de várias instâncias de servidor de modelos independentes em um único contêiner. Cada uma dessas instâncias serve como uma cópia completa e independente do servidor de modelos, o que permite o processamento simultâneo de solicitações na máquina virtual. Para gerenciar esse tráfego, implementamos uma camada de roteamento de instâncias no contêiner que distribui com eficiência as solicitações recebidas entre as instâncias ativas.
Esse design oferece paralelismo granular, permitindo que cada modelo co-hospedado utilize uma configuração de veiculação dedicada, com configurações exclusivas para paralelismo de tensor (TP), paralelismo de pipeline (PP) e o número específico de instâncias de modelo. Isso é complementado pelo fatiamento de recursos, em que partições específicas de memória da GPU são atribuídas a cada modelo, como uma partição de memória de 0,4 GPU por modelo, para garantir que cargas de trabalho diversas coexistam no mesmo acelerador sem privar umas às outras de recursos de memória críticos. Essa abordagem arquitetônica transforma uma reserva de hardware estática, como um nó de GPU 8x H100 completo, em um pool de computação flexível capaz de veicular um portfólio diversificado, que vai de modelos de raciocínio grandes a modelos de chat pequenos e de baixa latência.
Estudo de prototipagem e benchmark
Antes de desenvolver nosso orquestrador pronto para produção, realizamos um estudo de benchmark abrangente para validar a eficiência teórica da co-hospedagem de modelos. Essa fase tinha como objetivo testar completamente vLLM's paralelismo nativo e precisamente quantificar o grau de "interferência" quando os modelos compartilham o mesmo silício.
Investigação de paralelismo: como encontrar o "ponto de cruzamento"
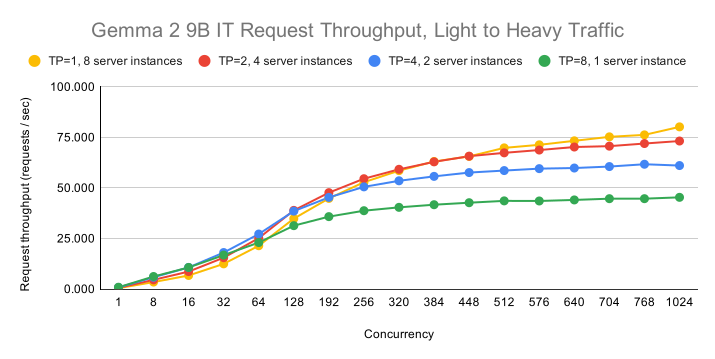
Nossa análise inicial se concentrou no paralelismo de tensor (TP) nativo do vLLM e na implementação de instâncias de modelo da Vertex como várias instâncias de servidor vLLM para determinar como essas estratégias interagem com cargas de usuário variáveis. Descobrimos que a configuração ideal depende muito da simultaneidade. Em simultaneidades mais baixas, um paralelismo de tensor alto (por exemplo, TP=8) oferece a menor latência para solicitações individuais, distribuindo camadas em todos os aceleradores disponíveis. No entanto, à medida que o tráfego simultâneo aumenta, o gargalo muda. Para maximizar a capacidade de processamento em condições de carga alta, a configuração ideal faz a transição de TP=8 para TP=4, TP=2 e, por fim, TP=1, enquanto aumenta simultaneamente o número de instâncias de modelo independentes. Essa transição define um "ponto de cruzamento" em que os benefícios da latência reduzida de comunicação entre GPUs em configurações de TP baixo superam a velocidade bruta da execução de TP alto. A seguir, você tem um gráfico de ponto de cruzamento com o modelo de TI Gemma 2 9B.
Escalonamento ideal: modelo único, várias réplicas
Para estabelecer uma linha de base rigorosa para escalonabilidade, fizemos um benchmark de várias instâncias do mesmo modelo em um único nó. Em condições de tráfego saturado (2.048 solicitações simultâneas por GPU), o lançamento de oito instâncias de servidor vLLM independentes em um nó 8xH100 gerou uma melhoria de capacidade de processamento de aproximadamente 7,8 vezes com regressão de latência praticamente zero em comparação com uma linha de base de GPU única.
Comparação de infraestrutura: co-agendamento de contêineres x pods
Além disso, avaliamos nossa orquestração no nível do contêiner em relação a soluções nativas no nível da infraestrutura, especificamente o co-agendamento de pods. Embora ambas as soluções tenham oferecido desempenho comparável para veiculação de várias réplicas, selecionamos a abordagem no nível do contêiner para nosso produto viável mínimo (MVP). Essa decisão foi motivada pela flexibilidade superior que a solução no nível do contêiner oferece para co-hospedagem heterogênea, permitindo que os desenvolvedores disponibilizem arquiteturas de modelos diferentes lado a lado com partições de memória granulares e definidas por software que não são restritas pelas restrições de agendamento do Kubernetes. Além disso, a orquestração no nível do contêiner permite iterações muito mais rápidas e é mais fácil de personalizar e inovar.
O teste de interferência: co-hospedagem de modelos diferentes
O marco final da prototipagem foi o "Teste de interferência", em que co-hospedamos o Gemma-3n-E2B-it e o Llama-3.1-8B-Instruct na mesma VM. Com cada modelo atribuído a uma partição de memória de GPU de 0,4, o desempenho de veiculação permaneceu quase idêntico aos benchmarks de modelo único. Por exemplo, o Gemma-3n atingiu 30,21 solicitações em um ambiente co-hospedado em comparação com 30,96 solicitações isoladamente. Esses resultados confirmam que há pouca ou nenhuma interferência de computação entre modelos co-hospedados, mesmo em tráfego intenso, desde que os recursos de memória sejam particionados adequadamente para evitar a falta de memória do KV cache.
Implementação de contêineres de MVP
A transição de um benchmark validado para um sistema pronto para produção exigiu a engenharia de um orquestrador robusto e em contêineres. Essa fase de desenvolvimento se concentrou na criação de uma camada de software de alto nível capaz de gerenciar as complexidades de vários ciclos de vida de modelos, garantindo o isolamento determinístico de recursos.
Design do servidor de co-hospedagem de modelos
O núcleo da nossa implementação é o model_cohost_server, um ponto de entrada personalizado projetado para atuar como um orquestrador mestre no contêiner. Desviando do modelo padrão de processo único, esse servidor implementa o gerenciamento de subprocessos, facilitando a execução simultânea de várias instâncias de servidor de modelos independentes, como o vLLM, como subprocessos isolados. Para gerenciar o tráfego recebido, o orquestrador emprega o roteamento de solicitações de alto nível, identificando solicitações pelos identificadores de modelo exclusivos usando argumentos como --served-model-name e direcionando-as para a instância de servidor interno correspondente. Além do roteamento, o servidor oferece orquestração
abrangente do ciclo de vida, gerenciando a inicialização, o monitoramento de integridade e o encerramento
de todas as instâncias co-hospedadas. Esse gerenciamento centralizado fornece um endpoint único e unificado para tráfego externo, mantendo os limites operacionais distintos de cada subprocesso.
Particionamento de recursos de GPU: fatiamento determinístico
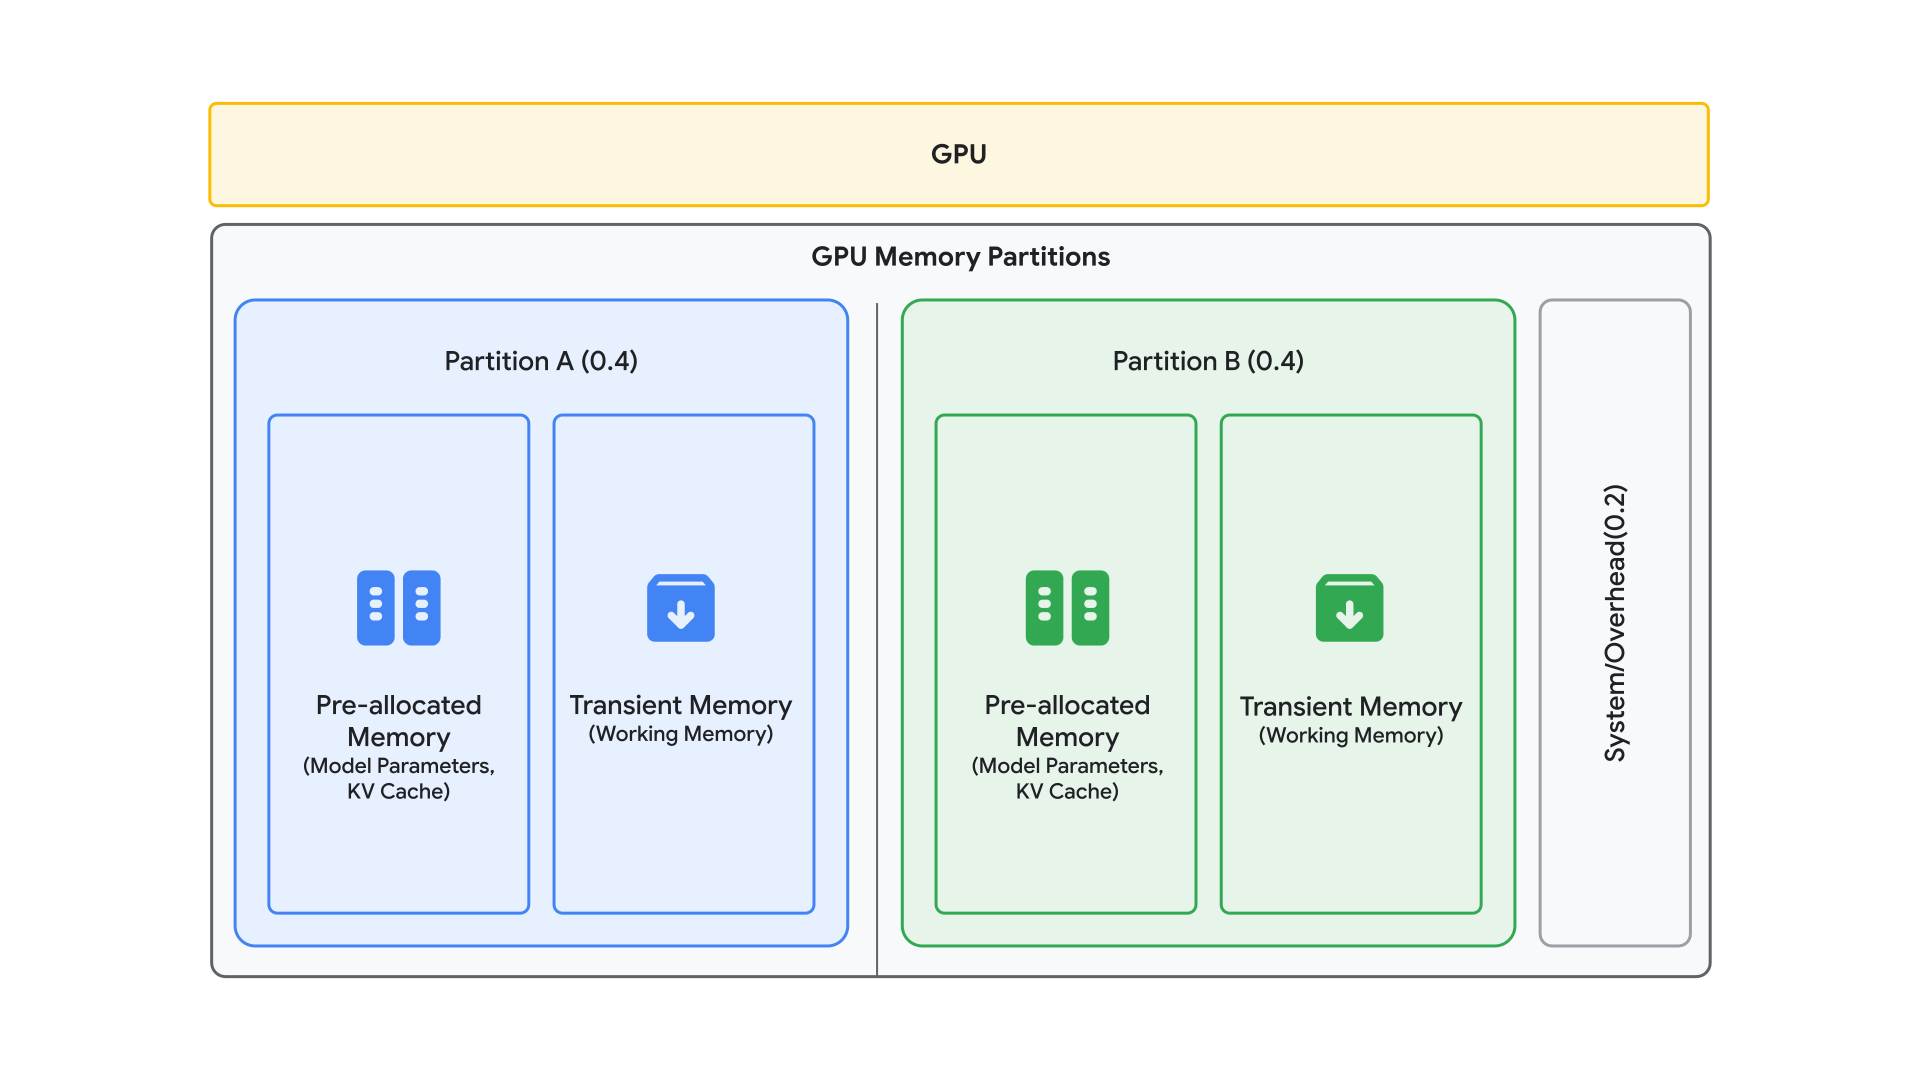
Para eliminar o risco de a carga de trabalho de um único modelo acionar um erro de falta de memória (OOM) em todo o ambiente co-hospedado, implementamos um mecanismo de fatiamento de recursos rigoroso. Isso é operacionalizado pelo argumento gpu-memory-partition, que permite que os desenvolvedores definam proporções de memória explícitas (por exemplo, 0,4, 0,4) para reservar uma porcentagem fixa da memória total da GPU de um nó para cada instância de modelo individual.
Para orientar essa alocação, adotamos um "modelo de memória pré-alocada x temporária", que distingue entre requisitos de recursos estáticos e dinâmicos.
A memória "pré-alocada" consiste na memória usada para os pesos do modelo e o KVCache. A quantidade de memória usada para os pesos do modelo depende da contagem de parâmetros e da precisão do modelo. Por exemplo, um modelo de parâmetro de 8B em BF16 requer aproximadamente 16 GB de armazenamento estático. A quantidade de memória usada para o KVCache depende das dimensões do modelo, da precisão, do tamanho do contexto e do número de sequências. A memória"temporária" consiste em cálculos intermediários e
memória de trabalho de inferência. O argumento gpu-memory-partition considera a memória "pré-alocada". Recomendamos deixar espaço de buffer para memória "temporária" definindo a soma de gpu-memory-partitions como menor que 1,0.
Produção
A fase de produção da co-hospedagem de modelos com a Vertex AI foi dedicada a estabelecer um ambiente pronto para produção e sem problemas para configurações de veiculação de várias réplicas de modelo único e multimodelos. Essa transição traduziu com eficácia as descobertas de benchmark empíricas em fluxos de trabalho de implantação simplificados e estruturas de suporte de infraestrutura profundamente integradas.
Fluxos de trabalho de implantação simplificados
Para reduzir a barreira de entrada para veiculação de alta densidade, padronizamos as configurações de co-hospedagem usando argumentos de contêiner personalizados que se integram nativamente às APIs da Vertex AI. Para máquinas virtuais de formato completo, como um nó 8x H100, desenvolvemos um utilitário de benchmark para personalizar as melhores receitas para seus casos de uso específicos. Esses utilitários de benchmark permitem encontrar a configuração que equilibra automaticamente o paralelismo de tensor (TP), paralelismo de pipeline (PP), e o número de instâncias de modelo com base na contagem de parâmetros e na precisão específicas do modelo. Isso é complementado pelo suporte robusto da API Deployment , permitindo que os desenvolvedores especifiquem esses parâmetros granulares, incluindo partições exatas de memória da GPU, diretamente em uma solicitação deployModel padrão e implantem modelos.
Veiculação multimodelos dinâmica
Um avanço significativo na nossa jornada técnica foi a transição de configurações estáticas para uma arquitetura de veiculação dinâmica. Essa capacidade é fundamental para ambientes de produção caracterizados por padrões de tráfego que mudam rapidamente, já que a capacidade de carregar ou descarregar modelos sem uma reinicialização completa do contêiner é essencial para manter a agilidade e a alta disponibilidade da infraestrutura.
A API de atualização dinâmica (update_models)
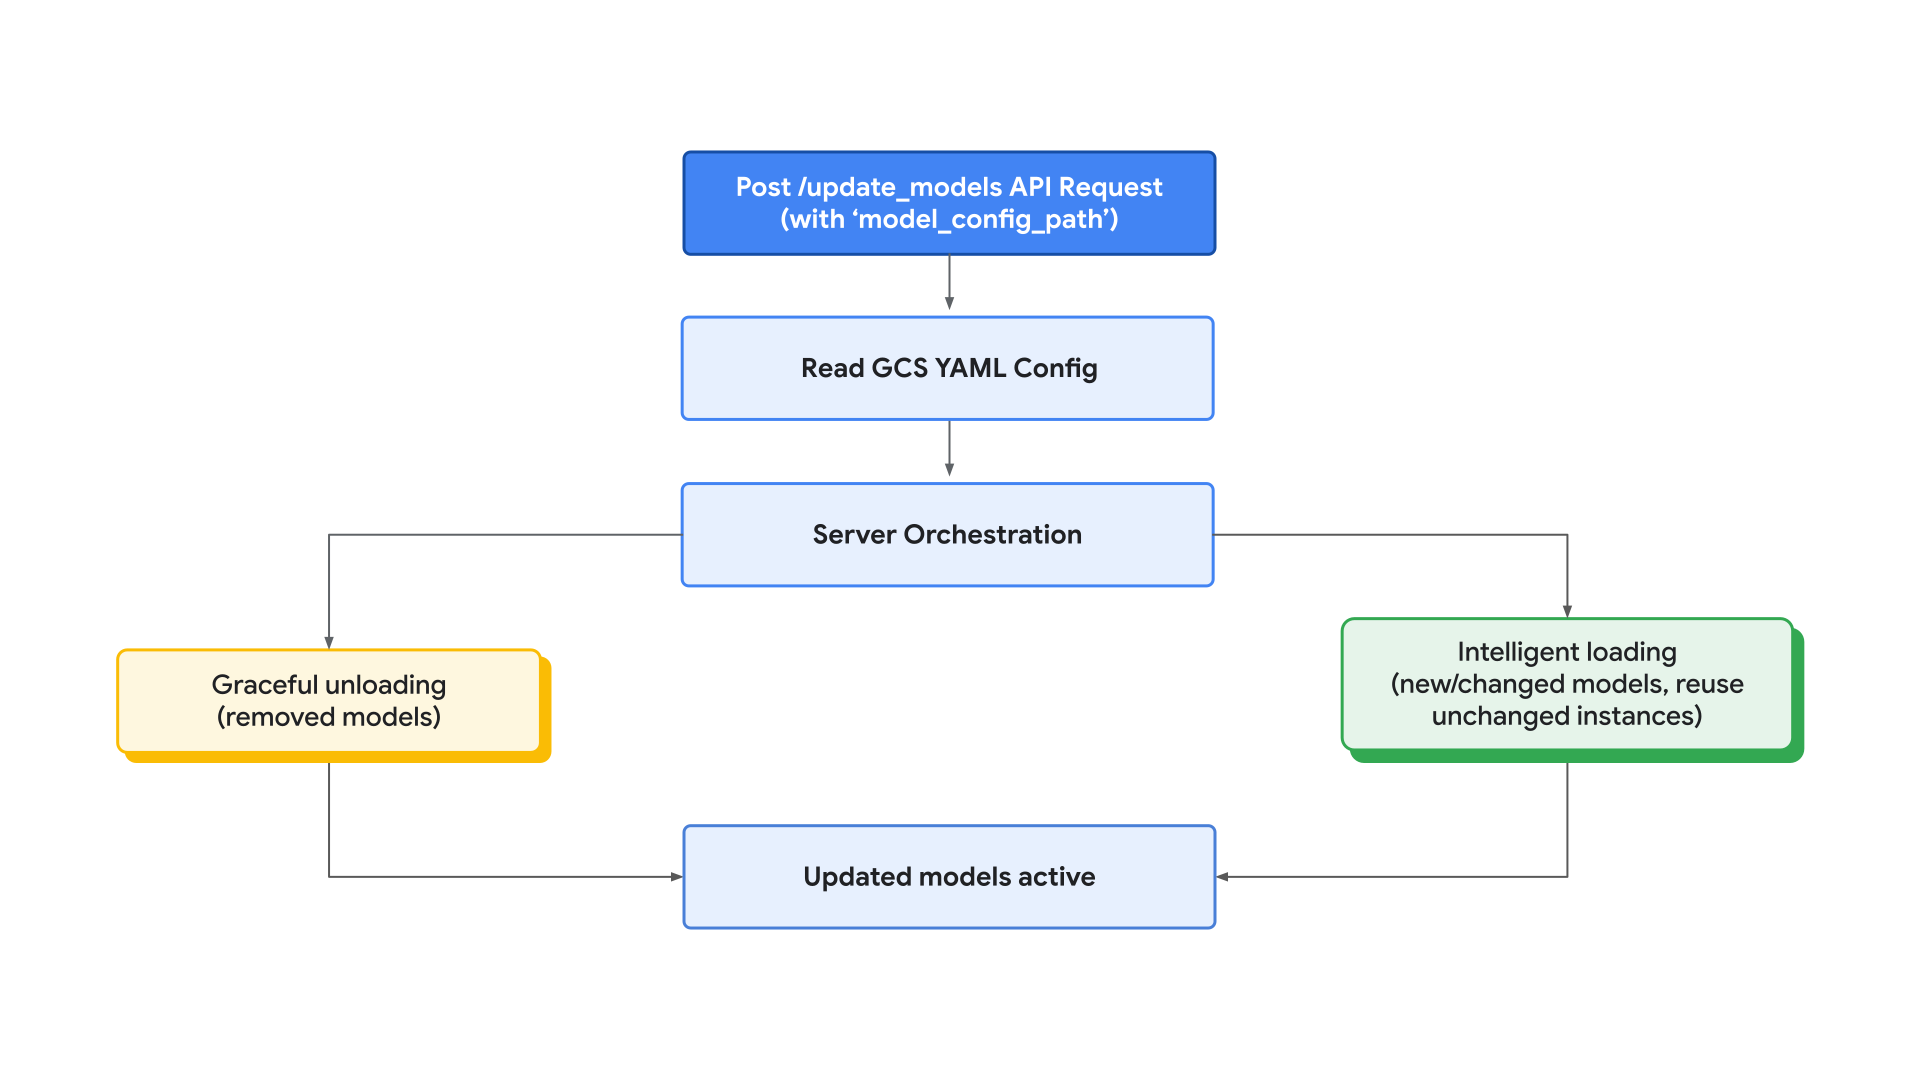
Para resolver as limitações inerentes das implantações imutáveis, implementamos uma API de atualização de modelo especializada no contêiner de co-hospedagem de modelos vLLM do Model Garden da Vertex. Essa API facilita o recarregamento dinâmico, permitindo que o servidor ajuste o portfólio de modelos hospedados em tempo real com base em um arquivo de configuração centralizado armazenado em um bucket do Cloud Storage.
O processo de atualização é iniciado por uma solicitação POST para o endpoint update_models, que inclui o model_config_path que aponta para o arquivo YAML do Cloud Storage.
Ao receber essa solicitação, o servidor executa uma sequência de orquestração de vários estágios otimizada para o tempo de inatividade mínimo:
- Descarregamento normal: o sistema identifica modelos ausentes da nova configuração e encerra os subprocessos primeiro, recuperando imediatamente a memória da GPU e os recursos de computação.
- Carregamento e reutilização inteligentes: o servidor inicializa novas instâncias de modelo. É importante ressaltar que, se as configurações de paralelismo de um modelo, como paralelismo de tensor (TP) ou paralelismo de pipeline (PP), e a partição de memória alocada permanecerem inalteradas, o orquestrador reutilizará a instância em execução. Essa otimização ignora a fase de reinicialização dispendiosa, garantindo que os serviços ativos permaneçam ininterruptos durante as mudanças de configuração.
Análise de latência e desempenho
A análise empírica dessas estratégias de atualização revela que o recarregamento dinâmico dinâmico atenua substancialmente a penalidade de "inicialização a frio" comumente associada à veiculação de LLMs em grande escala.
Conclusão
A co-hospedagem de modelos com a Vertex AI representa uma mudança de paradigma fundamental, fazendo a transição de implantações monolíticas rígidas e pesadas de hardware para uma arquitetura de veiculação fluida e eficiente. Ao evoluir além do padrão "um modelo por VM" para um modelo de pool de computação de alta densidade, as organizações podem reduzir significativamente o custo total de propriedade (TCO) e manter, e muitas vezes melhorar, os benchmarks de desempenho.
Nossa jornada de engenharia e estudos de benchmark multimodelos abrangentes estabeleceram um conjunto definitivo de diretrizes de produção para essa arquitetura:
- Não há uma configuração única para todos. Defendemos a busca da melhor receita de veiculação para um caso de uso específico (modelo, hardware, tráfego) e criamos ferramentas para isso.
- Escalonamento da capacidade de processamento com réplicas.
- Melhore a utilização de recursos quebrando os limites de hardware e dividindo a memória em um nível mais granular.
Para implementar uma arquitetura co-hospedada, recomendamos o seguinte fluxo de trabalho técnico:
- Particionamento explícito: use o argumento
--gpu-memory-partitionspara alocar recursos de memória para modelos individuais. - Benchmark iterativo: use o utilitário de benchmark fornecido para identificar o ponto de "cruzamento de simultaneidade" específico para sua carga de trabalho, a configuração ideal de número de instâncias, TP e PP.
A implementação da co-hospedagem no Model Garden do Google Cloud oferece um plano escalonável para a criação de aplicativos de IA de alta densidade. Incentivamos os desenvolvedores a explorar esses recursos e reproduzir nossos benchmarks usando o notebook de tutorial fornecido para otimizar as configurações de veiculação para os requisitos específicos da empresa.
Agradecemos a leitura
Dúvidas e feedback sobre a Vertex AI são bem-vindos.
Agradecimentos
Gostaríamos de expressar nossa sincera gratidão à equipe da Vertex AI do Google Cloud. Agradecemos especialmente a Bo Wu e Ting Yu pela liderança e orientação, bem como a Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur e Luis Rizo pelas contribuições inestimáveis ao longo deste projeto.