

在不断发展变化的大语言模型 (LLM) 领域,“每台机器一个模型”的部署模式正成为企业LLM 服务成本效益方面的一大瓶颈。LLM 通常需要预留大量硬件资源,例如完整的 8x H100 GPU 节点,才能管理峰值负载。 不过,在标准运营期间,这些昂贵的资源往往未得到充分利用,从而导致总拥有成本 (TCO) 较高。
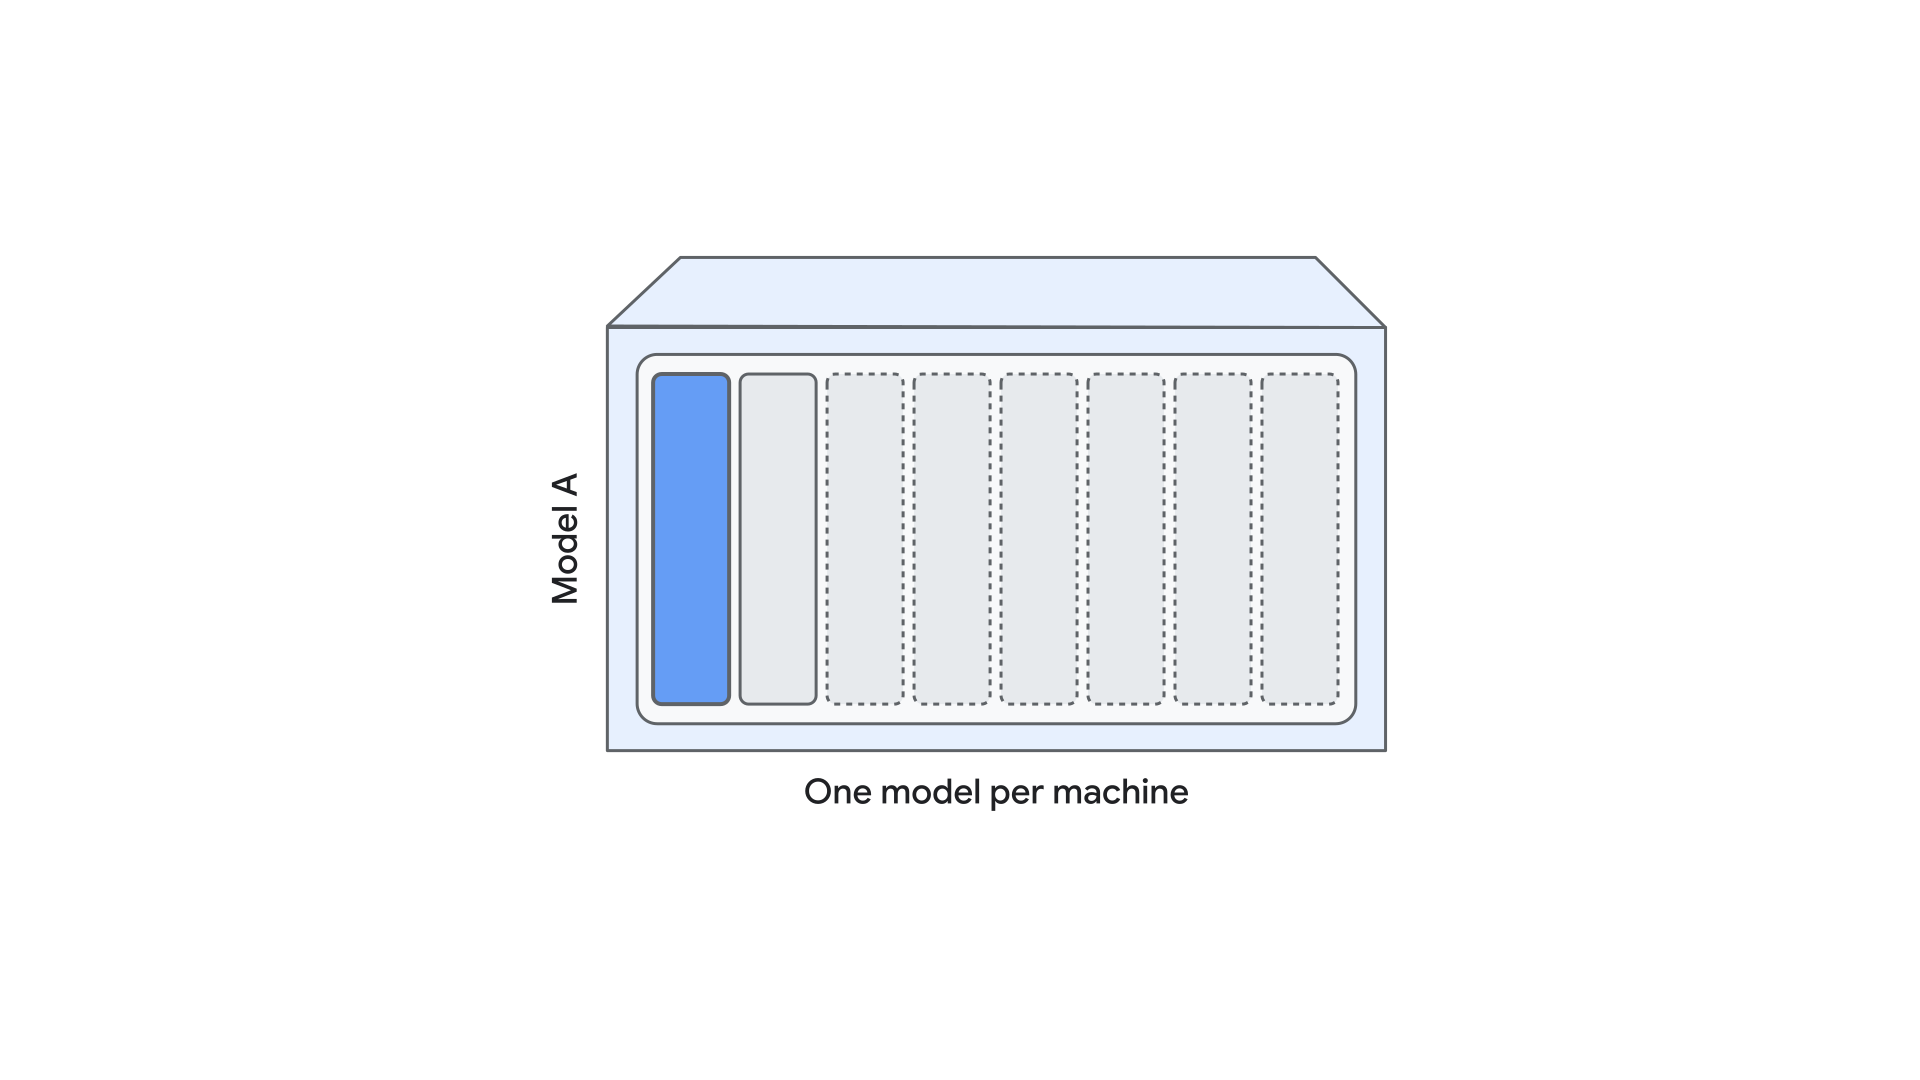
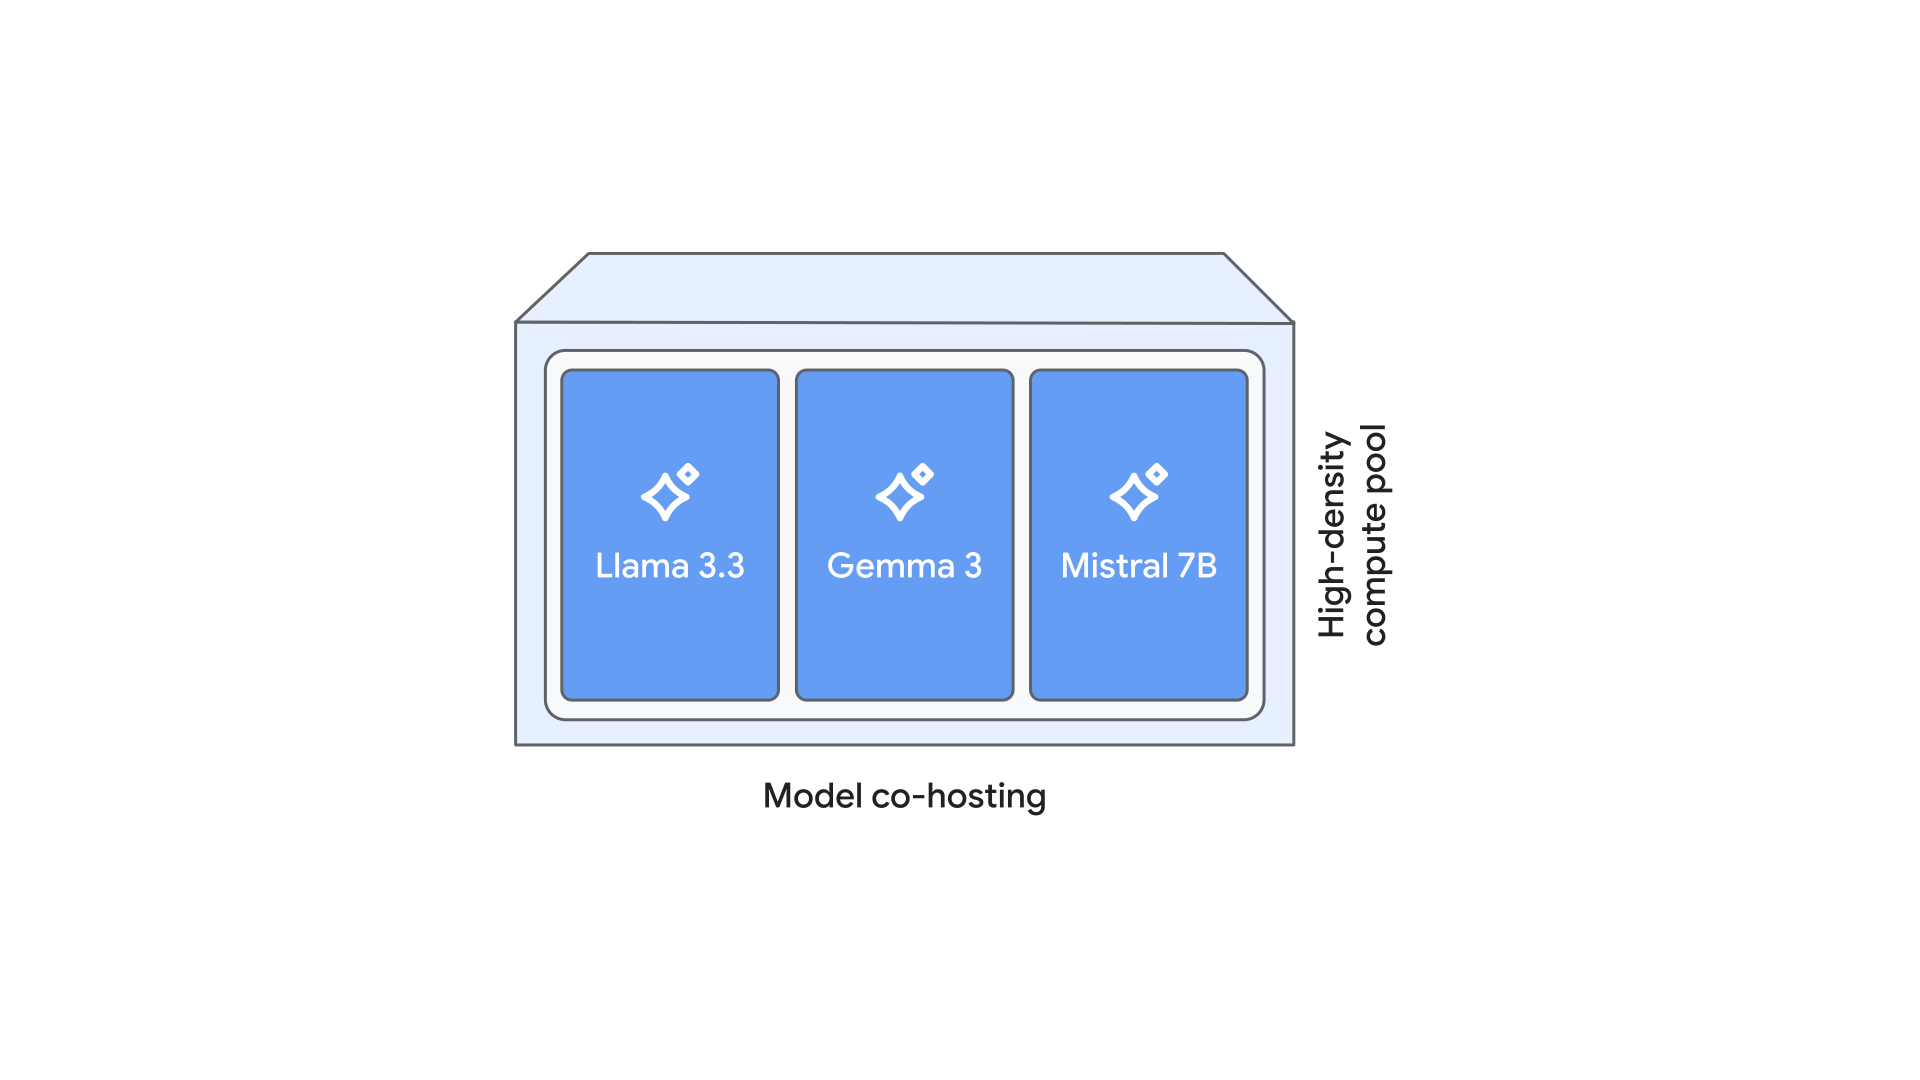
模型共同托管功能可让多个模型实例共享同一虚拟机和 GPU 资源,从而弥合这一效率差距。这包括完全不同的模型,例如 Llama 3.3 和 Gemma 3。通过利用子 GPU 内存切分和智能资源分区,Vertex AI Model Garden 可将静态硬件预留转换为灵活的高密度计算池。
这篇技术博客详细介绍了 Vertex AI 工程团队将模型共同托管功能引入可用于生产用途的云服务的流程。我们将分享我们的方法,包括容器级实现策略、确定最佳服务配置,以及我们广泛开展的多模型基准研究的主要发现,帮助您最大限度地提高 LLM 服务成本效益。
了解模型共同托管:概念和架构
模型共同托管是一种高密度服务策略,可让多个大型语言模型 (LLM) 实例或不同的模型架构在单个虚拟机 (VM) 内共享相同的物理硬件资源。与将整个虚拟机或 GPU 专用于单个模型的传统部署模型不同,共同托管利用精细的资源分区来最大限度地提高硬件投资回报率,并提高内存和计算资源的利用率。
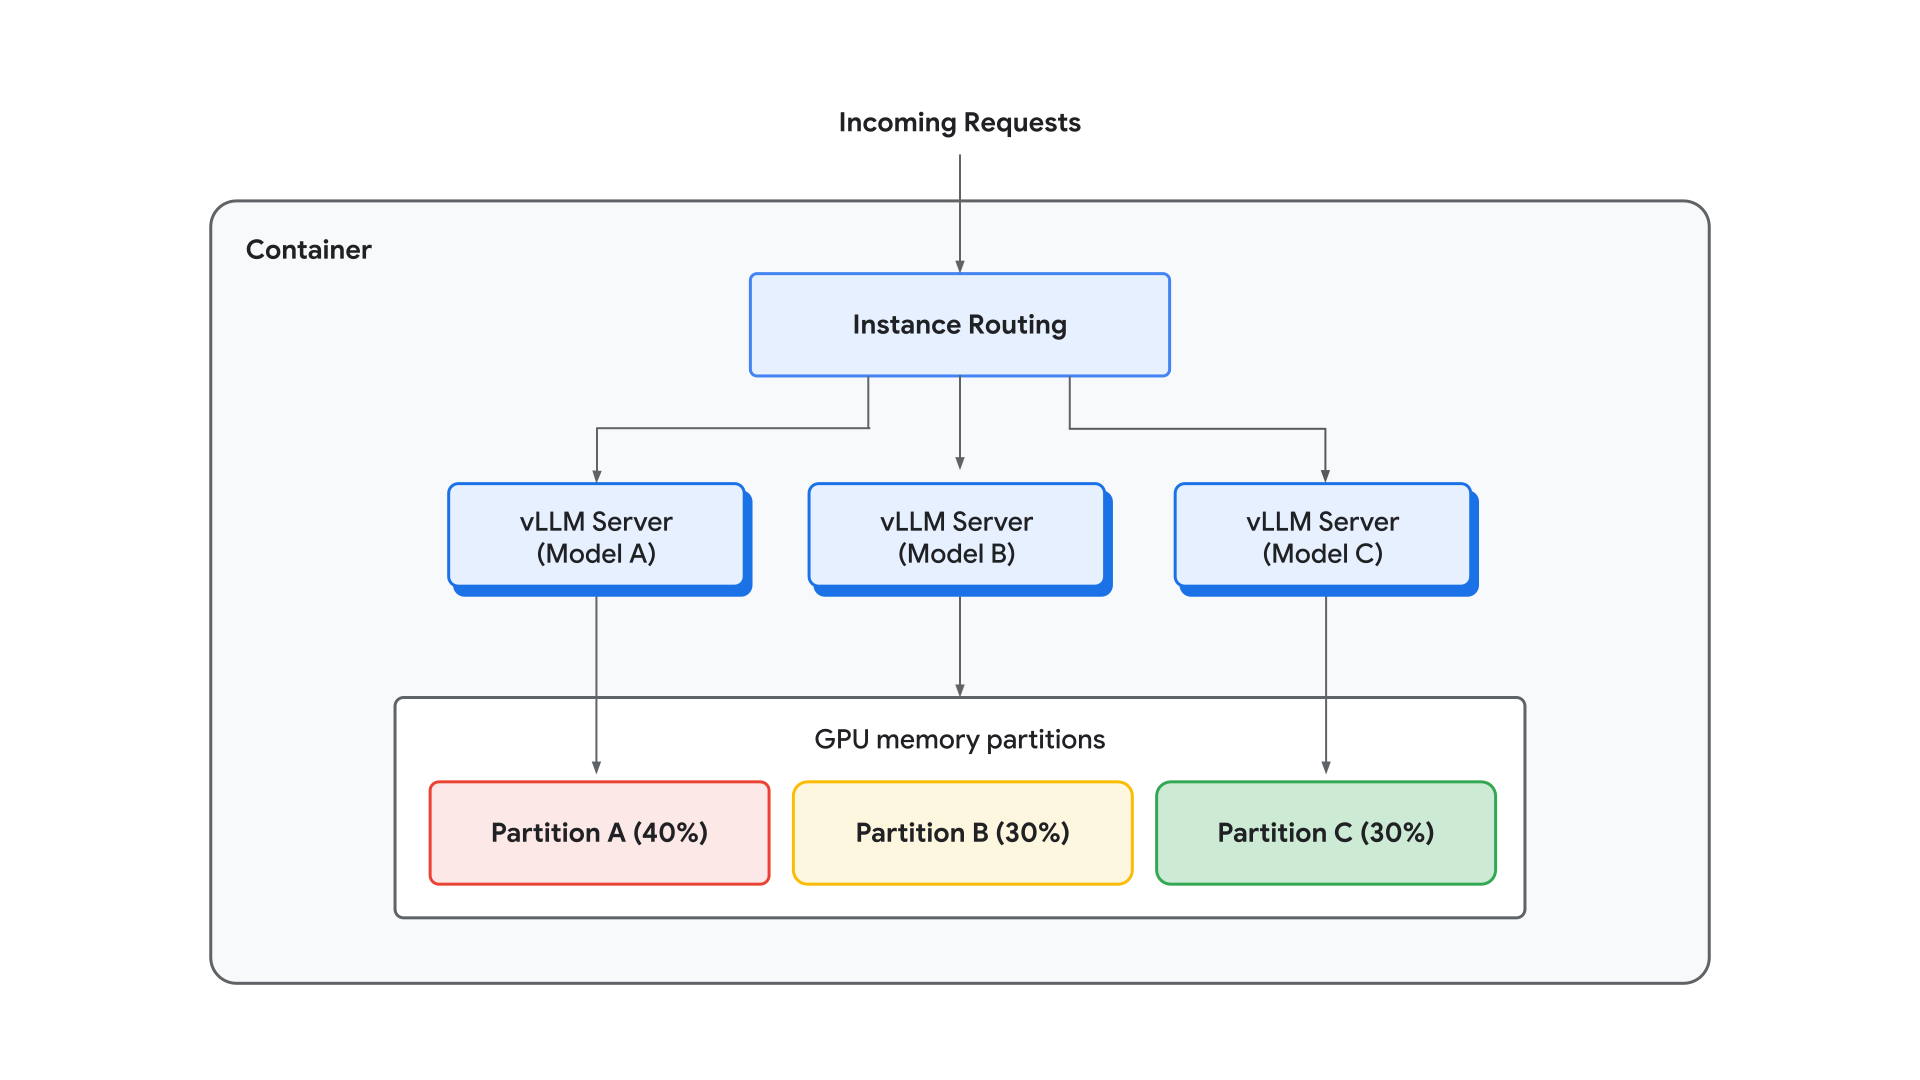
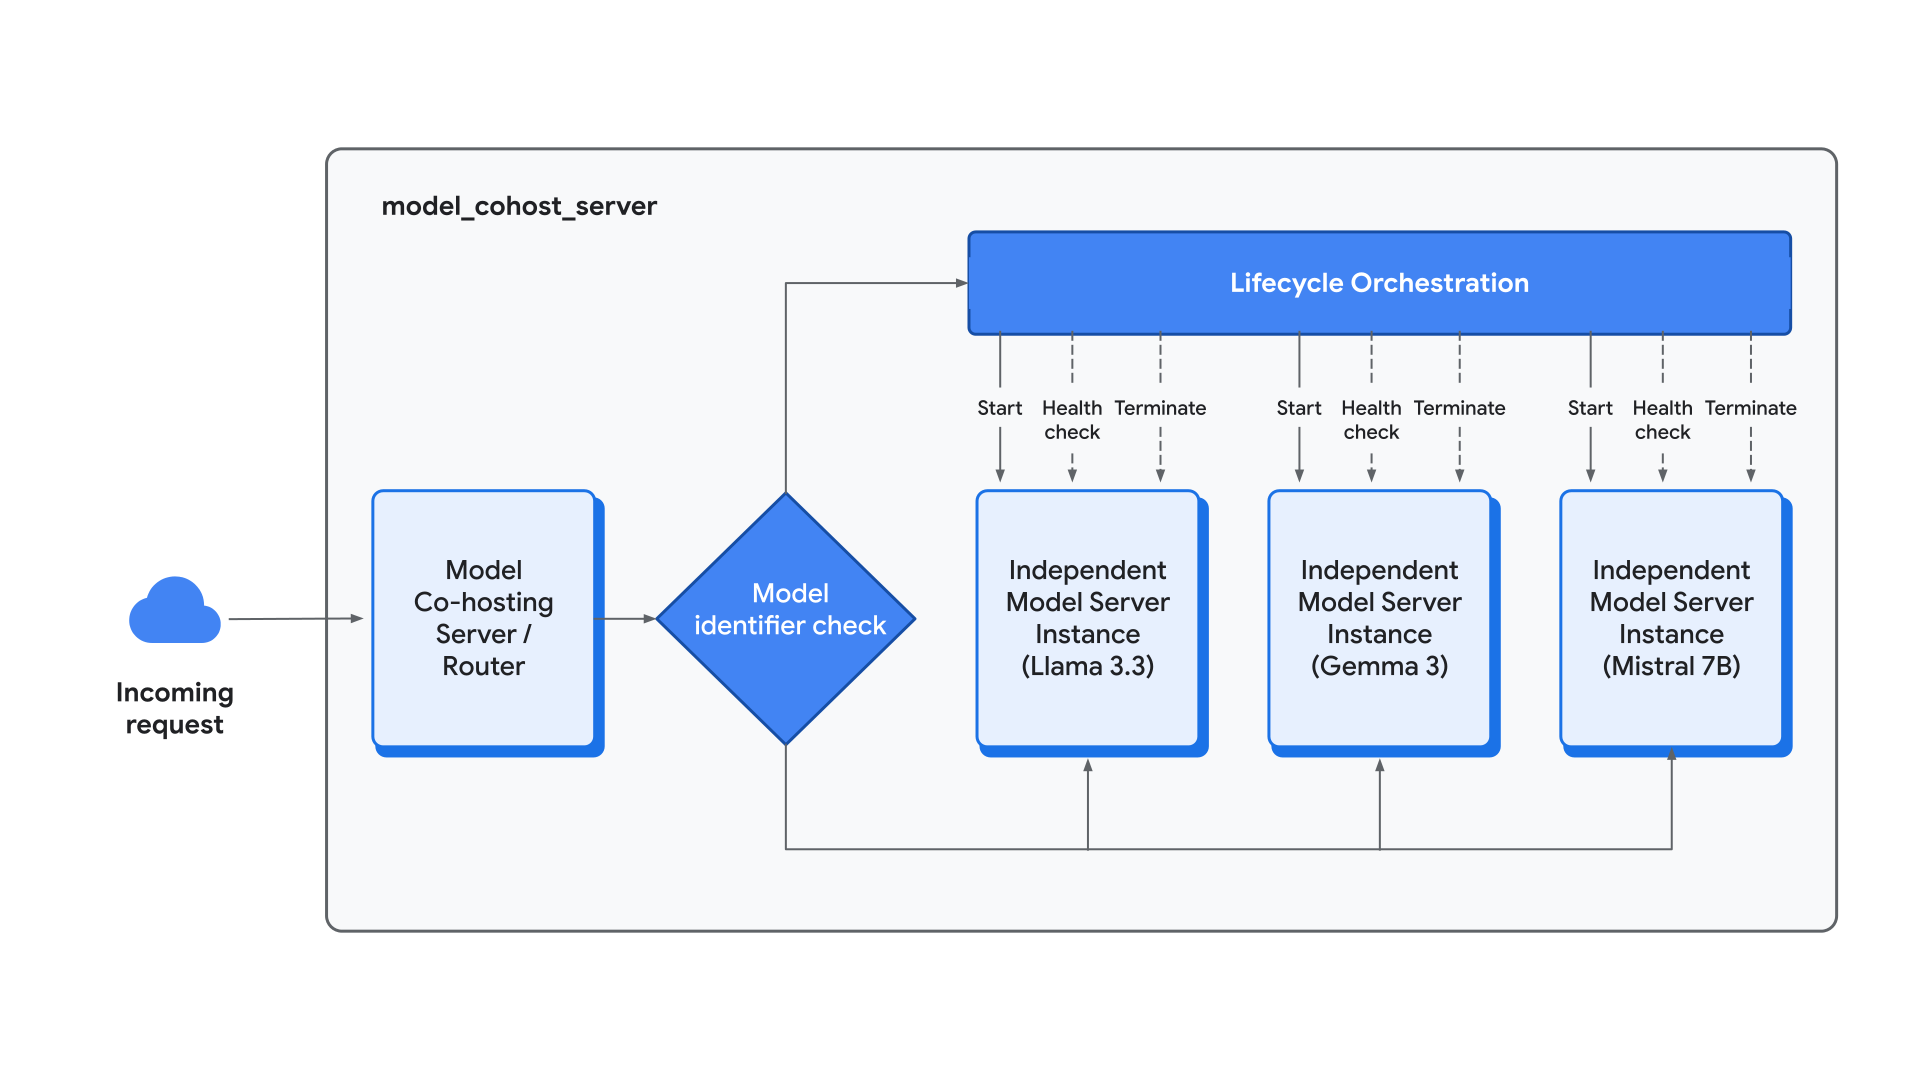
我们的实现侧重于容器级解决方案,该解决方案允许同时提供具有独立配置的多个模型。此架构通过多种集成式技术机制运行,首先是在单个容器中部署多个独立的模型服务器实例。每个实例都是模型服务器的完整独立副本,可实现虚拟机中的同步请求处理。为了管理此流量,我们在容器内实现了一个实例路由层,可高效地将传入请求分配给活跃实例。
此设计通过允许每个共同托管的模型利用专用服务配置来提供细粒度的并行处理,该配置具有针对张量并行处理 (TP)、流水线并行处理 (PP) 和特定模型实例数量的独特设置。此外,还可使用资源切分功能,为每个模型分配特定的 GPU 内存分区(例如每个模型分配 0.4 GPU 内存分区),以确保不同的工作负载在同一加速器上共存,而不会相互争夺关键内存资源。这种架构方法可将静态硬件预留(例如完整的 8x H100 GPU 节点)转换为灵活的计算池,能够为各种模型提供服务,从大型推理模型到小型低延迟聊天模型,应有尽有。
原型设计和基准研究
在开发可用于生产用途的编排器之前,我们进行了一项全面的基准研究,以验证模型共同托管的理论效率。此阶段旨在全面测试 vLLM 的原生并行性,并精确量化模型共享同一硅芯片时的“干扰”程度。
平行性调查:寻找“交叉点”
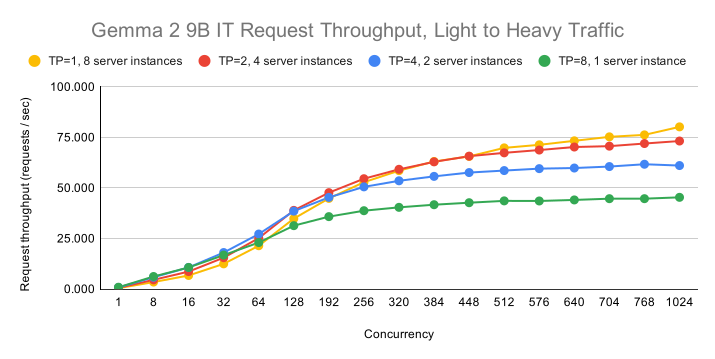
我们的初步分析侧重于 vLLM 的原生张量并行性 (TP) 和 Vertex 将模型实例实现为多个 vLLM 服务器实例,以确定这些策略如何与不同的用户负载互动。我们发现,最佳配置在很大程度上取决于并发性;在较低的并发性下,较高的张量并行性(例如 TP=8)通过在所有可用加速器之间分配层,可为单个请求提供最低延迟。不过,随着并发流量的增加,瓶颈会发生变化。为了在高负载条件下最大限度地提高吞吐量,最佳配置会从 TP=8 转换为 TP=4、TP=2,最终转换为 TP=1,同时增加独立模型实例的数量。此过渡定义了一个“交叉点”,在该点上,低 TP 设置中缩短的 GPU 间通信延迟带来的好处超过了高 TP 执行的原始速度。下图显示了 Gemma 2 9B IT 模型的交叉点图表。
最佳伸缩:单模型、多副本
为了建立严格的可伸缩性基准,我们对在单个节点上提供同一模型的多个实例进行了基准化分析。在饱和流量条件下(每个 GPU 有 2048 个并发请求),在 8xH100 节点上启动 8 个独立的 vLLM 服务器实例,与单 GPU 基准相比,吞吐量大约提高了 7.8 倍,延迟时间几乎没有回归。
基础架构比较:容器与 pod 共同调度
我们还针对原生基础架构级解决方案(尤其是 Pod 共同调度)评估了容器级编排。虽然这两种解决方案在多副本服务方面都提供了相当的性能,但我们最终为最简可行产品 (MVP) 选择了容器级方法。做出此决定的原因是,容器级解决方案在异构共同托管方面具有出色的灵活性,可让开发者并排提供不同的模型架构,并使用不受底层 Kubernetes 调度限制约束的精细软件定义内存分区。此外,容器级编排可实现更快的迭代,并且更易于自定义和创新。
干扰测试:共同托管不同的模型
最终的原型设计里程碑是“干扰测试”,我们在同一虚拟机上共同托管了 Gemma-3n-E2B-it 和 Llama-3.1-8B-Instruct。在为每个模型分配 0.4 GPU 内存分区的情况下,服务性能几乎与单模型基准测试结果相同。例如,在共用环境中,Gemma-3n 的每秒请求数达到 30.21,而在隔离环境中,每秒请求数达到 30.96。这些结果证实,即使在流量很大的情况下,只要适当划分内存资源以防止 KV 缓存饥饿,共同托管的模型之间几乎不会出现计算干扰。
MVP 容器实现
从经过验证的基准过渡到可用于生产用途的系统,需要设计一个强大的容器化编排器。此开发阶段的重点是构建一个高级软件层,该层能够管理多个模型生命周期的复杂性,同时确保确定性的资源隔离。
模型共同托管服务器设计
我们实现的核心是 model_cohost_server,这是一个自定义入口点,旨在充当容器中的主编排器。与标准的单进程模型不同,此服务器实现了子进程管理,可促进多个独立模型服务器实例(例如 vLLM)作为隔离的子进程并发执行。为了管理传入流量,编排器采用高级请求路由,通过 --served-model-name 等实参按唯一模型标识符识别请求,并将请求定向到相应的内部服务器实例。除了路由之外,服务器还提供全面的生命周期编排,用于管理所有共同托管实例的初始化、健康状况监控和终止。这种集中式管理可为外部流量提供单个统一的端点,同时保持每个子进程的独特操作边界。
GPU 资源分区:确定性切分
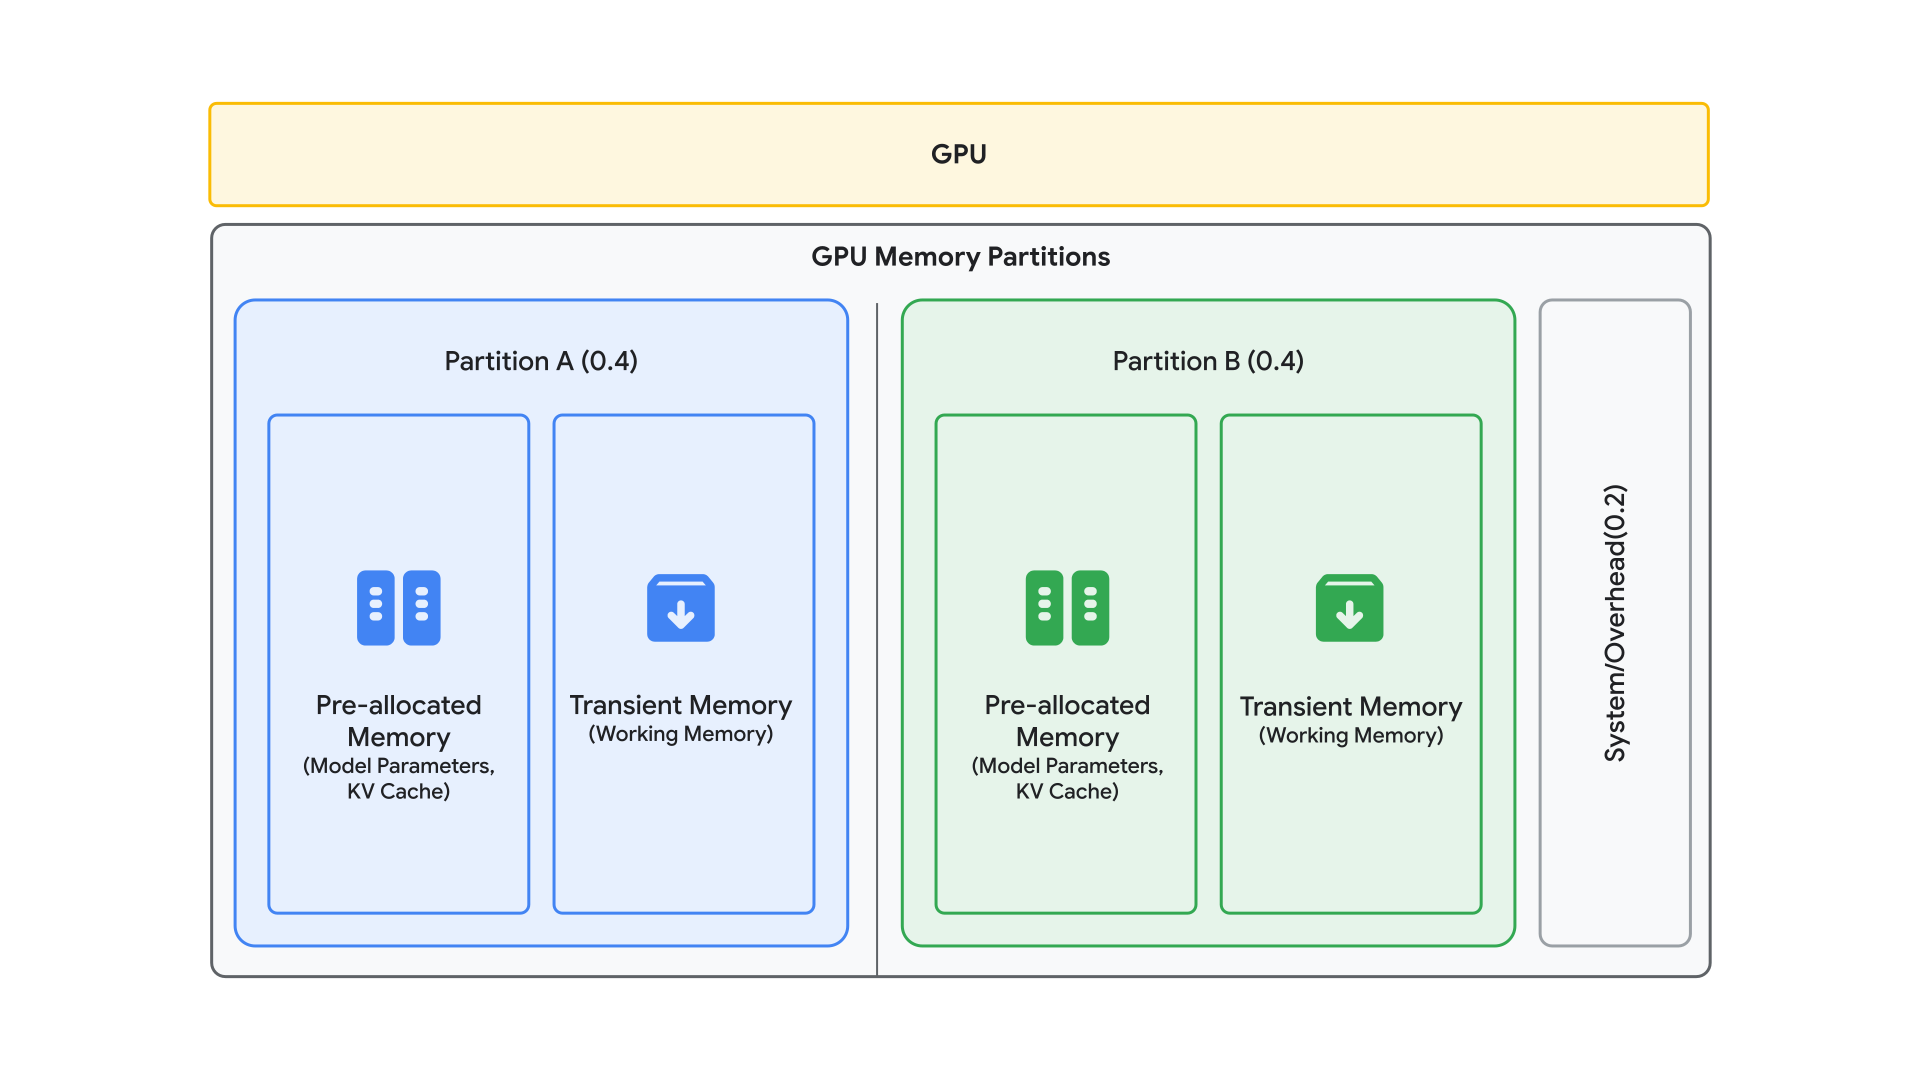
为了消除单个模型的工作负载在共同托管的环境中触发内存不足 (OOM) 错误的风险,我们实施了严格的资源切分机制。这是通过 gpu-memory-partition 实参实现的,该实参允许开发者定义明确的内存比率(例如 0.4、0.4),以便为每个单独的模型实例预留节点总 GPU 内存的固定百分比。
为了指导这种分配,我们采用了“预分配与瞬态”内存模型,该模型区分了静态和动态资源需求。“预分配”内存是指用于模型权重和 KV 缓存的内存。模型权重使用的内存量取决于模型的参数数量和精度。例如,一个采用 BF16 的 80 亿参数模型大约需要 16 GB 的静态存储空间。用于 KV 缓存的内存量取决于模型维度、精度、上下文长度和序列数量。“临时”内存包含中间计算和推理工作内存。gpu-memory-partition 实参表示“预分配”的内存。我们建议将 gpu-memory-partition 的总和设置为小于 1.0,以便为“瞬态”内存留出缓冲空间。
产品化
在与 Vertex AI 共同托管模型的生产化阶段,我们致力于为单模型多副本和多模型部署配置建立无缝的可用于生产用途环境。这种转变有效地将实证基准测试结果转化为简化的部署工作流程和深度集成的基础设施支持结构。
简化的部署工作流
为了降低高密度服务的门槛,我们使用自定义容器实参标准化了共同托管配置,这些实参与现有的 Vertex AI API 原生集成。对于全尺寸虚拟机(例如 8x H100 节点),我们开发了一个基准实用程序,可根据您的具体使用场景自定义最佳方案。借助这些基准实用程序,您可以找到一种配置,该配置可根据模型的具体参数数量和精度自动平衡张量并行 (TP)、流水线并行 (PP) 和模型实例数量。此外,该功能还提供强大的 Deployment API 支持,让开发者可以直接在标准 deployModel 请求中指定这些精细的参数(包括确切的 GPU 内存分区),并部署模型。
动态多模型服务
在技术发展历程中,我们取得了一项重大进步,即从静态配置过渡到动态服务架构。此功能对于流量模式快速变化的生产环境至关重要,因为在不完全重启容器的情况下加载或卸载模型的能力对于保持基础设施的敏捷性和高可用性至关重要。
动态更新 API (update_models)
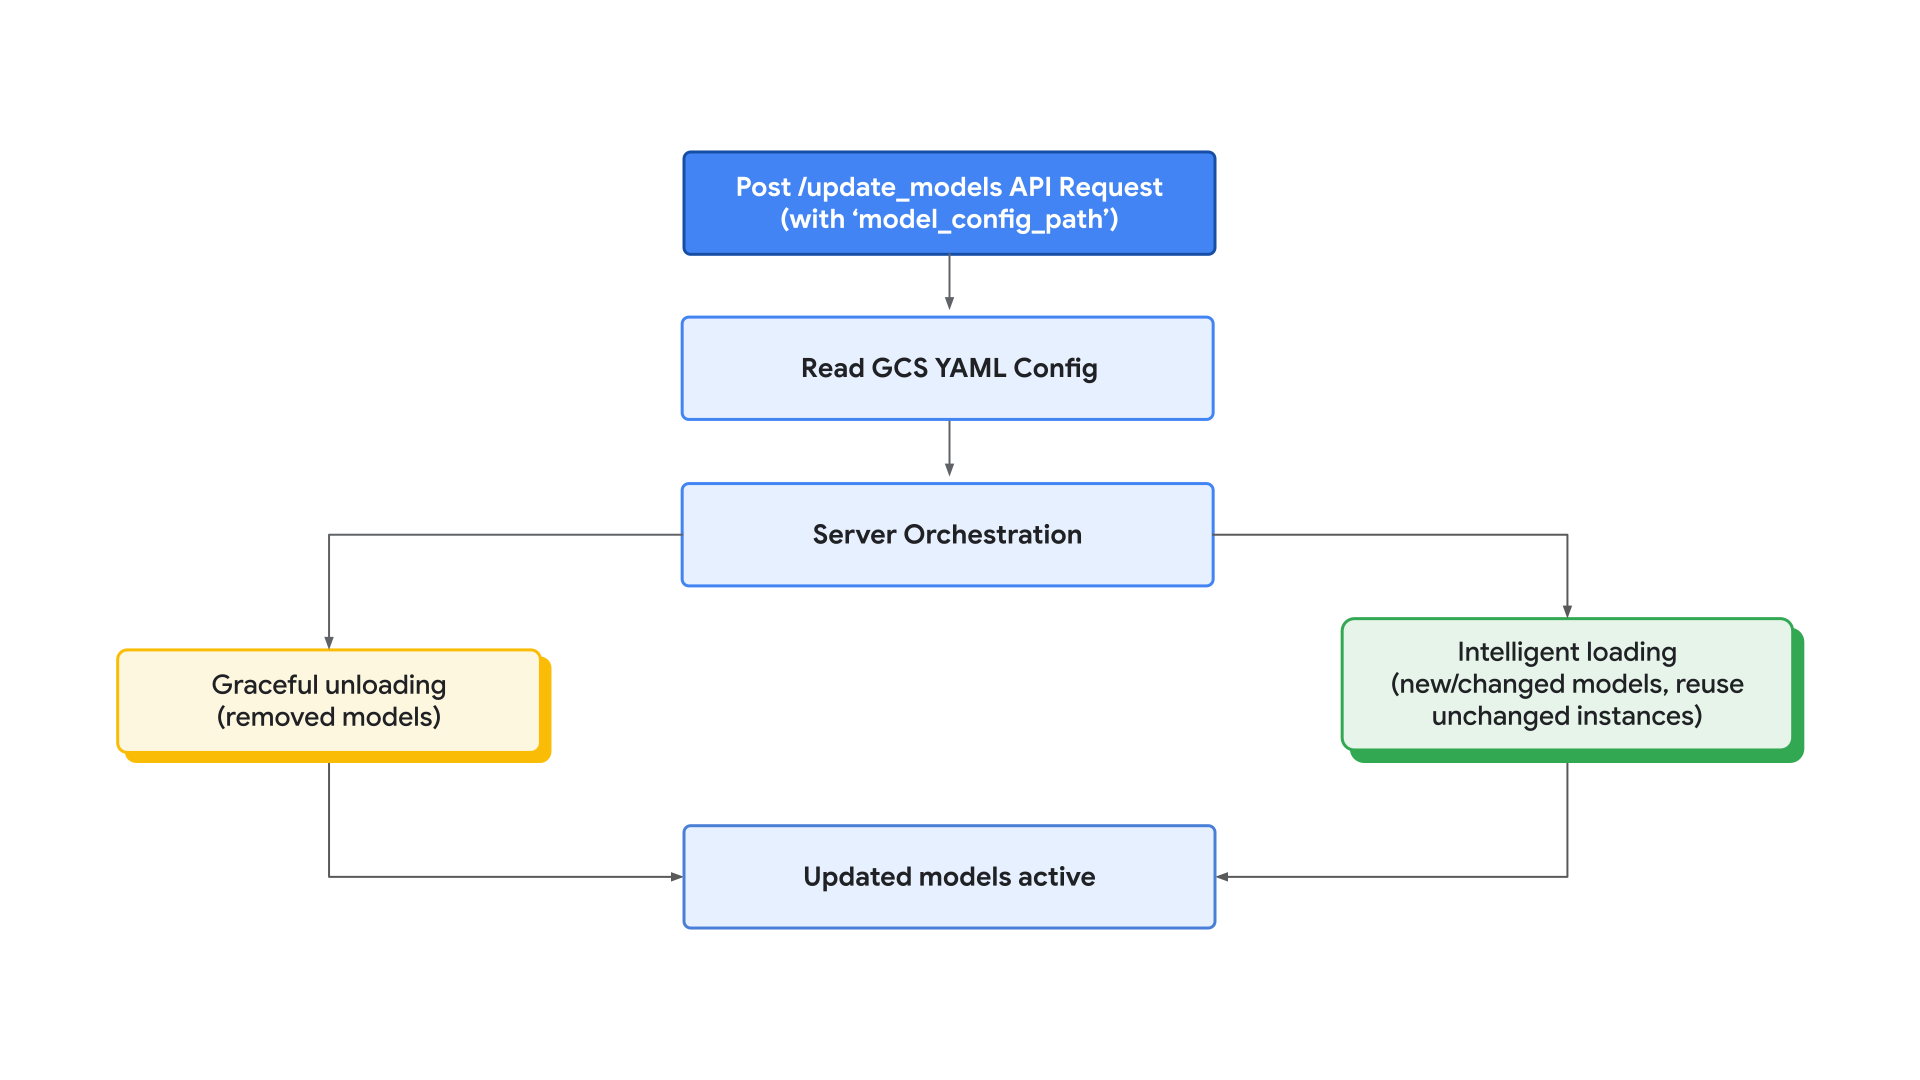
为了解决不可变部署的固有限制,我们在 Vertex Model Garden vLLM 模型共同托管容器中实现了一个专门的模型更新 API。此 API 可实现热重载,使服务器能够根据存储在 Cloud Storage 存储桶中的集中式配置文件,动态调整其托管的模型组合。
更新过程通过向 update_models 端点发送 POST 请求来启动,该请求包含指向 Cloud Storage YAML 文件的 model_config_path。收到此请求后,服务器会执行一个多阶段编排序列,该序列经过优化,可最大限度地减少停机时间:
- 正常卸载:系统会识别新配置中缺少的模型,并先终止其子进程,立即回收 GPU 内存和计算资源。
- 智能加载和重用:然后,服务器会初始化新的模型实例。至关重要的是,如果模型的并行性设置(例如张量并行性 [TP] 或流水线并行性 [PP])及其分配的内存分区保持不变,编排器会重复使用现有的正在运行的实例。此优化会绕过代价高昂的重新初始化阶段,确保在配置发生变化期间,活跃服务不会中断。
延迟时间和性能分析
对这些更新策略的实证分析表明,动态热重加载可大幅缓解与大规模 LLM 服务相关的常见“冷启动”惩罚。
总结
与 Vertex AI 进行模型共同托管代表着一种根本性的范式转变,从僵化的、依赖大量硬件的单体部署转变为流畅高效的服务架构。通过从“每个虚拟机一个模型”的标准发展为高密度计算池模型,组织可以显著降低总拥有成本 (TCO),同时保持(甚至提高)性能基准。
我们的工程实践和广泛的多模型基准研究已经为该架构建立了一套明确的生产指南:
- 没有一种配置能够适用于所有情况。我们提倡为特定使用情形(模型、硬件、流量)找到最佳服务方案,并为此构建工具。
- 使用副本扩缩吞吐量。
- 通过打破硬件边界并以更精细的粒度拆分内存,提高资源利用率。
如需成功实现共同托管架构,我们建议采用以下技术工作流程:
- 显式分区:使用
--gpu-memory-partitions实参为各个模型分配内存资源。 - 迭代基准测试:利用提供的基准测试实用程序,确定工作负载的特定“并发交叉”点,即实例数、TP 和 PP 的“最佳”配置。
在 Google Cloud Model Garden 上实现共同托管,为构建高密度 AI 应用提供了一个可伸缩的蓝图。我们鼓励开发者探索这些功能,并使用提供的教程笔记本重现我们的基准,以便根据其特定的企业要求优化服务配置。
感谢阅读
欢迎您就 Vertex AI 提供反馈和提出问题。
致谢
我们要向 Google Cloud Vertex AI 团队表达诚挚的谢意。具体而言,我们要感谢 Bo Wu 和 Ting Yu 在整个项目期间提供的领导和指导,以及 Deborah He、Shawn Ma、Desmond Liu、Yang Pan、Surya K G Tangatur 和 Luis Rizo 做出的宝贵贡献。