

隨著大型語言模型 (LLM) 的發展,企業在LLM 服務成本效益方面,「每部機器一個模型」的部署模式已成為重大瓶頸。LLM 通常需要大量硬體預留項目 (例如完整的 8x H100 GPU 節點),才能管理尖峰負載。然而,在標準作業期間,這些昂貴的資源往往未充分利用,導致總持有成本 (TCO) 偏高。
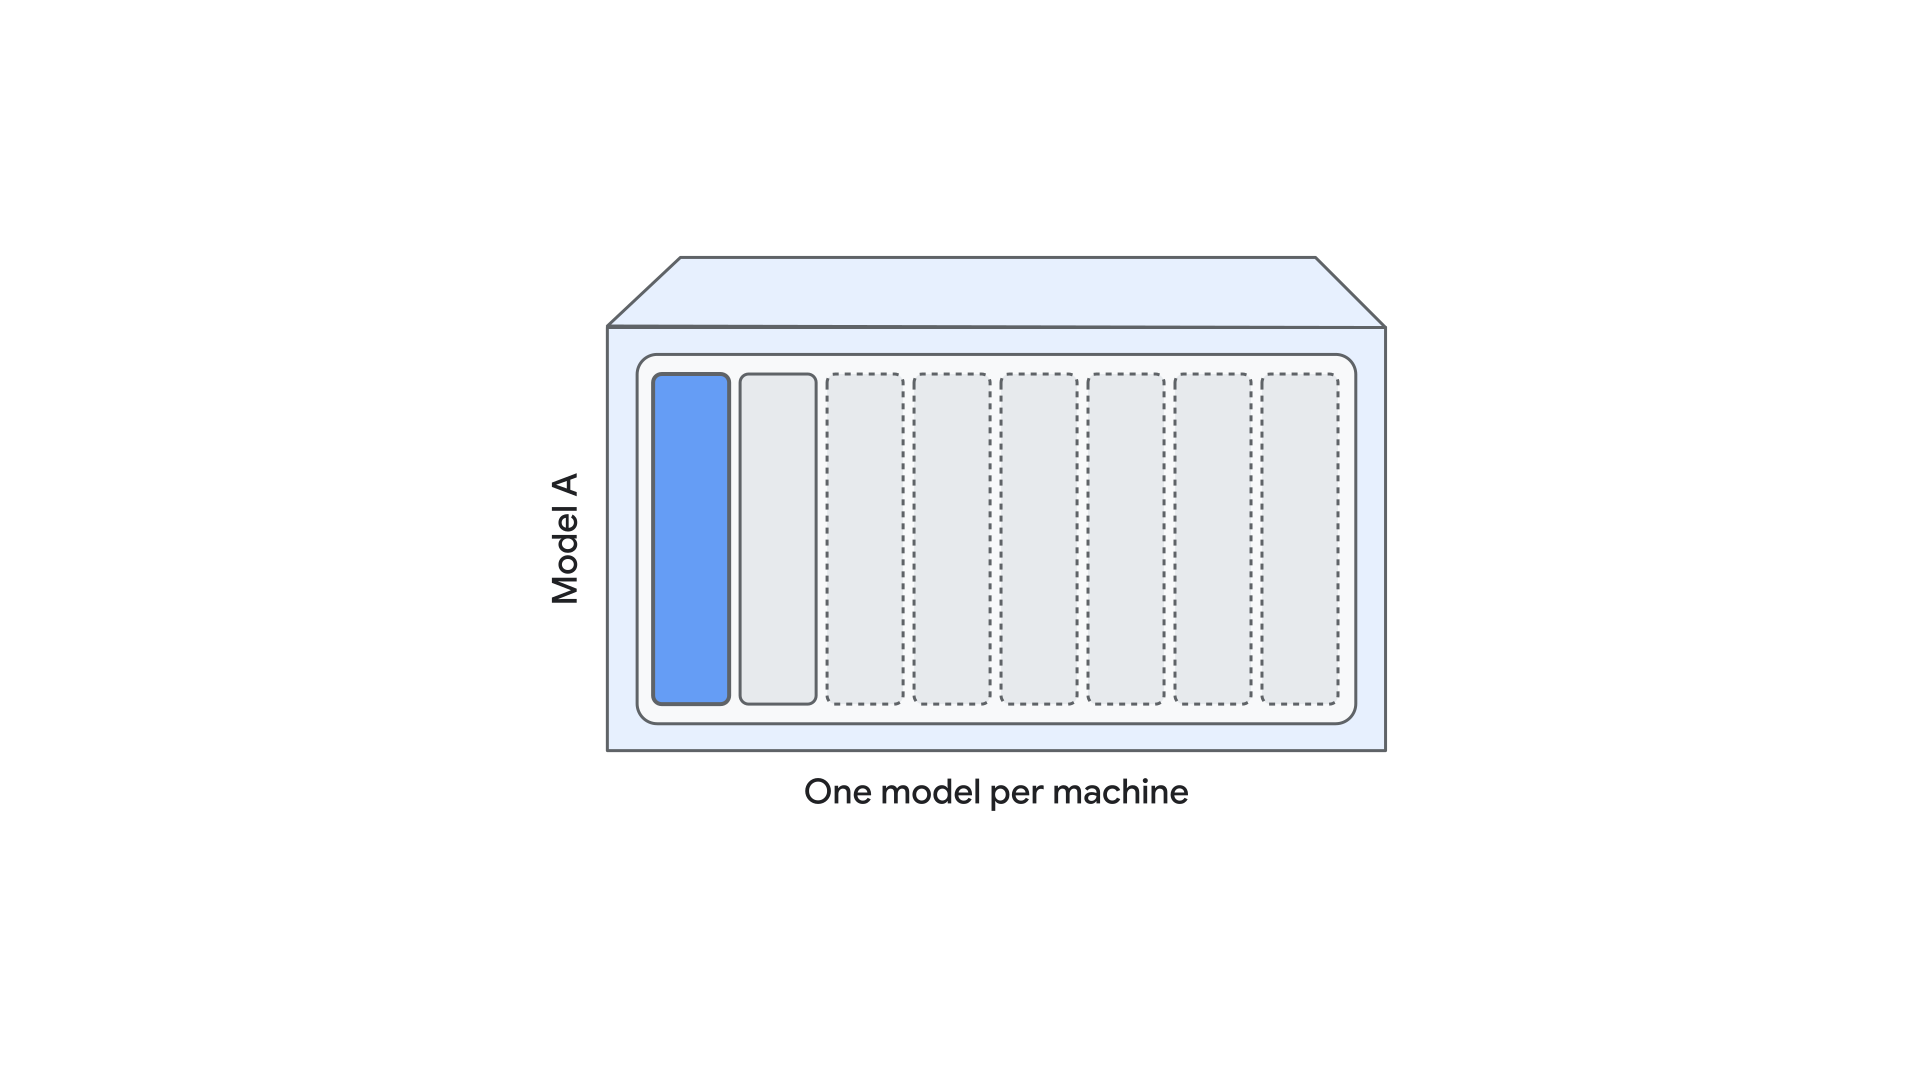
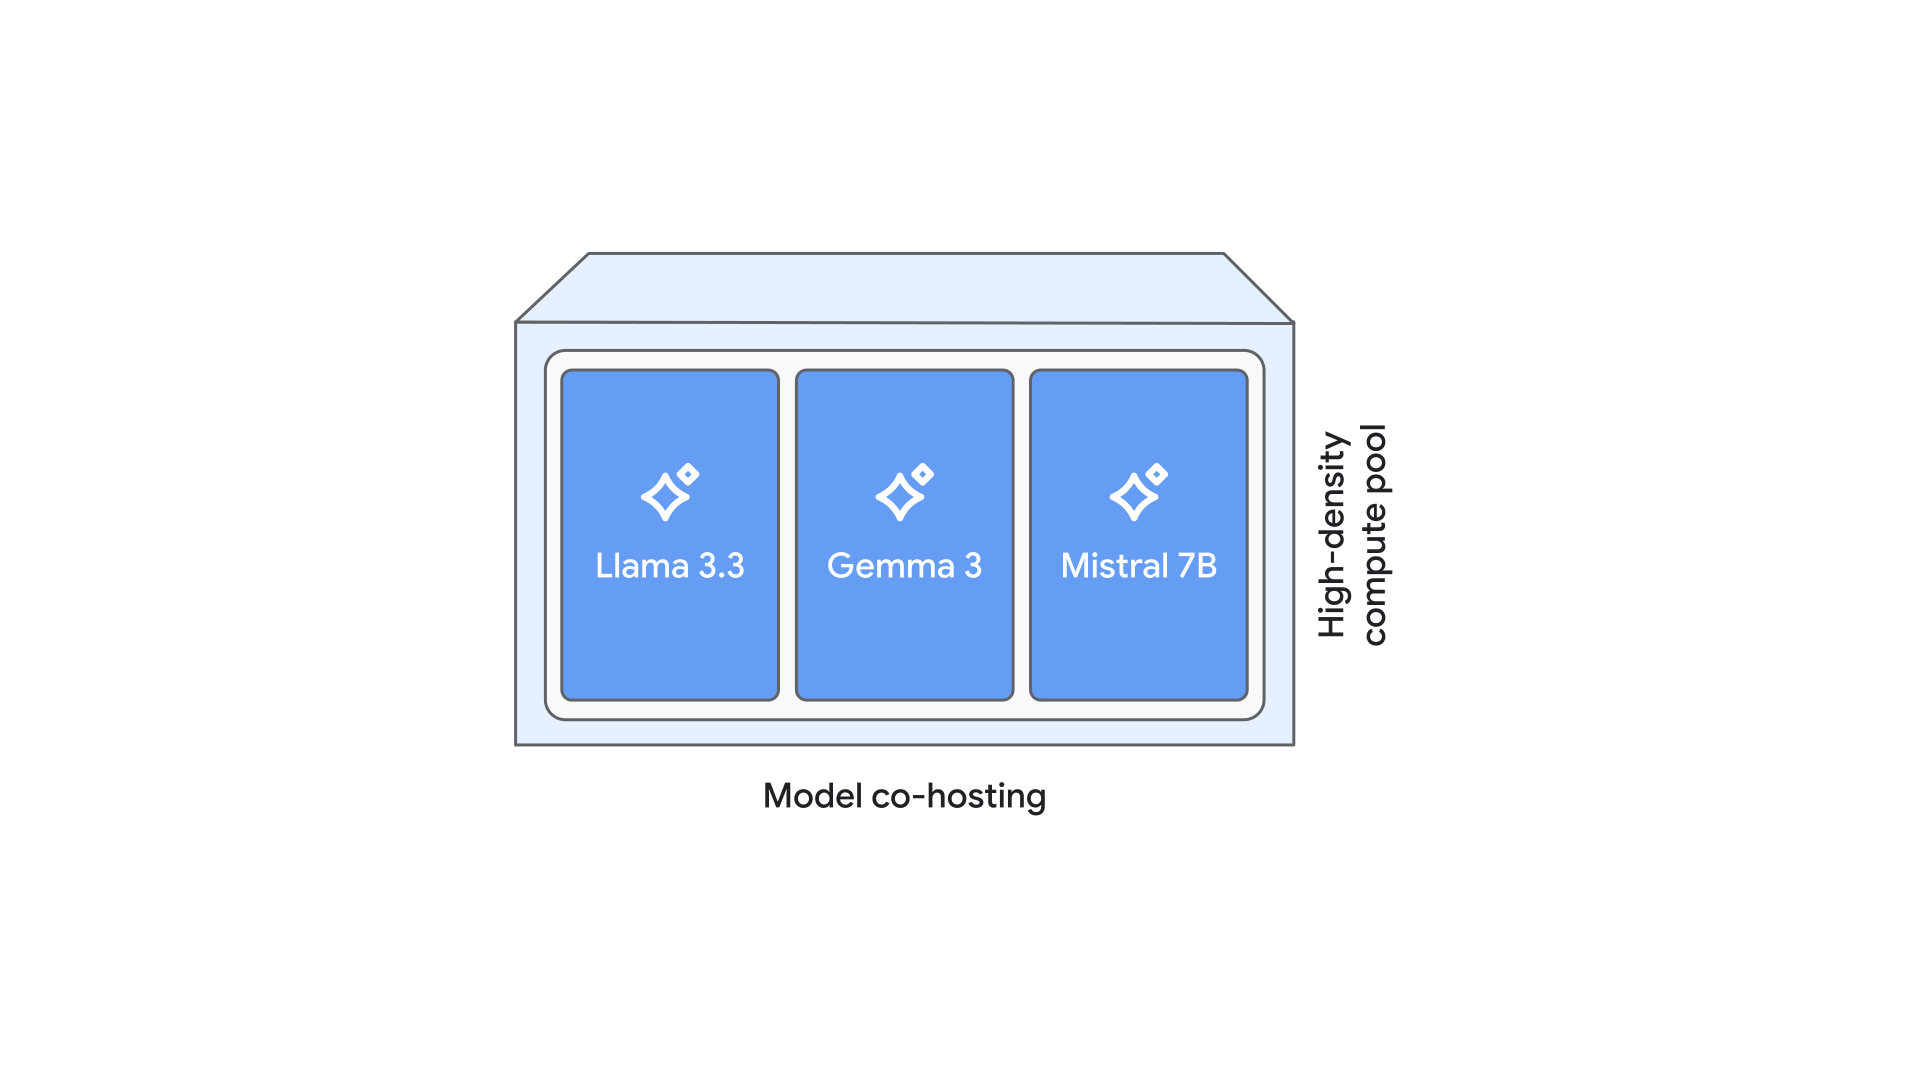
模型共同託管可讓多個模型執行個體共用相同的虛擬機器和 GPU 資源,解決效率不彰的問題。包括 Llama 3 和 Gemma 3 等完全不同的模型。Vertex AI Model Garden 運用 GPU 子記憶體切片和智慧資源分割功能,將靜態硬體預留項目轉換為彈性高密度的運算集區。
這篇技術網誌詳細說明 Vertex AI 工程團隊的流程,如何將模型共同主機服務導入正式版雲端服務。我們將分享容器層級的實作策略方法、找出最佳服務設定,以及從大規模多模型基準研究中獲得的重要發現,協助您盡可能提高 LLM 服務的成本效益。
瞭解模型共同主機:概念和架構
模型共同託管是一種高密度服務策略,可讓多個大型語言模型 (LLM) 執行個體或不同模型架構,在單一虛擬機器 (VM) 中共用相同的實體硬體資源。與傳統部署模型不同,共同代管會使用精細的資源分割,盡可能提高硬體投資報酬率,並改善記憶體和運算資源的使用率。傳統部署模型會將完整的 VM 或 GPU 專用於單一模型。
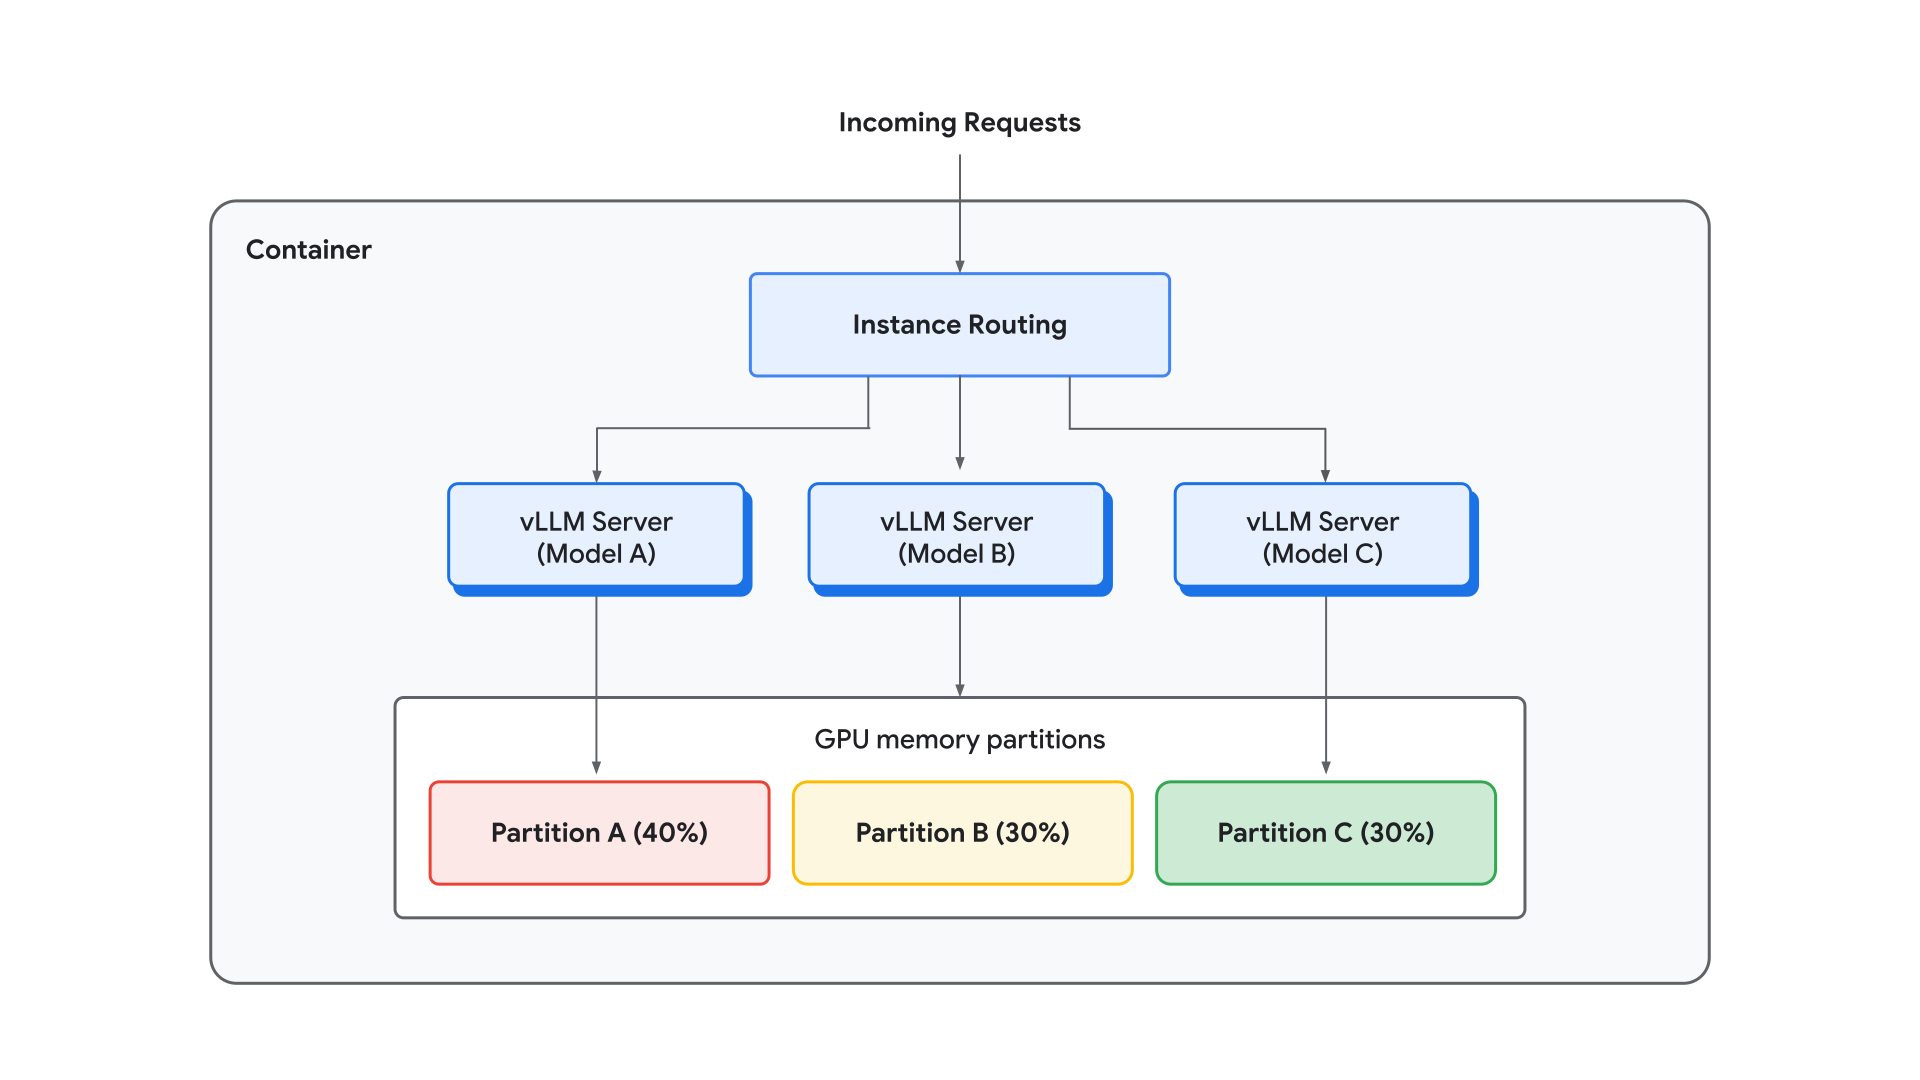
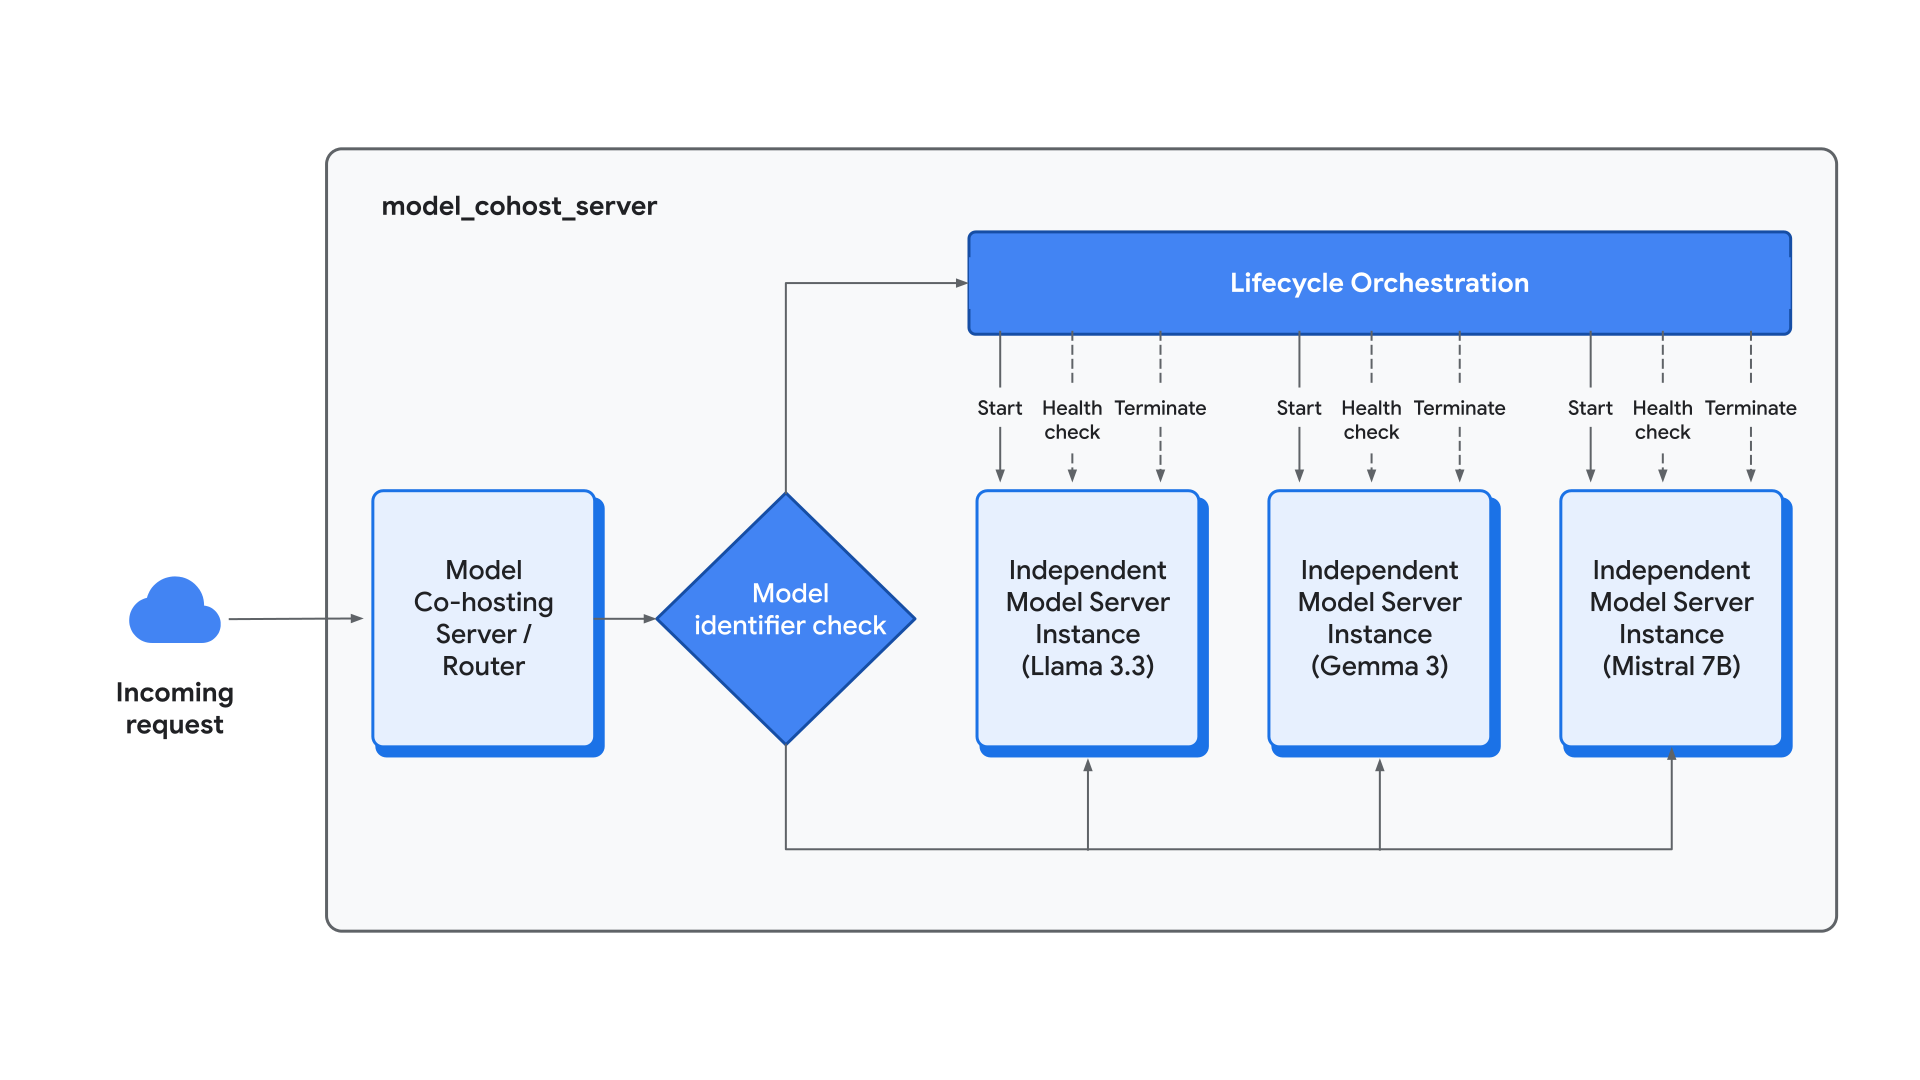
我們的實作重點是容器層級的解決方案,可同時提供多個模型,並採用獨立設定。這項架構透過多種整合式技術機制運作,首先是在單一容器中部署多個獨立模型伺服器執行個體。每個執行個體都是模型伺服器的完整獨立副本,因此虛擬機器可以同時處理多個要求。為管理這類流量,我們在容器中導入執行個體路由層,有效將傳入要求分配給作用中的執行個體。
這項設計可讓每個共存模型使用專屬的服務設定,並為張量平行處理 (TP)、管線平行處理 (PP) 和特定模型執行個體數量提供專屬設定,進而實現精細的平行處理。此外,系統還會進行資源切片,將特定 GPU 記憶體分割區指派給每個模型 (例如每個模型 0.4 個 GPU 記憶體分割區),確保多種工作負載共用同一部加速器時,不會互相耗盡重要的記憶體資源。這種架構方法可將靜態硬體預留項目 (例如完整的 8 倍 H100 GPU 節點),轉換為彈性運算集區,能夠提供各種組合,包括大型推理模型和小型低延遲聊天模型。
原型設計和基準研究
在開發可投入生產的協調器之前,我們進行了全面的基準研究,以驗證模型共同主機的理論效率。這個階段的目標是徹底測試 vLLM 的原生平行處理能力,並精確量化模型共用相同晶片時的「干擾」程度。
平行性調查:找出「交叉點」
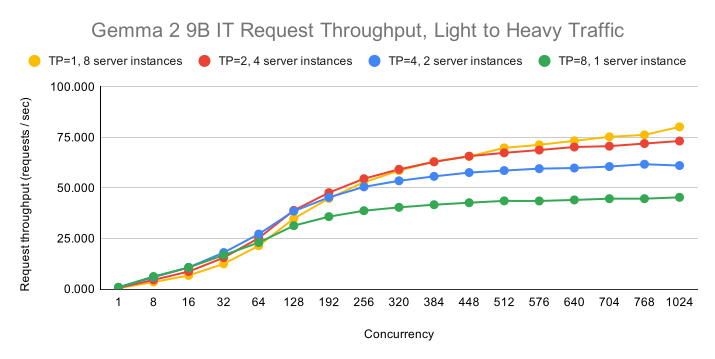
我們初步分析的重點是 vLLM 的原生張量平行化 (TP),以及將模型例項實作為多個 vLLM 伺服器例項的 Vertex,藉此判斷這些策略如何與不同的使用者負載互動。我們發現最佳設定高度取決於並行性;在並行性較低的情況下,高張量並行性 (例如 TP=8) 會將層分配到所有可用的加速器,為個別要求提供最低延遲。不過,隨著並行流量增加,瓶頸會轉移。如要在高負載條件下盡可能提高處理量,最佳設定會從 TP=8 轉換為 TP=4、TP=2,最終為 TP=1,同時增加獨立模型執行個體的數量。這項轉換定義了「交叉點」,在低 TP 設定中,減少 GPU 間通訊延遲的好處,會超過高 TP 執行速度的原始速度。下圖為 Gemma 2 9B IT 模型的交叉點圖表。
最佳化擴充:單一模型、多個副本
為建立嚴格的擴充性基準,我們在單一節點上對相同模型的數個執行個體進行基準測試。在流量飽和的條件下 (每個 GPU 2048 個並行要求),在 8xH100 節點上啟動八個獨立的 vLLM 伺服器執行個體,與單一 GPU 基準相比,產量大約提升了 7.8 倍,延遲時間幾乎沒有回歸。
基礎架構比較:容器與 Pod 共同排程
我們進一步評估了容器層級的協調作業,並與原生基礎架構層級的解決方案 (特別是 Pod 共同排程) 比較。雖然這兩種解決方案在多個副本的服務方面效能相當,但我們最終為最簡可行產品 (MVP) 選用了容器層級方法。這項決策的依據是容器層級解決方案在異質共存方面提供的絕佳彈性,可讓開發人員並排放送不同的模型架構,並使用不受基礎 Kubernetes 排程限制的精細軟體定義記憶體分割區。此外,容器層級的自動化調度管理可大幅加快疊代速度,並簡化自訂和創新程序。
干擾測試:共同託管不同模型
最後一個原型設計里程碑是「干擾測試」,我們在同一個 VM 上共同主辦 Gemma-3n-E2B-it 和 Llama-3.1-8B-Instruct。為每個模型指派 0.4 個 GPU 記憶體分割區後,服務效能幾乎與單一模型基準保持一致。舉例來說,在共用主機環境中,Gemma-3n 的要求數為 30.21,相較之下,獨立環境的要求數為 30.96。這些結果證實,即使在流量大的情況下,只要適當分割記憶體資源,避免 KV 快取資源不足,共同代管的模型之間幾乎不會發生運算干擾。
MVP 容器實作
從經過驗證的基準轉換為可部署於正式環境的系統,需要設計強大的容器化調度器。這個開發階段的重點是建構高階軟體層,以管理多個模型生命週期的複雜性,同時確保資源隔離的確定性。
模型共同託管伺服器設計
實作的核心是 model_cohost_server,這是一個自訂進入點,旨在做為容器內的主協調器。這個伺服器會實作子程序管理,有別於標準的單一程序模型,可做為獨立子程序,同時執行多個獨立模型伺服器執行個體 (例如 vLLM)。為管理傳入流量,協調器會採用高階要求路徑,透過 --served-model-name 等引數,依據專屬模型 ID 識別要求,並將要求導向對應的內部伺服器執行個體。除了路由之外,伺服器還提供完整的生命週期協調功能,可管理所有共同代管執行個體的初始化、健康狀態監控和終止作業。這種集中式管理方式可為外部流量提供單一統一的端點,同時維持各個子程序的獨立運作界線。
GPU 資源分割:確定性切片
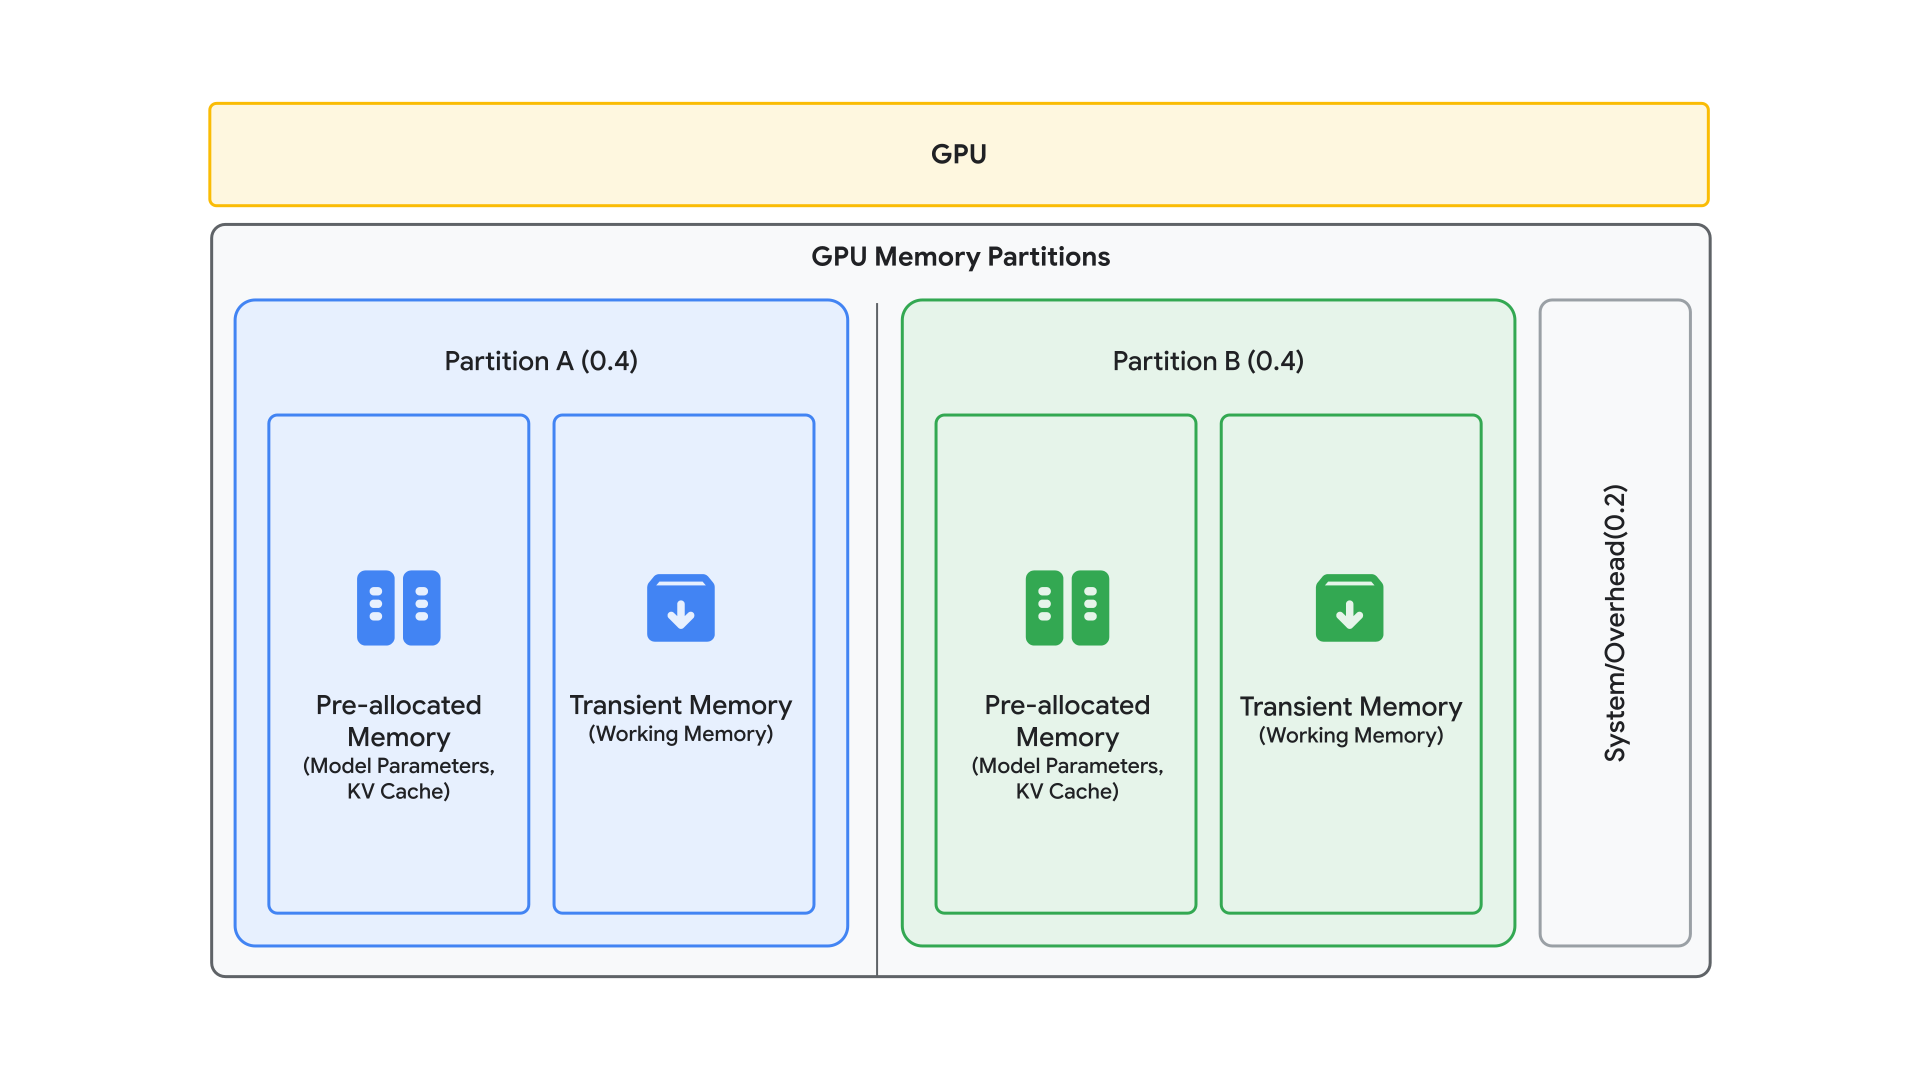
為避免單一模型的工作負載在共用環境中觸發記憶體不足 (OOM) 錯誤,我們導入了嚴格的資源切片機制。這項作業是透過 gpu-memory-partition 引數完成,開發人員可定義明確的記憶體比例 (例如 0.4、0.4),為每個個別模型例項預留節點 GPU 記憶體總量的固定百分比。
為引導這項分配作業,我們採用「預先分配與暫時性」記憶體模型,可區分靜態和動態資源需求。「預先分配」的記憶體包含用於模型權重和 KV 快取的記憶體。模型權重使用的記憶體量取決於模型的參數數量和精確度。舉例來說,BF16 中的 8B 參數模型約需 16 GB 的靜態儲存空間。KV 快取使用的記憶體量取決於模型維度、精確度、內容長度和序列數。「暫時性」記憶體包含中間運算和推論工作記憶體。gpu-memory-partition 引數會說明「預先配置」的記憶體。建議您將 gpu-memory-partition 的總和設為小於 1.0,為「暫時性」記憶體預留緩衝空間。
產品化
在 Vertex AI 模型共同代管的產品化階段,我們致力於為單一模型多重副本和多模型服務設定,建立可順暢運作的正式環境。這項轉移作業可有效將實證基準測試結果,轉換為簡化的部署工作流程,並深入整合基礎架構支援結構。
簡化部署工作流程
為降低高密度服務的進入門檻,我們使用自訂容器引數,將共同託管設定標準化,並與現有的 Vertex AI API 原生整合。對於 8x H100 節點等全形狀虛擬機器,我們開發了基準公用程式,可為特定用途自訂最佳配方。這些基準公用程式可協助您找出自動平衡張量平行處理 (TP)、管道平行處理 (PP) 和模型執行個體數量的設定,並根據模型的特定參數計數和精確度進行調整。此外,我們也提供強大的 Deployment API 支援,讓開發人員直接在標準 deployModel 要求中指定這些精細參數 (包括確切的 GPU 記憶體分割區),並部署模型。
動態提供多個模型
我們在技術方面的一大進展,是從靜態設定轉換為動態放送架構。在流量模式快速變化的生產環境中,這項功能至關重要,因為能夠載入或卸載模型,而不必重新啟動整個容器,是維持基礎架構靈活度和高可用性的必要條件。
動態更新 API (update_models)
為解決不可變動部署作業的固有限制,我們在 Vertex Model Garden vLLM 模型共同託管容器中,實作了專用模型更新 API。這項 API 可簡化熱重新載入作業,讓伺服器能根據儲存在 Cloud Storage 值區中的集中式設定檔,即時調整託管模型組合。
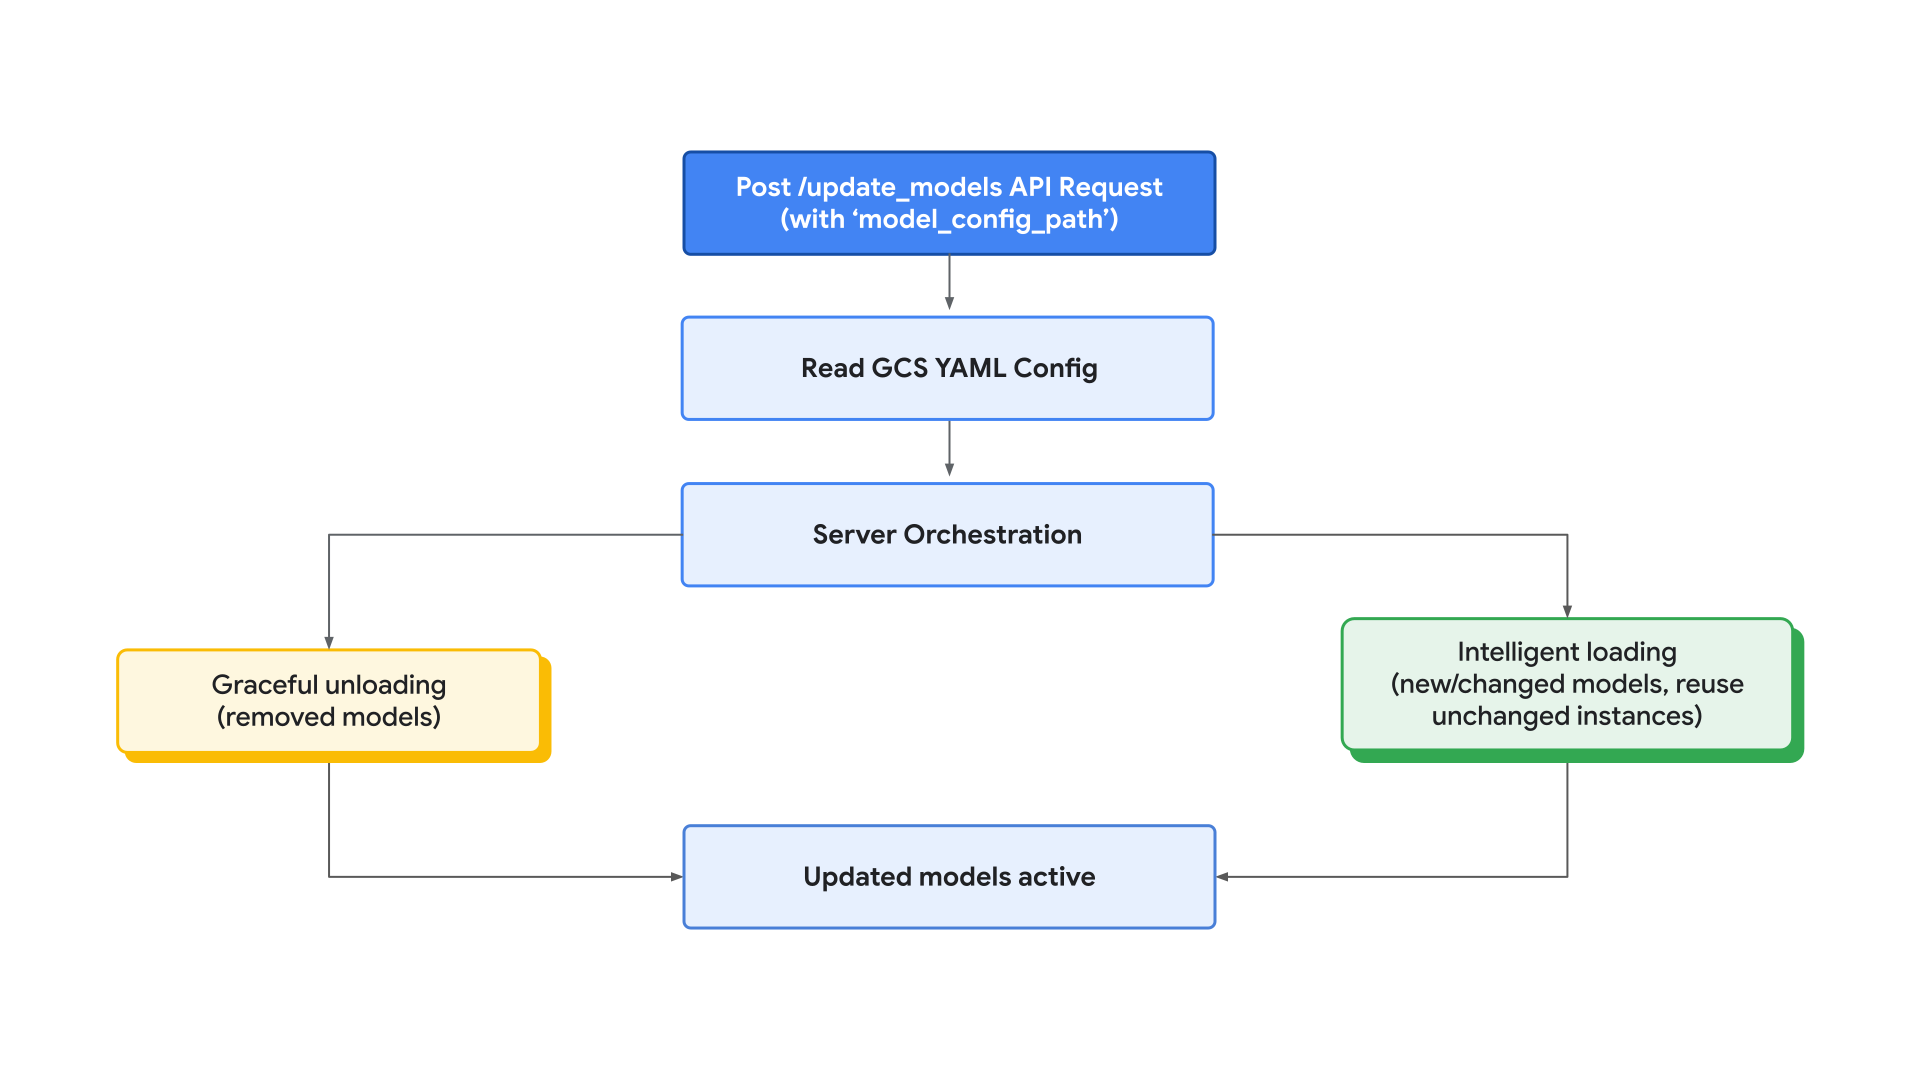
更新程序是透過對 update_models 端點發出的 POST 要求啟動,其中包含指向 Cloud Storage YAML 檔案的 model_config_path。伺服器收到這項要求後,會執行經過最佳化的多級式協調程序,盡量縮短停機時間:
- 正常卸載:系統會找出新設定中缺少的模型,並先終止其子程序,立即回收 GPU 記憶體和運算資源。
- 智慧載入和重複使用:伺服器接著會初始化新的模型執行個體。如果模型的平行處理設定 (例如張量平行處理 (TP) 或管道平行處理 (PP)) 和分配的記憶體分割區維持不變,編排器會重新使用現有的執行中執行個體。這項最佳化功能會略過成本高昂的重新初始化階段,確保在設定變更期間,現有服務不會中斷。
延遲時間和效能分析
對這些更新策略進行實證分析後發現,動態熱重新載入可大幅減輕「冷啟動」懲罰,這類懲罰通常與大規模 LLM 服務相關聯。
結論
與 Vertex AI 共同代管模型代表基本典範轉移,從硬體密集型單體部署轉移至流暢且有效率的服務架構。從「每個 VM 一個模型」的標準演進為高密度運算集區模型,機構可以大幅降低總持有成本 (TCO),同時維持 (通常還能提升) 效能基準。
我們的工程歷程和廣泛的多模型基準研究,已為這個架構建立明確的正式版指南:
- 沒有一體適用的設定。我們提倡為特定用途 (模型、硬體、流量) 找出最佳的服務食譜,並建構相關工具。
- 使用副本擴充輸送量。
- 打破硬體界線,以更精細的層級分割記憶體,提高資源利用率。
如要成功實作共同代管架構,建議採用下列技術工作流程:
- 明確分割:使用
--gpu-memory-partitions引數為個別模型分配記憶體資源。 - 疊代基準化:使用提供的基準公用程式,找出工作負載的特定「並行交叉」點,也就是執行個體、TP 和 PP 數量的「最佳」設定。
在 Google Cloud Model Garden 實作共同託管功能,可為建構高密度 AI 應用程式提供可擴充的藍圖。我們鼓勵開發人員探索這些功能,並使用提供的教學課程筆記本重現我們的基準,根據特定企業需求最佳化放送設定。
感謝閱讀
歡迎提供有關 Vertex AI 的意見回饋或提出問題。
特別銘謝
我們衷心感謝 Google Cloud Vertex AI 團隊。我們特別感謝 Bo Wu 和 Ting Yu 的領導和指導,以及 Deborah He、Shawn Ma、Desmond Liu、Yang Pan、Surya K G Tangatur 和 Luis Rizo 在這個專案中做出的寶貴貢獻。