

Best practice per i workload multi-tenant su BigQuery
Questo documento fornisce tecniche e best practice per i pattern comuni utilizzati nelle piattaforme di dati multi-tenant e nei data mart aziendali.
Le aziende commerciali, i fornitori di software as a service (SaaS) e le organizzazioni governative devono spesso ospitare in modo sicuro dati interni e di terze parti oltre i confini geografici e amministrativi. BigQuery è uno strumento potente in grado di soddisfare costantemente i requisiti della piattaforma multi-tenant per exabyte di dati e centinaia di migliaia di consumer di dati in diverse unità aziendali. Questo documento è rivolto alle organizzazioni che eseguono il deployment di piattaforme multi-tenant su BigQuery e che vogliono comprendere i controlli degli accessi e le funzionalità di gestione delle prestazioni disponibili.
I creatori di piattaforme multi-tenant spesso devono bilanciare le considerazioni relative ai seguenti aspetti:
- Isolamento dei dati: implementa controlli efficaci per impedire la fuga di dati tra i tenant.
- Prestazioni coerenti: configura e distribuisci le prenotazioni BigQuery per mantenere prestazioni coerenti tra i tenant.
- Gestione delle risorse: pianifica l'impatto di quote e limiti.
- Distribuzione geografica: individua i dati in località geografiche designate e richieste. Per problemi relativi alla conformità, consulta le offerte di conformità di Cloud de Confiance by S3NS.
- Controllo e sicurezza: proteggi i dati del tenant da accessi inappropriati ed esfiltrazione.
- Gestione dei costi: garantire costi BigQuery coerenti per l'hosting di ogni tenant.
- Complessità operativa: riduci al minimo la variabilità del sistema necessaria per ospitare nuovi tenant.
Fornitore SaaS con infrastruttura tenant condivisa
I fornitori SaaS che ospitano dati di terze parti devono garantire l'affidabilità e l'isolamento dell'intero parco clienti. Questi clienti potrebbero essere decine di migliaia e l'accesso ai loro dati potrebbe avvenire tramite un'infrastruttura di servizi condivisa. Alcuni fornitori SaaS gestiscono anche un datastore centralizzato e sanitizzato per eseguire analisi sull'intero parco risorse dei tenant.
Un design con un set di dati per tenant aiuta a mitigare i seguenti problemi che un'organizzazione deve affrontare quando scala fino a migliaia di tenant:
- Complessità amministrativa: il numero totale di nuovi progetti e risorse cloud per cliente
- Latenza end-to-end: quanto è aggiornato il datastore sia per i tenant sia per le soluzioni di analisi cross-customer
- Aspettative di rendimento: garantire che le prestazioni del tenant rimangano entro limiti accettabili
Configura i set di dati per ogni tenant
All'interno di un progetto dedicato all'archiviazione dei dati dei clienti, i dati di ogni cliente sono separati da set di dati BigQuery. All'interno dell'organizzazione host, utilizzi un secondo progetto per eseguire il deployment di analisi e machine learning sui dati dei clienti combinati. Puoi quindi configurare il motore di trattamento dati, Dataflow, per scrivere i dati in entrata sia nelle tabelle interne sia in quelle specifiche del tenant. La configurazione di Dataflow utilizza tabelle completamente scritte anziché viste autorizzate. L'utilizzo di tabelle completamente scritte consente una gestione uniforme della distribuzione geografica e aiuta a evitare di raggiungere i limiti delle visualizzazioni autorizzate quando il numero di tenant aumenta.
La separazione tra archiviazione e computing di BigQuery consente di configurare un numero inferiore di progetti rispetto ai data warehouse basati su cluster per gestire problemi come i livelli di servizio e l'isolamento dei dati. Se non hai bisogno di configurare i tenant con risorse cloud dedicate aggiuntive, ti consigliamo di prendere in considerazione la configurazione predefinita di un set di dati dedicato per ogni tenant. Il seguente diagramma mostra un esempio di configurazione di un progetto basato su questo design consigliato:
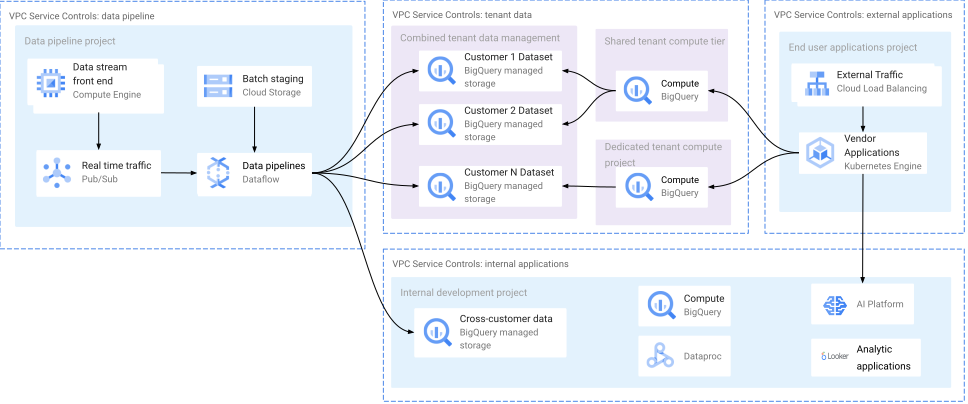
Figura 1. Un numero costante di progetti gestisce le esigenze di dati ed elaborazione man mano che il numero di tenant aumenta.
La configurazione del progetto nella Figura 1 include i seguenti progetti:
- Progetto di pipeline di dati: i componenti dell'infrastruttura di base che ricevono, elaborano e distribuiscono i dati dei tenant sono tutti pacchettizzati in un unico progetto.
- Progetto di dati dei tenant combinati: il progetto di dati principale che gestisce un set di dati per cliente. L'accesso ai dati del tenant deve avvenire tramite i progetti del livello di computing.
- Progetti di sviluppo interno: progetti che rappresentano le risorse autogestite utilizzate dai team di analisi per valutare i dati dei tenant e creare nuove funzionalità.
- Progetti di applicazioni per utenti finali: progetti che contengono risorse progettate per interagire con gli utenti finali. Ti consigliamo di utilizzare service account con ambito tenant per accedere ai set di dati del tenant e di utilizzare una pipeline di build solida e sicura per eseguire il deployment delle applicazioni.
- Progetti di livello di calcolo della prenotazione: i progetti che mappano l'attività di query dei tenant alle prenotazioni BigQuery.
Condividi le prenotazioni
Le prenotazioni in questo approccio si basano sull'algoritmo di pianificazione equa integrato nelle prenotazioni di BigQuery. Ogni prenotazione di livello di calcolo è assegnata a un singolo progetto. Le query dei tenant utilizzano slot di pianificazione equa disponibili per ogni progetto di livello di computing e gli slot inutilizzati di qualsiasi livello vengono riutilizzati automaticamente in un altro livello. Se un tenant ha requisiti di tempistica specifici, puoi utilizzare una coppia progetto-prenotazione dedicata a fornire un numero esatto di slot.
Configura i perimetri dei Controlli di servizio VPC
In questa configurazione, consigliamo i perimetri dei Controlli di servizio VPC per impedire l'esposizione accidentale dei set di dati dei tenant al di fuori della tua organizzazione Cloud de Confiance e per impedire l'unione dei dati non autorizzata all'interno dell'organizzazione.
Perimetri
In questa configurazione, ti consigliamo di creare i seguenti perimetri di servizio:
- Pipeline di dati: un perimetro attorno ai progetti della pipeline di dati deve applicare tutti i servizi che non devono ricevere dati dei tenant.
- Dati del tenant: un perimetro attorno al progetto del set di dati del tenant e attorno ai progetti di computing BigQuery del tenant. Applica tutti i servizi per impedire l'accesso dall'esterno dell'organizzazione.
- Applicazioni interne: applica tutti i servizi e utilizza i livelli di accesso per concedere l'accesso alle risorse ai team dei reparti.
- Applicazioni esterne: un perimetro intorno alle tue applicazioni SaaS. Applica tutti i servizi non necessari per il funzionamento delle applicazioni.
Bridge del perimetro
In questa configurazione, ti consigliamo di creare i seguenti bridge del perimetro:
- Pipeline di dati e dati del tenant: consente alla pipeline di scrivere dati nei set di dati del tenant.
- Pipeline di dati e applicazioni interne: consenti alla pipeline di scrivere dati nel set di dati inter-cliente.
- Applicazioni esterne e dati dei tenant: consenti alle applicazioni rivolte all'esterno di eseguire query sui dati dei tenant.
- Applicazioni esterne e applicazioni interne: consenti alle applicazioni rivolte all'esterno di elaborare i dati utilizzando i modelli sviluppati e distribuiti dalle applicazioni interne.
Fornitore SaaS con infrastruttura tenant dedicata
In scenari più complessi, i fornitori SaaS potrebbero eseguire il deployment di un'infrastruttura di computing dedicata per ogni tenant. In questo scenario, l'infrastruttura dedicata è responsabile della gestione delle richieste di dati dei tenant all'interno di BigQuery.
Un design dell'infrastruttura tenant dedicato affronta i seguenti problemi comuni durante il deployment dell'infrastruttura per ogni tenant insieme a BigQuery:
- Responsabilità della fatturazione: monitoraggio dei costi dell'infrastruttura associati a ogni tenant di cui è stato eseguito l'onboarding.
- Latenza end-to-end: il livello di aggiornamento del datastore sia per i tenant sia per le soluzioni di analisi cross-customer.
- Aspettative di rendimento: garantire che le prestazioni del tenant rimangano entro limiti accettabili.
Colloca i set di dati con risorse dedicate
Quando esegui il deployment dell'infrastruttura del tenant dedicato, ti consigliamo di creare una cartella principale per i progetti specifici del tenant. Quindi, colloca i set di dati BigQuery del tenant in progetti con le risorse dedicate che accedono ai dati per conto del tenant. Per ridurre al minimo la latenza end-to-end per i dati dei tenant, le pipeline Dataflow inseriscono i dati direttamente nei set di dati dei tenant.
Questo design gestisce l'elaborazione e la distribuzione dei dati upstream, in modo simile al design dell'infrastruttura condivisa precedente. Tuttavia, i dati dei tenant e le applicazioni che accedono ai dati dei tenant sono organizzati in progetti specifici per i tenant (e, facoltativamente, in cartelle dedicate ai tenant) per semplificare la fatturazione e la gestione delle risorse. Il seguente diagramma mostra un esempio di configurazione di un progetto basato su questo design consigliato:
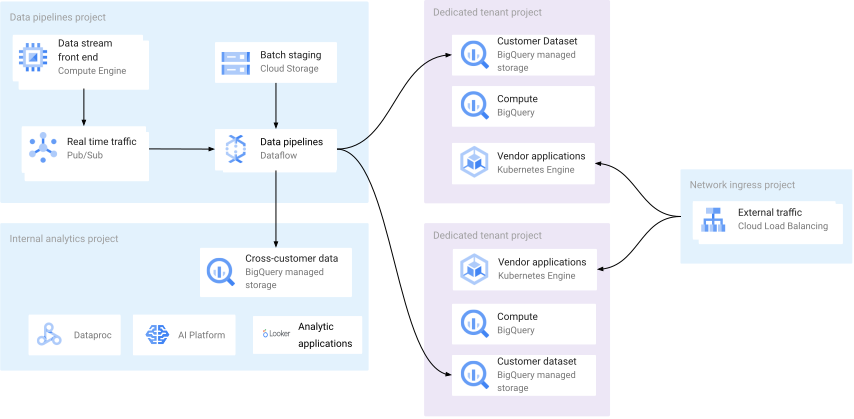
Figura 2. Un progetto di pipeline di dati gestisce i dati di un singolo tenant da diversi altri progetti.
La configurazione del progetto nella figura 2 include i seguenti progetti:
- Progetto di pipeline di dati: i componenti dell'infrastruttura di base che ricevono, elaborano e distribuiscono i dati dei tenant sono tutti pacchettizzati in un unico progetto.
- Progetti tenant dedicati: progetti che contengono tutte le risorse cloud dedicate a un singolo tenant, inclusi i set di dati BigQuery. Ti consigliamo di utilizzare Identity and Access Management (IAM) per limitare notevolmente l'ambito degli account e dei service account che possono accedere ai set di dati dei clienti.
- Progetti di analisi interni: progetti che rappresentano le risorse autogestite utilizzate dai team di analisi per valutare i dati dei tenant e creare nuove funzionalità.
- Progetto di networking esterno: progetto che gestisce e instrada le richieste dei tenant ai backend dedicati.
Condividi le prenotazioni
Le prenotazioni in questo approccio si basano sull'algoritmo di pianificazione equa integrato nelle prenotazioni di BigQuery. In questa configurazione, le prenotazioni del livello di computing vengono assegnate a ogni progetto tenant che utilizza quel livello. Se un tenant ha requisiti di tempistica specifici, puoi creare una prenotazione dedicata per fornire un numero preciso di slot a un progetto tenant.
Utilizza i controlli IAM e disabilita la creazione delle chiavi
I perimetri dei Controlli di servizio VPC potrebbero non essere appropriati per questo scenario. I limiti relativi ai progetti impediscono a un'organizzazione di utilizzare i confini del perimetro attorno ai progetti che interagiscono con i progetti tenant. Ti consigliamo invece di utilizzare controlli IAM rigorosi e di disattivare la creazione delle chiavi per proteggerti da accessi esterni indesiderati.
Data mart con autorità centrale
I data mart sono un tema di progettazione comune in cui i dati di analisi principali vengono archiviati in un repository centrale e i sottoinsiemi vengono condivisi tra le linee di business. I data mart hanno spesso decine o centinaia di tenant, rappresentati come linee di business da considerare.
Un design di data mart in BigQuery soddisfa le seguenti esigenze:
- Collaborazione sicura sui dati: condivisione dei dati con controlli tecnici per ridurre al minimo l'accesso inappropriato tra i team.
- Governance dei dati centralizzata: garantire che gli asset di dati principali utilizzati per i report aziendali critici siano standardizzati e convalidati.
- Attribuzione dei costi delle unità aziendali: monitoraggio e aggiustamento dell'utilizzo del computing da parte delle unità aziendali.
Utilizza un repository amministrato centralmente
In questo design, i dati principali vengono acquisiti in un repository gestito centralmente. Le viste autorizzate, le funzioni definite dall'utente (UDF) autorizzate e le policy delle colonne vengono spesso utilizzate insieme per condividere i dati con le linee di business, impedendo al contempo la distribuzione accidentale di dati sensibili.
I team nei progetti tenant possono accedere ai set di dati gestiti centralmente in base alle autorizzazioni del loro account. I team utilizzano gli slot allocati ai propri progetti per creare report e set di dati derivati. Il team dei dati principali utilizza le viste autorizzate per mantenere la piena proprietà del controllo dell'accesso agli asset del data mart. In questa configurazione, ti consigliamo di evitare di creare più livelli di visualizzazioni sugli oggetti presentati dal progetto di dati principali. Il seguente diagramma mostra un esempio di configurazione del progetto basata su questo design consigliato:
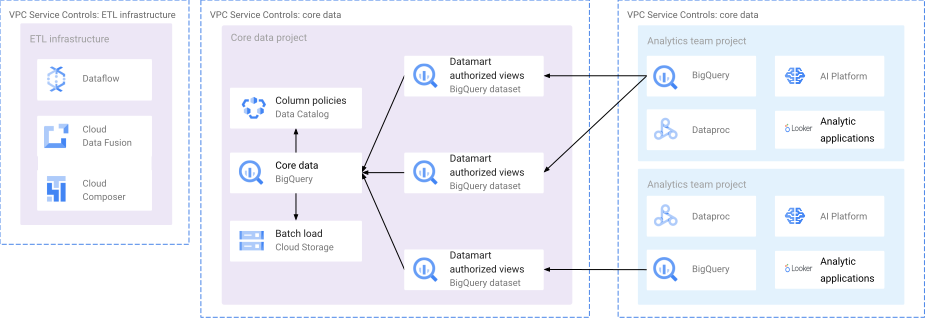
Figura 3. Un progetto di dati di base gestisce un data mart centralizzato accessibile da tutta l'organizzazione.
La configurazione del progetto nella figura 3 include i seguenti progetti:
- Progetto di dati principali: il perimetro di governance per la gestione dell'accesso ai dati principali e alle visualizzazioni del data mart. Mantieni le viste autorizzate all'interno dei set di dati di questo progetto e concedi le viste autorizzate ai tuoi team di analisi in base all'appartenenza ai gruppi.
- Infrastruttura di estrazione, trasformazione e caricamento (ETL): infrastruttura per l'elaborazione delle origini dati upstream nei dati principali. A seconda delle esigenze di separazione amministrativa, puoi scegliere di eseguire il deployment dell'infrastruttura ETL come progetto autonomo o come parte del progetto di dati principale.
- Progetti del team di analisi: i consumer del data mart utilizzano questi progetti e l'accesso all'infrastruttura di cui è stato eseguito il provisioning per elaborare i dati all'interno del data mart. I progetti del team di analisi dovrebbero essere in grado di creare set di dati derivati per l'utilizzo locale.
Utilizza un design di prenotazione a due livelli
Quando lavori con i data mart, ti consigliamo di utilizzare un design a due livelli. In un design a due livelli, assegni alla risorsa organizzazione una prenotazione con un numero ridotto di slot per coprire l'utilizzo generale. Se i team hanno esigenze maggiori, assegna le prenotazioni a livello di progetto o cartella.
Configura i perimetri dei Controlli di servizio VPC
In questa configurazione, consigliamo i perimetri dei Controlli di servizio VPC per evitare l'esposizione accidentale dei set di dati BigQuery all'esterno della tua organizzazioneCloud de Confiance .
Perimetri
In questa configurazione, ti consigliamo di creare i seguenti perimetri di servizio:
- Dati principali: un perimetro per proteggere i set di dati del data warehouse e del data mart.
- Pipeline di dati: un perimetro per il progetto dell'infrastruttura ETL. Se le pipeline di dati devono effettuare richieste al di fuori della tua organizzazione Cloud de Confiance, ti consigliamo di separare questo perimetro dal perimetro dei dati principali.
- Analytics: un perimetro per creare ed eseguire il deployment di asset di analisi interni alla tua organizzazione. Questo perimetro dovrebbe avere una policy di accesso più permissiva rispetto al perimetro dei dati principali con cui è collegato.
Bridge del perimetro
In questa configurazione, ti consigliamo di creare i seguenti bridge del perimetro:
- Pipeline di dati e dati principali: consenti alle pipeline di dati di scrivere nel progetto di dati principali.
- Dati e analisi di base: consenti agli utenti dei progetti di analisi di eseguire query sulle viste autorizzate.
Copia i set di dati per le configurazioni multiregionali
Poiché BigQuery non consente query tra regioni, non puoi utilizzare la strategia di segmentazione dei dati con viste autorizzate quando i data mart devono esistere in più regioni. Puoi invece utilizzare BigQuery Data Transfer Service per copiare i set di dati pertinenti in un'altra regione. In questo scenario, crei policy delle colonne all'interno del catalogo dati per ogni regione aggiuntiva in cui si trovano i dati. Il seguente diagramma mostra una configurazione multiregionale:
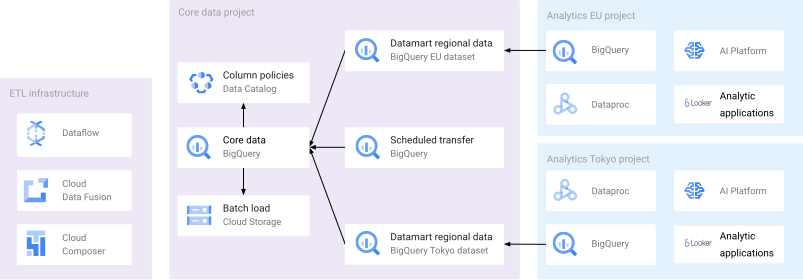
Immagine 4. Una configurazione multiregionale utilizza BigQuery Data Transfer Service per copiare i set di dati tra le regioni.
La configurazione del progetto nella figura 4 include i seguenti progetti.
- Progetto di dati principali: il perimetro di governance per la gestione dell'accesso ai dati principali e alle visualizzazioni del data mart. I dati vengono copiati e conservati in set di dati regionali che possono essere utilizzati dai team a livello globale.
- Infrastruttura ETL: infrastruttura per l'elaborazione delle origini dati upstream nei dati principali. A seconda delle esigenze di separazione amministrativa, puoi scegliere di eseguire il deployment dell'infrastruttura ETL come progetto autonomo o come parte del progetto di dati principale.
- Progetti del team di analisi: i consumer del data mart utilizzano questi progetti e la propria infrastruttura di cui è stato eseguito il provisioning per elaborare i dati all'interno dei set di dati regionali del data mart. I progetti del team di analisi dovrebbero essere in grado di creare set di dati derivati per l'uso locale.
BigQuery Data Transfer Service è un componente aggiuntivo pianificato con alcune limitazioni. Lo scheduler di servizi integrato è limitato a un intervallo di tempo minimo di 15 minuti e deve copiare tutte le tabelle dal set di dati di origine. Non è possibile incorporare script aggiuntivi per creare sottoinsiemi di dati specifici per regione nello scheduler di BigQuery Data Transfer Service.
Se la tua organizzazione ha bisogno di maggiore flessibilità, sono disponibili le seguenti opzioni:
- Job di Managed Service for Apache Airflow: puoi pianificare i job di Managed Service for Apache Airflow per emettere job ETL che creano sottoinsiemi regionali prima di attivare BigQuery Data Transfer Service tramite la sua API client. Se la tua organizzazione può supportare una latenza aggiuntiva, ti consigliamo questa opzione.
- Infrastruttura ETL: l'infrastruttura ETL, come Dataflow, può eseguire la doppia scrittura di sottoinsiemi regionali nelle regioni di destinazione. Se la tua organizzazione richiede una latenza dei dati minima tra le regioni, ti consigliamo questa opzione.
Data mart con autorità decentralizzata
Utilizza l'autorità decentralizzata quando hai bisogno di una separazione amministrativa per proprietario del sistema, linee di business o problemi geografici.
Un data mart decentralizzato presenta i seguenti problemi rispetto a un data mart standard:
- Collaborazione sicura sui dati: condivisione dei dati con controlli tecnici per ridurre al minimo l'accesso inappropriato tra i team.
- Rilevabilità dei dati: i team devono essere in grado di scoprire e richiedere l'accesso ai set di dati.
- Provenienza dei dati: senza un team di curatori centrale, i team devono essere in grado di fidarsi dell'origine dei dati che vengono inseriti nei loro prodotti di analisi.
Delega l'amministrazione dei dati principali
Questo design è diverso da un approccio convenzionale ai data mart perché l'autorità decentralizzata delega le decisioni principali di amministrazione dei dati ai sottogruppi dei componenti dell'organizzazione. Quando utilizzi l'autorità decentralizzata, mantieni il controllo centrale della sicurezza e della capacità di BigQuery utilizzando Cloud Key Management Service (Cloud KMS), policy delle colonne, Controlli di servizio VPC e prenotazioni. In questo modo, eviti la proliferazione dei dati, un problema comune nei data warehouse autogestiti. Il seguente diagramma mostra un'architettura che utilizza l'autorità decentralizzata:
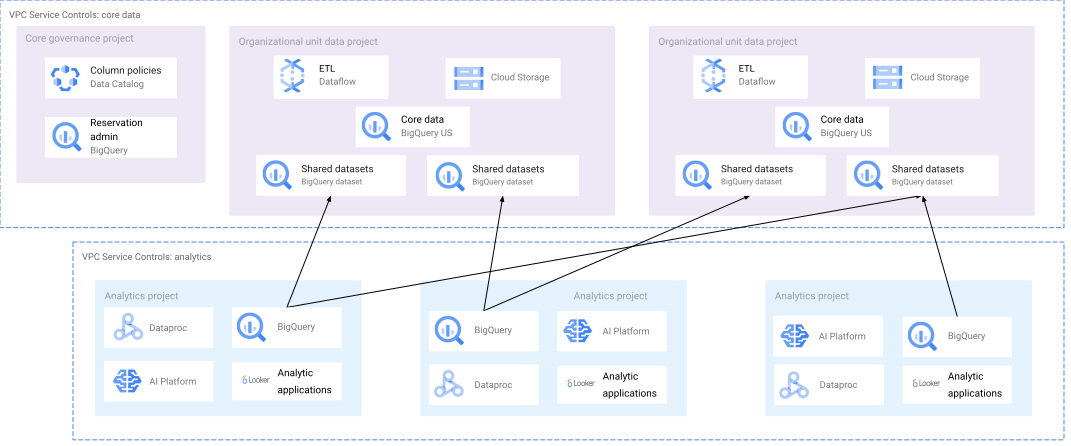
Figura 5. Un progetto di governance di base aiuta a garantire una sicurezza coerente, mentre i singoli gruppi mantengono le proprie operazioni sui dati.
La configurazione del progetto nella figura 5 include i seguenti progetti:
- Progetto di governance principale: il progetto responsabile delle questioni di gestione tra organizzazioni. In questo progetto, crei risorse di sicurezza come chiavi automatizzate Cloud KMS e policy delle colonne di Data Catalog. Questo progetto funge da progetto di amministrazione delle prenotazioni di BigQuery, consentendo la condivisione degli slot a livello di organizzazione.
- Progetti di dati delle unità organizzative: i proprietari dei data mart autogestiti all'interno dell'organizzazione più ampia. Il progetto di governance principale gestisce l'ambito limitato per i progetti di dati delle unità organizzative.
- Progetti del team di analisi: i progetti utilizzati dai consumer dei data mart. Questi progetti utilizzano l'infrastruttura e gli slot di cui è stato eseguito il provisioning per accedere ai dati ed elaborarli all'interno del data mart.
Utilizza un design di prenotazione a due livelli
Ti consigliamo di utilizzare per i tuoi data mart decentralizzati lo stesso design a due livelli dei data mart standard. In questa configurazione, assegni alla risorsa organizzazione una prenotazione con un numero ridotto di slot per coprire l'utilizzo generale. Se i team hanno esigenze maggiori, assegna le prenotazioni a livello di progetto o cartella.
Utilizza un catalogo dati
Un Data Catalog fornisce il rilevamento, il tagging dei metadati e la configurazione delle policy delle colonne a livello di organizzazione. Il rilevamento di Knowledge Catalog crea automaticamente voci di metadati per tutte le nuove tabelle BigQuery della tua organizzazione. Le funzionalità di Knowledge Catalog aiutano anche gli amministratori della governance dei dati a identificare rapidamente i nuovi asset di dati e ad applicare i controlli appropriati.
Configura i perimetri dei Controlli di servizio VPC
In questa configurazione, consigliamo i perimetri dei Controlli di servizio VPC per evitare l'esposizione accidentale dei set di dati BigQuery all'esterno della tua organizzazioneCloud de Confiance .
Perimetri
In questa configurazione, ti consigliamo di creare i seguenti perimetri di servizio:
- Dati principali: un perimetro per proteggere i set di dati del data warehouse e del data mart. Questo perimetro deve includere tutti i progetti delle unità organizzative e il progetto di governance dei dati.
- Analytics: un perimetro per creare ed eseguire il deployment degli asset di analisi interni all'organizzazione. Questo perimetro dovrebbe avere una policy di accesso più permissiva rispetto al perimetro dei dati principali con cui è collegato.
Bridge del perimetro
In questa configurazione, ti consigliamo di creare i seguenti bridge del perimetro:
- Dati e analisi di base: consenti agli utenti dei progetti di analisi di eseguire query sulle viste autorizzate.
Condivisione dei dati tra più organizzazioni
La condivisione tra più organizzazioni è una considerazione speciale per la progettazione di un data mart. Questo design di condivisione dei dati è destinato alle organizzazioni che vogliono condividere in modo sicuro i propri set di dati con un'altra entità che ha una propria organizzazione Google.
La condivisione dei dati tra più organizzazioni risponde alle seguenti preoccupazioni per chi condivide i dati:
- Riservatezza della condivisione: solo la parte prevista può accedere ai dati condivisi.
- Protezione da accessi inappropriati: solo le risorse a cui è previsto l'accesso possono essere accessibili esternamente.
- Separazione del computing: alle parti esterne vengono addebitate le query che avviano.
Proteggi i progetti interni dai progetti di dati condivisi
Il design della condivisione dei dati tra più organizzazioni si concentra sulla protezione dei progetti interni dell'organizzazione dalle attività nei progetti di dati condivisi. Il progetto del set di dati condiviso funge da buffer per impedire l'accesso al trattamento dati interno sensibile, fornendo al contempo la possibilità di condividere i dati esternamente.
Le query avviate dal progetto esterno utilizzano le risorse di computing del progetto chiamante. Se tutti i set di dati su cui viene eseguita la query condividono la stessa regione Cloud de Confiance, queste query possono unire i dati di più organizzazioni. Il seguente diagramma mostra come vengono condivisi i set di dati in una configurazione di progetto multiorganizzazione:
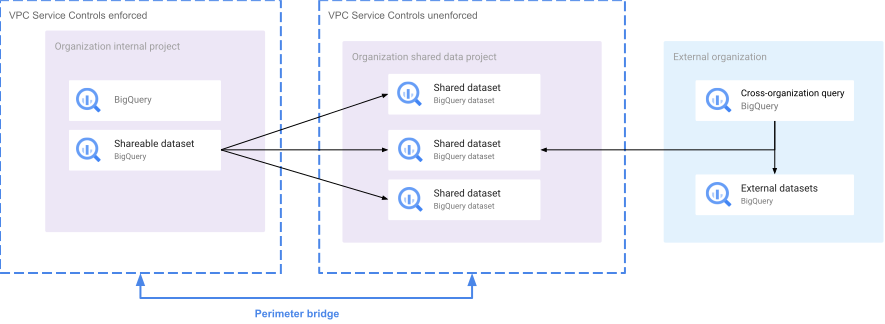
Immagine 6. Un'organizzazione esterna esegue query sui dati di più set di dati in progetti condivisi.
La configurazione del progetto nella figura 6 include i seguenti progetti:
- Progetto interno dell'organizzazione: il progetto che contiene dati interni sensibili. Il progetto interno può condividere i dati esternamente copiando i dati sanitizzati nei set di dati del progetto di dati condivisi. Il progetto interno deve essere proprietario del account di servizio responsabile dell'aggiornamento dei dati condivisi.
- Progetto di dati condivisi: il progetto che contiene le informazioni anonimizzate copiate dal progetto interno. Utilizza i gruppi di utenti esterni per gestire l'accesso da parte di soggetti esterni. In questo scenario, gestisci l'appartenenza ai gruppi come funzione amministrativa e concedi agli account esterni l'autorizzazione di visualizzatore in modo che possano accedere al set di dati tramite questi gruppi.
Configura i perimetri dei Controlli di servizio VPC
In questa configurazione, consigliamo i perimetri dei Controlli di servizio VPC per condividere i dati esternamente e impedire l'esposizione accidentale dei set di dati BigQuery al di fuori dei progetti interni.
Perimetri
In questa configurazione, ti consigliamo di creare i seguenti perimetri di servizio:
- Dati interni: un perimetro per proteggere gli asset di dati principali. I Controlli di servizio VPC applicano l'accesso a BigQuery.
- Dati condivisi esternamente: un perimetro per ospitare set di dati che possono essere condivisi con organizzazioni esterne. Questo perimetro disattiva l'applicazione dell'accesso a BigQuery.
Bridge del perimetro
In questa configurazione, ti consigliamo di creare il seguente bridge del perimetro:
- Dati da interni a esterni: un bridge del perimetro consente ai progetti di dati interni più protetti di trasferire i dati in uscita ai progetti di condivisione dei dati esterni.
Considerazioni aggiuntive sui sistemi multi-tenant
Questa sezione fornisce un'analisi più approfondita dei casi speciali che puoi prendere in considerazione insieme alle best practice precedenti.
Limiti e quote delle risorseCloud de Confiance
- I service account sono limitati a una quota flessibile di 100 service account per progetto. Puoi richiedere la quota tramite la console Cloud de Confiance per i progetti che gestiscono i service account tenant.
- La concorrenza di BigQuery ha una concorrenza predefinita di 100 query per progetto che genera query (i progetti che contengono set di dati non hanno questi limiti). Per aumentare questa quota flessibile, contatta il tuo rappresentante di vendita.
- I Controlli di servizio VPC hanno un limite di 10.000 progetti all'interno dei perimetri di servizio a livello di organizzazione. Se i tuoi design con un progetto per tenant hanno uno scale up elevato, ti consigliamo di utilizzare un design con un set di dati per tenant.
- I Controlli di servizio VPC hanno un limite di 100 perimetri, inclusi i bridge, per organizzazione.
Utilizzo di viste autorizzate o tabelle di sottoinsiemi materializzati
Per gestire l'accesso dei tenant a sottoinsiemi di tabelle dei fatti di grandi dimensioni, puoi utilizzare viste autorizzate specifiche per i tenant o creare tabelle di sottoinsiemi specifiche per i tenant. La tabella seguente fornisce un confronto di questi approcci:
| Funzionalità | Visualizzazioni autorizzate | Tabelle di sottoinsieme |
|---|---|---|
| Numero di tenant supportati | Esiste un limite massimo di 2500 risorse autorizzate per set di dati. | Le risorse autorizzate includono viste autorizzate, set di dati autorizzati e funzioni autorizzate.Non esistono limiti al numero di set di dati in un progetto o di tabelle in un set di dati. |
| Partizionamento e clustering |
Le viste autorizzate devono condividere lo schema di partizionamento e cluster comune della tabella di base. Per migliorare le prestazioni della segmentazione dei tenant, ti consigliamo di raggruppare la tabella principale in base all'ID tenant. |
Puoi partizionare la tabella del sottoinsieme e raggrupparla in base alle esigenze del tenant. |
| Aree geografiche | Le viste autorizzate non possono essere trasversali alle regioni e devono trovarsi nella regione Cloud de Confiance della tabella di base. La regionalizzazione influisce sui tenant geograficamente remoti. | Le tabelle di sottoinsieme possono esistere nella regione più appropriata per il tenant. Potrebbero essere applicati costi aggiuntivi. |
| Applicazione delle policy delle colonne | Le policy delle colonne applicate a una tabella di base vengono applicate a tutte le viste autorizzate, indipendentemente dalle autorizzazioni su queste viste. | Perché la policy delle colonne venga applicata, deve essere applicata a ogni tabella del sottoinsieme. |
| Logging dell'accesso ai dati | I log di accesso ai dati vengono riflessi nel logging della tabella di base. | L'accesso a ogni tabella di sottoinsieme viene registrato separatamente. |
| Flessibilità di trasformazione | Le viste autorizzate consentono di riprogettare istantaneamente l'oggetto a cui accedono i tenant. | Per modificare le tabelle dei sottoinsiemi sono necessarie modifiche complesse allo schema. |
Controllo dei dati sensibili
Per impedire l'accesso non autorizzato ai dati, BigQuery offre diverse funzionalità aggiuntive oltre alle autorizzazioni IAM standard.
Crittografia fornita dal client
La crittografia dei dati del client copre i casi in cui un'organizzazione di hosting archivia ed elabora i dati per conto di un tenant, ma non può accedere ad alcuni contenuti dei dati. Ad esempio, all'organizzazione di hosting potrebbe essere impedito di accedere ai dati personali o del dispositivo considerati sensibili.
Consigliamo al mittente dei dati di utilizzare le chiavi di crittografia AEAD della libreria Tink open source per criptare i dati sensibili. Le chiavi di crittografia AEAD della libreria Tink sono compatibili con le funzioni AEAD di BigQuery. Il tenant può quindi decriptare i dati accedendo al materiale della chiave in una UDF autorizzata o passando il materiale della chiave come parametro di query a BigQuery, dove l'organizzazione host non può registrare la chiave.
Policy di accesso alle colonne
Nei data mart multi-tenant, le policy delle colonne vengono spesso utilizzate per impedire la fuga accidentale di contenuti sensibili tra i team che collaborano. Le viste autorizzate sono il meccanismo preferito per condividere i dati tra i team in uno scenario di data mart. Le viste autorizzate non possono concedere l'accesso a una colonna protetta.
Quando imposti la policy per applicare controllo dell'accesso, impedisci l'accesso agli utenti a cui non è stato concesso il ruolo di lettore granulare per la policy. Anche quando la policy non viene applicata, registra tutti gli accessi degli utenti alla colonna categorizzata.
Sensitive Data Protection
Sensitive Data Protection fornisce API e utilità di scansione che ti aiutano a identificare e mitigare i contenuti sensibili archiviati nei set di dati BigQuery o Cloud Storage. Le organizzazioni in scenari multi-tenant utilizzano spesso l'API DLP (parte di Sensitive Data Protection) per identificare e, facoltativamente, tokenizzare i dati sensibili prima che vengano archiviati.
Gestione delle prenotazioni di slot
La gestione delle prenotazioni nei sistemi multi-tenant aiuta a controllare i costi man mano che i tenant scalano e garantisce le prestazioni per ogni tenant.
Per gestire le prenotazioni, ti consigliamo di creare un unico progetto amministrativo per le prenotazioni. Gli impegni slot acquistati nello stesso progetto amministrativo sono condivisibili tra tutte le prenotazioni che hanno origine dal progetto amministrativo. Un progetto che utilizza impegni di slot può essere assegnato a una sola prenotazione alla volta. Tutte le query che provengono da un progetto condividono gli slot in base alle risorse disponibili.
Per assicurarti che gli obiettivi del livello di servizio (SLO) dei tenant vengano soddisfatti, puoi monitorare le prenotazioni tramite Cloud Logging e l'information schema di BigQuery. Le organizzazioni che registrano periodi di intensa attività degli analisti o di job prioritari possono allocare capacità aggiuntiva utilizzando gli slot flessibili.
Prenotazioni come livelli di computing del tenant
I fornitori SaaS che hanno da decine a molte migliaia di tenant configurano comunemente un numero finito di prenotazioni BigQuery come risorse condivise.
Se sei un fornitore SaaS con un'infrastruttura tenant condivisa, ti consigliamo di dedicare ogni prenotazione a un singolo progetto e di raggruppare i tenant per condividere il progetto per il computing BigQuery. Questo design riduce l'overhead amministrativo di migliaia di progetti e prenotazioni aggiuntivi, consentendo al contempo alla tua organizzazione di allocare una capacità slot minima necessaria per soddisfare le esigenze di prestazioni previste per la prenotazione.
Se la tempestività del trattamento dati ELT è una priorità assoluta, ti consigliamo di allocare una prenotazione per gestire l'elaborazione. Per evitare di utilizzare slot aggiuntivi che potrebbero essere utilizzati per workload ad hoc, imposta la prenotazione in modo da ignorare gli slot inattivi.
Di seguito è riportato un esempio di come configurare le prenotazioni come livelli di computing dei tenant:
- Trattamento dati: 2000 slot, ignora inattivi. Questa prenotazione è configurata per soddisfare gli SLO di trattamento dati.
- Progetti interni: 1000 slot, consenti inattività. Questa prenotazione viene applicata ai progetti utilizzati per l'analisi interna.Gli slot vengono riutilizzati se non vengono utilizzati dai livelli di trattamento dati o di calcolo.
- Livello di calcolo basso: 2000 slot, ignora l'inattività. Questa prenotazione viene applicata ai tenant con risorse limitate. A differenza del livello alto, questa prenotazione ignora gli slot inattivi.
- Livello di computing elevato: 3000 slot, consente l'inattività. Questa prenotazione viene applicata ai tenant a cui vengono assegnate risorse elevate. Per velocizzare le query, vengono applicati automaticamente gli slot inattivi di altre prenotazioni.
Se i tuoi tenant operano su un'infrastruttura dedicata, ti consigliamo di assegnare la cartella o il progetto designato alla prenotazione condivisa appropriata.
Prenotazioni per team
Quando lavori con i team in un ambiente di data mart, ti consigliamo di creare una prenotazione per ogni team che richiede risorse di computing aggiuntive. Quindi, assegna la prenotazione alla cartella principale che contiene i progetti del team. Tutti i nuovi progetti di quel team utilizzano gli slot di pianificazione equa della stessa allocazione di risorse.
Di seguito è riportato un esempio di come configurare le prenotazioni per team:
- Prenotazione a livello di organizzazione: 500 slot, consenti inattività. Questa prenotazione viene assegnata all'organizzazione di primo livello e fornisce slot a qualsiasi utente BigQuery che non utilizza un progetto con una prenotazione dedicata
- Trattamento dati: 1000 slot, ignora inattivi. Questa prenotazione è configurata per soddisfare gli SLO minimi di trattamento dati.
- Amministrazione dei dati principali: 500 slot, consente l'inattività. Questa prenotazione viene applicata ai progetti utilizzati per l'amministrazione interna. Gli slot vengono riutilizzati se avanzano dai livelli di trattamento dati o di computing.
- Prenotazioni di elaborazione di Analytics: 500 slot, consenti inattività. Si tratta di una prenotazione dedicata assegnata a un team di analisi.
Requisiti di hosting multiregionale
I requisiti di hosting multiregionale sono in genere il risultato della necessità di ridurre la latenza dei dati per i consumatori o di soddisfare i requisiti normativi.
I progetti in Cloud de Confiance sono considerati globali e possono eseguire il provisioning delle risorse in qualsiasi regione. BigQuery considera i set di dati, le policy delle colonne e gli impegni degli slot come risorse regionali. Gli slot possono accedere solo ai set di dati nella regione locale e le policy delle colonne possono essere applicate solo alle tabelle all'interno dei set di dati locali. Per utilizzare i prezzi basati sulla capacità, devi acquistare slot in ogni regione che contiene set di dati.
Per indicazioni su come rispettare i requisiti normativi, consulta il tuo rappresentante di vendita.
Passaggi successivi
- Scopri le best practice per IAM.