

המסמך הזה מיועד למפתחי תוכנה ולאדמינים של מסדי נתונים שרוצים להעביר אפליקציות קיימות או לתכנן אפליקציות חדשות לשימוש עם Bigtable כמסד נתונים. במאמר הזה נתבסס על הידע שלכם ב-Apache Cassandra כדי להסביר מושגים שחשוב להבין לפני המעבר ל-Bigtable. במאמר מעבר מ-Cassandra ל-Bigtable מפורטים כלים בקוד פתוח שבהם אפשר להשתמש כדי להשלים את המעבר.
Bigtable ו-Cassandra הם מסדי נתונים מבוזרים. הם מטמיעים מאגרי מפתח/ערך רב-ממדיים שיכולים לתמוך בעשרות אלפי שאילתות לשנייה (QPS), בקריאות ובכתיבות עם זמן אחזור קצר, באחסון שניתן להרחבה עד לפטה-בייטים של נתונים ובסבילות לכשל בצומת.
מתי Bigtable הוא יעד טוב לעומסי עבודה של Cassandra
השירות של Cloud de Confiance by S3NS שהכי מתאים לעומס העבודה של Cassandra תלוי ביעדי ההעברה ובפונקציונליות של Cassandra שאתם צריכים אחרי ההעברה.
אם אחד או יותר מהתנאים הבאים מתקיימים, Bigtable הוא הפתרון האופטימלי:
- אתם רוצים שירות שמנוהל במלואו, בלי חלונות זמן לתחזוקה ועם זמינות גבוהה.
- אתם צריכים התאמה גמישה לעומס (elastic scaling) שמגיבה באופן אוטומטי לשינויים בתנועה בשרת.
- אתם צריכים זמן אחזור עקבי של קריאות וכתיבות, שנמדד בספרה אחת של אלפיות השנייה.
- אתם משתמשים בסוגי אוספים, במונים או בתצוגות מהותיות של Cassandra, בנוסף לסוגים סקלריים ש-Bigtable מותאם להם.
- יש לכם אפליקציה שמשתמשת בפרמטר
USING TIMESTAMP. - קצב העברת הנתונים וזמן האחזור של הכתיבה חשובים לא פחות מאלה של הקריאה.
- אתם מסתמכים על אחד ממודלי הרפליקציה של Cassandra, שמתבססים על מודל עקביות הדרגתי.
- בתרחיש לדוגמה שלכם נדרש אחסון משתלם.
כדי להעביר אפליקציות בלי לשנות את הקוד, אתם יכולים לנהל בעצמכם את Cassandra ב-GKE או להשתמש ב Cloud de Confianceשותף כמו DataStax או ScyllaDB. אם האפליקציה שלכם מתמקדת בקריאה ואתם מוכנים לארגן את הקוד מחדש כדי לקבל יכולות של מסד נתונים רלציוני ומודל עקביות חזק, כדאי לשקול את Spanner.
במאמר הזה נסביר מה כדאי להביא בחשבון כשמשנים את מבנה הקוד של האפליקציה, אם בוחרים ב-Bigtable כיעד להעברת עומסי העבודה של Cassandra.
איך להשתמש במסמך הזה
לא צריך לקרוא את המסמך הזה מההתחלה ועד הסוף. למרות שהמסמך הזה מספק השוואה בין שני מסדי הנתונים, אתם יכולים גם להתמקד בנושאים שרלוונטיים לתרחיש לדוגמה או לתחומי העניין שלכם.
כדי לעזור לכם להשוות בין Bigtable ל-Cassandra, במאמר הזה:
- השוואה בין המונחים, שיכולים להיות שונים בין שני מסדי הנתונים.
- סקירה כללית של שתי מערכות מסדי הנתונים.
- בחינה של האופן שבו כל מסד נתונים מטפל במודלים של נתונים, כדי להבין שיקולי תכנון שונים.
- השוואה בין הנתיב של הנתונים במהלך כתיבה וקריאה.
- בדיקת הפריסה הפיזית של הנתונים כדי להבין היבטים של ארכיטקטורת מסד הנתונים.
- איך להגדיר שכפול גיאוגרפי בהתאם לדרישות שלכם, ואיך לגשת לקביעת גודל האשכול.
- סקירת פרטים על ניהול, מעקב ואבטחה של אשכולות.
השוואת מינוחים
למרות שרבים מהמושגים שמשמשים ב-Bigtable וב-Cassandra דומים, לכל מסד נתונים יש מוסכמות שמות שונות במקצת והבדלים קלים.
אחת מאבני הבניין העיקריות של שני מסדי הנתונים היא טבלת המחרוזות הממוינות (SSTable). בשתי הארכיטקטורות, טבלאות SSTable נוצרות כדי לשמור נתונים שמשמשים למענה על שאילתות קריאה.
בפוסט בבלוג (2012), איליה גריגוריק כותב: "SSTable הוא הפשטה פשוטה לאחסון יעיל של מספרים גדולים של צמדי מפתח/ערך, תוך אופטימיזציה של עומסי עבודה של קריאה או כתיבה רציפה עם תפוקה גבוהה".
בטבלה הבאה מפורטים ומתוארים מושגים משותפים והמונחים התואמים שבהם משתמשים בכל מוצר:
| Cassandra | Bigtable |
|---|---|
|
מפתח ראשי: ערך ייחודי של שדה אחד או כמה שדות שקובע את המיקום והסדר של הנתונים. מפתח מחיצה: ערך של שדה יחיד או של כמה שדות שקובע את מיקום הנתונים לפי גיבוב עקבי (consistent hash). עמודת אשכולות: ערך של שדה אחד או של כמה שדות שקובע את מיון הנתונים הלקסיקוגרפי בתוך מחיצה. |
מפתח שורה: מחרוזת בייטים ייחודית אחת שקובעת את מיקום הנתונים לפי מיון לקסיקוגרפי. כדי לחקות מפתחות מורכבים, אפשר לאחד את הנתונים של כמה עמודות באמצעות תו מפריד משותף, כמו סולמית (#) או אחוז (%). |
| צומת: מכונה שאחראית על קריאה וכתיבה של נתונים שמשויכים לסדרה של טווחי גיבוב (hash) של מחיצות מפתח ראשי. ב-Cassandra, הנתונים מאוחסנים באחסון ברמת הבלוק שמחובר לשרת הצומת. | צומת: משאב מחשוב וירטואלי שאחראי על קריאה וכתיבה של נתונים שמשויכים לסדרה של טווחי מפתחות שורות. ב-Bigtable, הנתונים לא נמצאים באותו מיקום כמו צומתי המחשוב. במקום זאת, הוא מאוחסן ב-Colossus, מערכת הקבצים המבוזרת של Google. הצמתים מקבלים אחריות זמנית על הצגת טווחים שונים של נתונים, בהתאם לעומס הפעולות ולתקינות של צמתים אחרים באשכול. |
|
מרכז נתונים: דומה לאשכול Bigtable, אבל ב-Cassandra אפשר להגדיר היבטים מסוימים של הטופולוגיה ואסטרטגיית הרפליקציה. rack: קבוצה של צמתים במרכז נתונים שמשפיעה על מיקום הרפליקה. |
אשכול: קבוצת צמתים באותו אזור גיאוגרפי, שממוקמים יחד כדי לטפל בבעיות של זמן אחזור ושכפול.Cloud de Confiance by S3NS |
| cluster: פריסת Cassandra שמורכבת מאוסף של מרכזי נתונים. | מכונה: קבוצה של אשכולות Bigtable באזורים שונים ( Cloud de Confiance zones או regions) שביניהם מתרחשים שכפול וניתוב חיבורים. |
| vnode: טווח קבוע של ערכי גיבוב (hash) שמוקצים לצומת פיזי ספציפי. הנתונים ב-vnode מאוחסנים פיזית בצומת Cassandra בסדרה של SSTables. | tablet: טבלת SSTable שמכילה את כל הנתונים של טווח רציף של מפתחות שורות שממוינים לפי סדר לקסיקוגרפי. הטבלאות לא מאוחסנות בצמתים ב-Bigtable, אלא בסדרה של טבלאות SSTable ב-Colossus. |
| גורם שכפול: מספר הרפליקות של vnode שנשמרות בכל הצמתים במרכז הנתונים. גורם השכפול מוגדר בנפרד לכל מרכז נתונים. | רפליקציה: התהליך שבו הנתונים שמאוחסנים ב-Bigtable משוכפלים לכל האשכולות במכונה. שכבת האחסון של Colossus מטפלת ברפליקציה בתוך אשכול אזורי. |
| טבלה (לשעבר קבוצת עמודות): ארגון לוגי של ערכים שנוספו לאינדקס לפי המפתח הראשי הייחודי. | טבלה: ארגון לוגי של ערכים שנוספו לאינדקס לפי מפתח השורה הייחודי. |
| keyspace: מרחב שמות לוגי של טבלה שמגדיר את פקטור הרפליקציה של הטבלאות שהוא מכיל. | לא רלוונטי. Bigtable מטפל בבעיות של מרחב מפתחות באופן שקוף. |
| map: סוג אוסף של Cassandra שמכיל צמדי מפתח/ערך. | משפחת עמודות: מרחב שמות שצוין על ידי המשתמש, שמקבץ מגדירי עמודות לקריאה וכתיבה יעילות יותר. כששולחים שאילתות ל-Bigtable באמצעות SQL, קבוצות העמודות מטופלות כמו מפות של Cassandra. |
| map key: מפתח שמזהה באופן ייחודי רשומת מפתח/ערך במפה של Cassandra | מגדיר העמודה: תווית לערך שמאוחסן בטבלה, שנוסף לאינדקס לפי מפתח השורה הייחודי. כששולחים שאילתות ל-Bigtable באמצעות SQL, העמודות מטופלות כמו מפתחות של מפה. |
| עמודה: התווית של ערך שמאוחסן בטבלה, שנוסף לאינדקס לפי המפתח הראשי הייחודי. | column: התווית של ערך שמאוחסן בטבלה, שנוסף לאינדקס לפי מפתח השורה הייחודי. שם העמודה מורכב משילוב של קבוצת העמודות עם מגדיר העמודה. |
| תא: ערך של חותמת זמן בטבלה שמשויך להצטלבות של מפתח ראשי עם העמודה. | תא: ערך של חותמת זמן בטבלה שמשויך להצטלבות של מפתח שורה עם שם העמודה. אפשר לאחסן ולאחזר כמה גרסאות עם חותמות זמן לכל תא. |
| counter: סוג שדה שניתן להגדלה, שמותאם לפעולות של סכום מספרים שלמים. | מונים: תאים שמשתמשים בסוגי נתונים מיוחדים לפעולות של סכום מספרים שלמים. מידע נוסף זמין במאמר יצירה ועדכון של מונים. |
| מדיניות איזון עומסים: מדיניות שמגדירים בלוגיקה של האפליקציה כדי לנתב פעולות לצומת מתאים באשכול. המדיניות מביאה בחשבון את הטופולוגיה של מרכז הנתונים ואת טווחי הטוקנים של vnode. | פרופיל אפליקציה: הגדרות שמורות ל-Bigtable איך לנתב קריאה ל-API של לקוח לאשכול המתאים במכונה. אפשר גם להשתמש בפרופיל האפליקציה כתג לפילוח מדדים. אתם מגדירים את פרופיל האפליקציה בשירות. |
| CQL: Cassandra Query Language, שפה שדומה ל-SQL ומשמשת ליצירת טבלאות, לשינויים בסכימה, למוטציות של שורות ולשאילתות. | Cassandra to Bigtable client for Java הוא תחליף חלק למנהלי ההתקנים של Cassandra. לקוח Java מבין את שאילתות ה-CQL שלכם, ומאפשר לכם להשתמש ב-Bigtable באופן שקוף עם האפליקציה הקיימת שמבוססת על Cassandra, בלי לשכתב את הקוד. מתאם הפרוקסי של Cassandra ל-Bigtable הוא שכבה נפרדת שאפשר להריץ במקביל לאפליקציה, ולחבר ל-Bigtable כצומת נוסף של Cassandra. מתאם ה-proxy מספק תאימות ל-CQL ותומך בהעברות בכתיבה כפולה ובכמות גדולה. הפונקציונליות הזו דומה למה שמציע הלקוח Cassandra to Bigtable ל-Java. ממשקי ה-API של Bigtable הם ספריות הלקוח וממשקי ה-API של gRPC שמשמשים ליצירת מכונות ואשכולות, ליצירת טבלאות וקבוצות עמודות, למוטציות של שורות ולהרצת שאילתות. SQL API של Bigtable מוכר למשתמשי CQL. |
תצוגה מהותית: הצהרת SELECT שמגדירה קבוצת שורות שתואמת לשורות בטבלת מקור בסיסית. כשטבלת המקור משתנה, Cassandra מעדכנת את התצוגה המהותית באופן אוטומטי.
|
תצוגה מהותית רציפה: תוצאה מנוהלת באופן מלא ומחושבת מראש של שאילתת SQL, שמתעדכנת באופן מצטבר ואוטומטי מטבלת מקור. מידע נוסף זמין במאמר תצוגות מהותיות רציפות. |
סקירות כלליות של מוצרים
בקטעים הבאים מופיעה סקירה כללית של פילוסופיית העיצוב והמאפיינים העיקריים של Bigtable ו-Cassandra.
Bigtable
ב-Bigtable יש הרבה מהתכונות העיקריות שמתוארות במאמר Bigtable: A Distributed Storage System for Structured Data. ב-Bigtable יש הפרדה בין צומתי המחשוב, שמטפלים בבקשות של הלקוחות, לבין ניהול האחסון הבסיסי. הנתונים מאוחסנים ב-Colossus. שכבת האחסון משכפלת את הנתונים באופן אוטומטי כדי לספק עמידות גבוהה יותר מזו שמספק שכפול תלת-כיווני רגיל של מערכת הקבצים המבוזרת של Hadoop (HDFS).
הארכיטקטורה הזו מספקת קריאות וכתיבות עקביות בתוך אשכול, מגדילה ומקטינה את קנה המידה ללא עלות של חלוקה מחדש של האחסון, ויכולה לאזן מחדש את עומסי העבודה בלי לשנות את האשכול או הסכימה. אם צומת עיבוד נתונים כלשהו נפגע, שירות Bigtable מחליף אותו באופן שקוף. Bigtable תומך גם ברפליקציה אסינכרונית.
בנוסף ל-gRPC ולספריות לקוח בשפות תכנות שונות, Bigtable תואם לספריית הלקוח של HBase ב-Java, שהיא הטמעה חלופית של מנוע מסד נתונים בקוד פתוח של Apache למאמר על Bigtable.
בתרשים הבא אפשר לראות איך Bigtable מפריד פיזית בין צומתי העיבוד לבין שכבת האחסון:
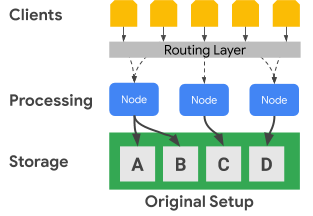
בתרשים הקודם, צומת העיבוד האמצעי אחראי רק על הצגת בקשות הנתונים של מערך הנתונים C בשכבת האחסון. אם Bigtable מזהה שנדרש איזון מחדש של הקצאת הטווחים של מערך נתונים, קל לשנות את טווחי הנתונים של צומת עיבוד כי שכבת האחסון מופרדת משכבת העיבוד.
התרשים הבא מציג, במונחים פשוטים, איזון מחדש של טווח מפתחות ושינוי גודל של אשכול:
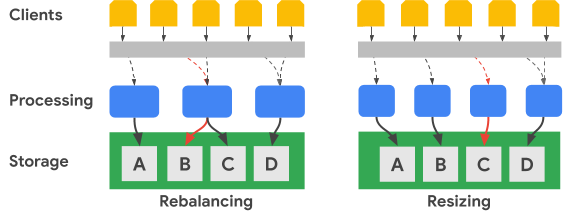
התמונה Rebalancing ממחישה את המצב של אשכול Bigtable אחרי שצומת העיבוד השמאלי ביותר מקבל מספר גדול יותר של בקשות לקבוצת הנתונים A. אחרי האיזון מחדש, הצומת האמצעי, במקום הצומת השמאלי ביותר, אחראי על הטיפול בבקשות הנתונים של מערך הנתונים B. הצומת השמאלי ביותר ממשיך לטפל בבקשות של מערך הנתונים A.
Bigtable יכול לסדר מחדש את טווחי מפתחות השורות כדי לאזן את טווחי מערכי הנתונים בין מספר גדול יותר של צומתי עיבוד זמינים. בתמונה Resizing מוצג המצב של אשכול Bigtable אחרי שמוסיפים צומת.
Cassandra
Apache Cassandra הוא מסד נתונים בקוד פתוח שמושפע באופן חלקי מרעיונות שמופיעים במאמר על Bigtable. היא משתמשת בארכיטקטורת צמתים מבוזרת, שבה האחסון ממוקם באותו מקום כמו השרתים שמגיבים לפעולות בנתונים. סדרה של צמתים וירטואליים (vnodes) מוקצים באופן אקראי לכל שרת כדי לשרת חלק ממרחב המפתחות של האשכול.
הנתונים מאוחסנים בצמתים הווירטואליים על סמך מפתח המחיצה. בדרך כלל, פונקציית גיבוב עקבי (consistent hashing) משמשת ליצירת אסימון כדי לקבוע את מיקום הנתונים. כמו ב-Bigtable, אפשר להשתמש במחיצה ששומרת על הסדר כדי ליצור טוקנים, וכך גם כדי למקם את הנתונים. עם זאת, בתיעוד של Cassandra לא ממליצים על הגישה הזו כי סביר להניח שהאשכול לא יהיה מאוזן, וקשה לתקן את המצב הזה. לכן, במסמך הזה אנחנו מניחים שאתם משתמשים באסטרטגיית גיבוב עקבי (consistent hashing) כדי ליצור אסימונים שמובילים להפצת נתונים בין הצמתים.
Cassandra מספקת עמידות בפני תקלות באמצעות רמות זמינות שקשורות לרמת העקביות הניתנת לכוונון, וכך מאפשרת לאשכול לשרת לקוחות בזמן שאחד או יותר מהצמתים פגומים. אתם מגדירים את הרפליקציה הגיאוגרפית באמצעות אסטרטגיית טופולוגיה של רפליקציית נתונים שניתנת להגדרה.
אתם מציינים רמת עקביות לכל פעולה. ההגדרה הרגילה היא QUORUM (או LOCAL_QUORUM בטופולוגיות מסוימות של כמה מרכזי נתונים). כדי שהפעולה תיחשב כמוצלחת, הגדרת רמת העקביות הזו דורשת שרוב צומתי הרפליקה יגיבו לצומת המתאם. מקדם השכפול, שאותו מגדירים לכל מרחב מפתחות, קובע את מספר הרפליקות של הנתונים שמאוחסנות בכל מרכז נתונים באשכול. לדוגמה, בדרך כלל משתמשים בערך 3 כגורם שכפול כדי לספק איזון מעשי בין עמידות לנפח אחסון.
בתרשים הבא מוצג אשכול של שישה צמתים, כשכל טווח מפתחות של צומת מחולק לחמישה צמתים וירטואליים. בפועל, יכולים להיות לכם יותר צמתים, וסביר להניח שיהיו לכם יותר צמתים וירטואליים.
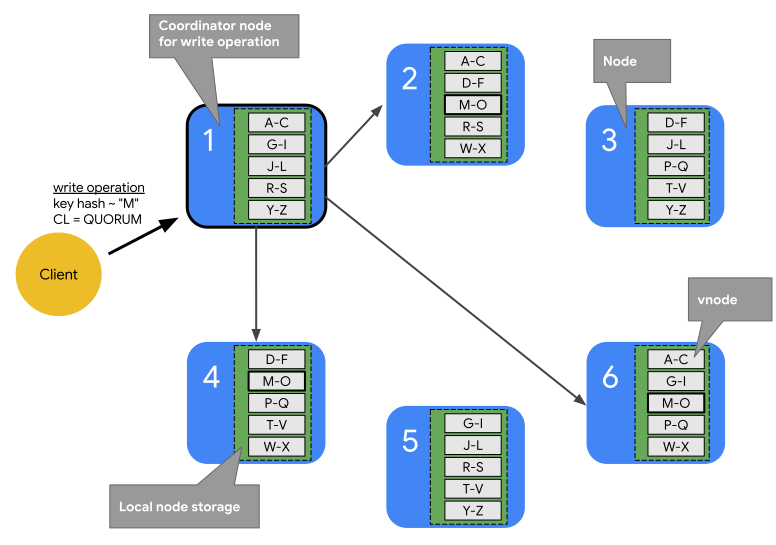
בתרשים הקודם אפשר לראות את הנתיב של פעולת כתיבה, עם רמת עקביות של QUORUM, שמקורה באפליקציית לקוח או בשירות (Client). לצורך התרשים הזה, טווחי המפתחות מוצגים כטווחים אלפביתיים. בפועל, האסימונים שנוצרים על ידי גיבוב (hash) של המפתח הראשי הם מספרים שלמים חתומים גדולים מאוד.
בדוגמה הזו, גיבוב המפתח הוא M, והצמתים הווירטואליים של M נמצאים בצמתים 2, 4 ו-6. הרכז צריך ליצור קשר עם כל צומת שבו טווחי הגיבוב של המפתחות מאוחסנים באופן מקומי, כדי שניתן יהיה לעבד את הכתיבה. מכיוון שרמת העקביות היא QUORUM, שתי רפליקות (הרוב) צריכות להגיב לצומת המתאם לפני שהלקוח מקבל הודעה שהכתיבה הושלמה.
בניגוד ל-Bigtable, כדי להעביר או לשנות טווחי מפתחות ב-Cassandra צריך להעתיק פיזית את הנתונים מצומת אחד לאחר. אם צומת אחד עמוס בבקשות לטווח גיבוב נתונים נתון של אסימונים, הוספת עיבוד לטווח האסימונים הזה מורכבת יותר ב-Cassandra בהשוואה ל-Bigtable.
רפליקציה גיאוגרפית ועקביות
ב-Bigtable וב-Cassandra, הטיפול ברפליקציה גיאוגרפית (שנקראת גם רפליקציה במספר אזורים) ובעקביות מתבצע באופן שונה. אשכול Cassandra מורכב מצומתי עיבוד שמקובצים למארזים, והמארזים מקובצים למרכזי נתונים. ב-Cassandra נעשה שימוש באסטרטגיית טופולוגיית רשת שאתם מגדירים כדי לקבוע איך הרפליקות של הצמתים הווירטואליים יתחלקו בין המארחים במרכז הנתונים. האסטרטגיה הזו חושפת את המקורות של Cassandra כמסד נתונים שנפרס במקור במרכזי נתונים פיזיים מקומיים. ההגדרה הזו גם מציינת את מקדם הרפליקציה לכל מרכז נתונים באשכול.
Cassandra משתמשת בהגדרות של מרכז הנתונים ושל המדפים כדי לשפר את העמידות בפני תקלות של הרפליקות של הנתונים. במהלך פעולות קריאה וכתיבה, הטופולוגיה קובעת את הצמתים המשתתפים שנדרשים כדי לספק עקביות. כשיוצרים או מרחיבים אשכול, צריך להגדיר באופן ידני את הצמתים, המדפים ומרכזי הנתונים. בסביבת ענן, פריסה אופיינית של Cassandra מתייחסת לאזור בענן כאל ארון שרתים ולאזור בענן כאל מרכז נתונים.
אתם יכולים להשתמש באמצעי הבקרה של קוורום ב-Cassandra כדי להתאים את הבטחות העקביות לכל פעולת קריאה או כתיבה. רמות החוזק של עקביות בסופו של דבר יכולות להשתנות, כולל אפשרויות שדורשות צומת רפליקה יחיד (ONE), רוב של צומתי רפליקה במרכז נתונים יחיד (LOCAL_QUORUM) או רוב של כל צומתי הרפליקה בכל מרכזי הנתונים (QUORUM).
ב-Bigtable, אשכולות הם משאבים של תחום מוגדר. מכונה של Bigtable יכולה להכיל אשכול אחד, או קבוצה של אשכולות ששוכפלו באופן מלא. אתם יכולים למקם אשכולות של מכונות בכל שילוב של אזורים בכל המחוזות שבהם Cloud de Confiance זמין. אפשר להוסיף אשכולות למכונה ולהסיר אותם ממנה, עם השפעה מינימלית על אשכולות אחרים במכונה.
ב-Bigtable, פעולות הכתיבה מתבצעות (עם עקביות של read-your-writes) באשכול אחד, ובסופו של דבר יהיו במודל עקביות הדרגתי באשכולות האחרים של המכונה. מכיוון שלכל תא יש גרסה לפי חותמת זמן, לא הולכות לאיבוד פעולות כתיבה, וכל אשכול מציג את התאים עם חותמות הזמן העדכניות ביותר שזמינות.
השירות חושף את סטטוס העקביות של האשכול. ב-Cloud Bigtable API יש מנגנון לקבלת אסימון עקביות ברמת הטבלה. אתם יכולים להשתמש בטוקן הזה כדי לוודא שכל השינויים שבוצעו בטבלה לפני שהטוקן נוצר שוכפלו באופן מלא.
תמיכה בעסקאות
אף אחד ממסדי הנתונים לא תומך בעסקאות מורכבות עם כמה שורות, אבל כל אחד מהם תומך בעסקאות מסוימות.
ל-Cassandra יש שיטה של טרנזקציה קלת משקל (LWT) שמספקת אטומיות לעדכונים של ערכי עמודות במחיצה אחת. ל-Cassandra יש גם סמנטיקה של השוואה והגדרה, שמשלימה את פעולת הקריאה של השורה ואת השוואת הערכים לפני שמתחילה פעולת הכתיבה.
Bigtable תומך בכתיבה עקבית לחלוטין של שורה אחת בתוך אשכול. טרנזקציות בשורה אחת מתאפשרות גם באמצעות הפעולות read-modify-write ו-check-and-mutate. פרופילי אפליקציות לניתוב בין כמה אשכולות לא תומכים בטרנזקציות בשורה אחת.
מודל נתונים
גם ב-Bigtable וגם ב-Cassandra הנתונים מאורגנים בטבלאות שתומכות בחיפושים ובסריקות של טווחים באמצעות המזהה הייחודי של השורה. שתי המערכות מסווגות כמאגרי NoSQL מסוג wide-column.
ב-Cassandra, צריך להשתמש ב-CQL כדי ליצור מראש את הסכימה המלאה של הטבלה, כולל ההגדרה של המפתח הראשי, שמות העמודות והסוגים שלהן. מפתחות ראשיים ב-Cassandra הם ערכים מורכבים ייחודיים שמורכבים ממפתח חלוקה למחיצות חובה וממפתח אשכול אופציונלי. מפתח המחיצה קובע את מיקום הצומת של השורה, ומפתח האשכול קובע את סדר המיון בתוך המחיצה. כשיוצרים סכימות, חשוב להיות מודעים לפשרות האפשריות בין ביצוע סריקות יעילות במחיצה אחת לבין עלויות המערכת שקשורות לתחזוקה של מחיצות גדולות.
ב-Bigtable, צריך רק ליצור את הטבלה ולהגדיר מראש את קבוצות העמודות שלה. העמודות לא מוצהרות כשיוצרים טבלאות, אלא נוצרות כשקריאות ל-API של האפליקציה מוסיפות תאים לשורות בטבלה.
מפתחות השורות מסודרים בסדר לקסיקוגרפי באשכול של Bigtable. הצמתים ב-Bigtable מאזנים באופן אוטומטי את האחריות של הצומת לטווחי מפתחות, שלעיתים קרובות נקראים טאבלטים ולפעמים פיצולים. מפתחות השורות ב-Bigtable מורכבים בדרך כלל מכמה ערכי שדות שמחוברים באמצעות תו מפריד נפוץ לבחירתכם (למשל סימן אחוז). כשהם מופרדים, רכיבי המחרוזת הבודדים מקבילים לשדות של מפתח ראשי של Cassandra.
עיצוב מפתח השורה
ב-Bigtable, המזהה הייחודי של שורה בטבלה הוא מפתח השורה. מפתח השורה חייב להיות ערך ייחודי אחד בכל הטבלה. אפשר ליצור מפתחות עם כמה חלקים על ידי שרשור של רכיבים שונים שמופרדים באמצעות תו מפריד נפוץ. מפתח השורה קובע את סדר המיון הגלובלי של הנתונים בטבלה. שירות Bigtable קובע באופן דינמי את טווחי המפתחות שמוקצים לכל צומת.
בניגוד ל-Cassandra, שבה ה-hash של מפתח המחיצה קובע את מיקום השורה ועמודות האשכולות קובעות את הסדר, מפתח השורה של Bigtable מספק גם הקצאת צומת וגם סדר. כמו ב-Cassandra, צריך לתכנן מפתח שורה ב-Bigtable כך ששורות שרוצים לאחזר ביחד יאוחסנו ביחד. עם זאת, ב-Bigtable לא צריך לתכנן את מפתח השורה למיקום ולסדר לפני שמשתמשים בטבלה.
סוגי הנתונים
שירות Bigtable לא אוכף את סוגי הנתונים של העמודות שהלקוח שולח. ספריות הלקוח מספקות שיטות עזר לכתיבת ערכי תאים כבייטים, כמחרוזות בקידוד UTF-8 וכמספרים שלמים של 64 ביט בקידוד big-endian (מספרים שלמים בקידוד big-endian נדרשים לפעולות של הגדלה אטומית).
קבוצת עמודות
ב-Bigtable, קבוצת עמודות קובעת אילו עמודות בטבלה מאוחסנות ונשלפות ביחד. לכל טבלה צריכה להיות לפחות קבוצת עמודות אחת, אבל בדרך כלל יש יותר (המגבלה היא 100 קבוצות עמודות לכל טבלה). צריך ליצור במפורש קבוצות של עמודות לפני שאפליקציה תוכל להשתמש בהן בפעולה.
מגדירי העמודות
כל ערך שמאוחסן בטבלה במפתח שורה משויך לתווית שנקראת מגדיר העמודה. מכיוון שמגדירי העמודות הם רק תוויות, אין מגבלה מעשית על מספר העמודות שיכולות להיות בקבוצת עמודות. ב-Bigtable, מגדירי העמודות משמשים לעיתים קרובות לייצוג נתוני האפליקציה.
תאים
ב-Bigtable, תא הוא נקודת המפגש של מפתח השורה ושם העמודה (קבוצת עמודות בשילוב עם מגדיר עמודה). כל תא מכיל ערך אחד או יותר עם חותמת זמן, שאפשר לספק על ידי הלקוח או להחיל באופן אוטומטי על ידי השירות. ערכי תאים ישנים נמחקים על סמך מדיניות איסוף אשפה שמוגדרת ברמת קבוצת העמודות.
אינדקסים משניים
אתם יכולים להשתמש בתצוגות המהותיות הרציפות כאינדקסים משניים אסינכרוניים לטבלאות, כדי לשלוח שאילתות לאותם נתונים באמצעות דפוסי חיפוש או מאפיינים שונים. מידע נוסף זמין במאמר יצירת אינדקס משני אסינכרוני.
מודלים של נתונים: גמישות עם אוספים
מתאם ה-proxy של Cassandra ל-Bigtable הופך את סוגי האוספים של Cassandra, כמו מפות, קבוצות ורשימות, לקבוצות של עמודות ב-Bigtable. כך השימוש ב-Bigtable עם סוגי אוספים של Cassandra יעיל מאוד, כי אפשר לכתוב ולקרוא עמודות בודדות הרבה יותר מהר מאשר קובצי blob בודדים.
בעזרת Bigtable, אתם יכולים ליצור אפליקציות עם אוספים גדולים ודינמיים בלי הפשרות בביצועים שנדרשות ב-Cassandra, מהסיבות הבאות:
- ב-Bigtable, רכיבי האוסף מאוחסנים כתאים נפרדים, כך שהפעולות על הרכיבים הן ברמת פירוט גבוהה. כלומר, עדכון מפה בודד מתורגם לכתיבה קלה של תא, מה שמאפשר ביצועים גבוהים ומדרגיות.
- לאוספים ב-Bigtable אין מגבלת גודל מעשית, מלבד מגבלות הגודל הכלליות של השורות.
- ב-Bigtable נשמר זמן אחזור נמוך ועקבי, לא משנה כמה האוסף גדל, כמו שמוצג באיור 4.
לעומת זאת, במסמכי התיעוד של Cassandra מומלץ להגביל מאוד את השימוש בסוגי אוספים, ולעיתים קרובות להגביל את מספר הרכיבים למספרים קטנים בגלל פגיעה בביצועים. בגלל ש-Cassandra קוראת עמודות של אוספים כמכלול, אוספים גדולים גורמים בהכרח לעליות חדות בזמן האחזור של הקריאה ולחוסר יציבות פוטנציאלי של הצומת.
אפשר לעקוף את המגבלות האלה באמצעות פתרונות עקיפים כמו אוספים קפואים או אחסון נתונים כמחרוזות JSON, אבל הפתרונות האלה פוגעים בביצועים כי הם מוסיפים מס קריאה-שינוי-כתיבה. התקורה הזו מאלצת את מסד הנתונים לקרוא, לבטל את ההסדרה, לעדכן ולשכתב את כל האובייקט בכל שינוי. בנוסף, Cassandra מתייחסת ל-JSON blobs האלה כטקסט אטום, ולכן צריך להוסיף את כל הלוגיקה של הניתוח לשכבת האפליקציה. בניגוד ל-Bigtable, שכולל עיבוד מובנה בצד השרת של מחרוזות JSON באמצעות פונקציות של SQL API.
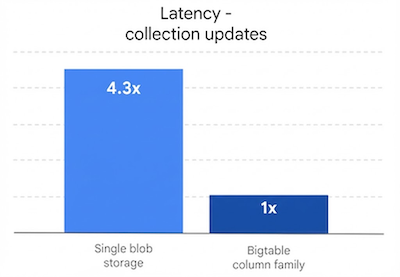
ב-Bigtable אפשר לשלב רכיבי סכימה קבועים עם רכיבים דינמיים בלי להתפשר. כך האפליקציות יכולות לאכוף מבנה במקומות שבהם הוא חשוב, ועדיין להישאר גמישות, מה שמאפשר לכם לפתח את מודל הנתונים בלי העברות נרחבות או זמני השבתה. הוא גם תומך בעומסי עבודה מודרניים, כמו למידת מכונה ו-AI, שדורשים איטרציה תכופה ב-Feature Store והצגה בזמן אמת בקנה מידה גלובלי.
איזון עומסים ויתירות כשל בצד הלקוח
ב-Cassandra, הלקוח שולט באיזון העומסים של הבקשות. מנהל ההתקן של הלקוח מגדיר מדיניות, שצוינה כחלק מההגדרה או באופן פרוגרמטי במהלך יצירת הסשן. האשכול מעדכן את המדיניות לגבי מרכזי הנתונים שהכי קרובים לאפליקציה, והלקוח מזהה צמתים ממרכזי הנתונים האלה כדי לשרת פעולה.
שירות Bigtable מנתב קריאות ל-API לאשכול יעד על סמך פרמטר (מזהה פרופיל אפליקציה) שמסופק עם כל פעולה. פרופילי אפליקציות מנוהלים בתוך שירות Bigtable. פעולות של לקוחות שלא בוחרים פרופיל משתמשות בפרופיל ברירת המחדל.
ב-Bigtable יש שני סוגים של מדיניות ניתוב לפרופיל של אפליקציה: אשכול יחיד ומספר אשכולות. פרופיל של כמה אשכולות מנתב את הפעולות לאשכול הזמין הקרוב ביותר. אשכולות באותו אזור נחשבים במרחק שווה מנקודת המבט של נתב הפעולות. אם הצומת שאחראי על טווח המפתחות המבוקש עמוס מדי או לא זמין באופן זמני באשכול, סוג הפרופיל הזה מספק יתירות כשל אוטומטית.
במונחים של Cassandra, מדיניות של כמה אשכולות מספקת את היתרונות של מדיניות איזון עומסים שמודעת למרכזי נתונים.
פרופיל אפליקציה עם ניתוב לאשכול יחיד מפנה את כל התנועה לאשכול יחיד. עקביות חזקה בשורות ועסקאות בשורה אחת זמינות רק בפרופילים עם ניתוב לאשכול יחיד.
החיסרון בגישה של אשכול יחיד הוא שבמקרה של יתירות כשל, האפליקציה צריכה להיות מסוגלת לנסות שוב באמצעות מזהה פרופיל אפליקציה חלופי, או שצריך לבצע באופן ידני את יתירות הכשל של פרופילי הניתוב המושפעים של האשכול היחיד.
ניתוב פעולות
ב-Cassandra וב-Bigtable משתמשים בשיטות שונות כדי לבחור את צומת העיבוד לפעולות קריאה וכתיבה. ב-Cassandra מזוהה מפתח המחיצה, ואילו ב-Bigtable נעשה שימוש במפתח השורה.
ב-Cassandra, הלקוח בודק קודם את מדיניות איזון העומסים. האובייקט הזה בצד הלקוח קובע לאיזה מרכז נתונים הפעולה תנותב.
אחרי שמרכז הנתונים מזוהה, Cassandra יוצרת קשר עם צומת מתאם כדי לנהל את הפעולה. אם המדיניות מזהה אסימונים, הרכז הוא צומת שמציג נתונים ממחיצת ה-vnode של היעד. אחרת, הרכז הוא צומת אקראי. צומת התיאום מזהה את הצמתים שבהם נמצאות הרפליקות של הנתונים של מפתח המחיצה של הפעולה, ואז מורה לצמתים האלה לבצע את הפעולה.
כמו שצוין קודם, ב-Bigtable כל פעולה כוללת מזהה של פרופיל אפליקציה. פרופיל האפליקציה מוגדר ברמת השירות. שכבת הניתוב של Bigtable בודקת את הפרופיל כדי לבחור את אשכול היעד המתאים לפעולה. לאחר מכן, שכבת הניתוב מספקת נתיב לפעולה כדי להגיע לצומתי העיבוד הנכונים באמצעות מפתח השורה של הפעולה.
תהליך כתיבת הנתונים
שני מסדי הנתונים עברו אופטימיזציה לכתיבה מהירה, והם משתמשים בתהליך דומה כדי להשלים כתיבה. עם זאת, השלבים שמסדי הנתונים מבצעים משתנים מעט, במיוחד עבור Cassandra, שבה, בהתאם לרמת העקביות של הפעולה, יכול להיות שתידרש תקשורת עם צומתי משתתפים נוספים.
אחרי שבקשת הכתיבה מנותבת לצמתים המתאימים (Cassandra) או לצומת המתאים (Bigtable), הכתיבה נשמרת קודם בדיסק באופן רציף ביומן תיעוד שינויים (Cassandra) או ביומן משותף (Bigtable). לאחר מכן, פעולות הכתיבה מוכנסות לטבלה בזיכרון (שנקראת גם memtable) שמסודרת כמו ה-SSTables.
אחרי שני השלבים האלה, הצומת מגיב כדי לציין שהכתיבה הושלמה. ב-Cassandra, כמה רפליקות (בהתאם לרמת העקביות שצוינה לכל פעולה) צריכות להגיב לפני שהרכז מודיע ללקוח שהכתיבה הושלמה. ב-Bigtable, כל מפתח שורה מוקצה לצומת אחד בלבד בכל נקודת זמן, ולכן תגובה מהצומת היא כל מה שצריך כדי לאשר שהכתיבה הצליחה.
בהמשך, אם צריך, אפשר להעביר את ה-memtable לדיסק כ-SSTable חדש. ב-Cassandra, ה-flush מתרחש כשיומן ה-commit מגיע לגודל המקסימלי, או כש-memtable חורג מהסף שהגדרתם. ב-Bigtable, מתבצעת פעולת flush כדי ליצור טבלאות SSTable חדשות שלא ניתנות לשינוי, כשה-memtable מגיעה לגודל המקסימלי שצוין על ידי השירות. מדי פעם, תהליך דחיסה ממזג טבלאות SSTable של טווח מפתחות נתון לטבלת SSTable אחת.
עדכוני נתונים
שני מסדי הנתונים מטפלים בעדכוני נתונים באופן דומה. עם זאת, Cassandra מאפשרת רק ערך אחד לכל תא, ואילו Bigtable יכולה לשמור מספר גדול של ערכים עם גרסאות לכל תא.
כשמשנים את הערך בנקודת המפגש של מזהה שורה ייחודי ועמודה, העדכון נשמר כמו שמתואר בקטע תהליך כתיבת הנתונים. חותמת הזמן של הכתיבה מאוחסנת לצד הערך במבנה של SSTable.
אם לא העברתם תא מעודכן ל-SSTable, אתם יכולים לאחסן רק את ערך התא ב-memtable, אבל מסדי הנתונים שונים במה שמאוחסן. Cassandra שומרת רק את הערך החדש ביותר ב-memtable, ואילו Bigtable שומרת את כל הגרסאות ב-memtable.
לחלופין, אם שמרתם בדיסק לפחות גרסה אחת של ערך תא בטבלאות SSTable נפרדות, מסדי הנתונים מטפלים בבקשות לנתונים האלה באופן שונה. כשמבקשים את התא מ-Cassandra, מוחזר רק הערך האחרון לפי חותמת הזמן. במילים אחרות, הכתיבה האחרונה היא הקובעת. ב-Bigtable, משתמשים במסננים כדי לקבוע אילו גרסאות של תאים יוחזרו בבקשת קריאה.
מחיקות של שורות
בגלל ששני מסדי הנתונים משתמשים בקובצי SSTable שלא ניתנים לשינוי כדי לשמור נתונים בדיסק, אי אפשר למחוק שורה באופן מיידי. כדי לוודא שהשאילתות יחזירו את התוצאות הנכונות אחרי מחיקת שורה, שני מסדי הנתונים מטפלים במחיקות באמצעות אותו מנגנון. קודם כל, מתווסף ל-memtable סמן (שנקרא tombstone ב-Cassandra). בסופו של דבר, טבלת SSTable חדשה שנכתבה מכילה סמן עם חותמת זמן שמציין שמזהה השורה הייחודי נמחק, ושהוא לא אמור לחזור בתוצאות השאילתה.
זמן חיים (TTL)
היכולות של אורך החיים (TTL) בשני מסדי הנתונים דומות, מלבד הבדל אחד. ב-Cassandra אפשר להגדיר את ה-TTL לעמודה או לטבלה, ואילו ב-Bigtable אפשר להגדיר את ה-TTL רק לקבוצת העמודות. ב-Bigtable יש שיטה שמאפשרת לדמות TTL ברמת התא.
איסוף אשפה
כמו שהוסבר קודם, אי אפשר לעדכן או למחוק נתונים באופן מיידי בטבלאות SSTable שלא ניתנות לשינוי, ולכן איסוף האשפה מתרחש במהלך תהליך שנקרא דחיסה. התהליך מסיר תאים או שורות שלא אמורים להופיע בתוצאות השאילתה.
תהליך איסוף האשפה לא כולל שורה או תא כשמתרחש מיזוג SSTable. אם יש סמן או מצבה לשורה, השורה הזו לא נכללת ב-SSTable שנוצר. שני מסדי הנתונים יכולים להחריג תא מה-SSTable הממוזג. אם חותמת הזמן של התא חורגת מהתנאי של TTL, מסדי הנתונים לא כוללים את התא. אם יש שתי גרסאות עם חותמת זמן לתא מסוים, Cassandra כוללת רק את הערך האחרון ב-SSTable הממוזג.
נתיב קריאת הנתונים
כשפעולת קריאה מגיעה לצומת העיבוד המתאים, תהליך הקריאה לקבלת נתונים כדי לענות על תוצאת שאילתה זהה בשני מסדי הנתונים.
לכל SSTable בדיסק שעשוי להכיל תוצאות של שאילתות, נבדק מסנן Bloom כדי לקבוע אם כל קובץ מכיל שורות שצריך להחזיר. מסנני בלום אף פעם לא מספקים תוצאה שלילית שגויה, ולכן כל טבלאות ה-SSTable שעומדות בדרישות מתווספות לרשימת מועמדים שתיכלל בעיבוד נוסף של תוצאות הקריאה.
פעולת הקריאה מתבצעת באמצעות תצוגה ממוזגת שנוצרה מה-memtable ומטבלאות ה-SSTable המועמדות בדיסק. כל המפתחות ממוינים לפי סדר לקסיקוגרפי, ולכן קל לקבל תצוגה ממוזגת שנסרקת כדי לקבל את תוצאות השאילתה.
ב-Cassandra, קבוצה של צומתי עיבוד שנקבעים לפי רמת העקביות של הפעולה חייבת להשתתף בפעולה. ב-Bigtable, צריך להתייעץ רק עם הצומת שאחראי לטווח המפתחות. ב-Cassandra, צריך להביא בחשבון את ההשלכות על גודל המחשוב, כי סביר להניח שכמה צמתים יעבדו כל קריאה.
אפשר להגביל את תוצאות הקריאה בצומת העיבוד בדרכים שונות.
ב-Cassandra, התנאי WHERE בשאילתת CQL מגביל את השורות שמוחזרות. המגבלה היא שאפשר להשתמש בעמודות במפתח הראשי או בעמודות שנכללות באינדקס משני כדי להגביל את התוצאות.
ב-Bigtable יש מגוון עשיר של מסננים שמשפיעים על השורות או התאים שמאחזרת שאילתת קריאה.
יש שלוש קטגוריות של מסננים:
- מסננים מגבילים, שקובעים אילו שורות או תאים ייכללו בתשובה.
- שינוי מסננים, שמשפיעים על הנתונים או המטא-נתונים של תאים ספציפיים.
- מסננים משולבים, שמאפשרים לשלב כמה מסננים למסנן אחד.
מסננים מגבילים הם הנפוצים ביותר – לדוגמה, הביטוי הרגולרי של קבוצת העמודות והביטוי הרגולרי של מגדיר העמודה.
אחסון נתונים פיזי
גם Bigtable וגם Cassandra מאחסנים נתונים ב-SSTables, שמתמזגים באופן קבוע במהלך שלב הדחיסה. שני מסדי הנתונים גם דוחסים את הנתונים כדי לצמצם את גודלם בדיסק. ב-Bigtable, הדחיסה חלה באופן אוטומטי על בלוקי נתונים כשהם נשמרים בדיסק, והכיווץ הוא תהליך תחזוקה ברקע שממזג טבלאות SSTable ומסיר תאים שנמחקו או שהנתונים שלהם הוחלפו. ב-Cassandra, הדחיסה היא אפשרות בטבלה שהמשתמש יכול להגדיר.
כשמשווים בין שני מסדי הנתונים, חשוב להבין איך כל אחד מהם מאחסן את הנתונים באופן פיזי, בהיבטים הבאים:
- אסטרטגיית הפצת הנתונים
- מספר הגרסאות הזמינות של התא
- סוג הדיסק לאחסון
- מנגנון עמידות הנתונים והרפליקציה
התפלגות הנתונים
ב-Cassandra, גיבוב עקבי (consistent hashing) של עמודות המחיצה של המפתח הראשי הוא השיטה המומלצת לקביעת חלוקת הנתונים בין טבלאות ה-SSTable השונות שמוצגות על ידי צומתי האשכול.
כדי למקם נתונים ב-SSTables באופן לקסיקוגרפי, Bigtable משתמש בתחילית משתנה למפתח השורה המלא.
גרסאות של תאים
Cassandra שומרת רק גרסה אחת של ערך תא פעיל. אם מתבצעות שתי כתיבות לתא, מדיניות של "הכתיבה האחרונה מנצחת" מבטיחה שיוחזר רק ערך אחד.
ב-Bigtable אין הגבלה על מספר הגרסאות עם חותמת הזמן לכל תא. יכול להיות שיחולו מגבלות אחרות על גודל השורות. אם חותמת הזמן לא מוגדרת על ידי בקשת הלקוח, היא נקבעת על ידי שירות Bigtable ברגע שצומת העיבוד מקבל את המוטציה. אפשר למחוק גרסאות של תאים באמצעות מדיניות איסוף אשפה, שיכולה להיות שונה לכל קבוצת עמודות בטבלה, או לסנן אותן מקבוצת תוצאות של שאילתה באמצעות ה-API.
נפח אחסון בדיסק
ב-Cassandra, טבלאות SSTable מאוחסנות בדיסקים שמחוברים לכל צומת באשכול. כדי לאזן מחדש את הנתונים ב-Cassandra, צריך להעתיק פיזית את הקבצים בין השרתים.
Bigtable משתמש ב-Colossus כדי לאחסן טבלאות SSTable. מכיוון ש-Bigtable משתמש במערכת הקבצים המבוזרת הזו, שירות Bigtable יכול להקצות מחדש טבלאות SSTable לצמתים שונים כמעט באופן מיידי.
עמידות נתונים ויצירת רפליקות
ב-Cassandra, עמידות הנתונים מתבצעת באמצעות הגדרת פקטור השכפול. גורם הרפליקציה קובע את מספר העותקים של SSTable שמאוחסנים בצמתים שונים באשכול. הגדרה אופיינית לפקטור הרפליקציה היא 3, שעדיין מאפשרת הבטחות חזקות יותר למודל עקביות חזק עם QUORUM או LOCAL_QUORUM גם אם מתרחש כשל בצומת.
ב-Bigtable, עמידות גבוהה של נתונים מובטחת באמצעות הרפליקציה ש-Colossus מספק.
התרשים הבא ממחיש את פריסת הנתונים הפיזיים, צומתי עיבוד המחשוב ושכבת הניתוב של Bigtable:
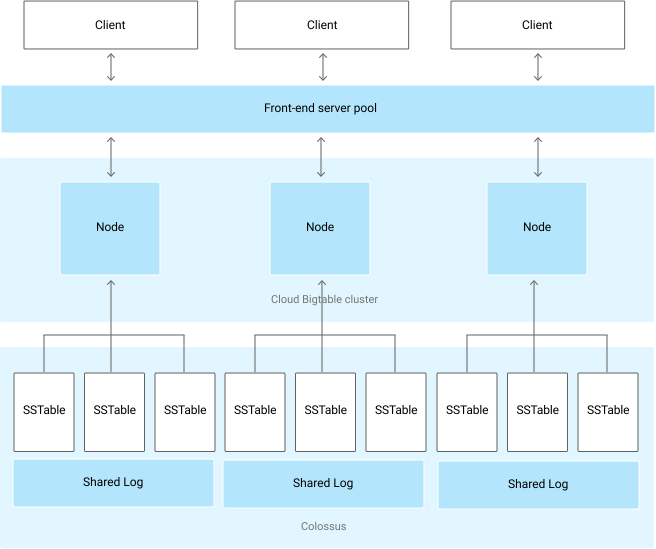
בשכבת האחסון של Colossus, כל צומת מוקצה להצגת הנתונים שמאוחסנים בסדרה של טבלאות SSTable. טבלאות ה-SSTable האלה מכילות את הנתונים של טווחי מפתחות השורות שמוקצים באופן דינמי לכל צומת. למרות שבדיאגרמה מוצגות שלוש טבלאות SSTable לכל צומת, סביר להניח שיש יותר, כי טבלאות SSTable נוצרות כל הזמן כשהצמתים מקבלים שינויים חדשים בנתונים.
לכל צומת יש יומן משותף. פעולות הכתיבה שמעובדות על ידי כל צומת נשמרות מיד ביומן המשותף לפני שהלקוח מקבל אישור כתיבה. מכיוון שפעולת כתיבה ב-Colossus משוכפלת כמה פעמים, העמידות מובטחת גם אם מתרחשת תקלה בחומרת הצומת לפני שהנתונים נשמרים ב-SSTable לטווח השורות.
ממשקי אפליקציות
במקור, הגישה למסד הנתונים של Cassandra נחשפה באמצעות ממשק API של Thrift, אבל שיטת הגישה הזו הוצאה משימוש. הדרך המומלצת לאינטראקציה עם הלקוח היא באמצעות CQL.
בדומה ל-Thrift API המקורי של Cassandra, הגישה למסד הנתונים של Bigtable מתבצעת דרך API שקורא וכותב נתונים על סמך מפתחות השורות שסופקו.
כמו ל-Cassandra, גם ל-Bigtable יש ממשק שורת פקודה שנקרא cbt CLI, וספריות לקוח שתומכות בהרבה שפות תכנות נפוצות. הספריות האלה מבוססות על ממשקי ה-API של gRPC ו-REST. אפליקציות שנכתבו ל-Hadoop ומסתמכות על ספריית הקוד הפתוח Apache HBase ל-Java יכולות להתחבר ל-Bigtable בלי שינוי משמעותי. לאפליקציות שלא דורשות תאימות ל-HBase, מומלץ להשתמש בלקוח Java המובנה של Bigtable.
אמצעי הבקרה של ניהול הזהויות והרשאות הגישה (IAM) ב-Bigtable משולבים באופן מלא ב- Cloud de Confiance, ואפשר גם להשתמש בטבלאות כמקור נתונים חיצוני מ-BigQuery.
הגדרת מסד הנתונים
כשמגדירים אשכול Cassandra, צריך לקבל כמה החלטות לגבי ההגדרות ולבצע כמה שלבים. קודם צריך להגדיר את צומתי השרת כדי לספק קיבולת מחשוב ולהקצות אחסון מקומי. כשמשתמשים בפקטור שכפול של שלוש, ההגדרה המומלצת והנפוצה ביותר, צריך להקצות נפח אחסון שגדול פי שלושה מכמות הנתונים שאתם מצפים להחזיק באשכול. אתם צריכים גם לקבוע ולהגדיר את התצורות של vnodes, מארזים ושכפול.
ההפרדה בין המחשוב לאחסון ב-Bigtable מפשטת את הגדלת האשכולות והקטנתם בהשוואה ל-Cassandra. באשכול שפועל באופן תקין, בדרך כלל צריך להתייחס רק לנפח האחסון הכולל שמשמש את הטבלאות המנוהלות, שקובע את המספר המינימלי של הצמתים, ולוודא שיש מספיק צמתים כדי לעמוד בקצב של השאילתות לשנייה (QPS).
אתם יכולים לשנות במהירות את גודל האשכול ב-Bigtable אם האשכול מוקצה יתר על המידה או פחות מדי, בהתאם לעומס הייצור.
אחסון ב-Bigtable
מלבד המיקום הגיאוגרפי של האשכול הראשוני, הבחירה היחידה שצריך לעשות כשיוצרים מכונה של Bigtable היא סוג האחסון. ב-Bigtable יש שתי אפשרויות לאחסון: כונני SSD או כוננים קשיחים (HDD). כל האשכולות במכונה חייבים להיות מאותו סוג אחסון.
כשמחשבים את צורכי האחסון ב-Bigtable, לא צריך להביא בחשבון רפליקות של אחסון כמו שצריך כשמחשבים את הגודל של אשכול Cassandra. אין אובדן של צפיפות האחסון כדי להשיג עמידות בפני תקלות, כמו שקורה ב-Cassandra. בנוסף, מכיוון שלא צריך להקצות נפח אחסון באופן מפורש, אתם מחויבים רק על נפח האחסון שבשימוש.
SSD
קיבולת הצומת של ה-SSD היא 5TB, והיא עדיפה לרוב עומסי העבודה. היא מספקת צפיפות אחסון גבוהה יותר בהשוואה להגדרות המומלצות למכונות Cassandra, שבהן צפיפות האחסון המקסימלית בפועל היא פחות מ-2TB לכל צומת. כשאתם מעריכים את צורכי קיבולת האחסון, זכרו שב-Bigtable נספר רק עותק אחד של הנתונים. לעומת זאת, ב-Cassandra צריך להביא בחשבון שלושה עותקים של הנתונים ברוב ההגדרות.
מספר השאילתות לשנייה (QPS) של כתיבה ב-SSD דומה לזה של HDD, אבל מספר השאילתות לשנייה של קריאה ב-SSD גבוה משמעותית מזה של HDD. המחיר של אחסון SSD זהה או קרוב לעלויות של דיסקים מתמידים מבוססי-SSD שהוקצו, והוא משתנה בהתאם לאזור.
HDD
סוג האחסון HDD מאפשר צפיפות אחסון משמעותית – 16TB לכל צומת. החיסרון הוא שקריאות אקראיות איטיות משמעותית, ותומכות רק בקריאה של 500 שורות בשנייה לכל צומת. עדיף להשתמש ב-HDD לעומסי עבודה שכוללים הרבה פעולות כתיבה, שבהם פעולות הקריאה צפויות להיות סריקות טווח שמשויכות לעיבוד באצווה. המחיר של אחסון HDD הוא קרוב לעלות שמשויכת ל-Cloud Storage, ומשתנה בהתאם לאזור.
שיקולים לגבי גודל האשכול
כשמגדירים את הגודל של מכונה ב-Bigtable כהכנה להעברת עומס עבודה מ-Cassandra, צריך להשוות בין אשכולות Cassandra במרכז נתונים יחיד לבין מכונות Bigtable עם אשכול יחיד, ובין אשכולות Cassandra בכמה מרכזי נתונים לבין מכונות Bigtable עם כמה אשכולות. ההנחיות בקטעים הבאים מבוססות על ההנחה שלא נדרשים שינויים משמעותיים במודל הנתונים לצורך ההעברה, ושיש דחיסת אחסון מקבילה בין Cassandra ל-Bigtable.
אשכול של מרכז נתונים אחד
כשמשווים בין אשכול של מרכז נתונים יחיד לבין מכונה של Bigtable עם אשכול יחיד, קודם כל צריך להביא בחשבון את דרישות האחסון. כדי להעריך את הגודל של כל מרחב מפתחות ללא רפליקציה, אפשר להשתמש בפקודה nodetool tablestats ולחלק את נפח האחסון הכולל שנמחק בפקטור הרפליקציה של מרחב המפתחות. לאחר מכן, מחלקים את נפח האחסון ללא שכפול של כל מרחבי המפתחות ב-3.5TB (5TB * .70) כדי לקבוע את המספר המוצע של צומתי SSD לטיפול באחסון בלבד. כמו שציינו, Bigtable מטפל בשכפול האחסון ובעמידות בשכבה נפרדת ששקופה למשתמש.
בשלב הבא, צריך להביא בחשבון את דרישות המחשוב למספר הצמתים. אפשר לעיין במדדים של אפליקציית הלקוח ושל שרת Cassandra כדי לקבל מספר משוער של פעולות קריאה וכתיבה מתמשכות שבוצעו. כדי להעריך את המספר המינימלי של צומתי SSD לביצוע עומס העבודה, מחלקים את המדד הזה ב-10,000. סביר להניח שתצטרכו יותר צמתים לאפליקציות שדורשות תוצאות שאילתה עם זמן אחזור קצר. Google ממליצה לבדוק את הביצועים של Bigtable באמצעות נתונים ושאילתות מייצגים, כדי לקבוע מדד ל-QPS לכל צומת שאפשר להשיג בעומס העבודה שלכם.
מספר הצמתים שנדרש לאשכול צריך להיות שווה לערך הגדול יותר מבין צורכי האחסון והמחשוב. אם אתם לא בטוחים לגבי צורכי האחסון או התפוקה שלכם, אתם יכולים להתאים את מספר הצמתים של Bigtable למספר המכונות הטיפוסיות של Cassandra. אפשר להגדיל או להקטין את אשכול Bigtable כדי להתאים אותו לצורכי עומס העבודה, במינימום מאמץ ובלי זמן השבתה.
אשכול של כמה מרכזי נתונים
באשכולות עם כמה מרכזי נתונים, קשה יותר לקבוע את ההגדרות של מכונה ב-Bigtable. במצב אידיאלי, צריך להיות אשכול במכונה לכל מרכז נתונים בטופולוגיה של Cassandra. כל אשכול Bigtable במכונה צריך לאחסן את כל הנתונים במכונה, ולהיות מסוגל לטפל בקצב ההוספה הכולל בכל האשכול. אפשר ליצור אשכולות במכונה בכל אזור נתמך בענן ברחבי העולם.
השיטה להערכת צורכי האחסון דומה לגישה של אשכולות במרכז נתונים יחיד. אתם משתמשים ב-nodetool כדי לתעד את גודל האחסון של כל מרחב מפתחות באשכול Cassandra, ואז מחלקים את הגודל הזה במספר הרפליקות. חשוב לזכור שלמרחב המפתחות של טבלה יכולים להיות גורמי שכפול שונים לכל מרכז נתונים.
כדי לעמוד ביעדי רמת השירות (SLO) בזמן הפסקה זמנית בפעילות של אשכול, מספר הצמתים בכל אשכול במכונה צריך להיות מספיק כדי לטפל בכל פעולות הכתיבה באשכול ובכל פעולות הקריאה בשני מרכזי נתונים לפחות. גישה נפוצה היא להתחיל עם כל האשכולות עם קיבולת הצומת המקבילה של מרכז הנתונים העמוס ביותר באשכול Cassandra. אפשר להגדיל או להקטין את האשכולות של Bigtable במכונה בנפרד, בהתאם לצורכי עומס העבודה, ללא זמן השבתה.
ניהול
ב-Bigtable יש רכיבים מנוהלים לחלוטין לפונקציות ניהול נפוצות שמבוצעות ב-Cassandra.
גיבוי ושחזור
ב-Bigtable יש שתי שיטות לגיבוי: גיבויים ב-Bigtable וייצוא נתונים מנוהל.
אפשר לחשוב על הגיבויים של Bigtable כגרסה מנוהלת של תכונת תמונת המצב של nodetool ב-Cassandra. גיבויים ב-Bigtable יוצרים עותקים של טבלה שאפשר לשחזר, והם מאוחסנים כאובייקטים של חברים באשכול. אתם יכולים לשחזר גיבויים כטבלה חדשה באשכול שממנו התחיל הגיבוי. הגיבויים נועדו ליצור נקודות שחזור במקרה של פגיעה ברמת האפליקציה. גיבויים שאתם יוצרים באמצעות הכלי הזה לא צורכים משאבי צומת, והמחיר שלהם זהה או קרוב למחירים של Cloud Storage. אתם יכולים להפעיל גיבויים של Bigtable באופן פרוגרמטי או דרך מסוף Cloud de Confiance ל-Bigtable.
דרך נוספת לגבות את Bigtable היא להשתמש בייצוא נתונים מנוהל ל-Cloud Storage. אפשר לייצא לפורמטים Avro, Parquet או Hadoop Sequence. בהשוואה לגיבויים של Bigtable, הייצוא נמשך זמן רב יותר וגורם לעלויות מחשוב נוספות כי הייצוא משתמש ב-Dataflow. עם זאת, הייצוא יוצר קובצי נתונים ניידים שאפשר לשלוח אליהם שאילתות אופליין או לייבא אותם למערכת אחרת.
שינוי גודל
ב-Bigtable יש הפרדה בין האחסון למחשוב, ולכן קל יותר להוסיף או להסיר צמתים ב-Bigtable בתגובה לביקוש לשאילתות מאשר ב-Cassandra. בארכיטקטורה ההומוגנית של Cassandra צריך לאזן מחדש את הצמתים (או הצמתים הווירטואליים) בין המכונות באשכול.
אפשר לשנות את גודל האשכול באופן ידני במסוף Cloud de Confiance או באופן פרוגרמטי באמצעות Cloud Bigtable API. הוספת צמתים לאשכול יכולה לשפר את הביצועים באופן משמעותי תוך דקות. חלק מהלקוחות השתמשו בהצלחה במידרוג אוטומטי בקוד פתוח שפותח על ידי Spotify.
תחזוקה פנימית
שירות Bigtable מטפל בצורה חלקה במשימות תחזוקה פנימיות נפוצות של Cassandra, כמו תיקון מערכת ההפעלה, שחזור צמתים, תיקון צמתים, מעקב אחר דחיסת האחסון ורוטציה של אישורי SSL.
מעקב
כדי לקשר את Bigtable להצגת מדדים או להתראות, לא צריך להשקיע מאמץ בניהול או בפיתוח. בדף של Bigtable במסוףCloud de Confiance יש מרכזי בקרה מוכנים מראש למעקב אחרי מדדי התפוקה והניצול ברמות המכונה, האשכול והטבלה. אפשר ליצור תצוגות והתראות בהתאמה אישית בלוחות הבקרה של Cloud Monitoring, שבהם המדדים זמינים באופן אוטומטי.
Key Visualizer של Bigtable, תכונת מעקב במסוף Cloud de Confiance , מאפשרת לכם לבצע כוונון ביצועים מתקדם.
IAM ואבטחה
ב-Bigtable, ההרשאה משולבת באופן מלא במסגרת ה-IAM שלCloud de Confiance, ודורשת הגדרה ותחזוקה מינימליות. סיסמאות וחשבונות משתמשים מקומיים לא משותפים עם אפליקציות לקוח. במקום זאת, הרשאות ותפקידים מפורטים ניתנים למשתמשים ברמת הארגון ולחשבונות שירות.
ב-Bigtable כל הנתונים מוצפנים באופן אוטומטי גם כשהם באחסון וגם כשהם מועברים. אי אפשר להשבית את התכונות האלה. כל הרשאות האדמין מתועדות ביומן. אתם יכולים להשתמש ב-VPC Service Controls כדי לשלוט בגישה למכונות של Bigtable מחוץ לרשתות שאושרו.
המאמרים הבאים
- מידע על עיצוב סכימה של Bigtable
- מידע נוסף על Apache Cassandra
- נסו את ה-Codelab של Bigtable למשתמשי Cassandra.
- מידע על אמולטור Bigtable
- כדאי להעמיק את הקריאה ולהכיר דוגמאות לארכיטקטורות, תרשימים ושיטות מומלצות בנושאי Google Cloud. כל אלה זמינים במרכז הארכיטקטורה של Cloud.