

סקירה כללית על Bigtable
Bigtable הוא טבלה חסכונית (sparse) שיכולה להתרחב למיליארדי שורות ואלפי עמודות, ומאפשרת לאחסן טרה-בייטים ואפילו פטה-בייטים של נתונים. Bigtable הוא פתרון אידיאלי לאחסון כמויות גדולות של נתונים עם מפתח יחיד וזמן אחזור קצר. הוא תומך בקצב העברת נתונים גבוה לקריאה ולכתיבה בזמן אחזור קצר, והוא מקור נתונים אידיאלי לפעולות MapReduce.
אפליקציות יכולות לגשת ל-Bigtable באמצעות כמה ספריות לקוח, כולל תוסף נתמך לספריית Apache HBase ל-Java. לכן הוא משתלב עם הסביבה העסקית הקיימת של Apache, שכוללת תוכנות קוד פתוח לנתונים בהיקפים גדולים.
לשרתי הבק-אנד החזקים של Bigtable יש כמה יתרונות מרכזיים:
- יכולת התאמה מדהימה לעומס. Bigtable משתנה בהתאמה ישירה למספר המכונות באשכול. בהתקנה של HBase בניהול עצמי יש צוואר בקבוק בתכנון שמגביל את הביצועים אחרי שמגיעים לסף מסוים. ב-Bigtable אין את צוואר הבקבוק הזה, כך שאפשר להגדיל את האשכול כדי לטפל ביותר פעולות קריאה וכתיבה.
- ניהול פשוט. Bigtable מטפל בשדרוגים ובהפעלות מחדש באופן שקוף, ושומר באופן אוטומטי על עמידות גבוהה של הנתונים. כדי לשכפל את הנתונים, מוסיפים אשכול שני למכונה, והשכפול מתחיל באופן אוטומטי. לא צריך יותר לנהל רפליקות או אזורים, אלא רק לעצב את הסכימות של הטבלאות, ו-Bigtable יטפל בכל השאר.
- שינוי גודל האשכול בלי זמן השבתה. אתם יכולים להגדיל את האשכול של Bigtable לכמה שעות כדי להתמודד עם עומס גדול, ואז להקטין אותו שוב – בלי זמן השבתה. אחרי שמשנים את גודל האשכול, בדרך כלל לוקח ל-Bigtable רק כמה דקות תחת עומס כדי לאזן את הביצועים בין כל הצמתים באשכול.
- התאמה אוטומטית לעומס (Automatic scaling). אתם יכולים להגדיר את Bigtable כך שיעקוב באופן רציף אחרי קיבולת המעבד (CPU) של האשכול, ויתאים באופן אוטומטי את מספר הצמתים באשכול לפי הצורך.
- תקופת ניסיון בחינם. אתם יכולים לבדוק את התכונות והיכולות של Bigtable בחינם למשך 10 ימים, עם אפשרות להאריך את תקופת הניסיון בחינם ל-90 יום. ב-Bigtable יש מכונה לתקופת ניסיון בחינם עם אחסון SSD בנפח של עד 500GB ואשכול עם צומת אחד. אתם יכולים להשתמש בה כדי לבדוק את הביצועים של האפליקציה, על ידי הפעלה של פעולות קריאה וכתיבה בנפח גבוה בטבלאות של Bigtable, ולראות איך Bigtable מטפל בפעולות עם ביצועים שמגובים ב-SSD.
למה זה טוב
Bigtable מתאים במיוחד לאפליקציות שדורשות קצב העברת נתונים גבוה ויכולת התאמה לעומס (scalability) של נתוני מפתח/ערך, שבהם כל ערך הוא בדרך כלל לא יותר מ-10MB. Bigtable מצטיין גם כמנוע אחסון לפעולות MapReduce באצווה, לעיבוד ולניתוח של זרמי נתונים (stream processing) ולאפליקציות של למידת מכונה.
אתם יכולים להשתמש ב-Bigtable כדי לאחסן את כל סוגי הנתונים הבאים ולהריץ עליהם שאילתות:
- נתוני סדרות עתיות,כמו שימוש במעבד (CPU) ובזיכרון לאורך זמן בכמה שרתים.
- נתוני שיווק, כמו היסטוריית רכישות והעדפות של לקוחות.
- נתונים פיננסיים, כמו היסטוריית עסקאות, מחירי מניות ושערי חליפין.
- נתונים מהאינטרנט של הדברים, כמו דוחות שימוש ממוני אנרגיה ומכשירי חשמל ביתיים.
- נתוני תרשים, כמו מידע על האופן שבו המשתמשים מחוברים זה לזה.
מודל האחסון של Bigtable
ב-Bigtable הנתונים מאוחסנים בטבלאות עם יכולת התאמה נרחבת, שכל אחת מהן היא מפה ממוינת של מפתחות וערכים. הטבלה מורכבת משורות, שכל אחת מהן בדרך כלל מתארת ישות אחת, ומעמודות, שמכילות ערכים נפרדים לכל שורה. המערכת מוסיפה לאינדקס ערך אחד בכל שורה. הערך הזה נקרא מפתח שורה. עמודות שקשורות זו לזו בדרך כלל מקובצות לקבוצת עמודות. כל עמודה מזוהה באמצעות שילוב של קבוצת העמודות ומגדיר העמודה, שהוא שם ייחודי בתוך קבוצת העמודות.
כל הצטלבות של שורה ועמודה יכולה להכיל כמה תאים. כל תא מכיל גרסה ייחודית עם חותמת זמן של הנתונים בשורה ובעמודה האלה. אחסון של כמה תאים בעמודה מספק תיעוד של השינויים שחלו לאורך זמן בנתונים המאוחסנים בשורה ובעמודה האלה. הטבלאות ב-Bigtable הן חסכוניות (sparse) – אם לא משתמשים בעמודה בשורה מסוימת, היא לא תופסת מקום.
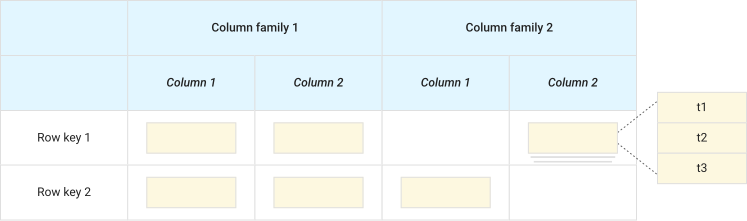
כמה דברים שכדאי לשים לב אליהם באיור הזה:
- יכול להיות שחלק מהעמודות לא יהיו בשימוש בשורה מסוימת.
- לכל תא בשורה ובעמודה נתונות יש חותמת זמן ייחודית (t).
הארכיטקטורה של Bigtable
התרשים הבא מציג גרסה פשוטה של ארכיטקטורת המשאבים הכוללת של Bigtable:
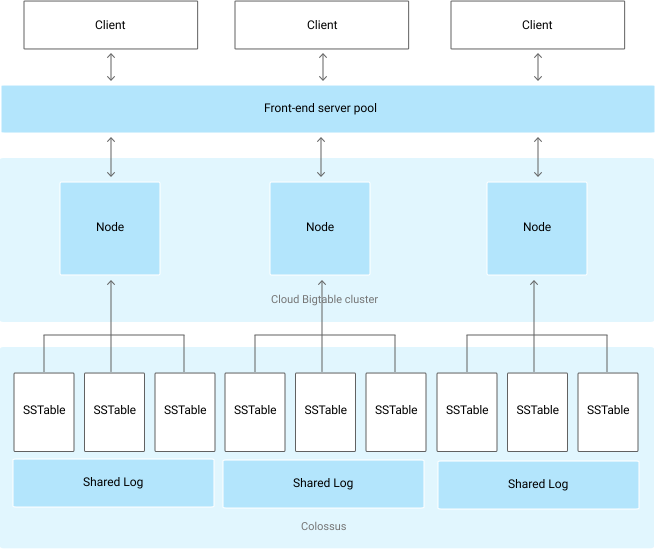
כפי שמוצג בתרשים, כל בקשות הלקוח עוברות דרך שרת חזיתי לפני שהן נשלחות לצומת Bigtable. (במאמר המקורי על Bigtable, הצמתים האלה נקראים "שרתי טאבלט"). הצמתים מאורגנים באשכול Bigtable, ששייך למכונה של Bigtable, קונטיינר לאשכול.
כל צומת באשכול מטפל בקבוצת משנה של הבקשות לאשכול. הוספת צמתים לאשכול מאפשרת להגדיל את מספר הבקשות שהאשכול יכול לטפל בהן בו-זמנית. הוספת צמתים גם מגדילה את התפוקה המקסימלית של האשכול. אם מפעילים רפליקציה על ידי הוספת אשכולות, אפשר גם לשלוח סוגים שונים של תנועה לאשכולות שונים. אם אחד מהאשכולות לא זמין, אפשר לעבור לאשכול אחר.
טבלה ב-Bigtable מחולקת לבלוקים של שורות סמוכות, שנקראים טאבלטים, כדי לאזן את עומס העבודה של השאילתות. (טבלאות דומות לאזורים ב-HBase). הטבלאות מאוחסנות ב-Colossus, מערכת קבצים שפותחה על ידי Google, בפורמט SSTable. טבלת SSTable מספקת מיפוי קבוע, מסודר ובלתי ניתן לשינוי ממפתחות לערכים, כאשר גם המפתחות וגם הערכים הם מחרוזות בייטים שרירותיות. כל טאבלט משויך לצומת Bigtable ספציפי. בנוסף לקובצי ה-SSTable, כל פעולות הכתיבה נשמרות ביומן המשותף של Colossus ברגע שהן מאושרות על ידי Bigtable, מה שמספק עמידות מוגברת.
חשוב לציין שהנתונים אף פעם לא מאוחסנים בצומתי Bigtable עצמם. לכל צומת יש מצביעים לקבוצת טבלאות שמאוחסנות ב-Colossus. כתוצאה מכך:
- האיזון מחדש של טבלאות מצומת אחד לאחר מתבצע במהירות, כי הנתונים עצמם לא מועתקים. Bigtable מעדכן את המצביעים של כל צומת.
- ההתאוששות מכשל בצומת Bigtable היא מהירה, כי צריך להעביר רק את המטא-נתונים לצומת החלופי.
- אם צומת ב-Bigtable נכשל, לא מאבדים נתונים.
למידע נוסף על אופן העבודה עם אבני הבניין הבסיסיות האלה, קראו את המאמר מכונות, אשכולות וצמתים. במאמר גישה לנתונים מוסבר איך לגשת לנתונים ברמות האלה.
איזון עומסים
כל אזור ב-Bigtable מנוהל על ידי תהליך ראשי, שמאזן את עומס העבודה ואת נפח הנתונים בתוך האשכולות. בתהליך הזה, טבלאות גדולות או עמוסות יותר מפוצלות לשניים, וטבלאות קטנות יותר או כאלה שהגישה אליהן פחות תכופה ממוזגות יחד, ומחולקות מחדש בין הצמתים לפי הצורך. אם טאבלט מסוים מקבל עלייה חדה בתנועה, Bigtable מפצל את הטאבלט לשניים, ואז מעביר אחד מהטאבלטים החדשים לצומת אחר. Bigtable מנהל את הפיצול, המיזוג והאיזון מחדש באופן אוטומטי, וחוסך לכם את המאמץ של ניהול ידני של הטאבלטים. במאמר הסבר על הביצועים מפורט מידע נוסף על התהליך הזה.
כדי לקבל את ביצועי הכתיבה הטובים ביותר מ-Bigtable, חשוב לפזר את פעולות הכתיבה באופן שווה ככל האפשר בין הצמתים. אחת הדרכים להשיג את המטרה הזו היא להשתמש במפתחות שורות שלא עוקבים אחרי סדר צפוי. לדוגמה, שמות משתמשים נוטים להתפזר באופן פחות או יותר שווה לאורך האלפבית, כך שהכללת שם משתמש בתחילת מפתח השורה תגרום לפיזור שווה של פעולות הכתיבה.
במקביל, כדאי לקבץ שורות קשורות כדי שהן יהיו זו לצד זו, מה שמאפשר לקרוא כמה שורות בו-זמנית בצורה יעילה יותר. לדוגמה, אם אתם מאחסנים סוגים שונים של נתוני מזג אוויר לאורך זמן, מפתח השורה יכול להיות המיקום שבו נאספו הנתונים, ואחריו חותמת זמן (לדוגמה, WashingtonDC#201803061617). מפתח שורה מהסוג הזה יקבץ את כל הנתונים ממיקום אחד לטווח רציף של שורות. במיקומים אחרים, השורה תתחיל במזהה אחר. מכיוון שבמיקומים רבים הנתונים נאספים באותו קצב, פעולות הכתיבה עדיין יתפרסו באופן שווה בין הטאבלטים.
במאמר בחירת מפתח שורה מוסבר איך לבחור מפתח שורה שמתאים לנתונים שלכם.
סוגי נתונים נתמכים
ברוב המקרים, Bigtable מתייחס לכל הנתונים כמחרוזות בייטים גולמיות. הפעם היחידה שבה Bigtable מנסה לקבוע את הסוג היא בפעולות של הגדלה, שבהן היעד חייב להיות מספר שלם של 64 ביט שמקודד כערך big-endian של 8 בייטים.
שימוש בזיכרון ובדיסק
בקטעים הבאים מוסבר איך כמה רכיבים של Bigtable משפיעים על השימוש בזיכרון ובדיסק במכונה.
עמודות שלא בשימוש
עמודות שלא משתמשים בהן בשורה ב-Bigtable לא תופסות מקום בשורה הזו. כל שורה היא למעשה אוסף של רשומות של מפתח/ערך, שבהן המפתח הוא שילוב של קבוצת העמודות, מגדיר העמודה וחותמת הזמן. אם שורה לא כוללת ערך לעמודה מסוימת, הרשומה של מפתח/ערך לא קיימת.
מגדירי העמודות
מגדירי העמודות תופסים מקום בשורה, כי כל מגדיר עמודה שמשתמשים בו בשורה מאוחסן בשורה הזו. לכן, לעיתים קרובות יעיל להשתמש במגדירי עמודות כנתונים.
מידע נוסף על מגדירי עמודות זמין במאמר עמודות.
דחיסות
Bigtable משכתב מדי פעם את הטבלאות כדי להסיר רשומות שנמחקו, ולארגן מחדש את הנתונים כך שפעולות הקריאה והכתיבה יהיו יעילות יותר. התהליך הזה נקרא דחיסה. אין הגדרות לדחיסות – Bigtable דוחס את הנתונים באופן אוטומטי. בממוצע, תהליך הדחיסה נמשך שבוע, ובמהלכו מתבצעות משימות כמו מחיקת נתונים.במהלך הדחיסה מתבצעות המחיקות שזוהו בתהליך איסוף האשפה. הדחיסה לא מתחילה את דחיסת הנתונים. Bigtable דוחס בלוקי נתונים באופן אוטומטי כשהם נשמרים באחסון. מידע נוסף זמין במאמרים דחיסת נתונים ואיסוף אשפה.
מוטציות ומחיקות
מוטציות, או שינויים, בשורה תופסות נפח אחסון נוסף, כי Bigtable מאחסן מוטציות ברצף ומכווץ אותן רק מדי פעם. כש-Bigtable דוחס טבלה, הוא מסיר ערכים שאין בהם יותר צורך. אם מעדכנים את הערך בתא, גם הערך המקורי וגם הערך החדש יישמרו בדיסק למשך זמן מסוים עד שהנתונים יידחסו.
גם מחיקות תופסות נפח אחסון נוסף, לפחות בטווח הקצר, כי מחיקות הן למעשה סוג מיוחד של מוטציה. עד שהטבלה נדחסת, המחיקה תופסת נפח אחסון נוסף במקום לפנות מקום.
דחיסת נתונים
כשנתונים נשמרים בדיסק, Bigtable דוחס אותם באופן אוטומטי באמצעות אלגוריתם חכם. אי אפשר לקבוע את הגדרות הדחיסה של הטבלה.
דחיסה לעומת דחיסה (compaction)
דחיסת נתונים שונה מדחיסת טבלאות:
הדחיסה מתבצעת באופן אוטומטי כשהנתונים נכתבים ונשמרים באחסון. הדחיסה מקטינה את הגודל הפיזי של בלוקי הנתונים בדיסק בבייטים. מדדי ניצול האחסון והחיובים משקפים את הגודל הדחוס הזה, ולא את הגודל הלוגי של הנתונים הלא דחוסים.
דחיסה היא תהליך תחזוקה אסינכרוני שמתבצע ברקע. במהלך הדחיסה, קובצי האחסון מתמזגים מדי פעם ונתונים שנמחקו או שפג תוקפם מוסרים באופן סופי. הדחיסה לא יוזמת דחיסת נתונים, כי הנתונים כבר מאוחסנים בצורה דחוסה.
כדאי לדעת איך לאחסן נתונים כדי שאפשר יהיה לדחוס אותם ביעילות:
אי אפשר לדחוס נתונים אקראיים ביעילות כמו נתונים עם דפוסים. נתונים עם דפוסים כוללים טקסט, כמו הדף שאתם קוראים עכשיו.
הדחיסה פועלת בצורה הטובה ביותר אם ערכים זהים נמצאים קרוב זה לזה, באותה שורה או בשורות סמוכות. אם תסדרו את מפתחות השורות כך ששורות עם מקטעי נתונים זהים יהיו זו לצד זו, הנתונים יידחסו בצורה יעילה.
Bigtable דוחס ערכים בגודל של עד 1MiB. אם אתם מאחסנים ערכים שגדולים מ-1MiB, כדאי לדחוס אותם לפני שכותבים אותם ב-Bigtable, כדי לחסוך במחזורי מעבד (CPU), בזיכרון השרת וברוחב הפס של הרשת.
עמידות הנתונים
כשאתם משתמשים ב-Bigtable, הנתונים שלכם מאוחסנים ב-Colossus, מערכת קבצים עמידה מאוד שפותחה על ידי Google, באמצעות התקני אחסון במרכזי הנתונים שלCloud de Confiance by S3NS. כדי להשתמש ב-Bigtable, לא צריך להפעיל אשכול HDFS או כל מערכת קבצים אחרת. מאחורי הקלעים, Colossus משתמש בשיטות אחסון קנייניות כדי להשיג עמידות נתונים מעבר למה שמספקת רפליקציה תלת-כיוונית רגילה של HDFS.
העמידות משתפרת עוד יותר כשמשתמשים ברפליקציה. ב-Bigtable נשמר עותק נפרד של הנתונים במיקום שבחרתם לכל אשכול של מכונה משוכפלת.
מודל העקביות
מכונות Bigtable עם אשכול יחיד מספקות עקביות חזקה. כברירת מחדל, מכונות עם יותר מאשכול אחד מספקות מודל עקביות הדרגתי, אבל בתרחישי שימוש מסוימים אפשר להגדיר אותן כך שיספקו עקביות של קריאת הנתונים שנכתבו או מודל עקביות חזק, בהתאם לעומס העבודה ולהגדרות של פרופיל האפליקציה.
אבטחה
הגישה לטבלאות Bigtable נשלטת על ידי הפרויקט ב- Cloud de Confiance by S3NSוהתפקידים בממשק לניהול זהויות והרשאות גישה (IAM) שאתם מקצים למשתמשים. לדוגמה, אתם יכולים להקצות תפקידי IAM שמונעים ממשתמשים ספציפיים לקרוא מטבלאות, לכתוב לטבלאות או ליצור מכונות חדשות. אם למישהו אין גישה לפרויקט שלכם או שאין לו תפקיד ב-IAM עם הרשאות מתאימות ל-Bigtable, הוא לא יכול לגשת לאף אחת מהטבלאות שלכם.
אפשר לנהל את האבטחה ברמת הפרויקט, המכונה והטבלה. ב-Bigtable אין תמיכה בהגבלות אבטחה ברמת השורה, העמודה או התא.הצפנה
כברירת מחדל, כל הנתונים שמאוחסנים ב- Cloud de Confiance, כולל הנתונים בטבלאות Bigtable, מוצפנים במצב מנוחה באמצעות אותן מערכות מוקשחות לניהול מפתחות שבהן אנחנו משתמשים לנתונים המוצפנים שלנו.
אם אתם רוצים יותר שליטה במפתחות שמשמשים להצפנת הנתונים שלכם במצב מנוחה ב-Bigtable, אתם יכולים להשתמש במפתחות הצפנה בניהול הלקוח (CMEK).
גיבויים
גיבויים ב-Bigtable מאפשרים לשמור עותק של הסכימה והנתונים של טבלה, ואז לשחזר אותם לטבלה חדשה במועד מאוחר יותר. באמצעות גיבויים, אתם יכולים לשחזר לטבלה חדשה בכל אזור או פרויקט שבהם יש לכם מכונה של Bigtable, בלי קשר למיקום של טבלת המקור.
ניתוב בקשות באמצעות פרופילים של אפליקציות
מדיניות הניתוב של פרופיל האפליקציה מאפשרת לכם לקבוע אילו אשכולות יטפלו בבקשות הנכנסות מהאפליקציות שלכם. ב-Bigtable יש את הסוגים הבאים של פרופילי אפליקציות, בהתאם למודל החישוב שבו משתמשים:
פרופילי אפליקציות רגילים: משתמשים בצומתי אשכולות שהוקצו כדי לטפל בבקשות. הם תומכים במדיניות הניתוב הבאה:
ניתוב לאשכול יחיד: כל הבקשות נשלחות לאשכול יחיד.
ניתוב לכמה אשכולות, לכל אשכול: שולח בקשות לאשכול הזמין הקרוב ביותר במכונה, מבין כל האשכולות או מבין קבוצת אשכולות מסוימת.
פרופילי אפליקציות של Data Boost: שימוש במחשוב בלי שרת (serverless computing) במקום בצמתים של האשכול כדי לבודד משימות קריאה עם תפוקה גבוהה מהתנועה של האפליקציה העיקרית. הפרופילים האלה מוגבלים למדיניות ניתוב של אשכול יחיד.
אפשרויות אחרות לאחסון ולמסדי נתונים
Bigtable הוא לא מסד נתונים רלציוני רגיל. יכול להיות שתרחישי שימוש מסוימים יתאימו יותר לאפשרות אחרת של מסד נתונים.
- אם אתם צריכים שאילתות אינטראקטיביות במערכת עיבוד אנליטי אונליין (OLAP), כדאי להשתמש ב-BigQuery.
למידע נוסף על אפשרויות אחרות של מסדי נתונים, קראו את הסקירה הכללית על שירותי מסדי נתונים. ב- Cloud de Confiance by S3NS יש גם אפשרויות אחסון שונות.
המאמרים הבאים
- מידע ולמידה על השוואה בין Bigtable ב- Cloud de Confiance ל-Google Cloud
- נסו את המדריך למתחילים של Bigtable באמצעות ה-CLI של
cbt, כלי שורת הפקודה של Bigtable. - מידע על מכונות, אשכולות וצמתים ב-Bigtable
- איך יוצרים מכונה של Bigtable
- איך עוברים ל-Bigtable
- מידע על ספריות הלקוח של Cloud Bigtable
- המאמר המקורי של OSDI על Bigtable.