

שיטות מומלצות לעיצוב סכימה
סכימת Bigtable יעילה מאפשרת למקסם את קצב העברת הנתונים (throughput) של קריאה וכתיבה, למנוע נקודות חמות ולשנות את גודל האחסון בצורה יעילה. לפני שמתחילים, מומלץ לעיין בסקירה הכללית על Bigtable כדי להבין את הארכיטקטורה ואת מודל האחסון הבסיסיים.
מושגים כלליים
עיצוב סכימה ב-Bigtable שונה מעיצוב סכימה במסד נתונים רלציוני. סכימת Bigtable מוגדרת על ידי לוגיקת האפליקציה ולא על ידי אובייקט או קובץ של הגדרת סכימה. אפשר להוסיף משפחות עמודות לטבלה כשיוצרים או מעדכנים את הטבלה, אבל העמודות והדפוסים של מפתחות השורות מוגדרים לפי הנתונים שכותבים לטבלה.
ב-Bigtable, סכימה היא תוכנית או מודל של טבלה, כולל המבנה של רכיבי הטבלה הבאים:
- מפתחות שורה
- משפחות עמודות, כולל מדיניות איסוף האשפה שלהן
- Columns
ב-Bigtable, עיצוב הסכימה מבוסס בעיקר על שאילתות או על בקשות קריאה שאתם מתכננים לשלוח לטבלה. קריאת טווח שורות היא הדרך הכי מהירה לקרוא את הנתונים ב-Bigtable, ולכן ההמלצות בדף הזה נועדו לעזור לכם לבצע אופטימיזציה לקריאות של טווח שורות. ברוב המקרים, המשמעות היא שליחת שאילתה שמבוססת על קידומות של מפתחות שורה.
שיקול משני הוא הימנעות מנקודות חמות – כדי למנוע נקודות חמות, צריך לשקול דפוסי כתיבה ולחשוב איך אפשר להימנע מגישה למרחב קטן של מפתחות בפרק זמן קצר.
המושגים הכלליים הבאים רלוונטיים לעיצוב סכימת Bigtable:
- Bigtable הוא מאגר של זוגות מפתח/ערך, ולא מאגר יחסי. הוא לא תומך בצירופים, והתמיכה בעסקאות מוגבלת לשורה אחת בלבד.
- לכל טבלה יש אינדקס: מפתח השורה. כל מפתח שורה חייב להיות ייחודי. כדי ליצור אינדקס משני, משתמשים בתצוגה חומרית רציפה. מידע נוסף זמין במאמר יצירת אינדקס משני אסינכרוני.
- מפתחות השורות ממיינים את השורות בסדר לקסיקוגרפי מהבייט הנמוך ביותר למחרוזת הבייט הגבוהה ביותר. הסדר הזה הוא big-endian (לפעמים נקרא סדר בייטים ברשת), שהוא המקבילה הבינארית של סדר אלפביתי.
- משפחות העמודות לא מאוחסנות בסדר מסוים.
- העמודות מקובצות לפי משפחת עמודות וממוינות בסדר לקסיקוגרפי בתוך משפחת העמודות. לדוגמה, במשפחת עמודות בשם
SysMonitorעם מזהי עמודותProcessName,User,%CPU,ID,Memory,DiskReadו-Priority, Bigtable מאחסן את העמודות בסדר הזה:
| SysMonitor | ||||||
|---|---|---|---|---|---|---|
| %CPU | DiskRead | מזהה | זיכרון | עדיפות | ProcessName | משתמש |
- הצומת של שורה ועמודה יכול להכיל כמה תאים עם חותמת זמן. כל תא מכיל גרסה ייחודית של הנתונים עם חותמת זמן, שמתייחסת לשורה ולעמודה הספציפיות.
- משפחות עמודות של צבירה מכילות תאים של צבירה. אפשר ליצור משפחות של עמודות שמכילות רק תאים של נתונים מצטברים. פונקציית צבירה מאפשרת לכם למזג נתונים חדשים עם נתונים שכבר נמצאים בתא.
- כל הפעולות הן אטומיות ברמת השורה. פעולה משפיעה על שורה שלמה או לא משפיעה על אף חלק בשורה.
- באופן אידיאלי, פעולות הקריאה והכתיבה צריכות להתבצע באופן שווה בטווח השורות של הטבלה.
- טבלאות Bigtable הן דלילות. עמודה לא תופסת מקום בשורה שלא נעשה בה שימוש בעמודה.
שיטות מומלצות
סכימה טובה מובילה לביצועים ולמדרגיות מצוינים, וסכימה שתוכננה בצורה לא טובה עלולה להוביל למערכת עם ביצועים נמוכים. כל תרחיש שימוש הוא שונה ודורש עיצוב משלו, אבל השיטות המומלצות הבאות רלוונטיות לרוב תרחישי השימוש. החריגים מצוינים.
בקטעים הבאים מפורטות שיטות מומלצות לעיצוב סכימה, החל מרמת הטבלה ועד לרמת מפתח השורה:
צריך לתכנן את כל רכיבי הטבלה, במיוחד מפתחות השורות, בהתאם לבקשות הקריאה המתוכננות. במאמר בנושא מכסות ומגבלות מפורטות מגבלות הגודל המומלצות והקשיחות לכל רכיבי הטבלה.
מכיוון שכל הטבלאות במופע מאוחסנות באותם טאבלטים, עיצוב סכימה שיוצר נקודות חמות בטבלה אחת יכול להשפיע על זמן האחזור של טבלאות אחרות באותו מופע. המונח 'נקודות חמות' מתייחס למצב שבו יש גישה תכופה לחלק אחד בטבלה בפרק זמן קצר.
Tables
אחסון מערכי נתונים עם סכימות דומות באותה טבלה, במקום בטבלאות נפרדות.
במערכות אחרות של מסדי נתונים, יכול להיות שתבחרו לאחסן נתונים בכמה טבלאות, בהתאם לנושא ולמספר העמודות. לעומת זאת, ב-Bigtable, בדרך כלל עדיף לאחסן את כל הנתונים בטבלה אחת. אתם יכולים להקצות קידומת ייחודית של מפתח שורה לשימוש בכל קבוצת נתונים, כך ש-Bigtable יאחסן את הנתונים הקשורים בטווח רציף של שורות שאפשר לשלוח עליהן שאילתות לפי קידומת של מפתח שורה.
ב-Bigtable יש מגבלה של 1,000 טבלאות לכל מופע, אבל מומלץ להימנע מיצירה של מספר גדול של טבלאות מהסיבות הבאות:
- שליחת בקשות להרבה טבלאות שונות יכולה להגדיל את התקורה של החיבור לקצה העורפי, וכתוצאה מכך להגדיל את זמן האחזור של הזנב.
- יצירת טבלאות נוספות לא משפרת את איזון העומסים, ויכולה להגדיל את תקורה הניהול.
יכול להיות שתרצו ליצור טבלה נפרדת לתרחיש שימוש אחר שדורש סכימה שונה, אבל לא מומלץ להשתמש בטבלאות נפרדות לנתונים דומים. לדוגמה, לא כדאי ליצור טבלה חדשה כי השנה התחלפה או כי יש לכם לקוח חדש.
משפחות עמודות
כדאי להוסיף עמודות קשורות לאותה קבוצת עמודות. כששורה מכילה כמה ערכים שקשורים זה לזה, מומלץ לקבץ את העמודות שמכילות את הערכים האלה באותה משפחת עמודות. כדאי לקבץ את הנתונים בצורה הכי קרובה שאפשר כדי שלא תצטרכו לתכנן מסננים מורכבים, וכדי שתקבלו רק את המידע שאתם צריכים, ולא יותר מזה, בבקשות הקריאה הכי נפוצות שלכם.
אפשר ליצור עד כ-100 משפחות עמודות לכל טבלה. יצירה של יותר מ-100 משפחות עמודות עלולה לגרום לירידה בביצועים.
בחירת שמות קצרים למשפחות העמודות השמות נכללים בנתונים שמועברים בכל בקשה.
כדאי להוסיף עמודות עם צרכים שונים של שמירת נתונים למשפחות עמודות שונות. השיטה הזו חשובה אם רוצים להגביל את עלויות האחסון. מדיניות איסוף האשפה מוגדרת ברמת משפחת העמודות, ולא ברמת העמודה. לדוגמה, אם אתם צריכים לשמור רק את הגרסה האחרונה של נתון מסוים, אל תשמרו אותו בעמודה שמוגדרת לשמירה של 1,000 גרסאות של משהו אחר. אחרת, אתם משלמים על אחסון של 999 תאים של נתונים שאתם לא צריכים.
Columns
יוצרים כמה עמודות שרוצים בטבלה. טבלאות Bigtable הן דלילות, ואין קנס על שטח אחסון של עמודה שלא נעשה בה שימוש בשורה. אתם יכולים להוסיף לטבלה מיליוני עמודות, כל עוד אף שורה לא חורגת מהמגבלה המקסימלית של 256MB לכל שורה.
אל תשתמשו ביותר מדי עמודות בשורה אחת. למרות שלטבלה יכולות להיות מיליוני עמודות, לשורה לא. יש כמה גורמים שמשפיעים על השיטה המומלצת הזו:
- לוקח זמן ל-Bigtable לעבד כל תא בשורה.
- כל תא מוסיף תקורה מסוימת לכמות הנתונים שמאוחסנים בטבלה ונשלחים ברשת. לדוגמה, אם מאחסנים נתונים בגודל 1KB (1,024 בייט), הרבה יותר יעיל לאחסן את הנתונים האלה בתא אחד, במקום לפצל אותם ל-1,024 תאים שכל אחד מהם מכיל בייט אחד.
אם מבחינה לוגית קבוצת הנתונים שלכם דורשת יותר עמודות לכל שורה ממה ש-Bigtable יכול לעבד ביעילות, כדאי לשקול לאחסן את הנתונים כ-protobuf בעמודה אחת.
אופציונלי: אפשר להתייחס למסווגי העמודות כאל נתונים. מכיוון שצריך לאחסן מזהה עמודה לכל עמודה, אפשר לחסוך מקום על ידי מתן שם לעמודה עם ערך. לדוגמה, נניח שיש טבלה שמאחסנת נתונים על חברויות בFriends קבוצת עמודות. כל שורה מייצגת אדם ואת כל החברויות שלו. כל מגדיר עמודה יכול להיות המזהה של חבר. אז הערך של כל עמודה בשורה הזו יכול להיות המעגל החברתי שהחבר נמצא בו. בדוגמה הזו, השורות יכולות להיראות כך:
| מפתח שורה | Fred | גבריאל | הירושי | Seo Yoon | יעקב |
|---|---|---|---|---|---|
| Jose | מועדון הספר הטוב | עבודה | טניס | ||
| סופיה | עבודה | בית ספר | chess-club |
הנה סכימה של אותם נתונים שבה לא מתייחסים למסווגי העמודות כנתונים, ובמקום זאת יש את אותן עמודות בכל שורה:
| מפתח שורה | חבר | להקיף בעיגול |
|---|---|---|
| Jose#1 | Fred | מועדון הספר הטוב |
| Jose#2 | גבריאל | עבודה |
| Jose#3 | הירושי | טניס |
| Sofia#1 | הירושי | עבודה |
| Sofia#2 | Seo Yoon | בית ספר |
| Sofia#3 | יעקב | chess-club |
העיצוב השני של הסכימה גורם לטבלה לגדול הרבה יותר מהר.
אם משתמשים במאפייני עמודה כדי לאחסן נתונים, חשוב לתת למאפייני העמודה שמות קצרים אבל בעלי משמעות. הגישה הזו מאפשרת לכם לצמצם את כמות הנתונים שמועברת בכל בקשה. הגודל המקסימלי הוא 16KB.
Rows
הגודל של כל הערכים בשורה אחת צריך להיות קטן מ-100MB. מוודאים שגודל הנתונים בשורה אחת לא חורג מ-256MB. אם יש שורות שחורגות מהמגבלה הזו, יכול להיות שביצועי הקריאה ירדו.
כל המידע על ישות מסוימת צריך להיות בשורה אחת. ברוב התרחישים לדוגמה, כדי להימנע מחוסר עקביות, לא מומלץ לאחסן נתונים שצריך לקרוא באופן אטומי או בבת אחת ביותר משורה אחת. לדוגמה, אם מעדכנים שתי שורות בטבלה, יכול להיות ששורה אחת תעודכן בהצלחה והעדכון של השורה השנייה ייכשל. מוודאים שהסכימה לא דורשת יותר משורה אחת לעדכון בו-זמנית כדי שהנתונים הקשורים יהיו מדויקים. השיטה הזו מבטיחה שאם חלק מבקשת כתיבה נכשל או שצריך לשלוח אותו שוב, הנתונים האלה לא יהיו חסרים באופן זמני.
יוצא מן הכלל: אם שמירת ישות בשורה אחת מובילה לשורות בגודל של מאות מגה-בייט, צריך לפצל את הנתונים לכמה שורות.
אחסון ישויות קשורות בשורות סמוכות,כדי לייעל את הקריאות.
תאים
לא לאחסן יותר מ-10MB של נתונים בתא אחד. תזכורת: תא הוא הנתונים שמאוחסנים בשורה ובעמודה מסוימות עם חותמת זמן ייחודית, ויכולים להיות כמה תאים שמאוחסנים בנקודת החיתוך של השורה והעמודה. מספר התאים שנשמרים בעמודה נקבע לפי מדיניות איסוף הגרוטאות שהגדרתם עבור משפחת העמודות שמכילה את העמודה הזו.
שימוש בתאים מצטברים לאחסון ולעדכון של נתונים מצטברים. אם אתם רוצים לראות רק את הערך המצטבר של אירועים עבור ישות מסוימת, כמו הסכום החודשי של מכירות לכל עובד בחנות קמעונאית, אתם יכולים להשתמש באגרגטים. מידע נוסף מופיע במאמר בנושא צבירת ערכים בזמן הכתיבה.
מפתחות שורה
מעצבים את מפתח השורה על סמך השאילתות שבהן תשתמשו כדי לאחזר את הנתונים. מפתחות שורות שמעוצבים היטב מאפשרים להפיק את הביצועים הכי טובים מ-Bigtable. השאילתות הכי יעילות ב-Bigtable שולפות נתונים באמצעות אחת מהאפשרויות הבאות:
- מפתח שורה
- קידומת של מפתח שורה
- טווח השורות שמוגדר על ידי מפתחות השורות של ההתחלה והסיום
סוגים אחרים של שאילתות מפעילים סריקה מלאה של הטבלה, שהיא הרבה פחות יעילה. אם תבחרו עכשיו את מפתח השורה הנכון, תוכלו להימנע מתהליך מייגע של העברת נתונים בהמשך.
השתמשו במפתחות שורות קצרים. מפתח שורה צריך להיות בגודל של עד 4KB. מפתחות שורה ארוכים תופסים יותר זיכרון ואחסון, ומאריכים את הזמן שלוקח לקבל תשובות משרת Bigtable.
אחסון של כמה ערכים מופרדים בכל מפתח שורה. הדרך הכי יעילה לשלוח שאילתות ל-Bigtable היא באמצעות מפתח שורה, ולכן כדאי לכלול במפתח השורה כמה מזהים. אם מפתח השורה כולל כמה ערכים, חשוב במיוחד להבין בבירור איך אתם משתמשים בנתונים.
בדרך כלל יש תו מפריד בין פלחי מפתח השורה, כמו נקודתיים, לוכסן או סולמית. המקטע הראשון או קבוצת המקטעים הרציפים הראשונה הם הקידומת של מפתח השורה, והמקטע האחרון או קבוצת המקטעים הרציפים האחרונה הם הסיומת של מפתח השורה.
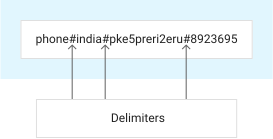
תחיליות מתוכננות היטב של מפתחות שורות מאפשרות לכם לנצל את סדר המיון המובנה של Bigtable כדי לאחסן נתונים קשורים בשורות סמוכות. אחסון נתונים קשורים בשורות סמוכות מאפשר גישה לנתונים קשורים כטווח של שורות, במקום להריץ סריקות לא יעילות של טבלאות.
אם הנתונים כוללים מספרים שלמים שרוצים לאחסן או למיין בסדר מספרי, צריך להוסיף אפסים מובילים למספרים השלמים. Bigtable מאחסן נתונים בסדר לקסיקוגרפי. לדוגמה, בסדר לקסיקוגרפי, 3 > 20 אבל 20 > 03. הוספת אפס לפני המספר 3 מבטיחה שהמספרים ימוינו בסדר מספרי. הטקטיקה הזו חשובה לחותמות זמן שבהן נעשה שימוש בשאילתות מבוססות-טווח.
חשוב ליצור מפתח שורה שמאפשר לאחזר טווח מוגדר היטב של שורות. אחרת, השאילתה תדרוש סריקה של הטבלה, שהיא הרבה יותר איטית מאחזור של שורות ספציפיות.
לדוגמה, אם האפליקציה שלכם עוקבת אחרי נתונים של מכשירים ניידים, יכול להיות שיש לכם מפתח שורה שכולל את סוג המכשיר, מזהה המכשיר והיום שבו הנתונים נרשמו. מפתחות השורות של הנתונים האלה עשויים להיראות כך:
        phone#4c410523#20200501
        phone#4c410523#20200502
        tablet#a0b81f74#20200501
        tablet#a0b81f74#20200502
העיצוב הזה של מפתח השורה מאפשר לאחזר נתונים באמצעות בקשה אחת עבור:
- סוג המכשיר
- שילוב של סוג המכשיר ומזהה המכשיר
העיצוב הזה של מפתח השורה לא יהיה אופטימלי אם רוצים לאחזר את כל הנתונים של יום מסוים. היום מאוחסן בפלח השלישי, או בסיומת של מפתח השורה, ולכן אי אפשר לבקש טווח של שורות על סמך הסיומת או פלח אמצעי של מפתח השורה. במקום זאת, צריך לשלוח בקשת קריאה עם מסנן שסורק את כל הטבלה בחיפוש אחר ערך היום.
כדאי להשתמש בערכי מחרוזת קריאים לאנשים במפתחות השורות, כשאפשר. השיטה הזו מקלה על השימוש בכלי Key Visualizer כדי לפתור בעיות ב-Bigtable.
לרוב, כדאי לעצב מפתחות שורות שמתחילים בערך משותף ומסתיימים בערך גרנולרי. לדוגמה, אם מפתח השורה כולל יבשת, מדינה ועיר, אפשר ליצור מפתחות שורה שנראים כך, כדי שהם ימוינו אוטומטית קודם לפי ערכים עם קרדינליות נמוכה יותר:
        asia#india#bangalore
        asia#india#mumbai
        asia#japan#osaka
        asia#japan#sapporo
        southamerica#bolivia#cochabamba
        southamerica#bolivia#lapaz
        southamerica#chile#santiago
        southamerica#chile#temuco
מפתחות שורות מובנים
אם אתם מתכננים להריץ שאילתות בטבלה באמצעות SQL, אתם יכולים להגדיר מפתחות שורות מובְנים, שמאפשרים לכם לגשת לנתוני Bigtable באמצעות מפתחות מרובי חלקים, בדומה למפתחות מורכבים במסדי נתונים רלציוניים. הגדרת מפתחות שורות מובנים בטבלה מאפשרת לכם לגשת לפלחים ספציפיים של מפתחות השורות באמצעות GoogleSQL לשאילתות Bigtable.
מפתחות שורות מובנים נוצרים באופן אוטומטי כשיוצרים תצוגה חומרית רציפה. כדי להטמיע מפתחות שורות מובנים בטבלת Bigtable, אפשר ליצור סכימת מפתחות שורות שמגדירה את סוג הנתונים והקידוד של כל פלח במפתח השורה. ב-Bigtable, מפתחות השורות מאוחסנים כבייטים ממוינים לקסיקוגרפית, וסכימת מפתחות השורות מציינת ל-GoogleSQL for Bigtable איך לפענח ולפרש את הבייטים האלה.
כשמבצעים שאילתה בטבלה באמצעות method ReadRows של Bigtable Data API עם ספריית לקוח של Bigtable, המערכת מתעלמת מסכימות של מפתחות שורות.
מידע נוסף זמין במאמרים בנושא ניהול סכימות של מפתחות שורות ושאילתות מובנות של מפתחות שורות.
מפתחות שורות שכדאי להימנע מהם
סוגים מסוימים של מפתחות שורה יכולים להקשות על שליפת הנתונים, וחלקם מובילים לביצועים נמוכים. בקטע הזה מתוארים כמה סוגים של מפתחות שורות שכדאי להימנע משימוש בהם ב-Bigtable.
מפתחות שורה שמתחילים בחותמת זמן. הדפוס הזה גורם לכך שפעולות כתיבה רציפות נדחפות לצומת יחיד, ויוצרות נקודה חמה. אם אתם מוסיפים חותמת זמן למפתח שורה, הקדימו אותה בערך בעל עוצמה גבוהה, כמו מזהה משתמש, כדי להימנע מנקודות חמות.
מפתחות שורות שגורמים לכך שנתונים קשורים לא מקובצים. מומלץ להימנע ממפתחות שורות שגורמים לאחסון של נתונים קשורים בטווחים לא סמוכים של שורות, כי קשה לקרוא אותם ביחד.
מזהים מספריים עוקבים. נניח שהמערכת שלכם מקצה מזהה מספרי לכל אחד מהמשתמשים באפליקציה. יכול להיות שתתפתו להשתמש במזהה המספרי של המשתמש כמפתח השורה בטבלה. עם זאת, מכיוון שיש סיכוי גבוה יותר שמשתמשים חדשים יהיו משתמשים פעילים, סביר להניח שהגישה הזו תדחוף את רוב התנועה שלכם למספר קטן של צמתים.
גישה בטוחה יותר היא להשתמש בגרסה הפוכה של המזהה המספרי של המשתמש, וכך התנועה מתפזרת בצורה אחידה יותר בכל הצמתים של טבלת Bigtable.
מזהים שמתעדכנים בתדירות גבוהה. אל תשתמשו במפתח שורה יחיד כדי לזהות ערך שצריך לעדכן לעיתים קרובות. לדוגמה, אם אתם מאחסנים נתונים של שימוש בזיכרון
למספר מכשירים פעם בשנייה, אל תשתמשו במפתח שורה יחיד לכל מכשיר שמורכב ממזהה המכשיר וממדד שמאוחסן, כמו 4c410523#memusage, ותעדכנו את השורה שוב ושוב. סוג הפעולה הזה גורם לעומס יתר בטאבלט שבו מאוחסנת השורה שנעשה בה שימוש בתדירות גבוהה. היא גם יכולה לגרום לשורה לחרוג ממגבלת הגודל שלה, כי הערכים הקודמים של העמודה תופסים מקום עד שהתאים מוסרים במהלך איסוף האשפה.
במקום זאת, מאחסנים כל קריאה חדשה בשורה חדשה. בדוגמה של השימוש בזיכרון, כל מפתח שורה יכול להכיל את מזהה המכשיר, את סוג המדד ואת חותמת הזמן, כך שמפתחות השורה דומים ל-4c410523#memusage#1423523569918. השיטה הזו יעילה כי ב-Bigtable, יצירת שורה חדשה לא לוקחת יותר זמן מיצירת תא חדש. בנוסף, שיטת הבידינג הזו מאפשרת לכם לקרוא במהירות נתונים מטווח תאריכים ספציפי על ידי חישוב של מפתחות ההתחלה והסיום המתאימים.
לערכים שמשתנים לעיתים קרובות, כמו מונה שמתעדכן מאות פעמים בכל דקה, מומלץ לשמור את הנתונים בזיכרון, בשכבת האפליקציה, ולכתוב שורות חדשות ב-Bigtable באופן תקופתי.
ערכים מגובבים (hashed). ביצוע גיבוב (hashing) של מפתח שורה מבטל את היכולת שלכם לנצל את סדר המיון הטבעי של Bigtable, ולכן אי אפשר לאחסן שורות בצורה אופטימלית לביצוע שאילתות. מאותה סיבה, ערכי גיבוב מקשים על השימוש בכלי Key Visualizer כדי לפתור בעיות עם Bigtable. השתמשו בערכים שקריאים לאנשים במקום בערכים מגובבים.
הערכים מבוטאים בבייטים גולמיים ולא במחרוזות שאנשים יכולים לקרוא. בסדר להשתמש בבייטים גולמיים לערכי עמודות, אבל כדי שיהיה קל לקרוא ולפתור בעיות, כדאי להשתמש בערכי מחרוזות במפתחות שורות.
תרחישי שימוש מיוחדים
יכול להיות שיש לכם קבוצת נתונים ייחודית שדורשת התייחסות מיוחדת כשמעצבים סכימה לאחסון שלה ב-Bigtable. בקטע הזה מתוארים כמה סוגים של נתונים ב-Bigtable, אבל לא כולם, ומוצעות כמה שיטות לאחסון הנתונים בצורה האופטימלית ביותר.
נתונים מבוססי-זמן
אם אתם מאחזרים נתונים לעיתים קרובות על סמך הזמן שבו הם נרשמו, אתם יכולים לכלול חותמת זמן כחלק ממפתח השורה.
לדוגמה, יכול להיות שהאפליקציה שלכם תתעד נתונים שקשורים לביצועים, כמו השימוש במעבד ובזיכרון, פעם בשנייה עבור הרבה מכונות. מפתח השורה של הנתונים האלה יכול לשלב מזהה של המכונה עם חותמת זמן של הנתונים (לדוגמה, machine_4223421#1425330757685). חשוב לזכור שמפתחות השורה ממוינים לקסיקוגרפית.
אם כוללים חותמות זמן במפתח השורה, אסור להשתמש בחותמת זמן לבד או בתחילת מפתח השורה. הדפוס הזה גורם לכך שפעולות כתיבה רציפות נדחפות לצומת יחיד, ויוצרות נקודה חמה.
אם בדרך כלל אתם מאחזרים את הרשומות האחרונות קודם בשאילתות, כדאי לשקול להשתמש בחותמות זמן הפוכות במפתח השורה. הדפוס הזה גורם לכך שהשורות יסודרו מהעדכנית ביותר לישנה ביותר, כך שהנתונים העדכניים יותר יופיעו מוקדם יותר בטבלה. כמו בכל חותמת זמן, אל תתחילו מפתח שורה עם חותמת זמן הפוכה כדי שלא תיצרו נקודות חמות.
אפשר לקבל חותמת זמן הפוכה על ידי הפחתת חותמת הזמן מהערך המקסימלי של מספרים שלמים ארוכים בשפת התכנות (ב-Java, java.lang.Long.MAX_VALUE).
מידע ספציפי על עבודה עם נתוני סדרות זמנים זמין במאמר תכנון סכימה לנתוני סדרות זמנים.
ריבוי דיירים
קידומות של מפתחות שורה מספקות פתרון ניתן להרחבה לתרחיש שימוש של 'ריבוי דיירים', שבו מאחסנים נתונים דומים, באמצעות אותו מודל נתונים, בשם של כמה לקוחות. השיטה הכי יעילה לאחסון נתונים של כמה דיירים ולגישה אליהם היא שימוש בטבלה אחת לכל הדיירים.
לדוגמה, נניח שאתם מאחסנים ועוקבים אחרי היסטוריית רכישות בשם הרבה חברות. אפשר להשתמש במזהה הייחודי של כל חברה כקידומת של מפתח שורה. כל הנתונים של דייר מאוחסנים בשורות רצופות באותה טבלה, ואפשר לבצע שאילתות או סינון באמצעות התחילית של מפתח השורה. לאחר מכן, אם חברה מסוימת כבר לא לקוחה שלכם ואתם רוצים למחוק את נתוני היסטוריית הרכישות שאחסנתם לגביה, אתם יכולים להסיר את טווח השורות שמשתמשות בקידומת של מפתח השורה של הלקוח הזה.
לדוגמה, אם אתם מאחסנים נתונים של מכשירים ניידים עבור לקוחות altostrat ו-examplepetstore, אתם יכולים ליצור מפתחות שורות כמו אלה. לאחר מכן, אם altostrat כבר לא לקוח שלכם, אתם משמיטים את כל השורות עם קידומת מפתח השורה altostrat.
        altostrat#phone#4c410523#20190501
        altostrat#phone#4c410523#20190502
        altostrat#tablet#a0b41f74#20190501
        examplepetstore#phone#4c410523#20190502
        examplepetstore#tablet#a6b81f79#20190501
        examplepetstore#tablet#a0b81f79#20190502
לעומת זאת, אם אתם שומרים נתונים בשם כל חברה בטבלה משלה, יכול להיות שתיתקלו בבעיות בביצועים ובמדרגיות. בנוסף, יש סיכוי גבוה יותר שתגיעו למגבלה של Bigtable של 1,000 טבלאות לכל מופע. אחרי שמגיעים למגבלה הזו, Bigtable מונע יצירה של טבלאות נוספות במופע.
פרטיות
אלא אם תרחיש השימוש שלכם מחייב זאת, אל תשתמשו בפרטים אישיים מזהים (PII) או בנתוני משתמשים במפתחות שורות או במזהים של משפחות עמודות. הערכים במפתחות השורות ובמשפחות העמודות הם נתוני לקוחות ונתוני שירות, ואפליקציות שמשתמשות בהם, כמו הצפנה או רישום ביומן, עלולות לחשוף אותם בטעות למשתמשים שלא אמורה להיות להם גישה לנתונים פרטיים.
מידע נוסף על האופן שבו אנחנו מטפלים בנתוני השירות זמין בהודעת הפרטיות שלCloud de Confiance by S3NS.
שמות דומיין
אפשר לאחסן שמות דומיינים כנתוני Bigtable.
מגוון רחב של שמות דומיין
אם אתם מאחסנים נתונים על ישויות שאפשר לייצג כשמות דומיין, כדאי להשתמש בשם דומיין הפוך (לדוגמה, com.company.product) כמפתח השורה. שימוש בשם דומיין הפוך מומלץ במיוחד אם הנתונים בכל שורה נוטים לחפוף לשורות סמוכות. במקרה כזה, Bigtable יכול לדחוס את הנתונים בצורה יעילה יותר.
לעומת זאת, שמות דומיין רגילים שלא הפוכים יכולים לגרום למיון השורות באופן כזה שנתונים קשורים לא מקובצים במקום אחד, מה שעלול להוביל לדחיסה פחות יעילה ולקריאות פחות יעילות.
הגישה הזו מתאימה במיוחד אם הנתונים שלכם מפוזרים על פני הרבה שמות דומיין הפוכים שונים.
כדי להמחיש את הנקודה הזו, נסתכל על שמות הדומיינים הבאים, שממוינים אוטומטית בסדר לקסיקוגרפי על ידי Bigtable:
      drive.google.com
      en.wikipedia.org
      maps.google.com
זה לא רצוי בתרחיש השימוש שבו רוצים לשלוח שאילתה לגבי כל השורות של google.com. לעומת זאת, נסתכל על אותן שורות שבהן שמות הדומיינים הפוכים:
      com.google.drive
      com.google.maps
      org.wikipedia.en
בדוגמה השנייה, השורות שקשורות זו לזו ממוינות אוטומטית כדי שיהיה קל יותר לאחזר אותן כטווח של שורות.
מספר קטן של שמות דומיין
אם אתם מתכננים לאחסן הרבה נתונים רק עבור שם דומיין אחד או מספר קטן של שמות דומיין, כדאי לשקול ערכים אחרים למפתח השורה. אחרת, יכול להיות שתדחפו פעולות כתיבה לצומת יחיד באשכול, מה שיוביל לנקודות חמות, או שהשורות יגדלו יותר מדי.
אחסון נתונים בפורמט protobuf
כדי לצמצם את עלויות האחסון ולשפר את יעילות הקריאה והכתיבה, אפשר לקבץ נתונים קשורים בהודעה של מאגר אחסון לפרוטוקולים (protobuf) ולאחסן אותה בעמודה אחת, במקום לאחסן כל שדה בעמודה נפרדת. אם בדרך כלל קוראים קבוצה של שדות ביחד, יעיל יותר לאחסן אותם בעמודה אחת כערך אחד, כי קריאה של עמודה אחת מהירה יותר מקריאה של הרבה עמודות נפרדות. אם מאחסנים נתונים כהודעות protobuf, אפשר לנצל את התכונות הבאות של Bigtable:
- שימוש ב-protocol buffers לאחסון מבני נתונים גמישים מפחית את עלויות האחסון כי הנתונים נשארים במקום ולא משוכפלים.
- העלאת סכימת ה-protobuf ל-Bigtable בחבילות סכימות מאפשרת שאילתות בצד השרת. חבילת הסכימה מאפשרת ל-Bigtable להבין ולנתח את המבנה של הנתונים הסדרתיים במהלך ביצוע השאילתה.
- שימוש ב-GoogleSQL כדי לשלוח שאילתות ולסנן שדות נפרדים בהודעות protobuf ישירות ב-Bigtable הוא מהיר ויעיל. באמצעות ביטול הסריאליזציה של הנתונים בצד השרת, אפשר להריץ שאילתות והשלכות גרנולריות בלי להעביר את אובייקט ה-protobuf כולו ללקוח.
- שימוש בטבלאות חיצוניות של BigQuery כדי לנתח נתוני protobuf שמאוחסנים ב-Bigtable מאפשר לכם לפשט את הניתוח.
מידע נוסף זמין במאמר בנושא יצירה וניהול של סכימות protobuf.