

במדריך הזה נסביר איך להשתמש ב-Managed Service for Apache Airflow כדי ליצור DAG (גרף אציקלי מכוון) של Apache Airflow שמריץ משימת ספירת מילים של Apache Hadoop באשכול Managed Service for Apache Spark.
מטרות
- ניגשים לסביבת Managed Airflow ומשתמשים בממשק המשתמש של Airflow.
- יצירה של משתני סביבה ב-Airflow וצפייה בהם.
- יצירה והרצה של DAG שכולל את המשימות הבאות:
- יוצר אשכול של Managed Service for Apache Spark.
- מריץ משימה של ספירת מילים ב-Apache Hadoop באשכול.
- התוצאות של ספירת המילים מועברות לקטגוריה של Cloud Storage.
- מחיקת האשכול.
עלויות
במסמך הזה משתמשים ברכיבים הבאים של Cloud de Confiance by S3NS, והשימוש בהם כרוך בתשלום:
- Managed Airflow
- Managed Service for Apache Spark
- Cloud Storage
לפני שמתחילים
מוודאים שממשקי ה-API הבאים מופעלים בפרויקט:
המסוף
מפעילים את Managed Service for Apache Spark ואת Cloud Storage APIs, אם הם עדיין לא מופעלים.
תפקידים שנדרשים להפעלת ממשקי API
כדי להפעיל ממשקי API, נדרשת ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד 'בעלים' (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד 'אדמין בממשק Service Usage' (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידיםgcloud
מפעילים את Managed Service for Apache Spark ואת Cloud Storage APIs, אם הם עדיין לא מופעלים:
תפקידים שנדרשים להפעלת ממשקי API
כדי להפעיל ממשקי API, נדרשת ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד 'בעלים' (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד 'אדמין בממשק Service Usage' (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידיםgcloud services enable dataproc.googleapis.com
storage-component.googleapis.com בפרויקט, יוצרים קטגוריה של Cloud Storage עם סוג אחסון ואזור כלשהם כדי לאחסן את התוצאות של משימת ספירת המילים של Hadoop.
שימו לב לנתיב של הקטגוריה שיצרתם, לדוגמה
gs://example-bucket. בהמשך המדריך הזה תגדירו משתנה Airflow לנתיב הזה ותשתמשו במשתנה ב-DAG לדוגמה.יצירת סביבת Managed Airflow עם פרמטרים שמוגדרים כברירת מחדל. מחכים עד ליצירת הסביבה. בסיום, סימן וי ירוק מופיע מימין לשם הסביבה.
שימו לב לאזור שבו יצרתם את הסביבה, למשל
us-central. תגדירו משתנה Airflow לאזור הזה ותשתמשו בו ב-DAG לדוגמה כדי להפעיל אשכול Managed Service for Apache Spark באותו אזור.
הגדרת משתנים ב-Airflow
מגדירים את המשתנים של Airflow כדי להשתמש בהם בהמשך בדוגמה של DAG. לדוגמה, אפשר להגדיר משתני Airflow בממשק המשתמש של Airflow.
| משתנה Airflow | ערך |
|---|---|
gcp_project
|
מזהה הפרויקט שבו אתם משתמשים במדריך הזה, למשל example-project. |
gcs_bucket
|
ה-URI של קטגוריה של Cloud Storage שיצרתם לצורך המדריך הזה, כמו gs://example-bucket |
gce_region
|
האזור שבו יצרתם את הסביבה, למשל us-central1.
זהו האזור שבו ייווצר האשכול של Managed Service for Apache Spark. |
דוגמה לזרימת עבודה
DAG ב-Airflow הוא אוסף של משימות מאורגנות שרוצים לתזמן ולהריץ. גרפים מכווני מחזור (DAG) מוגדרים בקובצי Python רגילים. הקוד שמוצג ב-hadoop_tutorial.py הוא קוד תהליך העבודה.
אופרטורים
כדי לתזמן את שלוש המשימות בתהליך העבודה לדוגמה, ה-DAG מייבא את שלושת האופרטורים הבאים של Airflow:
DataprocClusterCreateOperator: יצירת אשכול של Managed Service for Apache Spark.
DataProcHadoopOperator: שולח משימת ספירת מילים של Hadoop וכותב את התוצאות לקטגוריה של Cloud Storage.
DataprocClusterDeleteOperator: מחיקת האשכול כדי להימנע מחיובים שוטפים ב-Compute Engine.
פניות קשורות
אתם מארגנים את המשימות שאתם רוצים להריץ באופן שמשקף את הקשרים ויחסי התלות ביניהן. המשימות ב-DAG הזה רצות ברצף.
קביעת מועד
השם של ה-DAG הוא composer_hadoop_tutorial, והוא מופעל פעם ביום. כי הערך של start_date שמועבר אל default_dag_args מוגדר כ-yesterday. מערכת Managed Airflow מתזמנת את תהליך העבודה כך שיתחיל מיד אחרי שה-DAG מועלה אל הדלי של הסביבה.
העלאת ה-DAG לקטגוריה של הסביבה
Managed Airflow מאחסן DAGs בתיקייה /dags בדלי של הסביבה.
כדי להעלות את ה-DAG:
במחשב המקומי, שומרים את הקובץ
hadoop_tutorial.py.נכנסים לדף Environments במסוף Cloud de Confiance .
ברשימת הסביבות, בעמודה DAGs folder של הסביבה, לוחצים על הקישור DAGs.
לוחצים על העלאת קבצים.
בוחרים באפשרות
hadoop_tutorial.pyבמחשב המקומי ולוחצים על פתיחה.
Managed Airflow מוסיף את ה-DAG ל-Airflow ומתזמן את ה-DAG באופן אוטומטי. השינויים ב-DAG מתעדכנים תוך 3-5 דקות.
עיון בהרצות של DAG
צפייה בסטטוס המשימה
כשמעלים את קובץ ה-DAG לתיקייה dags/ ב-Cloud Storage, Managed Airflow מנתח את הקובץ. אם הפעולה הושלמה בהצלחה, השם של תהליך העבודה מופיע ברשימת ה-DAG, ותהליך העבודה מתווסף לתור להפעלה מיידית.
כדי לראות את סטטוס המשימה, עוברים לממשק האינטרנט של Airflow ולוחצים על DAGs בסרגל הכלים.
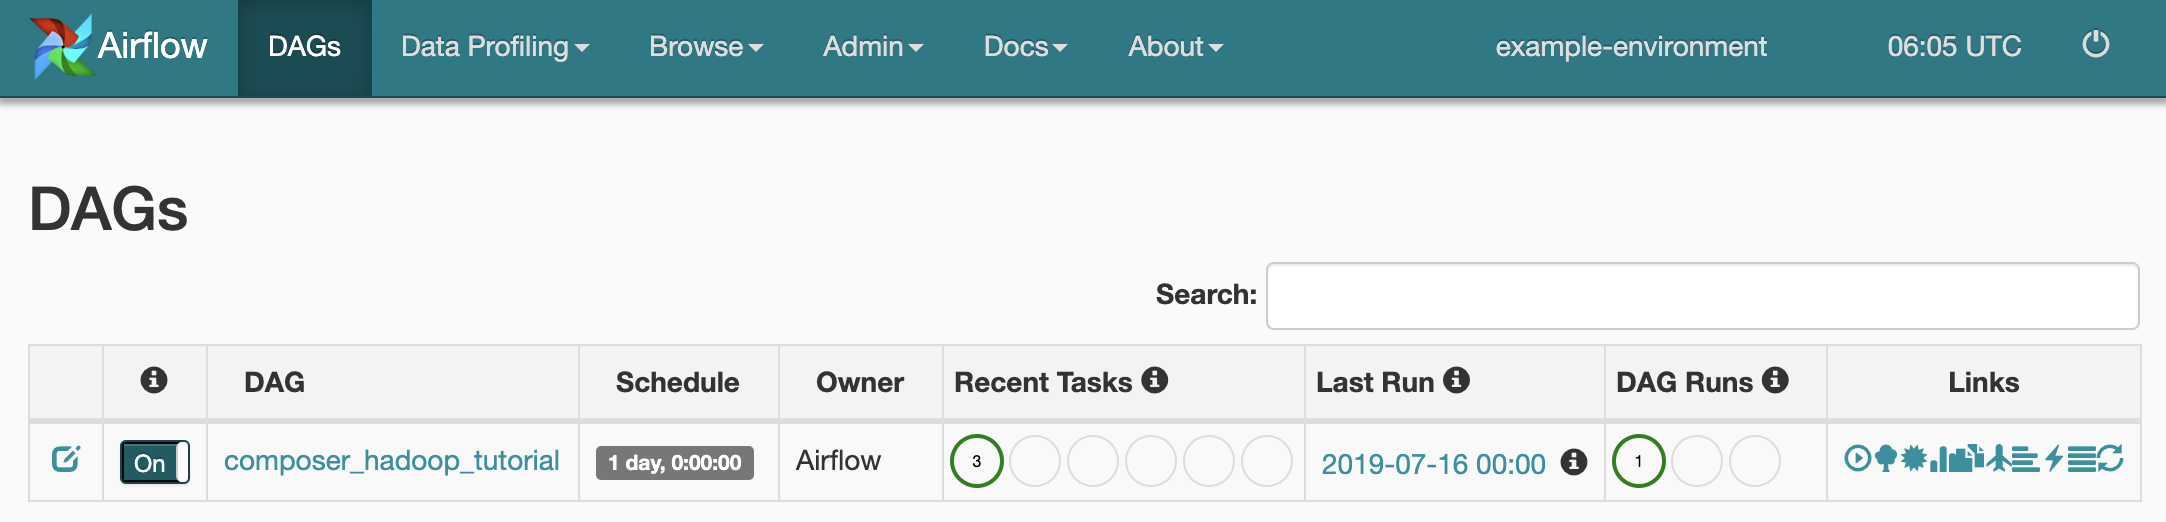
כדי לפתוח את דף הפרטים של ה-DAG, לוחצים על
composer_hadoop_tutorial. בדף הזה יש ייצוג גרפי של משימות ויחסי תלות בתהליך העבודה.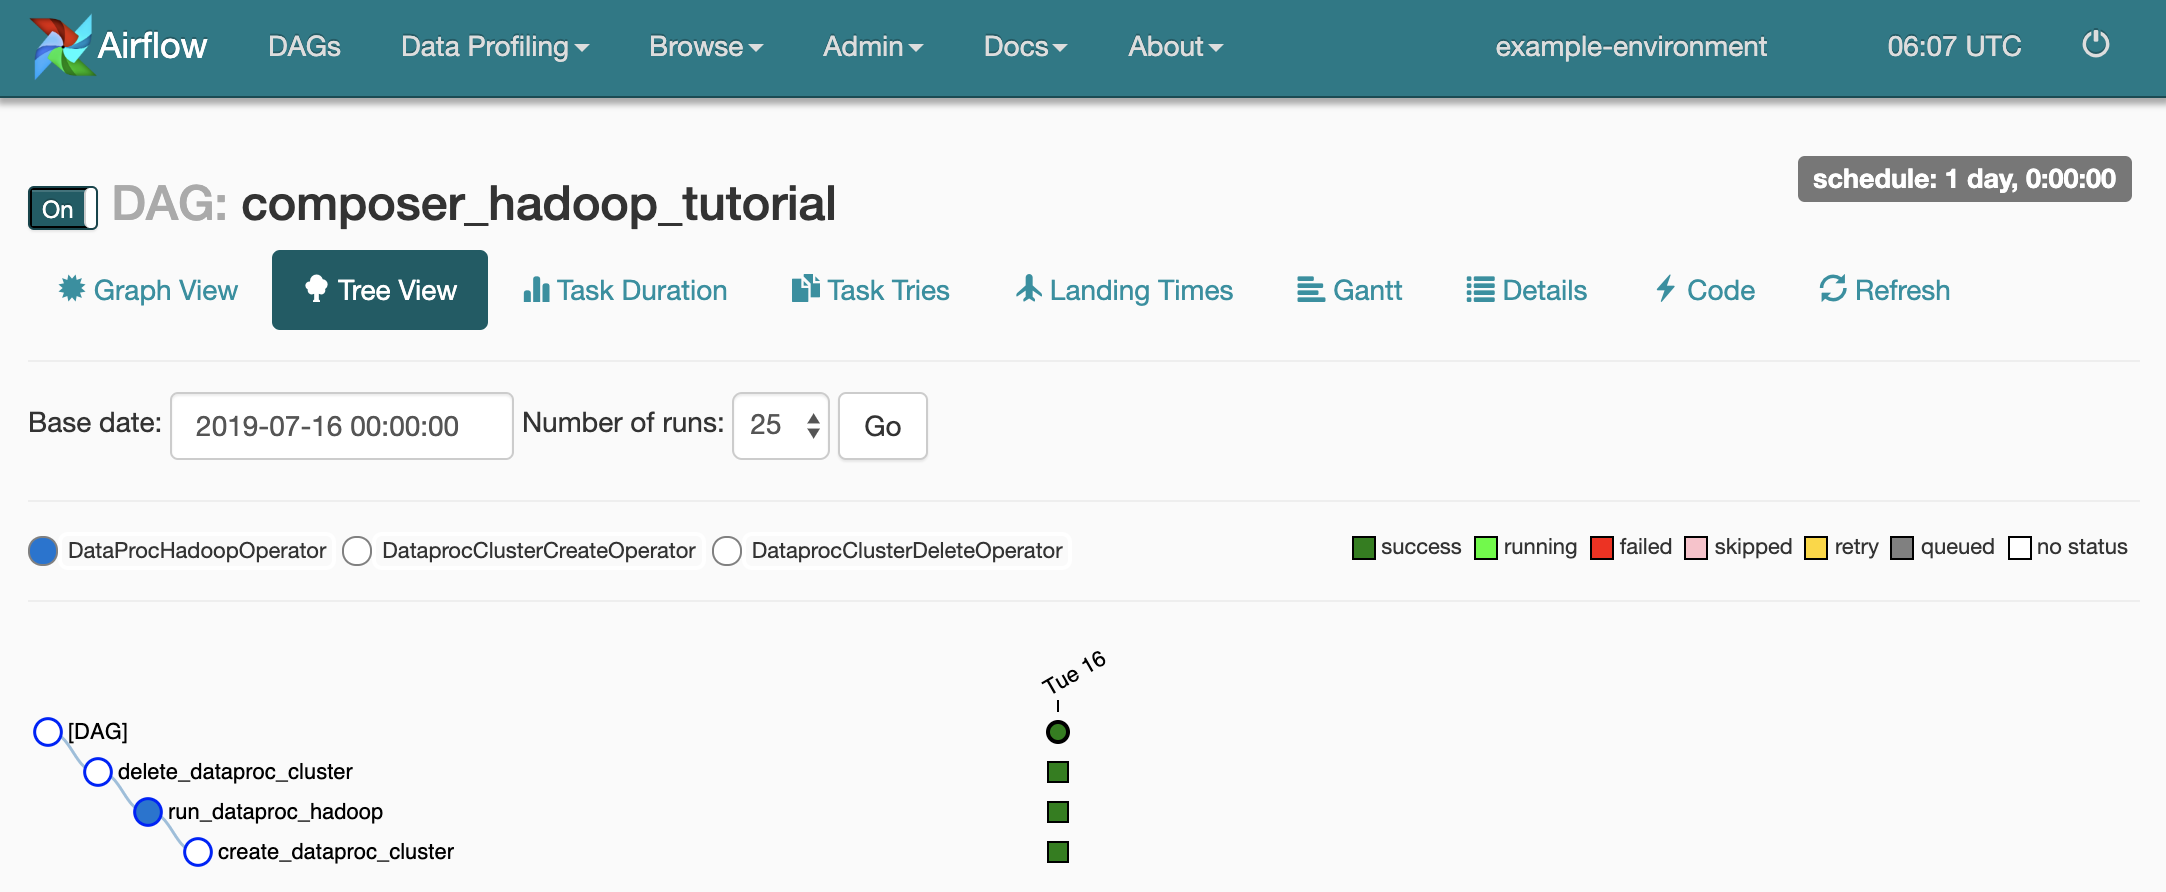
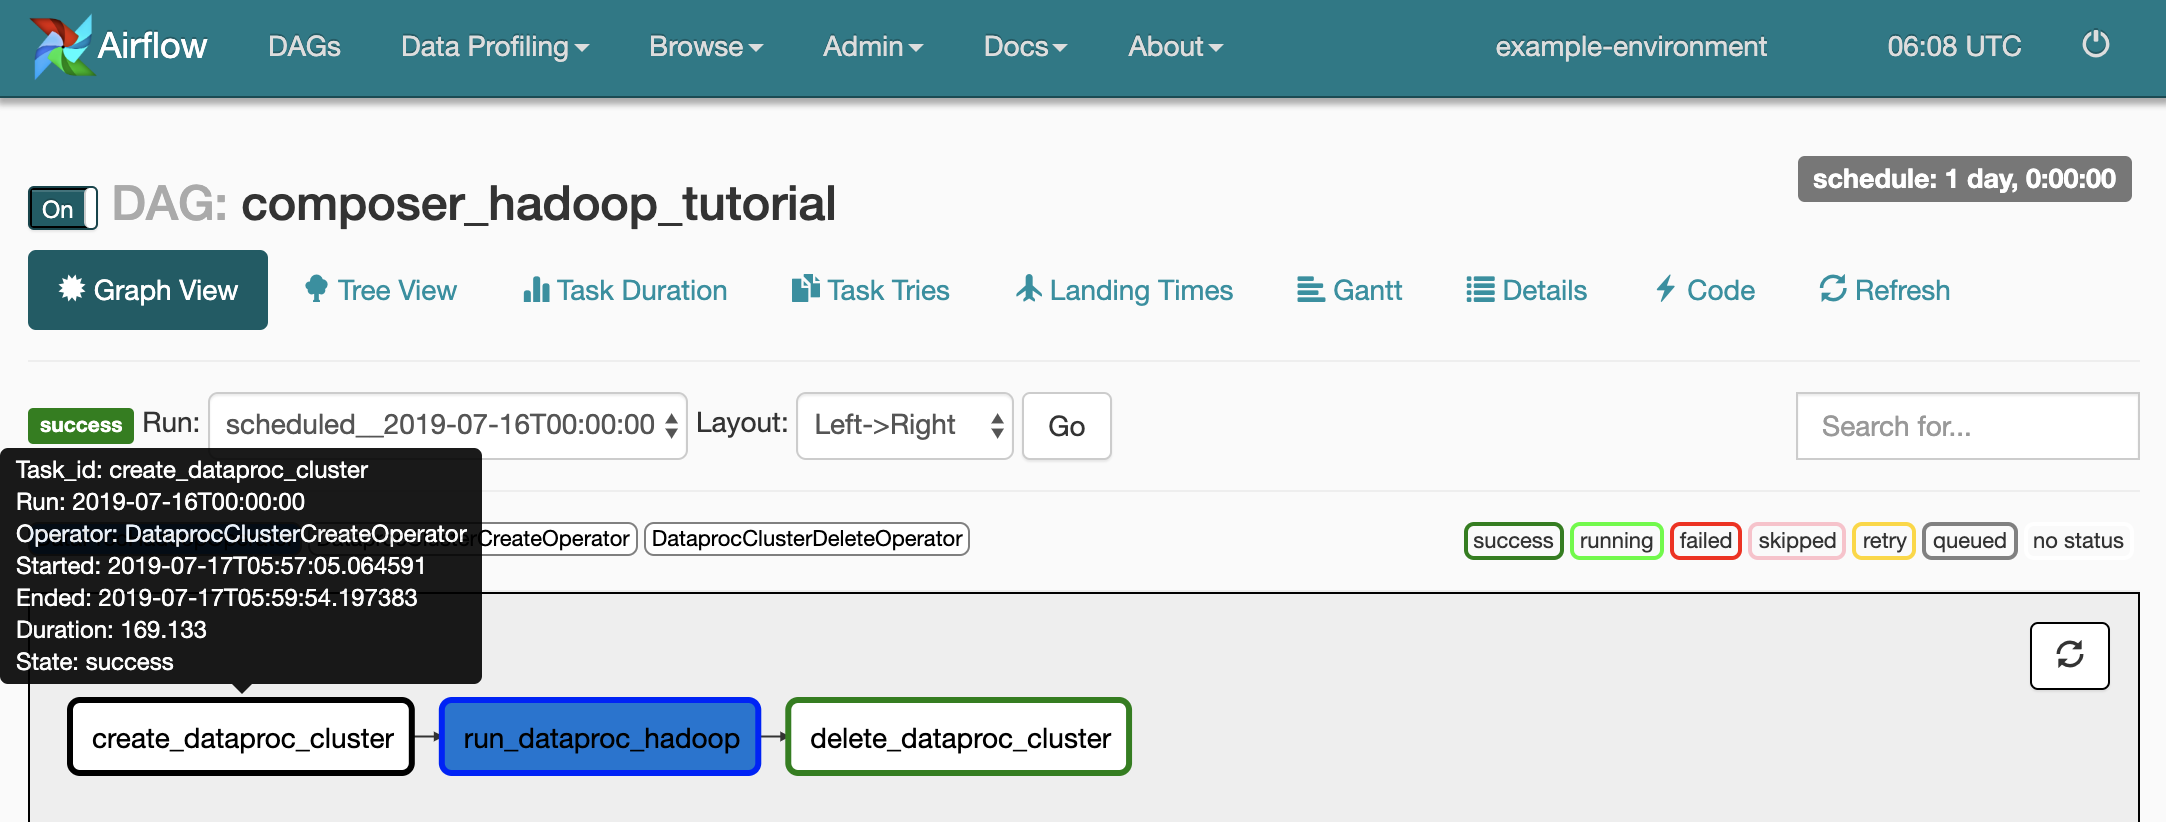
כדי לראות את הסטטוס של כל משימה, לוחצים על תצוגת תרשים ומעבירים את העכבר מעל הגרפיקה של כל משימה.
הוספה חוזרת של תהליך העבודה לתור
כדי להריץ שוב את תהליך העבודה מתצוגת התרשים:
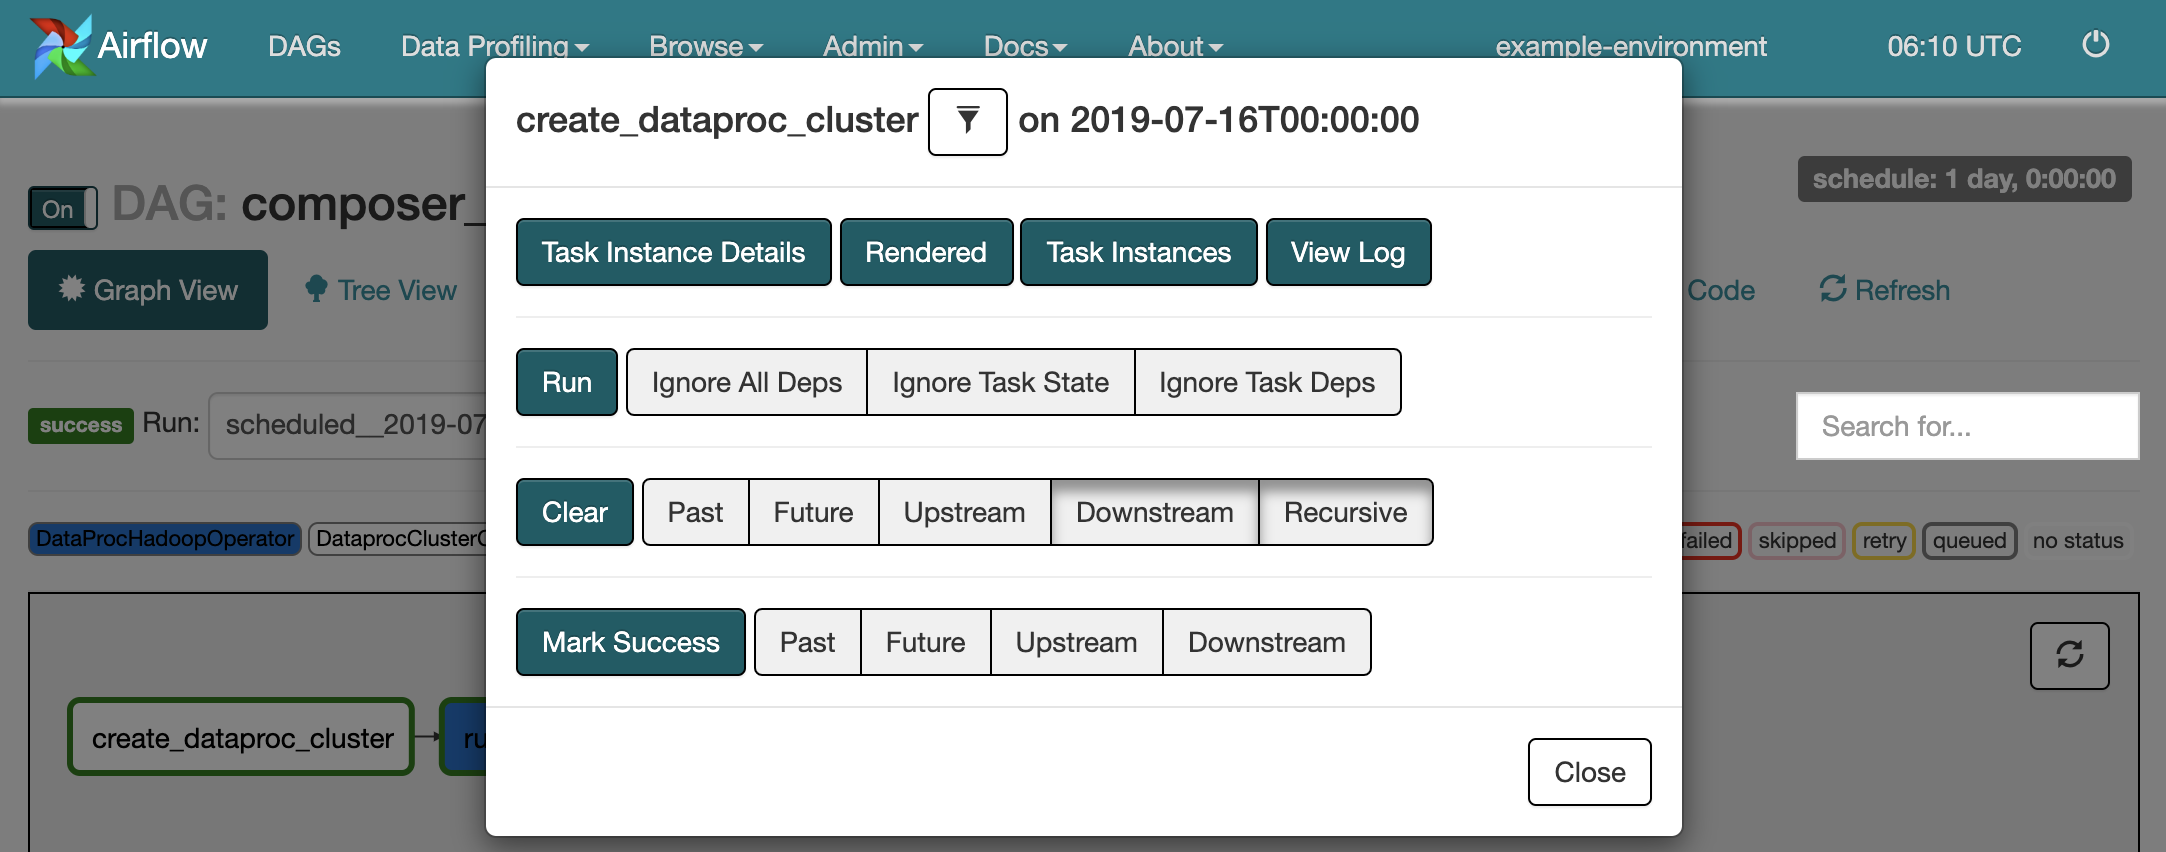
- בתצוגת הגרף של ממשק המשתמש של Airflow, לוחצים על הגרפיקה
create_dataproc_cluster. - כדי לאפס את שלוש המשימות, לוחצים על ניקוי ואז על אישור כדי לאשר.
- לוחצים שוב על
create_dataproc_clusterבתצוגת התרשים. - כדי להוסיף שוב את תהליך העבודה לתור, לוחצים על הפעלה.
צפייה בתוצאות של משימות
אפשר גם לבדוק את הסטטוס והתוצאות של composer_hadoop_tutorial
זרימת העבודה בדפים הבאים במסוף: Cloud de Confiance
Managed Service for Apache Spark Clusters: כדי לעקוב אחרי יצירה ומחיקה של אשכולות. הערה: האשכול שנוצר על ידי תהליך העבודה הוא זמני: הוא קיים רק למשך תהליך העבודה ונמחק כחלק מהמשימה האחרונה בתהליך העבודה.
Managed Service for Apache Spark Jobs: כדי להציג או לנטר את משימת ספירת המילים של Apache Hadoop. לוחצים על מזהה משימה כדי לראות את הפלט של יומן העבודה.
Cloud Storage Browser: כדי לראות את התוצאות של ספירת המילים בתיקייה
wordcountבקטגוריה של Cloud Storage שיצרתם לצורך המדריך הזה.
הסרת המשאבים
מוחקים את המשאבים שבהם השתמשתם במדריך הזה:
מחיקת סביבת Airflow מנוהלת, כולל מחיקה ידנית של קטגוריית הסביבה.
מוחקים את קטגוריית Cloud Storage שבה מאוחסנות התוצאות של משימת ספירת המילים ב-Hadoop.