

本教程介绍了如何使用 Managed Service for Apache Airflow 创建一个 Apache Airflow DAG(有向无环图),该 DAG 在 Managed Service for Apache Spark 集群上运行 Apache Hadoop wordcount 作业。
目标
- 访问您的 Managed Airflow 环境并使用 Airflow 界面。
- 创建和查看 Airflow 环境变量。
- 创建和运行包含以下任务的 DAG:
- 创建 Managed Service for Apache Spark 集群。
- 在该集群上运行 Apache Hadoop WordCount 作业。
- 将字数统计结果输出到 Cloud Storage 存储桶。
- 删除集群。
费用
在本文档中,您将使用 Cloud de Confiance by S3NS的以下收费组件:
- Managed Airflow
- Managed Service for Apache Spark
- Cloud Storage
准备工作
确保您的项目已启用以下 API:
控制台
启用 Managed Service for Apache Spark 和 Cloud Storage API(如果尚未启用)。
启用 API 所需的角色
如需启用 API,您需要拥有
serviceusage.services.enable权限。如果您创建了项目,则可能已经通过 Owner 角色 (roles/owner) 拥有此权限。否则,您可以通过 Service Usage Admin 角色 (roles/serviceusage.serviceUsageAdmin) 获取此权限。 了解如何授予角色。gcloud
启用 Managed Service for Apache Spark 和 Cloud Storage API(如果尚未启用):
启用 API 所需的角色
如需启用 API,您需要拥有
serviceusage.services.enable权限。如果您创建了项目,则可能已经通过 Owner 角色 (roles/owner) 获得了此权限。否则,您可以通过 Service Usage Admin 角色 (roles/serviceusage.serviceUsageAdmin) 获得此权限。了解如何授予角色。gcloud services enable dataproc.googleapis.com
storage-component.googleapis.com 在您的项目中,创建一个 Cloud Storage 存储桶,用于存储 Hadoop 字数统计作业的结果。您可以选择任何存储类和区域。
记下您创建的存储桶的路径,例如
gs://example-bucket。您将为此路径定义一个 Airflow 变量,并在本教程后面的示例 DAG 中使用该变量。使用默认参数创建 Managed Airflow 环境。等待环境创建操作完成。完成后,环境名称左侧会显示绿色对勾标记。
请记住您在其中创建了环境的区域,例如
us-central。您将为此区域定义一个 Airflow 变量,并在示例 DAG 中使用该变量,以在同一区域中运行 Managed Service for Apache Spark 集群。
设置 Airflow 变量
设置 Airflow 变量,以便在示例 DAG 中稍后使用。例如,您可以在 Airflow 界面中设置 Airflow 变量。
| Airflow 变量 | 值 |
|---|---|
gcp_project
|
您在本教程中使用的项目的项目 ID,例如 example-project。 |
gcs_bucket
|
您为此教程创建的 Cloud Storage 存储桶的 URI,例如 gs://example-bucket |
gce_region
|
您创建环境的区域,例如 us-central1。
这是将创建 Managed Service for Apache Spark 集群的区域。 |
查看示例工作流
Airflow DAG 是您想要安排和运行的有序任务集合。DAG 在标准 Python 文件中定义。hadoop_tutorial.py 中显示的代码就是工作流代码。
运算符
为了编排示例工作流中的三个任务,DAG 会导入以下三个 Airflow 运算符:
DataprocClusterCreateOperator:创建 Managed Service for Apache Spark 集群。DataProcHadoopOperator:提交 Hadoop 字数统计作业并将结果写入 Cloud Storage 存储桶。DataprocClusterDeleteOperator:删除集群,以免产生持续的 Compute Engine 费用。
依赖项
您需要以反映任务关系和依赖项的方式来整理要运行的任务。此 DAG 中的任务按顺序运行。
时间安排
相应 DAG 的名称为 composer_hadoop_tutorial,并且每天运行一次。由于传递到 default_dag_args 的 start_date 设置为 yesterday,因此 Managed Airflow 会安排工作流在 DAG 上传到环境的存储桶后立即开始运行。
将 DAG 上传到环境的存储桶
Managed Airflow 会将 DAG 存储在环境存储桶的 /dags 文件夹中。
如需上传 DAG,请执行以下操作:
在本地机器上,保存
hadoop_tutorial.py。在 Cloud de Confiance 控制台中,前往环境页面。
在环境列表中,点击相应环境的 DAG 文件夹列中的 DAG 链接。
点击上传文件。
在本地机器上选择
hadoop_tutorial.py,然后点击打开。
Managed Airflow 会将 DAG 添加到 Airflow 并自动安排 DAG。DAG 会在 3 到 5 分钟内发生更改。
探索 DAG 运行
查看任务状态
当您将 DAG 文件上传到 Cloud Storage 中的 dags/ 文件夹时,Managed Airflow 会解析该文件。成功完成后,工作流的名称会显示在 DAG 列表中,并且工作流会排入队列以立即运行。
如需查看任务状态,请转到 Airflow 网页界面并点击工具栏中的 DAGs。
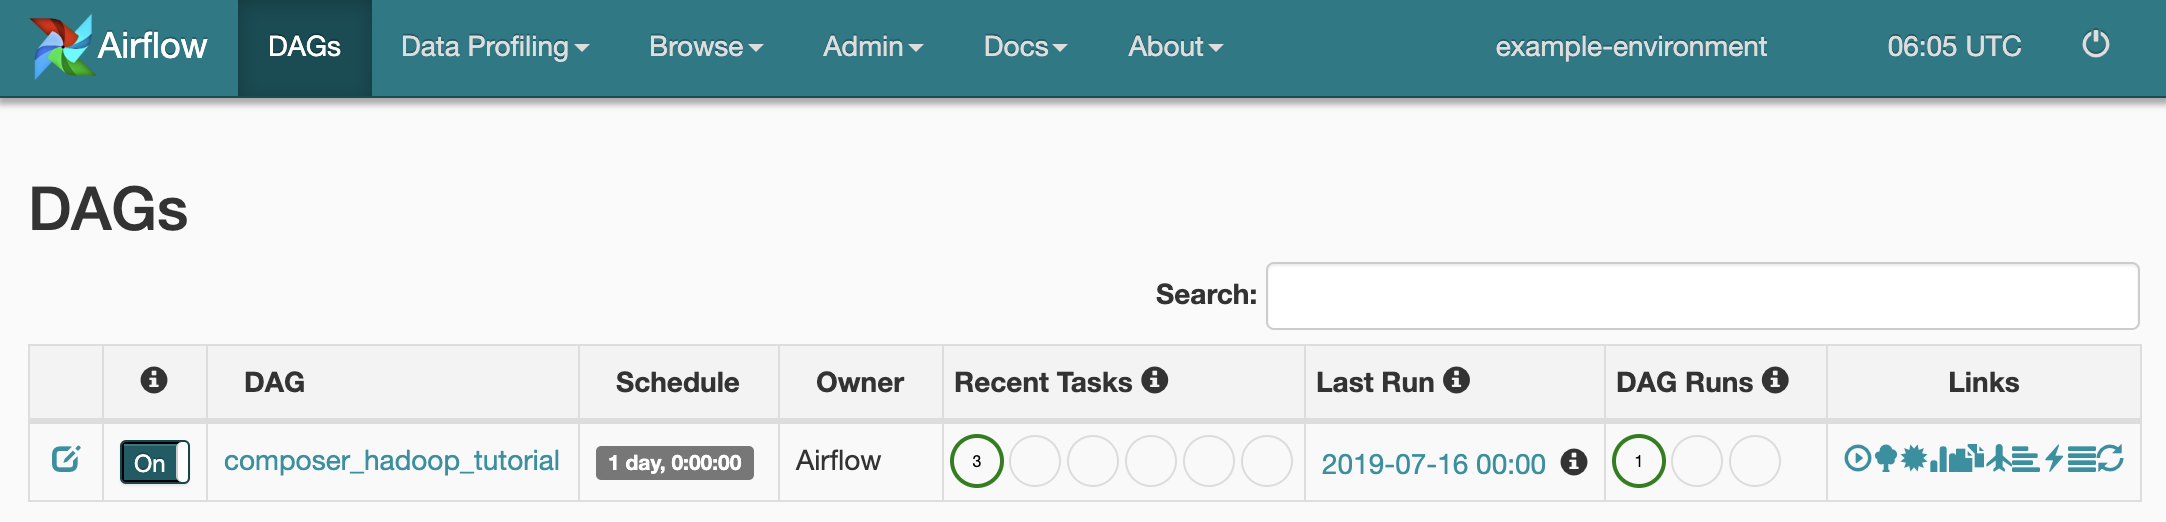
如需打开 DAG 详情页面,请点击
composer_hadoop_tutorial。此页面包含工作流任务和依赖项的图形表示。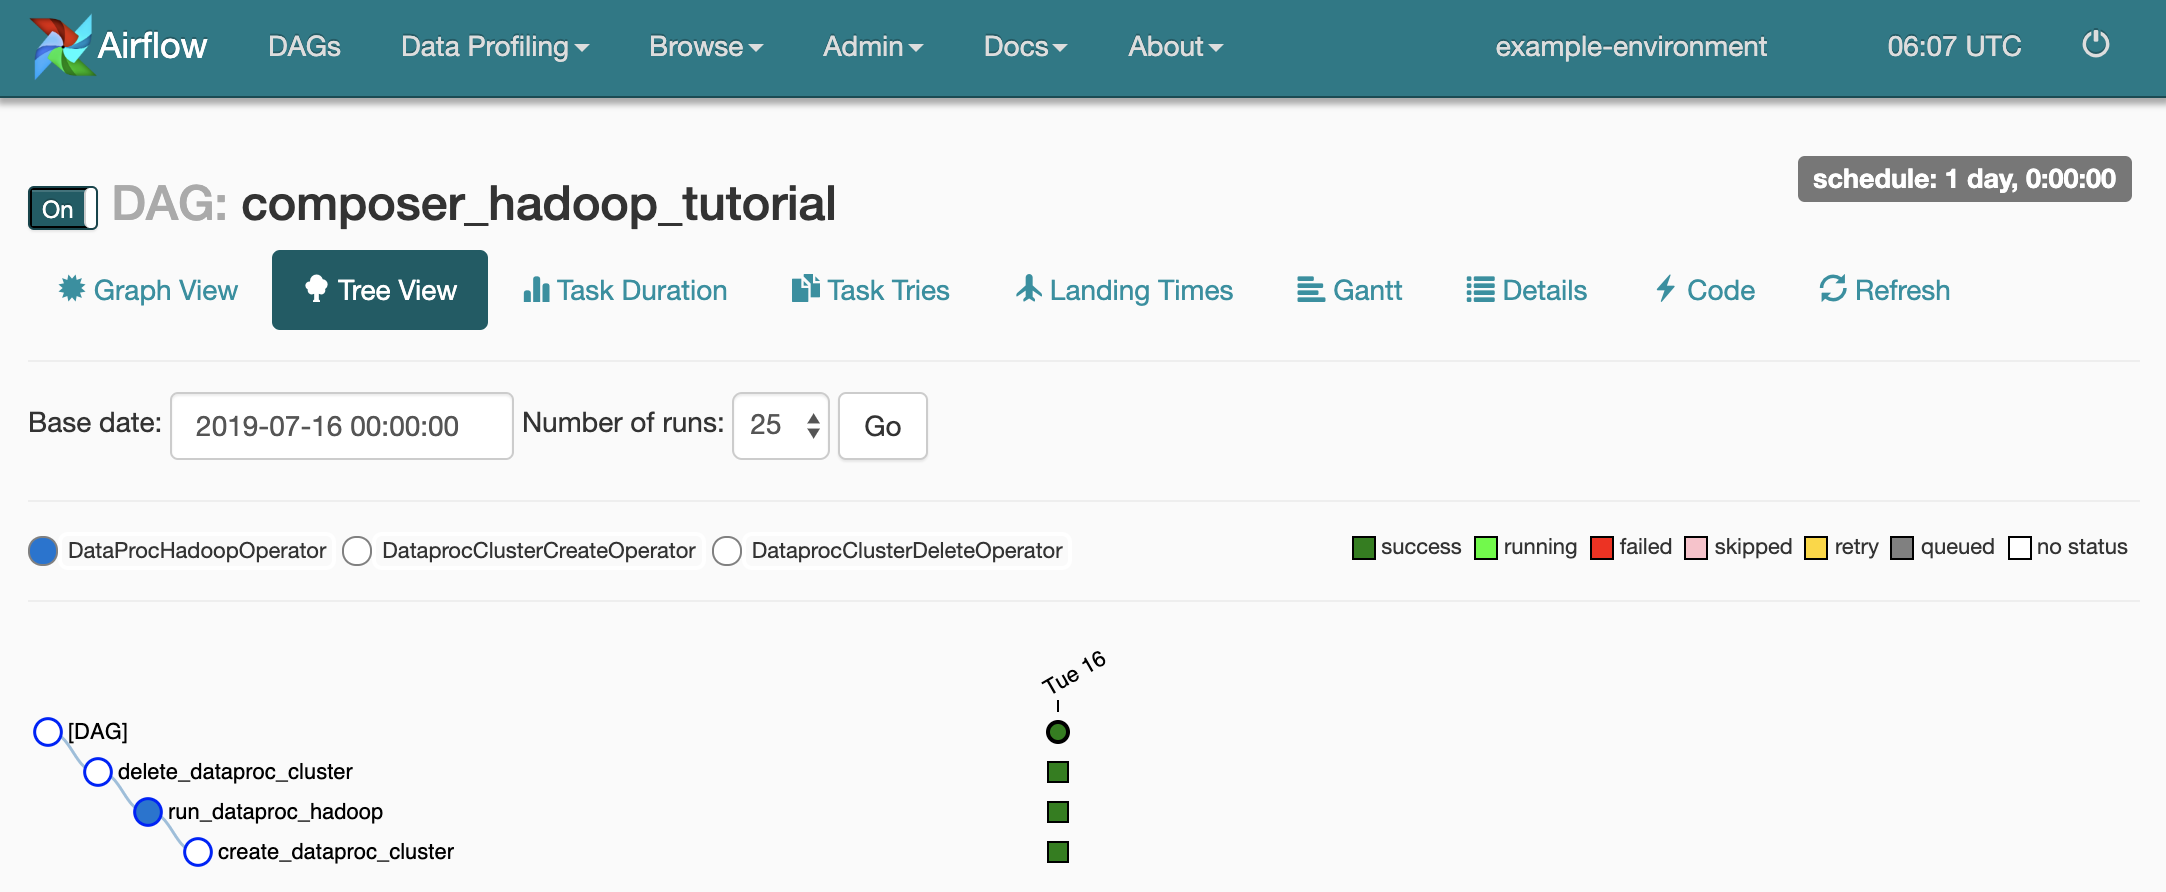
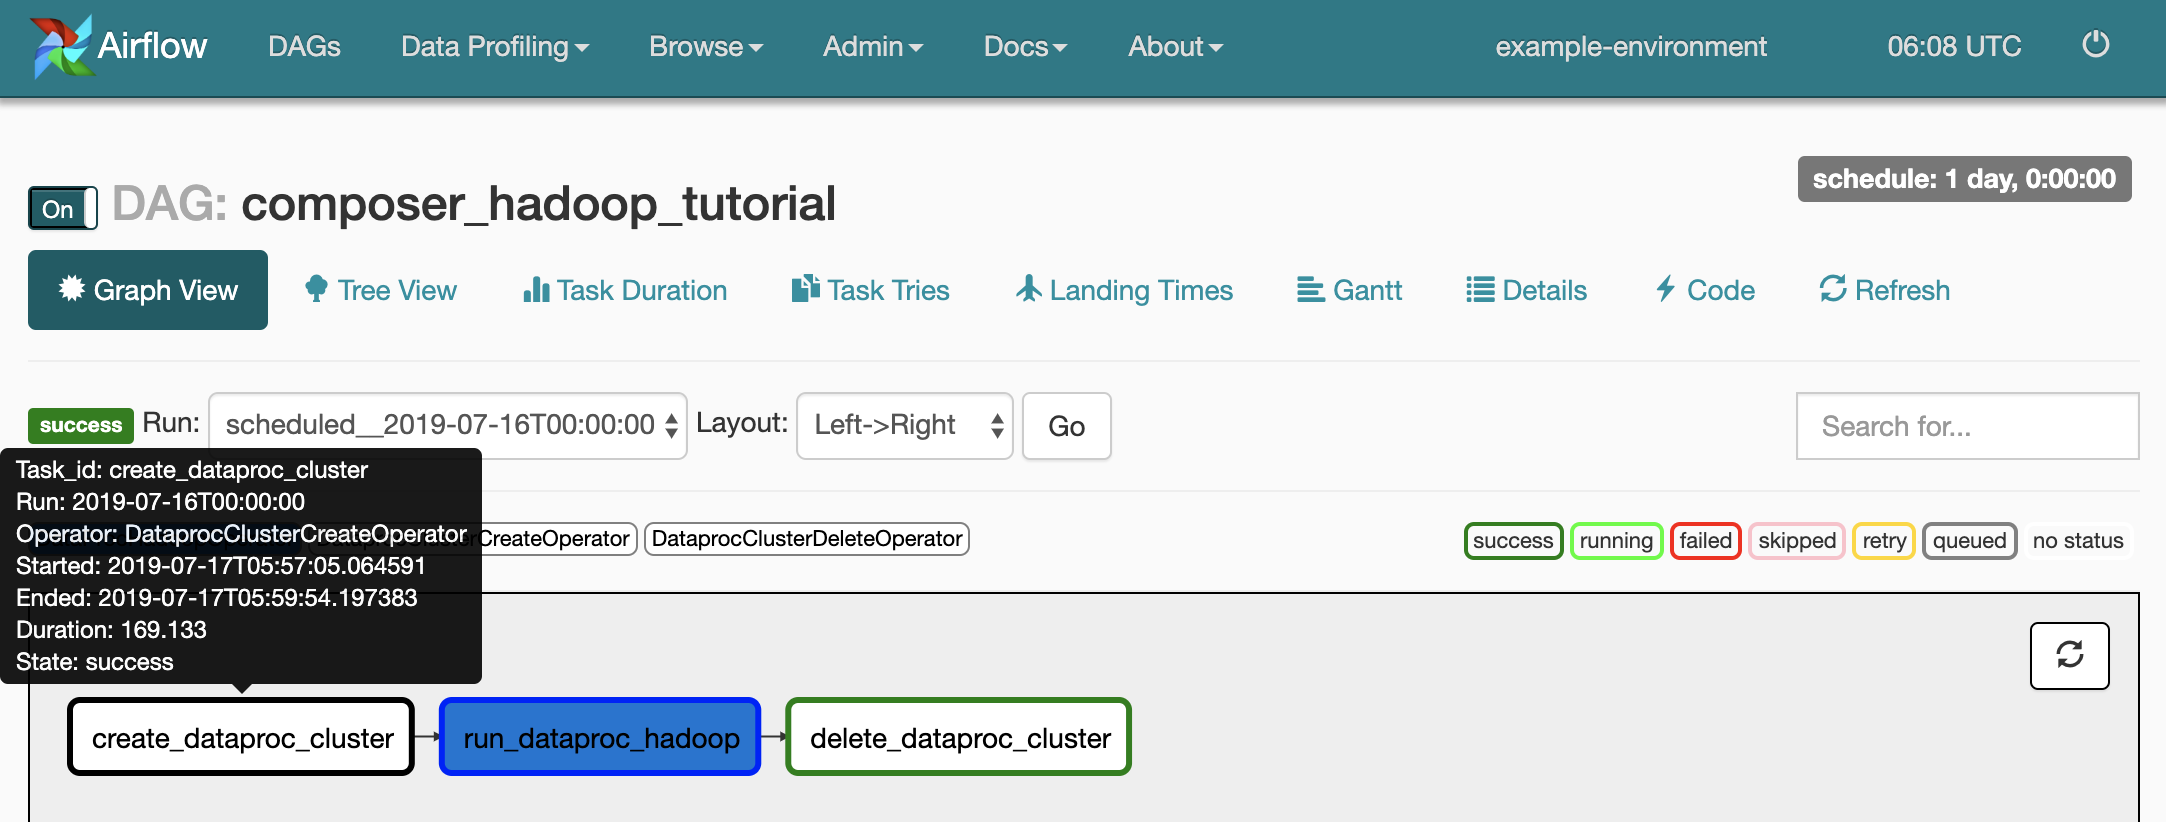
如需查看每个任务的状态,请点击 Graph View,然后将鼠标悬停在每个任务对应的图形上。
再次将工作流加入队列
如需从 Graph View 重新运行工作流,请执行以下操作:
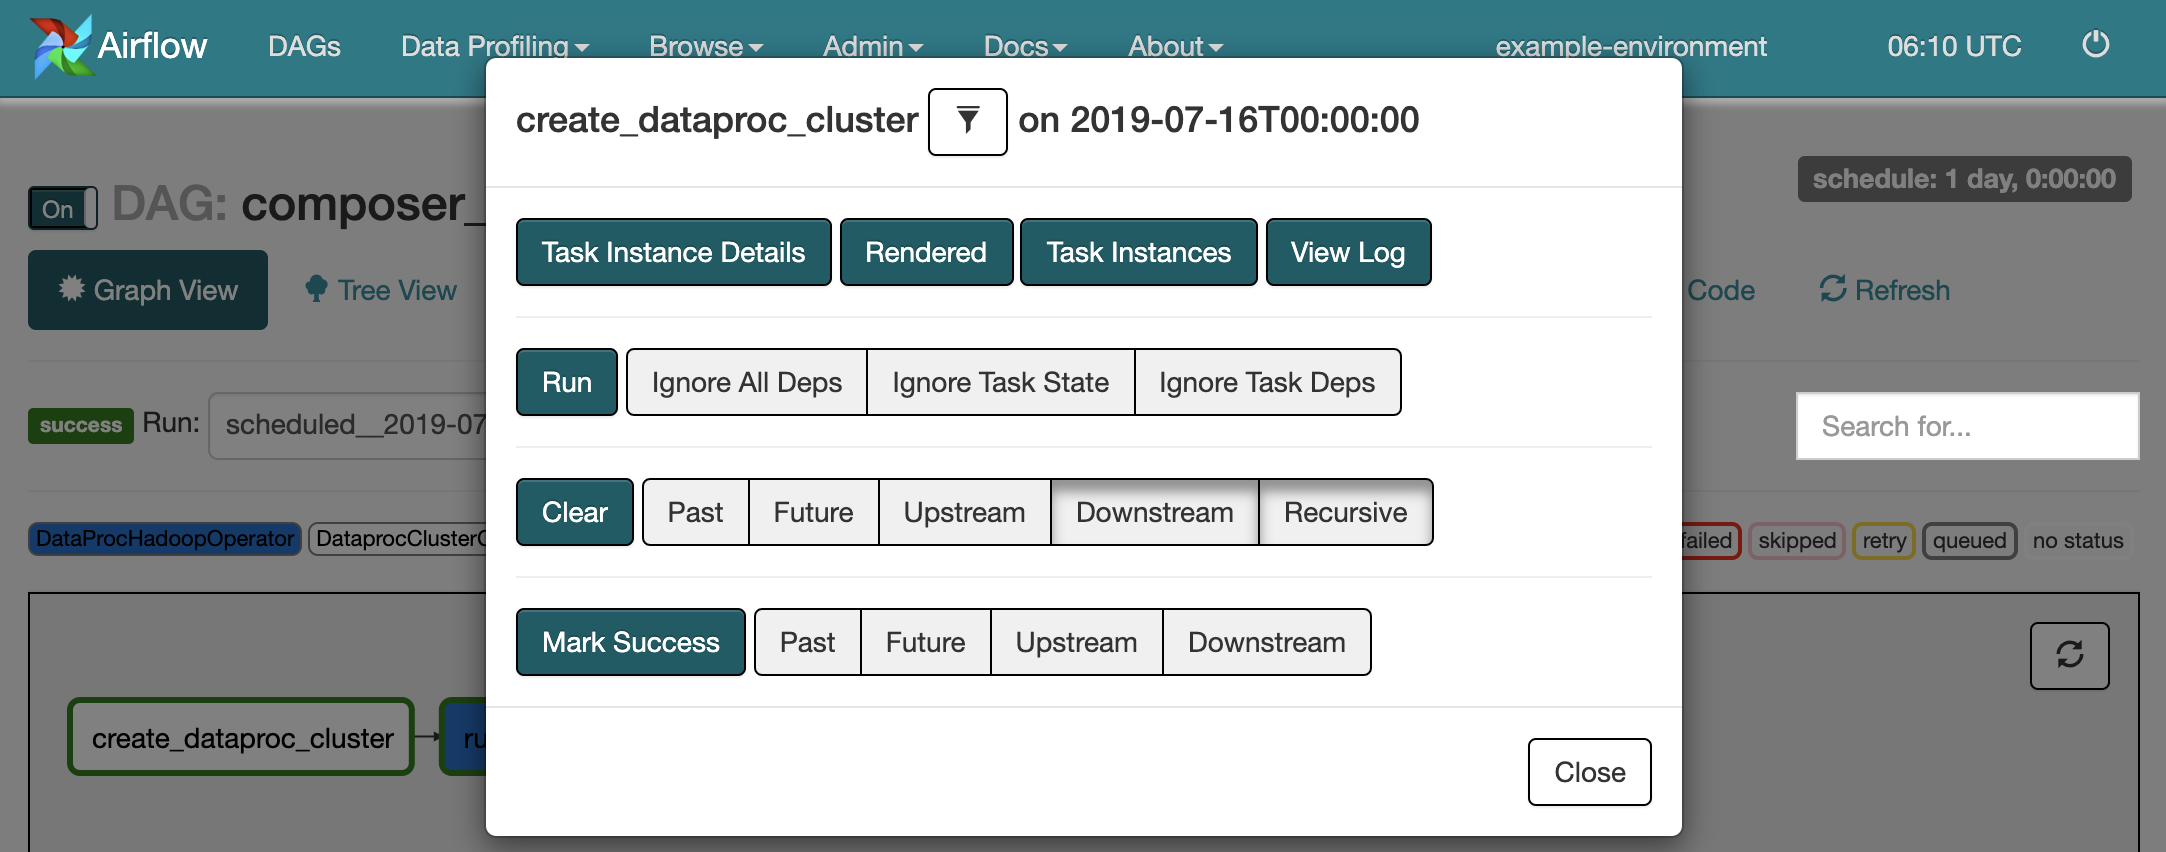
- 在 Airflow 界面的“Graph View”中,点击
create_dataproc_cluster图形。 - 如需重置三个任务,请点击 Clear,然后点击 OK 进行确认。
- 在“Graph View”中,再次点击
create_dataproc_cluster。 - 如需将工作流重新加入队列,请点击 Run。
查看任务结果
您还可以前往以下 Cloud de Confiance 控制台页面,检查 composer_hadoop_tutorial 工作流的状态和结果:
Managed Service for Apache Spark 集群:用于监控集群创建和删除。请注意,工作流创建的集群是临时集群:它仅在工作流运行期间存在,并在最后一个工作流任务中被删除。
Managed Service for Apache Spark 作业:用于查看或监控 Apache Hadoop 字数统计作业。点击任务 ID 以查看作业日志输出。
Cloud Storage 浏览器:查看您为此教程创建的 Cloud Storage 存储桶中
wordcount文件夹内的字数统计结果。
清理
删除本教程中使用的资源:
删除 Managed Airflow 环境,包括手动删除环境的存储桶。
删除 Cloud Storage 存储桶,该存储桶用于存储 Hadoop WordCount 作业的结果。