

Managed Airflow Agent 可帮助您了解、诊断和解决 Airflow 任务和 DAG 运行失败的问题。
准备工作
- 运行受管 Airflow 代理的 Conversational Analytics API 有自己的数据驻留政策。您的对话可能会在不同于您环境所在位置的区域中处理。
调查失败的 Airflow 任务或 DAG 运行
如需调查失败的 Airflow 任务或 DAG 运行,请执行以下操作:
在 Cloud de Confiance 控制台中,前往环境页面。
选择环境以查看其详细信息。
在环境详情页面上,前往 DAG 标签页。
点击 DAG 的名称。
在 DAG 详情页面上,前往运行历史记录标签页。
找到失败的 DAG 运行。您可以调查整个 DAG 运行或特定的失败任务:
如需调查 DAG 运行,请执行以下操作:
点击失败的 DAG 运行名称旁边的 调查。
在调查 DAG 运行失败的原因对话框中,点击调查。
如需调查 Airflow 任务,请执行以下操作:
点击失败的 DAG 运行的名称,以显示任务列表。
在失败的 Airflow 任务的状态列中,点击 调查。
在调查任务失败原因对话框中,点击调查。
系统会打开向代理提问面板,并开始调查 Managed Airflow Agent DAG 运行失败问题。等待代理完成分析,然后查看诊断报告,该报告包含以下几个部分:
- 问题描述了问题的根本原因。
- 证据是指支持代理结论的特定制品。
- 建议会提供解决问题的具体步骤。
调查示例
此示例展示了分析失败任务的过程。
在 Monitoring > DAG Statistics 信息中心内,观察失败的 DAG 运行:

图 1. 已完成的 DAG 运行图表(点击可放大) 前往 DAG 标签页。失败的运行(1 小时)列显示,
create_large_txt_file_print_logsDAG 在过去一小时内有多次运行失败。点击 DAG 的名称。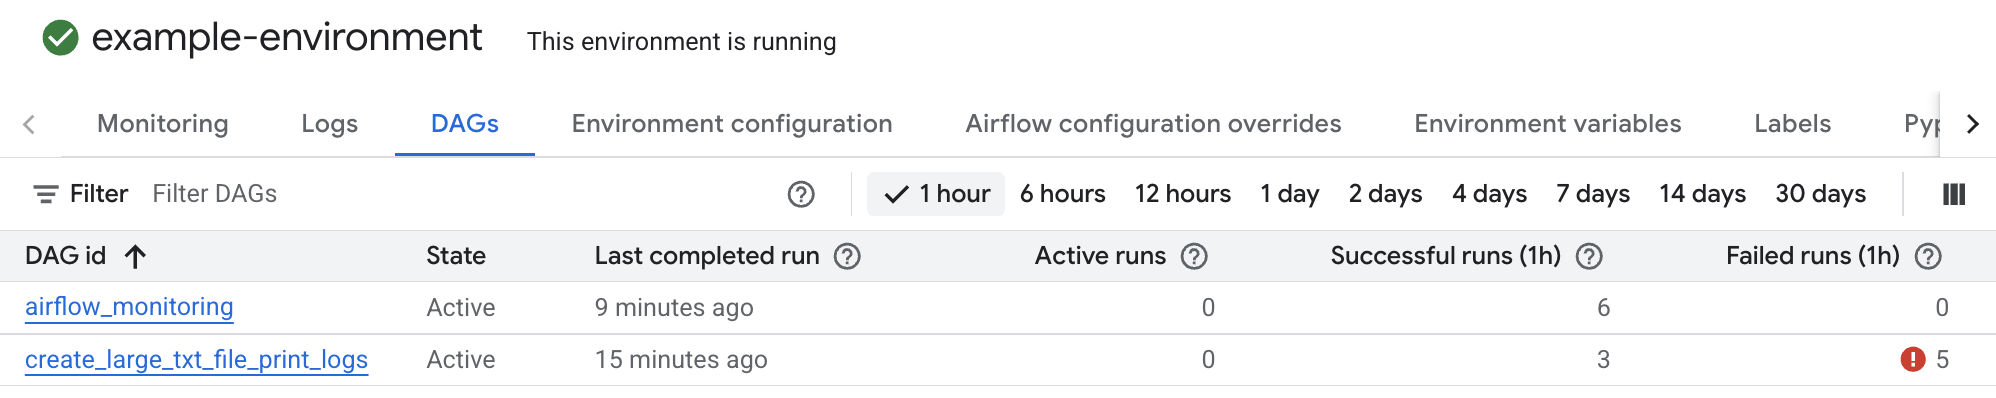
图 2. 包含 DAG 运行统计信息的 DAG 列表(点击可放大) 点击某个失败的 DAG 运行,然后点击失败的 Airflow 任务条目旁边的 Investigate(调查)。

图 3. 失败 DAG 中的任务列表(点击可放大) 等待代理完成报告。
查看诊断报告。在此特定示例中,任务失败且未生成日志,但 Managed Airflow 代理能够从 Airflow 调度程序日志中找到失败原因,其中任务被终止为僵尸任务:
### **1. Problem**

The task `create_huge_file` in DAG `dag_simulation` failed because the
Airflow worker executing it ran out of memory (OOM). This caused the task
container or process to be abruptly terminated, preventing it from sending
heartbeats to the scheduler. As a result, the scheduler detected it as a
zombie task and marked it as failed.

### **2. Evidence**

*  **Scheduler Log (Zombie Detection)**:
   Detected a task instance without a heartbeat:
   filepath='dag-simulation.py'
   bundle_name='dags-folder' bundle_version=None msg="{'DAG Id':
   'dag_simulation', 'Task Id': 'create_huge_file', 'Run Id':
   'manual__2026-11-25T12:42:50.190250+00:00', 'Hostname':
   'airflow-worker-2lxm2', 'External Executor Id':
   'cfc98619-0de6-4699-96e6-7ba8a5a581aa'}"

*  ...
最后,检查建议的推荐内容。 Managed Airflow Agent 会总结证据,并提供有关如何解决问题的建议。在此示例中,任务失败是因为 Airflow 工作器没有足够的资源来处理该任务。证据表明,工作器 Pod 因出现 OOM 错误而多次重启,并且任务随后被调度程序终止,成为僵尸任务。
### **3. Recommendation**
To resolve this issue, you must prevent the task from consuming unbound
memory. Depending on your workflow:

*  **Fix Code Logic (Highly Recommended)**: Avoid loading large datasets
   completely into worker memory. Implement chunk-based processing or
   streaming, or set up explicit safety limits. For example, if you need to
   limit memory allocation or process in bounded batches, do not keep
   references to old chunks in memory: ...

*  **Scale Worker Memory**: If processing massive datasets in memory is
   unavoidable, consider upgrading the resource limits (RAM/CPU) of your
   Airflow worker pools or offloading the heavy processing step to external
   services.