

איך פועל GKE Volume Populator
GKE Volume Populator מבוסס על הקונספט הבסיסי של Kubernetes Volume Populator. במקום להקצות נפח ריק, מאכלס הנפחים של GKE מאפשר ל-PVC להפנות למשאב בהתאמה אישית של GCPDataSource. המשאב המותאם אישית הזה מציין את קטגוריית המקור של Cloud Storage ואת פרטי הכניסה הנדרשים.
כשיוצרים PVC עם dataSourceRef שמצביע על משאב GCPDataSource, הכלי GKE Volume Populator מתחיל את העברת הנתונים. הוא מעתיק נתונים מה-URI שצוין של קטגוריית Cloud Storage לנפח האחסון המתמיד הבסיסי, לפני שנפח האחסון הופך לזמין ל-Pods.
התהליך הזה מפחית את הצורך להשתמש בסקריפטים ידניים להעברת נתונים או בפקודות CLI, והופך את ההעברה של מערכי נתונים גדולים לנפחים קבועים לאוטומטית. GKE Volume Populator תומך בהעברות נתונים בין סוגי המקור והיעד הבאים:
- Cloud Storage ל-Hyperdisk ML
GKE Volume Populator הוא רכיב מנוהל של GKE שמופעל כברירת מחדל באשכולות Autopilot ו-Standard. האינטראקציה עם GKE Volume Populator מתבצעת בעיקר באמצעות ה-CLI של gcloud ו-kubectl CLI.
ארכיטקטורה
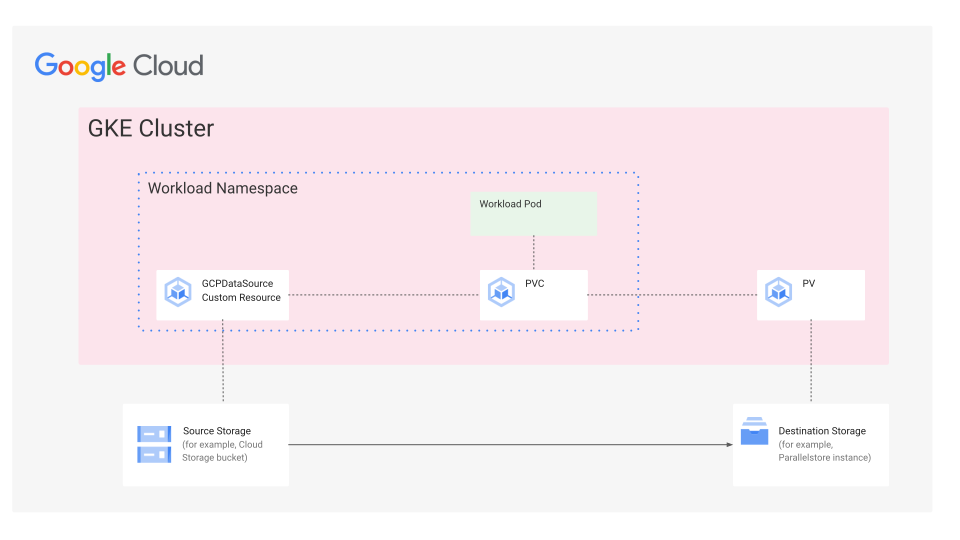
בתרשים הבא מוצג זרימת הנתונים מאחסון המקור לאחסון היעד, ואיך נוצר PersistentVolume לאחסון היעד באמצעות GKE Volume Populator.
- יוצרים PVC שמפנה למשאב בהתאמה אישית של
GCPDataSource. - הכלי GKE Volume Populator מזהה את ה-PVC ומתחיל משימת העברת נתונים.
- משימת ההעברה פועלת במאגר צמתים קיים, או שנוצר מאגר חדש אם מופעלת הקצאת צמתים אוטומטית (NAP).
- משימת ההעברה מעתיקה נתונים מהקטגוריה של Cloud Storage שצוינה במשאב
GCPDataSourceלנפח האחסון ביעד. - אחרי שההעברה מסתיימת, ה-PVC מקושר לנפח האחסון של היעד, והנתונים זמינים ל-Pod של עומס העבודה.
יתרונות מרכזיים
ל-GKE Volume Populator יש כמה יתרונות:
- אכלוס נתונים אוטומטי: אכלוס אוטומטי של נפחים עם נתונים מ-Cloud Storage במהלך ההקצאה, כדי לצמצם את התקורה התפעולית.
- ניידות נתונים חלקה: העברת נתונים ממאגר אובייקטים למערכות אחסון בלוקים עם ביצועים גבוהים (Hyperdisk) כדי לבצע אופטימיזציה למחיר או לביצועים על סמך צורכי עומס העבודה.
- תהליכי עבודה פשוטים יותר: פחות צורך במשימות נפרדות של טעינת נתונים או בהתערבות ידנית כדי להכין אמצעי אחסון קבועים.
- שילוב עם ניהול זהויות והרשאות גישה (IAM): אפשר להשתמש באימות מבוסס-IAM באמצעות איחוד זהויות של עומסי עבודה ל-GKE כדי להבטיח העברת נתונים מאובטחת עם בקרת גישה מדויקת.
- עומסי עבודה מואצים של AI/ML: טעינה מראש של קבוצות נתונים גדולות, מודלים ומשקלים ישירות לאחסון עם ביצועים גבוהים, כדי להאיץ את משימות האימון וההסקה.
תרחישים לדוגמה לשימוש ב-GKE Volume Populator
אתם יכולים להשתמש ב-GKE Volume Populator כדי לטעון מערכי נתונים גדולים לאימון של AI/ML. נניח שיש לכם קבוצת נתונים בגודל של כמה טרה-בייטים לאימון מודל שפה גדול (LLM) שמאוחסן בקטגוריה של Cloud Storage. משימת האימון שלכם פועלת ב-GKE ודורשת ביצועי קלט/פלט גבוהים. במקום להעתיק את הנתונים באופן ידני, אתם יכולים להשתמש ב-GKE Volume Populator כדי להקצות באופן אוטומטי נפח של Hyperdisk ML, ולאכלס אותו במערך הנתונים מ-Cloud Storage כשנוצר ה-PVC. התהליך האוטומטי הזה עוזר להבטיח שה-Pods לאימון יתחילו עם גישה מיידית ומהירה לנתונים.
הנה עוד כמה דוגמאות לשימוש ב-GKE Volume Populator:
- שמירה מראש במטמון של נכסים ומשקלים של מודלים של AI/ML מ-Cloud Storage בכרכים של Hyperdisk ML כדי לקצר את זמני הטעינה של המודלים לצורך הסקת מסקנות.
- העברת נתונים מ-Cloud Storage לנפחים מתמידים לאפליקציות עם מצב (stateful) שנדרשת בהן גישה לדיסק עם ביצועים טובים.
המאמרים הבאים
- אוטומציה של העברת נתונים ל-Hyperdisk ML באמצעות GKE Volume Populator.
- פתרון בעיות בהעברת נתונים של GKE Volume Populator