

בדף הזה מוסבר איך לבצע פריסה הדרגתית של גרסאות חדשות של תשתית ההסקה ב-GKE Inference Gateway. השער הזה מאפשר לכם לבצע עדכונים בטוחים ומבוקרים בתשתית ההסקה. אתם יכולים לעדכן צמתים, מודלים בסיסיים ומתאמי LoRA עם הפרעה מינימלית לשירות. בדף הזה יש גם הנחיות לגבי חלוקת התנועה והחזרות למצב הקודם, כדי להבטיח פריסות אמינות.
הדף הזה מיועד לאדמינים של זהויות וחשבונות ב-GKE ולמפתחים שרוצים לבצע פעולות השקה של GKE Inference Gateway.
אלה תרחישי השימוש הנתמכים:
עדכון פריסת צומת
עדכוני הצמתים מעבירים בבטחה עומסי עבודה של הסקת מסקנות לחומרה חדשה של צמתים או להגדרות חדשות של מאיצים. התהליך הזה מתרחש באופן מבוקר בלי להפריע לשירות המודל. אפשר להשתמש בעדכוני צמתים כדי לצמצם את ההפרעה לשירותים במהלך שדרוגי חומרה, עדכוני מנהלי התקנים או פתרון בעיות אבטחה.
יצירת
InferencePoolחדש: פריסתInferencePoolשמוגדר עם המפרטים המעודכנים של הצומת או החומרה.פיצול התנועה באמצעות
HTTPRoute: מגדיריםHTTPRouteכדי לחלק את התנועה בין משאביInferencePoolקיימים וחדשים. משתמשים בשדהweightב-backendRefsכדי לנהל את אחוז התנועה שמופנה לצמתים החדשים.שמירה על עקביות
InferenceObjective: כדי להבטיח התנהגות אחידה של המודל בשתי הגדרות הצומת, חשוב לשמור על ההגדרה הקיימת שלInferenceObjective.שמירה של המשאבים המקוריים: משאירים את
InferencePoolוהצמתים המקוריים פעילים במהלך ההשקה כדי לאפשר ביטול של השינויים אם צריך.
לדוגמה, אפשר ליצור InferencePool חדש בשם llm-new. מגדירים את המאגר הזה עם אותן הגדרות מודל כמו ב-llm
InferencePool הקיים. פורסים את המאגר בקבוצה חדשה של צמתים בתוך האשכול. אפשר להשתמש באובייקט HTTPRoute כדי לפצל את התנועה בין llm המקורי לבין llm-new InferencePool החדש. השיטה הזו מאפשרת לכם לעדכן את צומתי המודל באופן מצטבר.
בתרשים הבא אפשר לראות איך GKE Inference Gateway מבצע השקה של עדכון צומת.
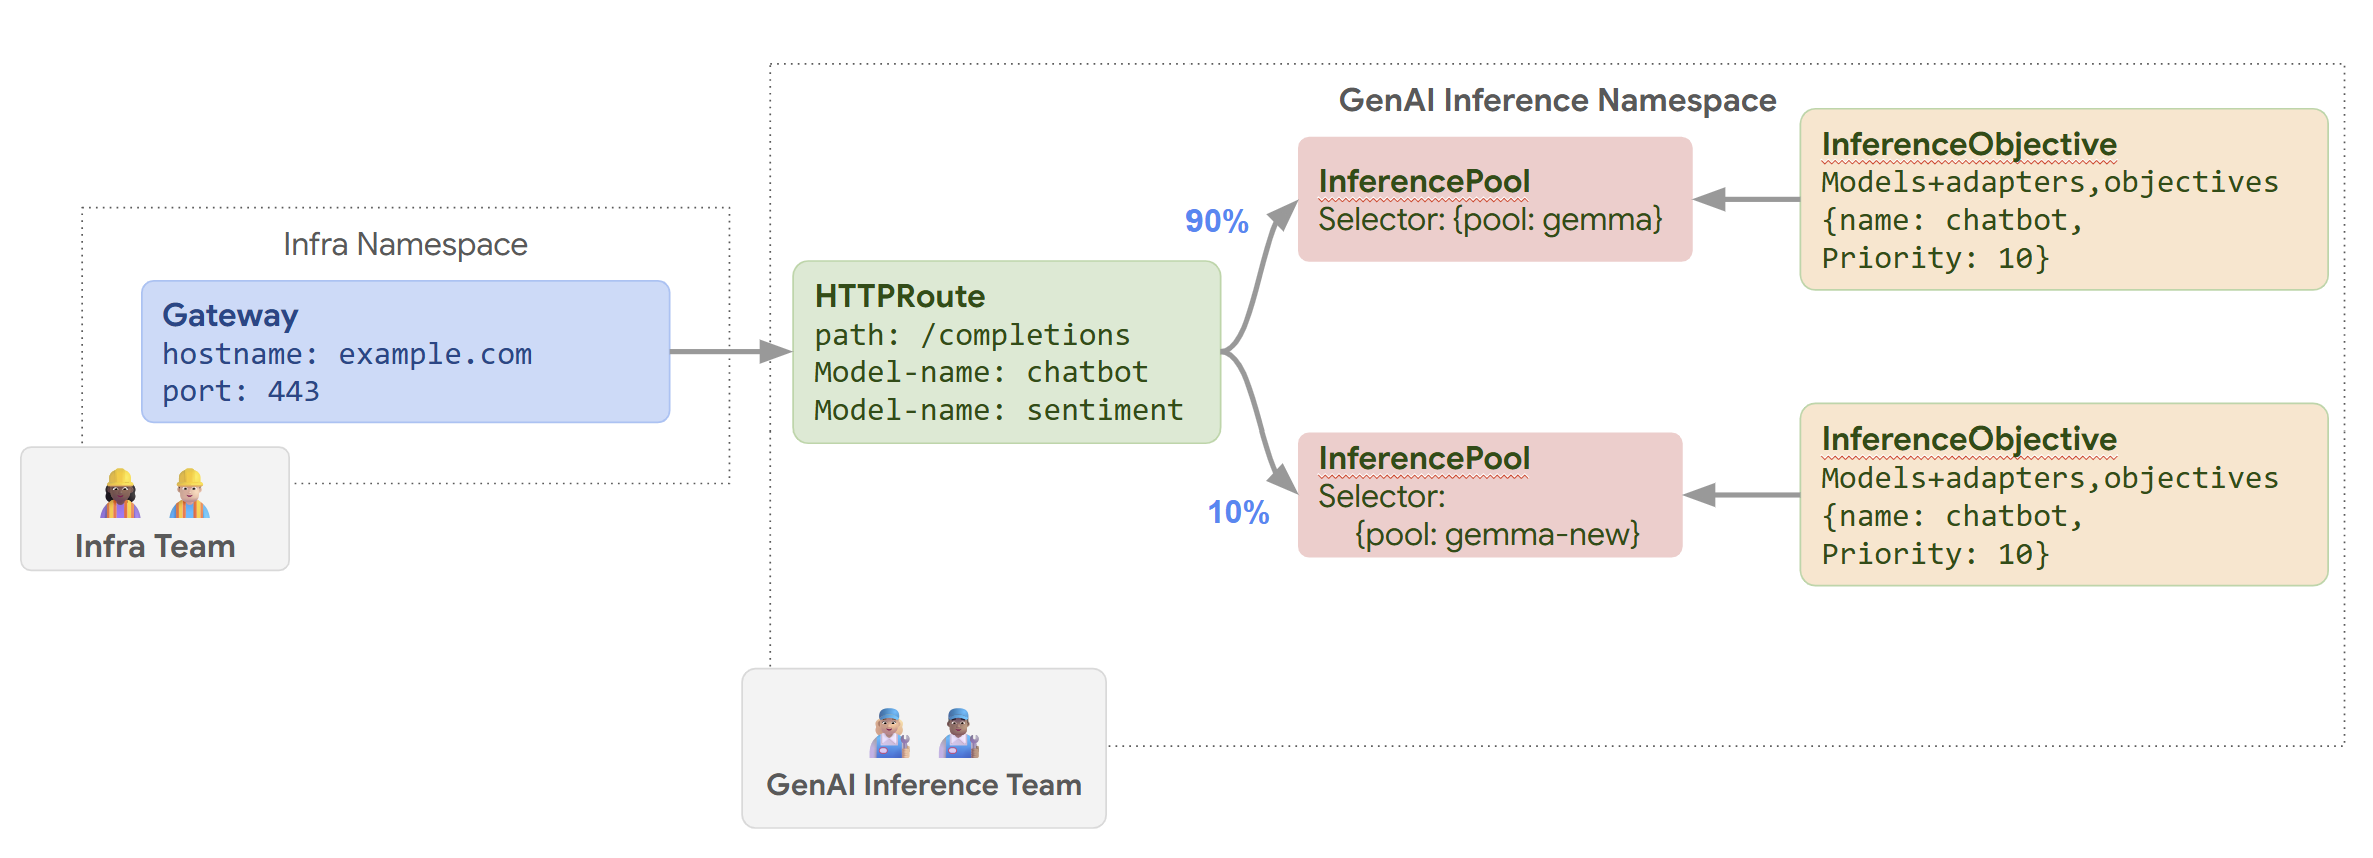
כדי לבצע פריסה של עדכון צומת:
שומרים את קובץ המניפסט לדוגמה הבא בשם
routes-to-llm.yaml:apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: routes-to-llm spec: parentRefs: - name: my-inference-gateway group: gateway.networking.k8s.io kind: Gateway rules: - backendRefs: - name: llm group: inference.networking.k8s.io kind: InferencePool weight: 90 - name: llm-new group: inference.networking.k8s.io kind: InferencePool weight: 10מחילים את קובץ המניפסט לדוגמה על האשכול:
kubectl apply -f routes-to-llm.yaml
הגרסה המקורית llm InferencePool מקבלת את רוב התנועה, והגרסה llm-new InferencePool מקבלת את שאר התנועה. כדי להשלים את השקת העדכון של הצומת, מגדילים בהדרגה את משקל התנועה של llm-new InferencePool.
השקת מודל בסיס
עדכונים של מודלים בסיסיים מופצים בשלבים למודל LLM בסיסי חדש, תוך שמירה על תאימות למתאמי LoRA קיימים. אתם יכולים להשתמש בהשקות של עדכונים למודל הבסיס כדי לשדרג לארכיטקטורות משופרות של מודלים או כדי לטפל בבעיות ספציפיות למודל.
כדי להשיק עדכון למודל בסיס:
- פריסת תשתית חדשה: יצירת צמתים חדשים ו-
InferencePoolחדש שהוגדר עם מודל הבסיס החדש שבחרתם. - הגדרת חלוקת התנועה: משתמשים ב-
HTTPRouteכדי לפצל את התנועה בין ה-InferencePoolהקיים (שמשתמש במודל הבסיס הישן) לבין ה-InferencePoolהחדש (שמשתמש במודל הבסיס החדש). השדהbackendRefs weightקובע את אחוז התנועה שמוקצה לכל מאגר. - שמירה על שלמות
InferenceObjective: ההגדרה שלInferenceObjectiveלא משתנה. הגישה הזו עוזרת להבטיח שהמערכת תחיל את אותם מתאמי LoRA באופן עקבי על שתי הגרסאות של מודל הבסיס. - שמירה על אפשרות הביטול: כדאי לשמור את הצמתים המקוריים ואת
InferencePoolבמהלך ההשקה כדי לאפשר ביטול אם יהיה צורך בכך.
יוצרים InferencePool חדש בשם llm-pool-version-2. המאגר הזה פורס גרסה חדשה של מודל הבסיס בקבוצה חדשה של צמתים. על ידי הגדרת HTTPRoute, כמו בדוגמה שמוצגת, אפשר לפצל את התנועה באופן הדרגתי בין llm-pool המקורי לבין llm-pool-version-2. כך אתם יכולים לשלוט בעדכונים של מודל הבסיס באשכול.
כדי להשיק עדכון למודל בסיס:
שומרים את המניפסט לדוגמה הבא בתור
routes-to-llm.yaml:apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: routes-to-llm spec: parentRefs: - name: my-inference-gateway group: gateway.networking.k8s.io kind: Gateway rules: - backendRefs: - name: llm-pool group: inference.networking.k8s.io kind: InferencePool weight: 90 - name: llm-pool-version-2 group: inference.networking.k8s.io kind: InferencePool weight: 10מחילים את קובץ המניפסט לדוגמה על האשכול:
kubectl apply -f routes-to-llm.yaml
הגרסה המקורית llm-pool InferencePool מקבלת את רוב התנועה, והגרסה llm-pool-version-2 InferencePool מקבלת את שאר התנועה. כדי להשלים את השקת העדכון של מודל הבסיס, צריך להגדיל בהדרגה את משקל התנועה של llm-pool-version-2 InferencePool.