

Esta página mostra como realizar operações de lançamento incremental, que implantam gradualmente novas versões da infraestrutura de inferência para o GKE Inference Gateway. Esse gateway permite realizar atualizações seguras e controladas na infraestrutura de inferência. É possível atualizar nós, modelos de base e adaptadores LoRA com interrupção mínima do serviço. Esta página também oferece orientações sobre divisão de tráfego e reversões para garantir implantações confiáveis.
Esta página é destinada a administradores de identidade e conta do GKE e desenvolvedores que querem realizar operações de lançamento para o GKE Inference Gateway.
Os seguintes casos de uso são compatíveis:
- Lançamento de atualização de nós (computação, acelerador)
- Lançamento de atualização do modelo de base
Atualizar um lançamento de nó
As atualizações de nós migram cargas de trabalho de inferência com segurança para novas configurações de hardware ou acelerador de nós. Esse processo ocorre de maneira controlada, sem interromper o serviço do modelo. Use atualizações de nós para minimizar a interrupção do serviço durante upgrades de hardware, atualizações de driver ou resolução de problemas de segurança.
Criar um novo
InferencePool: implante umInferencePoolconfigurado com as especificações atualizadas do nó ou do hardware.Dividir o tráfego usando um
HTTPRoute: configure umHTTPRoutepara distribuir o tráfego entre os recursosInferencePoolatuais e novos. Use o campoweightembackendRefspara gerenciar a porcentagem de tráfego direcionada aos novos nós.Manter um
InferenceObjectiveconsistente: mantenha a configuraçãoInferenceObjectiveatual para garantir um comportamento uniforme do modelo nas duas configurações de nó.Manter os recursos originais: mantenha o
InferencePoole os nós ativos durante o lançamento para permitir reversões, se necessário.
Por exemplo, é possível criar um novo InferencePool chamado llm-new. Configure esse pool com a mesma configuração de modelo do InferencePool llm atual. Implante o pool em um novo conjunto de nós no cluster. Use
um objeto HTTPRoute para dividir o tráfego entre o llm original e o novo
llm-new InferencePool. Essa técnica permite atualizar os nós do modelo de maneira incremental.
O diagrama a seguir ilustra como o GKE Inference Gateway realiza um lançamento de atualização de nós.
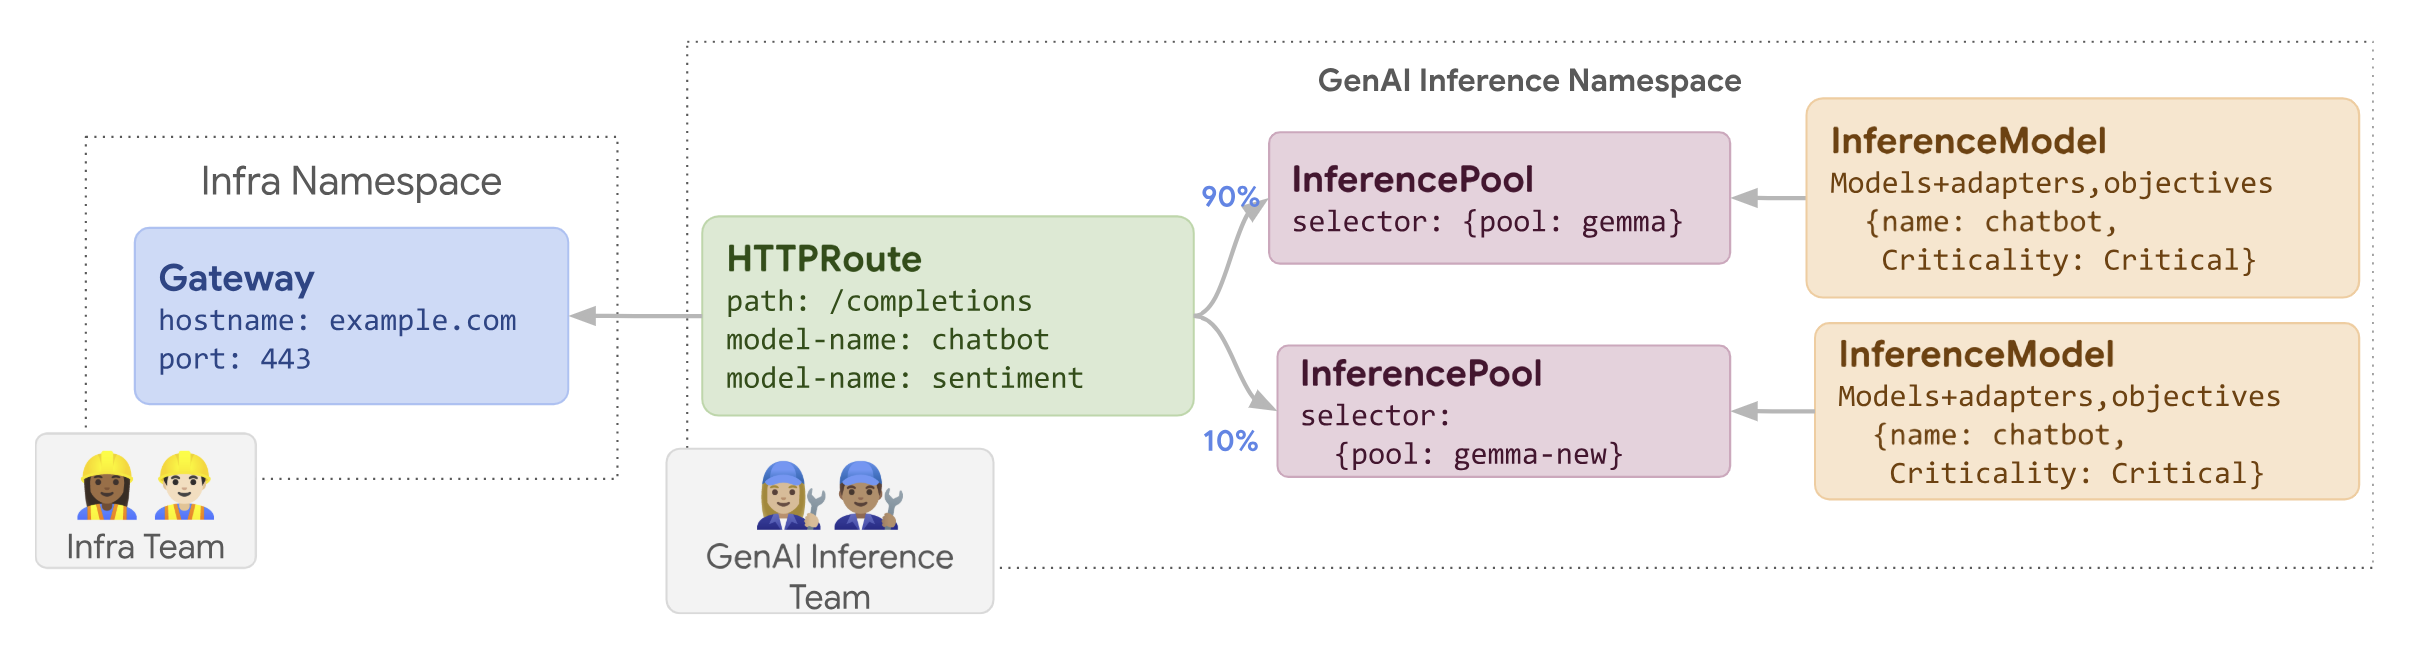
Para realizar um lançamento de atualização de nós, siga estas etapas:
Salve o seguinte manifesto de amostra como
routes-to-llm.yaml:apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: routes-to-llm spec: parentRefs: - name: my-inference-gateway group: gateway.networking.k8s.io kind: Gateway rules: - backendRefs: - name: llm group: inference.networking.k8s.io kind: InferencePool weight: 90 - name: llm-new group: inference.networking.k8s.io kind: InferencePool weight: 10Aplique o manifesto de amostra ao cluster:
kubectl apply -f routes-to-llm.yaml
O InferencePool llm original recebe a maior parte do tráfego, enquanto o
InferencePool llm-new recebe o restante. Aumente o peso do tráfego gradualmente para o InferencePool llm-new para concluir o lançamento da atualização do nó.
Lançar um modelo de base
As atualizações do modelo de base são lançadas em fases para um novo LLM de base, mantendo a compatibilidade com os adaptadores LoRA atuais. É possível usar lançamentos de atualização do modelo de base para fazer upgrade para arquiteturas de modelo aprimoradas ou para resolver problemas específicos do modelo.
Para lançar uma atualização do modelo de base:
- Implantar uma nova infraestrutura: crie novos nós e um novo
InferencePoolconfigurado com o novo modelo de base escolhido. - Configurar a distribuição de tráfego: use um
HTTPRoutepara dividir o tráfego entre oInferencePoolatual (que usa o modelo de base antigo) e o novoInferencePool(usando o novo modelo de base). O campobackendRefs weightcontrola a porcentagem de tráfego alocada para cada pool. - Manter a integridade do
InferenceObjective: mantenha a configuraçãoInferenceObjectiveinalterada. Essa abordagem ajuda a garantir que o sistema aplique os mesmos adaptadores LoRA de maneira consistente nas duas versões do modelo de base. - Preservar a capacidade de reversão: mantenha os nós e o
InferencePooloriginais durante o lançamento para facilitar uma reversão, se necessário.
Crie um novo InferencePool chamado llm-pool-version-2. Esse pool implanta uma nova versão do modelo de base em um novo conjunto de nós. Ao
configurar um HTTPRoute, conforme mostrado no exemplo fornecido, é possível
dividir o tráfego de maneira incremental entre o llm-pool original e
llm-pool-version-2. Isso permite controlar as atualizações do modelo de base no cluster.
Para realizar um lançamento de atualização do modelo de base, siga estas etapas:
Salve o seguinte manifesto de amostra como
routes-to-llm.yaml:apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: routes-to-llm spec: parentRefs: - name: my-inference-gateway group: gateway.networking.k8s.io kind: Gateway rules: - backendRefs: - name: llm-pool group: inference.networking.k8s.io kind: InferencePool weight: 90 - name: llm-pool-version-2 group: inference.networking.k8s.io kind: InferencePool weight: 10Aplique o manifesto de amostra ao cluster:
kubectl apply -f routes-to-llm.yaml
O InferencePool llm-pool original recebe a maior parte do tráfego, enquanto o
InferencePool llm-pool-version-2 recebe o restante. Aumente o peso do tráfego gradualmente para o InferencePool llm-pool-version-2 para concluir o lançamento da atualização do modelo de base.
A seguir
- Personalizar a configuração do GKE Inference Gateway
- Disponibilizar um LLM com o GKE Inference Gateway