

בדף הזה מתוארים המדדים ולוחות הבקרה שזמינים למעקב אחרי זמן האחזור של הפעלת עומסי עבודה (workload) ב-Google Kubernetes Engine (GKE) וצמתי האשכול הבסיסיים. אתם יכולים להשתמש במדדים כדי לעקוב אחרי זמן האחזור בהפעלה, לפתור בעיות ולצמצם אותו.
הדף הזה מיועד לאדמינים ולמפעילים של פלטפורמות שצריכים לעקוב אחרי זמן האחזור של הפעלת עומסי העבודה שלהם ולבצע אופטימיזציה שלו. למידע נוסף על תפקידים נפוצים שאנחנו מתייחסים אליהם בתוכן של Cloud de Confiance by S3NS , קראו את המאמר תפקידים ומשימות נפוצים של משתמשי GKE.
סקירה כללית
זמן האחזור של ההפעלה משפיע באופן משמעותי על האופן שבו האפליקציה מגיבה לעליות חדות בתנועה, על המהירות שבה הרפליקות שלה מתאוששות מהפרעות ועל היעילות של עלויות התפעול של האשכולות ועומסי העבודה. מעקב אחרי זמן האחזור של עומסי העבודה בזמן ההפעלה יכול לעזור לכם לזהות ירידה בזמן האחזור, ולעקוב אחרי ההשפעה של עדכונים בעומסי העבודה ובתשתית על זמן האחזור בזמן ההפעלה.
לאופטימיזציה של זמן האחזור של הפעלת עומס העבודה יש את היתרונות הבאים:
- מפחית את זמן האחזור של התגובה של השירות למשתמשים בזמן עליות חדות בתנועה.
- מפחית את קיבולת ההצגה העודפת שנדרשת כדי לספוג עליות חדות בביקוש בזמן שנוצרות רפליקות חדשות.
- הפחתת זמן ההמתנה של משאבים שכבר נפרסו וממתינים להפעלת שאר המשאבים במהלך חישובים באצווה.
לפני שמתחילים
לפני שמתחילים, חשוב לוודא שביצעתם את המשימות הבאות:
- מפעילים את ממשק ה-API של Google Kubernetes Engine. הפעלת Google Kubernetes Engine API
- כדי להשתמש ב-CLI של Google Cloud למשימה הזו, צריך להתקין ואז לאתחל את ה-CLI של gcloud. אם כבר התקנתם את ה-CLI של gcloud, הריצו את הפקודה
gcloud components updateכדי לקבל את הגרסה העדכנית. יכול להיות שגרסאות קודמות של ה-CLI של gcloud לא יתמכו בהרצת הפקודות שמופיעות במסמך הזה.
מפעילים את Cloud Logging API ואת Cloud Monitoring API.
תפקידים שנדרשים להפעלת ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים
דרישות
כדי להציג מדדים ומרכזי בקרה של זמן האחזור בהפעלה של עומסי עבודה, אשכול ה-GKE צריך לעמוד בדרישות הבאות:
- צריך להשתמש בגרסה 1.31.1-gke.1678000 ואילך של GKE.
- צריך להגדיר איסוף של מדדי מערכת.
- צריך להגדיר איסוף של יומני מערכת.
- כדי לראות את המדדים של ה-Pod והקונטיינר, מפעילים את kube state metrics באמצעות הרכיב
PODבאשכולות.
תפקידים והרשאות נדרשים
כדי לקבל את ההרשאות שדרושות להפעלת יצירת יומנים ולגישה ליומנים ולעיבוד שלהם, צריך לבקש מהאדמין להקצות לכם את תפקידי ה-IAM הבאים:
-
צפייה באשכולות, בצמתים ובעומסי העבודה של GKE:
צפייה ב-Kubernetes Engine (
roles/container.viewer) בפרויקט -
כדי לגשת למדדי זמן האחזור של ההפעלה ולהציג את לוחות הבקרה:
Monitoring Viewer (
roles/monitoring.viewer) בפרויקט -
יומני גישה עם מידע על זמן האחזור, כמו אירועי משיכת תמונות של Kubelet, וצפייה בהם בכלי Logs Explorer וב-Observability Analytics:
מציג היומנים (
roles/logging.viewer) בפרויקט
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
יכול להיות שאפשר לקבל את ההרשאות הנדרשות גם באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש.
מדדי זמן הטעינה של ההפעלה
מדדי זמן האחזור של ההפעלה כלולים במדדי המערכת של GKE ומיוצאים ל-Cloud Monitoring באותו פרויקט כמו אשכול GKE.
לשמות של מדדי Cloud Monitoring בטבלה הזו צריך להוסיף את הקידומת kubernetes.io/. התחילית הזו הושמטה מהערכים בטבלה.
| סוג המדד (רמות בהיררכיית המשאבים) השם המוצג |
|
|---|---|
|
Kind, Type, Unit
משאבים במעקב |
תיאור תוויות |
pod/latencies/pod_first_ready
(project)
Pod first ready latency |
|
GAUGE, Double, s
k8s_pod |
זמן האחזור של הפעלת Pod מקצה לקצה (מ-Pod Created עד Ready), כולל משיכות תמונות. נדגמים כל 60 שניות. |
node/latencies/startup
(project)
זמן האחזור של הפעלת הצומת |
|
GAUGE, INT64, s
k8s_node |
זמן האחזור הכולל של הפעלת הצומת, מהאירוע CreationTimestamp של מכונת GCE ועד לאירוע Kubernetes node ready בפעם הראשונה. נדגמים כל 60 שניות.accelerator_family: סיווג של צמתים על סמך שיפור מהירות באמצעות חומרה: gpu, tpu, cpu.
kube_control_plane_available: אם הבקשה ליצירת הצומת התקבלה כש-KCP (מישור הבקרה של kube) היה זמין.
|
autoscaler/latencies/per_hpa_recommendation_scale_latency_seconds
(project)
Per HPA recommendation scale latency |
|
GAUGE, DOUBLE, s
k8s_scale |
השהיית המלצות לשינוי גודל של Horizontal Pod Autoscaler (HPA) (הזמן שחלף בין יצירת המדדים לבין יישום ההמלצה התואמת לשינוי גודל ב-apiserver) עבור יעד ה-HPA. נדגם כל 60 שניות. אחרי הדגימה, הנתונים לא מוצגים במשך עד 20 שניות.metric_type: סוג מקור המדד. הערך צריך להיות אחד מהערכים הבאים: "ContainerResource", "External", "Object", "Pods" או "Resource".
|
הצגת לוח הבקרה "זמן אחזור בהפעלה" לעומסי עבודה
לוח הבקרה Startup Latency (זמן האחזור של ההפעלה) לעומסי עבודה זמין רק לפריסות. כדי לראות את מדדי זמן האחזור של הפעלת פריסות, מבצעים את השלבים הבאים במסוף Cloud de Confiance :
נכנסים לדף Workloads.
כדי לפתוח את התצוגה פרטי הפריסה, לוחצים על שם עומס העבודה שרוצים לבדוק.
לוחצים על הכרטיסייה Observability (יכולת תצפית).
בתפריט שמימין, בוחרים באפשרות זמן האחזור של ההפעלה.
הצגת ההתפלגות של זמן הטעינה אחרי הפעלה של Pods
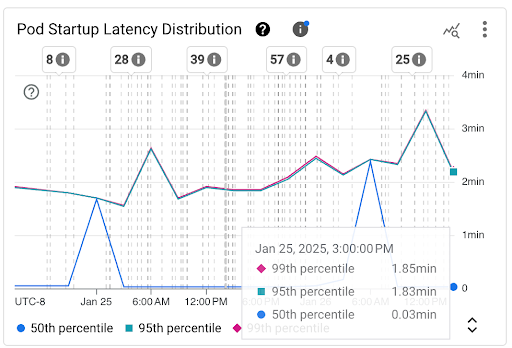
זמן ההשהיה בהפעלה של Pods מתייחס לזמן ההשהיה הכולל בהפעלה, כולל משיכות של תמונות, שמודד את הזמן מהסטטוס Created של ה-Pod עד לסטטוס Ready. כדי להעריך את זמן האחזור בהפעלה של Pods, אפשר להשתמש בשני התרשימים הבאים:
תרשים Pod Startup Latency Distribution: בתרשים הזה מוצגים האחוזונים של חביון ההפעלה של ה-Pods (האחוזון ה-50, ה-95 וה-99) שמחושבים על סמך התצפיות של אירועי ההפעלה של ה-Pods במרווחי זמן קבועים של 3 שעות, לדוגמה, 00:00 עד 03:00 ו-03:00 עד 06:00. אפשר להשתמש בתרשים הזה למטרות הבאות:
- הסבר על זמן האחזור הבסיסי של הפעלת Pod.
- לזהות שינויים בחביון של הפעלת ה-Pod לאורך זמן.
- אפשר להשוות בין השינויים בחביון של הפעלת ה-Pod לבין אירועים מהזמן האחרון, כמו פריסות של עומסי עבודה או אירועים של מידרוג אוטומטי באשכול. אתם יכולים לבחור את האירועים ברשימה הערות בחלק העליון של מרכז הבקרה.
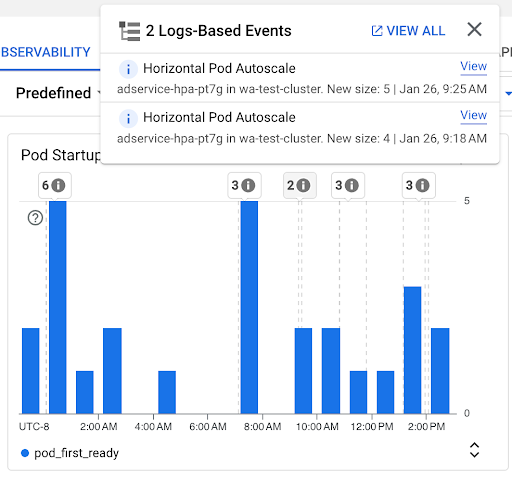
התרשים Pod Startup Count: בתרשים הזה מוצג מספר ה-Pods שהופעלו במהלך מרווחי הזמן שנבחרו. אפשר להשתמש בתרשים הזה למטרות הבאות:
- להבין את גודלי הדגימות של Pod שמשמשים לחישוב האחוזונים של התפלגות זמן האחזור של הפעלת Pod במרווח זמן נתון.
- הסבר על הסיבות להפעלת Pod, כמו פריסות של עומסי עבודה או אירועים של Horizontal Pod Autoscaler. אפשר לבחור את האירועים ברשימה Annotations (הערות) בחלק העליון של לוח הבקרה.
הצגת זמן האחזור של ההפעלה של Pods ספציפיים
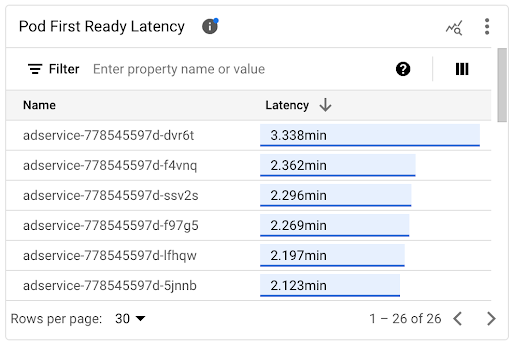
אפשר לראות את זמן האחזור של הפעלת כל אחד מה-Pods בתרשים ציר הזמן Pod First Ready Latency וברשימה שמשויכת אליו.
- בתרשים ציר הזמן Pod First Ready Latency אפשר לראות את הקשר בין הפעלות של Pods ספציפיים לבין אירועים שהתרחשו לאחרונה, כמו אירועים של Horizontal Pod Autoscaler או Cluster Autoscaler. אפשר לבחור את האירועים האלה ברשימה הערות בחלק העליון של מרכז הבקרה. התרשים הזה עוזר לכם לקבוע מה יכולות להיות הסיבות לשינויים בזמן האחזור של ההפעלה בהשוואה ל-Pods אחרים.
- משתמשים ברשימה Pod First Ready Latency כדי לזהות Pods ספציפיים שההפעלה שלהם ארכה הכי הרבה זמן או הכי מעט זמן. אפשר למיין את הרשימה לפי העמודה Latency. כשמזהים Pods עם זמן האחזור הכי גבוה של תהליך ההפעלה, אפשר לפתור בעיות שקשורות לירידה בביצועים של זמן האחזור על ידי שיוך של אירועי ההפעלה של ה-Pod לאירועים אחרים מהזמן האחרון.
כדי לברר מתי נוצר Pod מסוים, אפשר לבדוק את הערך בשדה timestamp באירוע המתאים של יצירת Pod. כדי לראות את השדה timestamp, מריצים את השאילתה הבאה ב-Logs Explorer:
   log_id("cloudaudit.googleapis.com/activity") AND
   protoPayload.methodName="io.k8s.core.v1.pods.create" AND
   resource.labels.project_id=PROJECT_ID AND
   resource.labels.cluster_name=CLUSTER_NAME AND
   resource.labels.location=CLUSTER_LOCATION AND
   protoPayload.response.metadata.namespace=NAMESPACE AND
   protoPayload.response.metadata.name=POD_NAME
כדי להציג את כל אירועי היצירה של Pod בעומס העבודה, משתמשים במסנן הבא בשאילתה הקודמת:
protoPayload.response.metadata.name=~"POD_NAME_PREFIX-[a-f0-9]{7,10}-[a-z0-9]{5}"
כשמשווים בין זמני האחזור של Pods נפרדים, אפשר לבדוק את ההשפעה של הגדרות שונות על זמן האחזור של הפעלת Pod, ולזהות את ההגדרה האופטימלית בהתאם לדרישות שלכם.
קביעת זמן האחזור של תזמון ה-Pod
זמן האחזור של תזמון Pod הוא משך הזמן שעובר מרגע שנוצר Pod ועד שהוא מתוזמן בצומת. זמן האחזור של תזמון Pod תורם לזמן ההפעלה מקצה לקצה של Pod, והוא מחושב על ידי חיסור חותמות הזמן של אירוע תזמון Pod ובקשה ליצירת Pod.
אפשר למצוא חותמת זמן של אירוע תזמון Pod ספציפי בשדה jsonPayload.eventTime באירוע תזמון Pod תואם. כדי לראות את השדה jsonPayload.eventTime, מריצים את השאילתה הבאה ב-Logs Explorer:
  log_id("events")
  jsonPayload.reason="Scheduled"
  resource.type="k8s_pod"
  resource.labels.project_id=PROJECT_ID
  resource.labels.location=CLUSTER_LOCATION
  resource.labels.cluster_name=CLUSTER_NAME
  resource.labels.namespace_name=NAMESPACE
  resource.labels.pod_name=POD_NAME
כדי להציג ברשימה את כל אירועי התזמון של ה-Pod עבור עומס העבודה, משתמשים במסנן הבא בשאילתה הקודמת:
resource.labels.pod_name=~"POD_NAME_PREFIX-[a-f0-9]{7,10}-[a-z0-9]{5}"
צפייה בזמן האחזור של שליפת תמונות
השהיית השליפה של קובץ האימג' של הקונטיינר תורמת להשהיית ההפעלה של ה-Pod בתרחישים שבהם קובץ האימג' עדיין לא זמין בצומת או שצריך לרענן את קובץ האימג'. כשמבצעים אופטימיזציה של זמן האחזור של שליפת תמונות, מקטינים את זמן האחזור של הפעלת עומס העבודה במהלך אירועים של הרחבת קלאסטר.
בטבלה Kubelet Image Pull Events אפשר לראות מתי נשלפו קובצי האימג' של הקונטיינרים של עומס העבודה וכמה זמן התהליך נמשך.
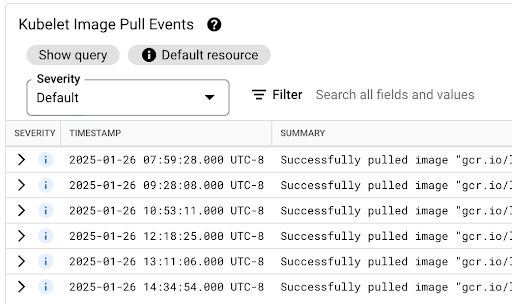
זמן האחזור של שליפת התמונה זמין בשדה jsonPayload.message, שמכיל הודעה כמו זו:
"Successfully pulled image "gcr.io/example-project/image-name" in 17.093s (33.051s including waiting). Image size: 206980012 bytes."
הצגת התפלגות זמן האחזור של המלצות להתאמה לעומס (scaling) של HPA
זמן האחזור של המלצות להתאמה לעומס של Horizontal Pod Autoscaler (HPA) ליעד ה-HPA הוא משך הזמן שבין יצירת המדדים לבין החלת ההמלצה המתאימה להתאמה לעומס על שרת ה-API. כשמבצעים אופטימיזציה של זמן האחזור של ההמלצה על שינוי הגודל של HPA, מקטינים את זמן האחזור של הפעלת עומס העבודה במהלך אירועי הרחבה אופקית.
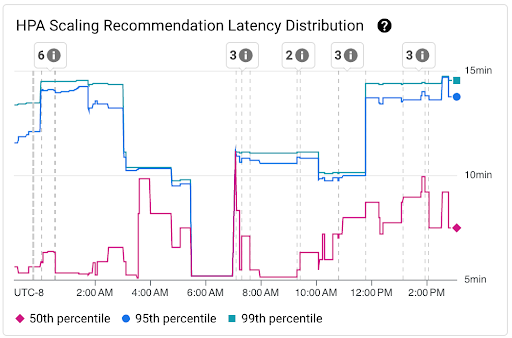
אפשר לראות את קנה המידה של HPA בשני התרשימים הבאים:
תרשים HPA Scaling Recommendation Latency Distribution (התפלגות חביון ההמלצות לשינוי גודל של HPA): התרשים הזה מציג את האחוזונים של חביון ההמלצות לשינוי גודל של HPA (אחוזון 50, אחוזון 95 ואחוזון 99) שמחושבים על סמך התצפיות של ההמלצות לשינוי גודל של HPA במרווחי זמן של 3 שעות. אפשר להשתמש בתרשים הזה למטרות הבאות:
- להבין את זמן האחזור של ההמלצה הבסיסית לשינוי קנה המידה של HPA.
- לזהות שינויים בחביון של המלצות לגבי שינוי גודל של HPA לאורך זמן.
- התאמה בין שינויים בזמן האחזור של המלצות להתאמה לעומס (scaling) של HPA לבין אירועים אחרונים. אפשר לבחור את האירועים ברשימה הערות בחלק העליון של מרכז הבקרה.
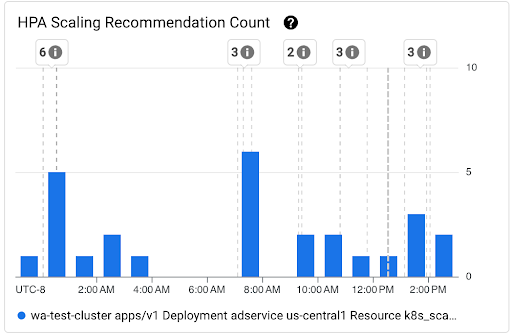
התרשים HPA Scaling Recommendation Count: בתרשים הזה מוצג מספר ההמלצות לשינוי קנה המידה של HPA שנצפו במהלך מרווח הזמן שנבחר. אפשר להשתמש בתרשים כדי לבצע את המשימות הבאות:
- הסבר על גודלי הדגימות של ההמלצות לשינוי קנה המידה של HPA. הדגימות משמשות לחישוב האחוזונים בהתפלגות זמן האחזור, לצורך המלצות לשינוי קנה המידה של HPA במרווח זמן נתון.
- התאמה בין המלצות לשינוי גודל של HPA לבין אירועים חדשים של הפעלת Pod ואירועים של Horizontal Pod Autoscaler. אפשר לבחור את האירועים ברשימה הערות בחלק העליון של לוח הבקרה.
צפייה בבעיות בתזמון של Pods
בעיות בתזמון Pods עלולות להשפיע על זמן האחזור של ההפעלה מקצה לקצה של עומס העבודה. כדי לצמצם את זמן האחזור של עומס העבודה מקצה לקצה, פתרו את הבעיות האלה וצמצמו את מספר הבעיות.
אלה שני התרשימים שזמינים למעקב אחרי בעיות כאלה:
- בתרשים Unschedulable/Pending/Failed Pods מוצג מספר הפודים שלא ניתן לתזמן, הפודים בהמתנה והפודים שנכשלו לאורך זמן.
- בתרשים Backoff/Waiting/Readiness Failed Containers מוצג מספר הקונטיינרים במצבים האלה לאורך זמן.
הצגת לוח הבקרה של זמן האחזור של הפעלת הצמתים
כדי לראות את מדדי זמן האחזור של הפעלת הצמתים, פועלים לפי השלבים הבאים בCloud de Confiance מסוף:
נכנסים לדף Kubernetes Clusters.
כדי לפתוח את התצוגה Cluster details, לוחצים על שם האשכול שרוצים לבדוק.
לוחצים על הכרטיסייה Observability (יכולת תצפית).
בתפריט הימני, בוחרים באפשרות זמן האחזור של ההפעלה.
הצגת ההתפלגות של זמן הטעינה אחרי הפעלה של הצמתים
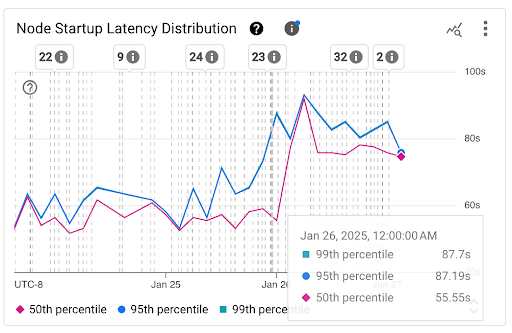
זמן האחזור של הפעלת צומת מתייחס לזמן האחזור הכולל של ההפעלה, שמודד את הזמן מה-CreationTimestamp של הצומת עד לסטטוס Kubernetes node ready. אפשר לראות את זמן האחזור של הפעלת הצומת בשני התרשימים הבאים:
התרשים Node Startup Latency Distribution: בתרשים הזה מוצגים האחוזונים של זמן האחזור בהפעלת הצומת (האחוזון ה-50, האחוזון ה-95 והאחוזון ה-99), שמחושבים על סמך התצפיות של אירועי הפעלת הצומת במרווחי זמן קבועים של 3 שעות, למשל 12:00 AM-3:00 AM ו-3:00 AM-6:00 AM. אתם יכולים להשתמש בתרשים הזה למטרות הבאות:
- להבין את זמן האחזור הבסיסי של הפעלת הצומת.
- לזהות שינויים בזמן האחזור של הפעלת הצומת לאורך זמן.
- התאמה בין שינויים בזמן האחזור של הפעלת הצומת לבין אירועים שהתרחשו לאחרונה, כמו עדכונים של אשכולות או עדכונים של מאגרי צמתים. אתם יכולים לבחור את האירועים ברשימה הערות בחלק העליון של מרכז הבקרה.
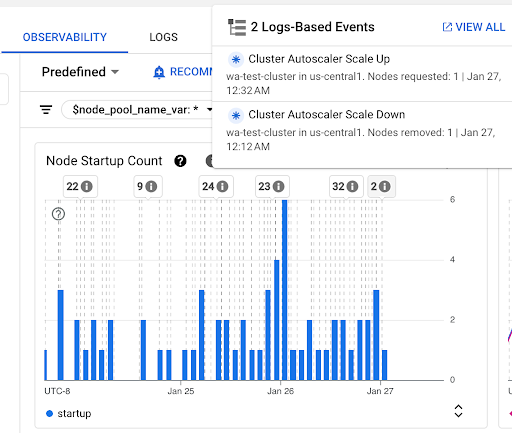
תרשים Node Startup Count: בתרשים הזה מוצג מספר הצמתים שהופעלו במרווחי הזמן שנבחרו. אפשר להשתמש בתרשים למטרות הבאות:
- הבנת גדלי הדגימות של הצמתים, שמשמשים לחישוב האחוזונים של חלוקת זמן האחזור של הפעלת הצומת במרווח זמן נתון.
- להבין את הסיבות להפעלת צמתים, כמו עדכונים של מאגר צמתים או אירועים של מידרוג אוטומטי באשכול. אתם יכולים לבחור את האירועים ברשימה Annotations בחלק העליון של מרכז הבקרה.
הצגת זמן האחזור של אתחול צמתים נפרדים
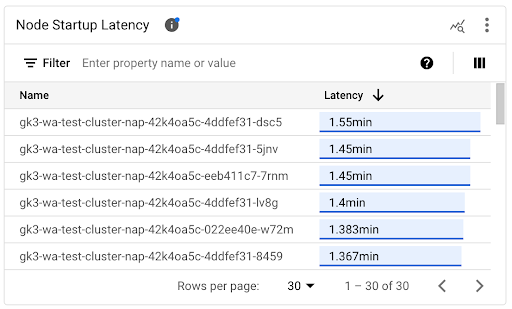
כשמשווים בין זמני האחזור של צמתים נפרדים, אפשר לבדוק את ההשפעה של הגדרות שונות של צמתים על זמן האחזור של הפעלת הצומת, ולזהות את ההגדרה האופטימלית בהתאם לדרישות שלכם. אפשר לראות את זמן האחזור של הפעלת צמתים ספציפיים בתרשים ציר הזמן Node Startup Latency וברשימה המשויכת.
אפשר להשתמש בתרשים ציר הזמן Node Startup Latency כדי ליצור קורלציה בין הפעלות של צמתים בודדים לבין אירועים מהזמן האחרון, כמו Cluster Updates או עדכוני מאגר צמתים. אתם יכולים לקבוע את הסיבות האפשריות לשינויים בזמן האחזור בהפעלה בהשוואה לצמתים אחרים. אפשר לבחור את האירועים ברשימה הערות בחלק העליון של לוח הבקרה.
ברשימה Node Startup Latency אפשר לזהות צמתים ספציפיים שההפעלה שלהם נמשכה הכי הרבה או הכי מעט זמן. אפשר למיין את הרשימה לפי העמודה Latency. כשמזהים צמתים עם זמן האחזור הכי גבוה של תהליך ההפעלה, אפשר לפתור בעיות שקשורות לירידה בביצועים של זמן האחזור על ידי שיוך של אירועי הפעלה של צמתים לאירועים אחרים מהזמן האחרון.
כדי לדעת מתי נוצר צומת מסוים, אפשר לבדוק את הערך של השדה protoPayload.metadata.creationTimestamp באירוע המתאים של יצירת צומת. כדי לראות את השדה protoPayload.metadata.creationTimestamp, מריצים את השאילתה הבאה ב-Logs Explorer:
   log_id("cloudaudit.googleapis.com/activity") AND
   protoPayload.methodName="io.k8s.core.v1.nodes.create" AND
   resource.labels.project_id=PROJECT_ID AND
   resource.labels.cluster_name=CLUSTER_NAME AND
   resource.labels.location=CLUSTER_LOCATION AND
   protoPayload.response.metadata.name=NODE_NAME
הצגת זמן האחזור של ההפעלה במאגר צמתים
אם למאגרי הצמתים יש הגדרות שונות, למשל כדי להריץ עומסי עבודה שונים, יכול להיות שתצטרכו לעקוב אחרי זמן האחזור של הפעלת הצמתים בנפרד לפי מאגרי צמתים. כשמשווים בין זמני האחזור של הפעלת הצמתים במאגרי הצמתים, אפשר לקבל תובנות לגבי האופן שבו הגדרת הצומת משפיעה על זמן האחזור של הפעלת הצומת, וכתוצאה מכך לבצע אופטימיזציה של זמן האחזור.
כברירת מחדל, בלוח הבקרה Node Startup Latency מוצגת ההתפלגות המצטברת של זמן הטעינה אחרי הפעלה וזמני הטעינה אחרי הפעלה של כל צומת בנפרד בכל מאגרי הצמתים באשכול. כדי לראות את זמן האחזור של הפעלת צומת עבור מאגר צמתים ספציפי, בוחרים את השם של מאגר הצמתים באמצעות המסנן $node_pool_name_var שנמצא בחלק העליון של לוח הבקרה.
המאמרים הבאים
- השוואה בין אסטרטגיות להפחתת זמן ההשהיה בהפעלה
- איך מאיצים את הפעלת האפליקציה באמצעות שיפור ביצועי המעבד (CPU) בזמן ההפעלה
- מידע נוסף על דרכים לצמצום זמן האחזור של הפעלה במצב התחלתי ב-GKE
- איך משתמשים בסטרימינג של קובצי אימג' כדי לצמצם את זמן האחזור של שליפת קובצי אימג'
- מידע ולמידה על ההיבטים הכלכליים המפתיעים של כוונון התאמה אופקית של קבוצות Pod לעומס
- מעקב אחרי עומסי העבודה באמצעות מעקב אוטומטי אחרי אפליקציות.