

Después de crear un clúster de Managed Service para Apache Spark, puedes ajustarlo ("escalarlo") aumentando o disminuyendo la cantidad de nodos trabajadores principales o secundarios (escalamiento horizontal) en el clúster. Puedes escalar un clúster de Managed Service para Apache Spark en cualquier momento, incluso cuando se ejecutan trabajos en el clúster. No puedes cambiar el tipo de máquina de un clúster existente (escalamiento vertical). Para escalar verticalmente, crea un clúster con un tipo de máquina compatible y, luego, migra los trabajos al clúster nuevo.
Puedes escalar un clúster de Managed Service para Apache Spark para lo siguiente:
- para aumentar la cantidad de trabajadores y hacer que un trabajo se ejecute más rápido.
- Para disminuir la cantidad de trabajadores y ahorrar dinero (consulta Retiro de servicio ordenado como una opción que se usa cuando se reduce el tamaño de un clúster a fin de evitar la pérdida de trabajo en progreso)
- para aumentar la cantidad de nodos y expandir el almacenamiento disponible del sistema de archivos distribuido de Hadoop (HDFS).
Debido a que los clústeres se pueden escalar más de una vez, es posible que quieras aumentar o disminuir el tamaño del clúster en un momento y, luego, disminuir o aumentar el tamaño más adelante.
Recomendaciones:
Quita trabajadores con precaución: Si quitas trabajadores de tu clúster, asegúrate de que el nuevo tamaño del clúster sea suficiente para controlar tu carga de trabajo. De lo contrario, es posible que tus trabajos tarden mucho tiempo en completarse o que dejen de responder.
Evita escalar los trabajadores principales: Los trabajadores principales ejecutan DataNodes de HDFS, mientras que los trabajadores secundarios son solo de procesamiento. Escalar los trabajadores principales conlleva riesgos. Por ejemplo, los NameNodes de HDFS pueden tener varias condiciones de carrera durante las operaciones de escalamiento que pueden provocar que HDFS se dañe y que la retirada se detenga de forma indefinida. Para obtener más información, consulta Evita escalar los trabajadores principales.
Usa el escalamiento
Existen tres formas de escalar tu clúster de Managed Service para Apache Spark:
- Usa la herramienta de línea de comandos de
gclouden gcloud CLI. - Edita la configuración del clúster en la consola deCloud de Confiance .
- Usa la API de REST.
Los trabajadores nuevos que se agreguen a un clúster usarán el mismo tipo de máquina que los trabajadores existentes. Por ejemplo, si un clúster se crea con trabajadores que usan el tipo de máquina n1-standard-8, los trabajadores nuevos también usarán el tipo de máquina n1-standard-8.
Puedes escalar la cantidad de trabajadores principales o secundarios (interrumpibles), o ambos. Por ejemplo, si solo escalas la cantidad de trabajadores interrumpibles, la cantidad de trabajadores principales permanece igual.
gcloud
Para escalar un clúster congcloud dataproc clusters update,
ejecuta el siguiente comando:
gcloud dataproc clusters update cluster-name \
    --region=region \
    [--num-workers and/or --num-secondary-workers]=new-number-of-workers
gcloud dataproc clusters update dataproc-1 \
    --region=region \
    --num-workers=5
...
Waiting on operation [operations/projects/project-id/operations/...].
Waiting for cluster update operation...done.
Updated [https://dataproc.googleapis.com/...].
clusterName: my-test-cluster
...
  masterDiskConfiguration:
    bootDiskSizeGb: 500
  masterName: dataproc-1-m
  numWorkers: 5
  ...
  workers:
  - my-test-cluster-w-0
  - my-test-cluster-w-1
  - my-test-cluster-w-2
  - my-test-cluster-w-3
  - my-test-cluster-w-4
...
API de REST
Consulta clusters.patch.
Ejemplo
PATCH /v1/projects/project-id/regions/us-central1/clusters/example-cluster?updateMask=config.worker_config.num_instances,config.secondary_worker_config.num_instances
{
  "config": {
    "workerConfig": {
      "numInstances": 4
    },
    "secondaryWorkerConfig": {
      "numInstances": 2
    }
  },
  "labels": null
}
Console
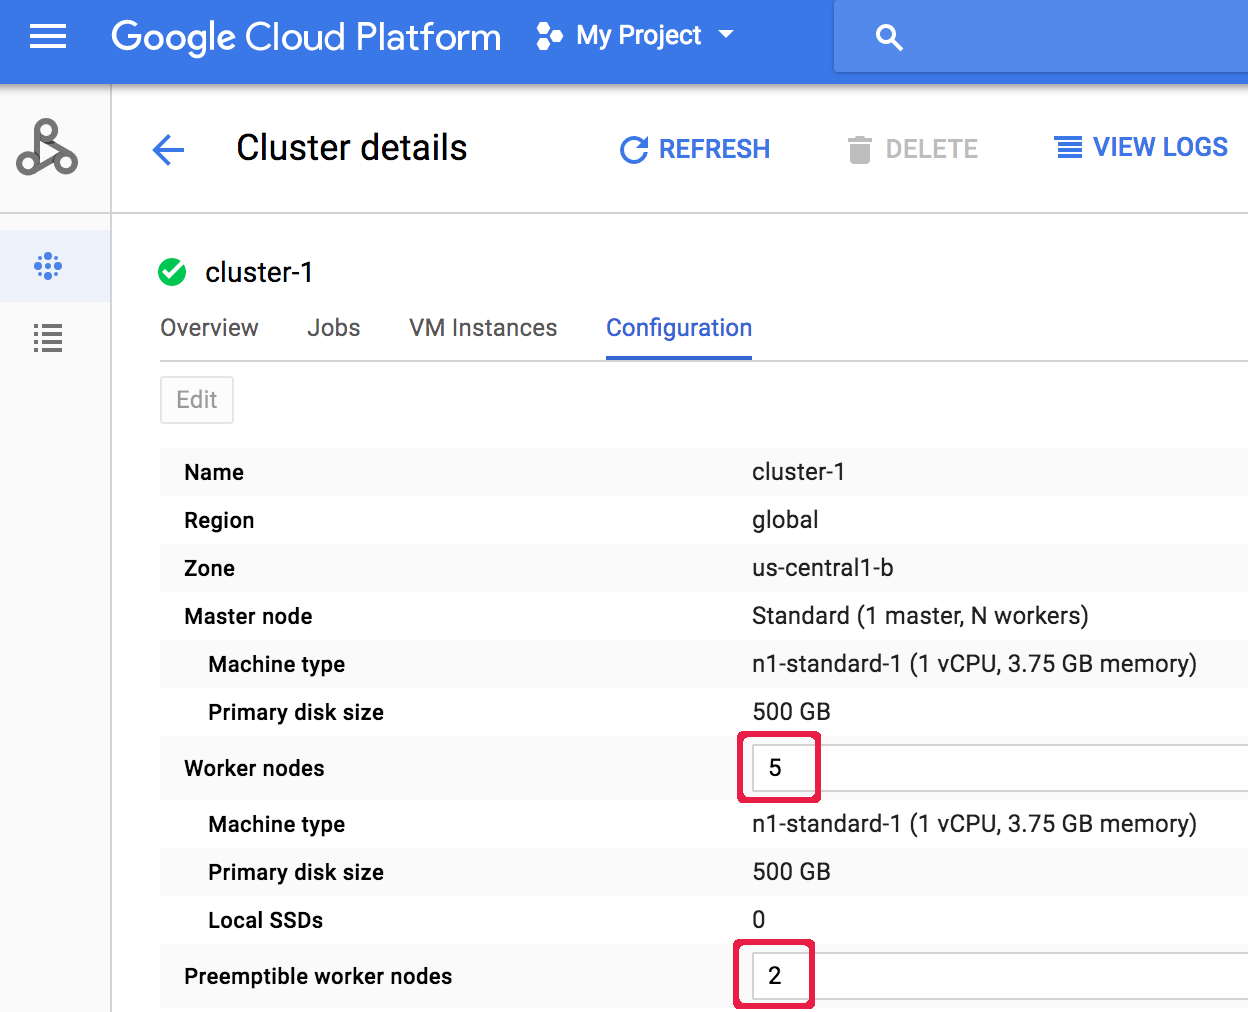
Después de crear un clúster, lo puedes escalar abriendo la página Detalles del clúster desde la página Clústeres de la consola deCloud de Confiance y, luego, haciendo clic en el botón Editar en la pestaña Configuración.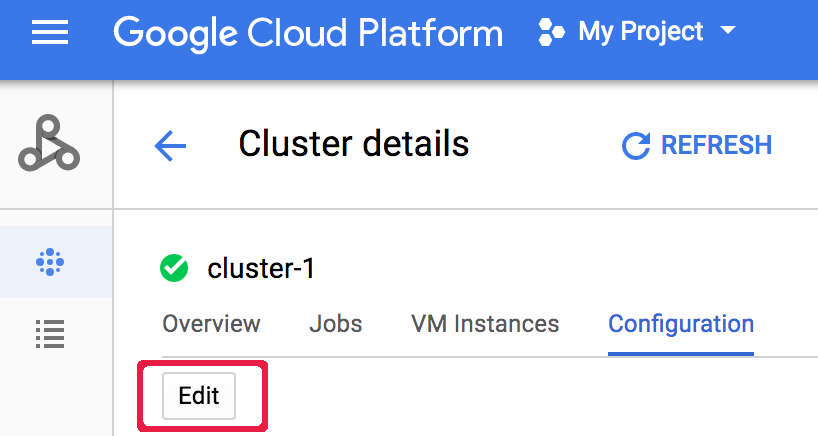 Ingresa un valor nuevo para la cantidad de Nodos trabajadores o
Nodos trabajadores interrumpibles (se actualizaron a "5" y "2", respectivamente,
en la siguiente captura de pantalla).
 Haz clic en Guardar para actualizar el clúster.
Cómo Managed Service para Apache Spark selecciona los nodos del clúster que se quitarán
En los clústeres creados con las versiones con imágenes 1.5.83+, 2.0.57+, y 2.1.5+, cuando se reduce la escala verticalmente de un clúster, Managed Service para Apache Spark intenta minimizar el impacto de la eliminación de nodos en las aplicaciones de YARN en ejecución. Para ello, primero quita los nodos inactivos, en mal estado y sin actividad, y, luego, quita los nodos con la menor cantidad de maestros de aplicaciones de YARN y contenedores en ejecución.
Retiro de servicio ordenado
Cuando realizas un escalamiento descendente de un clúster, el trabajo en progreso puede terminar antes de completarse. Si usas Managed Service para Apache Spark v 1.2 o posterior, puedes usar el retiro de servicio ordenado, que incorpora el retiro de servicio ordenado de nodos de YARN para finalizar el trabajo en curso en un trabajador antes de que se quite del clúster de Managed Service para Apache Spark de Cloud.
Retiro de servicio ordenado y trabajadores secundarios
El grupo de trabajadores interrumpibles (secundarios) continúa con el aprovisionamiento o el borrado de trabajadores a fin de alcanzar el tamaño esperado incluso después de que una operación de escalamiento de clúster se marcó como completada. Si intentas retirar de servicio de forma ordenada un trabajador secundario
y recibes un mensaje de error similar al siguiente:
"Secondary
worker group cannot be modified outside of Managed Service for Apache Spark. Si la creación o actualización de este clúster es reciente, espera unos minutos antes de realizar un retiro de servicio ordenado a fin de permitir que todas las instancias secundarias se unan o abandonen el clúster.
Tamaño del grupo de trabajadores secundarios esperado: x. Tamaño real: y”,
espera unos minutos y, luego, repite la solicitud de retiro de servicio ordenado.
Usa el retiro de servicio ordenado
El retiro de servicio ordenado de Managed Service para Apache Spark incorpora el retiro de servicio ordenado de nodos de YARN para finalizar el trabajo en curso en un trabajador antes de que se quite del clúster de Managed Service para Apache Spark de Cloud. Por configuración predeterminada, el retiro de servicio ordenado está inhabilitado. Lo inhabilitas mediante la configuración de un valor de tiempo de espera cuando actualizas tu clúster con el fin de quitar uno o más trabajadores del clúster.
gcloud
Cuando actualices un clúster para quitar uno o más trabajadores, usa el comando gcloud dataproc clusters update con la marca--graceful-decommission-timeout. Los valores del tiempo de espera (string) pueden ser un valor de “0s” (el predeterminado; retiro de servicio a la fuerza no ordenado) o una duración positiva relacionada con la hora actual (por ejemplo, “3s”).
La duración máxima es de 1 día.
gcloud dataproc clusters update cluster-name \
    --region=region \
    --graceful-decommission-timeout="timeout-value" \
    [--num-workers and/or --num-secondary-workers]=decreased-number-of-workers \
    ... other args ...
API de REST
Consulta clusters.patch.gracefulDecommissionTimeout. Los valores del tiempo de espera (string) pueden ser un valor de “0” (el predeterminado; retiro de servicio a la fuerza no ordenado) o una duración en segundos (por ejemplo, “3s”). La duración máxima es de 1 día.Console
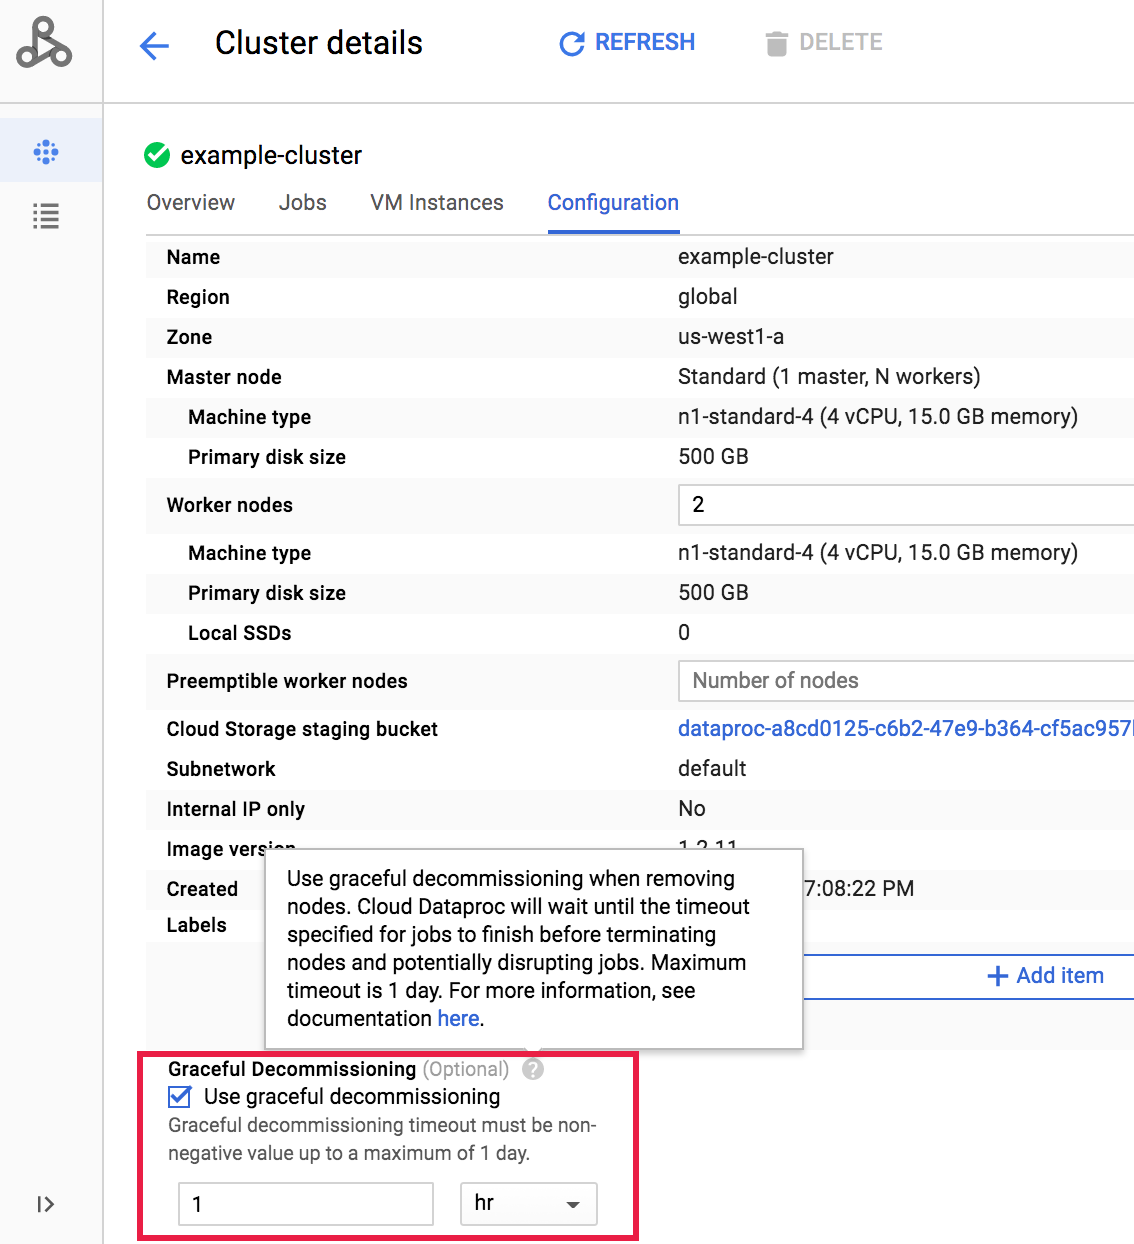
Después de crear un clúster, puedes seleccionar el retiro de servicio ordenado de un clúster si abres la página Detalles del clúster desde la página de la consola deCloud de Confiance Clústeres y, luego, haces clic en el botón Editar en la pestaña Configuración.
En la sección Retiro de servicio ordenado, selecciona
Usar retiro de servicio ordenado y, luego, un valor de tiempo de espera.
 Haz clic en Guardar para actualizar el clúster.
Cancela una operación de reducción de retiro de servicio ordenado
En los clústeres de Managed Service para Apache Spark creados con las versiones de imagen
2.0.57+
o 2.1.5+,
puedes ejecutar el comando gcloud dataproc operations cancel
o emitir una solicitud operations.cancel
a la API de Managed Service para Apache Spark
para cancelar una operación de reducción de retiro de servicio ordenado.
Cuando cancelas una operación de reducción de retiro de servicio ordenado, sucede lo siguiente:
Los trabajadores en estado
DECOMMISSIONINGse vuelven a poner en servicio y pasan a serACTIVEcuando se completa la cancelación de la operación.Si la operación de reducción de escala incluye actualizaciones de etiquetas, es posible que estas no se apliquen.
Para verificar el estado de la solicitud de cancelación, puedes
ejecutar el comando gcloud dataproc operations describe
o emitir una solicitud a la API de Managed Service para Apache Spark
operations.get. Si la operación de cancelación se realiza de forma correcta, el estado operativo de la operación interna se marca como CANCELLED.