

כשאתם שולחים משימה ב-Managed Service for Apache Spark, המערכת אוספת באופן אוטומטי את הפלט של המשימה ומאפשרת לכם לגשת אליו. כך אפשר לבדוק במהירות את הפלט של המשימה בלי לשמור על החיבור לאשכול בזמן שהמשימות פועלות, ובלי לעבור על קובצי יומן מורכבים.
יומני Spark
יש שני סוגים של יומני Spark: יומני מנהלי התקנים של Spark ויומני מנהלי משימות של Spark.
יומני מנהלי ההתקנים של Spark מכילים פלט של משימות. יומני מנהלי ההפעלה של Spark מכילים פלט של קובצי הפעלה או של מרכז האפליקציות של משימות, כמו ההודעה spark-submit "Submitted application ... ", והם יכולים לעזור בניפוי באגים של כשלים במשימות.
מנהל ההתקן של Managed Service for Apache Spark, שהוא שונה ממנהל ההתקן של Spark, הוא מרכז אפליקציות להרבה סוגי עבודה. כשמפעילים משימות Spark, הוא פועל כמעטפת של קובץ ההפעלה spark-submit, שמפעיל את מנהל ההתקן של Spark. מנהל ההתקן של Spark מריץ את המשימה באשכול של Managed Service for Apache Spark במצב client או cluster:
מצב
client: מנהל ההתקן של Spark מריץ את המשימה בתהליךspark-submit, והיומנים של Spark נשלחים למנהל ההתקן של המשימה ב-Managed Service for Apache Spark.מצב
cluster: מנהל ההתקן של Spark מריץ את המשימה בקונטיינר של YARN. יומני מנהל ההתקן של Spark לא זמינים למנהל ההתקן של המשימה ב-Managed Service for Apache Spark.
סקירה כללית על Managed Service for Apache Spark ועל מאפייני משימות Spark
| מאפיין (property) | ערך | ברירת מחדל | תיאור |
|---|---|---|---|
dataproc:dataproc.logging.stackdriver.job.driver.enable |
true or false | FALSE | צריך להגדיר את זה בזמן יצירת האשכול. כשהערך הוא true, הפלט של מנהל ההתקן של המשימה נמצא ב-Logging ומשויך למשאב המשימה. כשהערך הוא false, הפלט של מנהל ההתקן של המשימה לא נמצא ב-Logging.הערה: כדי להפעיל את יומני מנהלי ההתקנים של המשימות ב-Logging, צריך גם להגדיר את מאפייני האשכול הבאים, שמוגדרים כברירת מחדל כשיוצרים אשכול: dataproc:dataproc.logging.stackdriver.enable=true ו-dataproc:jobs.file-backed-output.enable=true
|
dataproc:dataproc.logging.stackdriver.job.yarn.container.enable |
true or false | FALSE | צריך להגדיר את זה בזמן יצירת האשכול.
כשהערך הוא true, יומני מאגר ה-YARN של המשימה משויכים למשאב המשימה. כשהערך הוא false, יומני מאגר ה-YARN של המשימה משויכים למשאב האשכול. |
spark:spark.submit.deployMode |
לקוח או אשכול | לקוח | שולטת במצב client או cluster של Spark. |
משימות Spark שנשלחו באמצעות Managed Service for Apache Spark jobs API
בטבלאות שבקטע הזה מפורטות ההשפעות של הגדרות שונות של מאפיינים על היעד של פלט מנהל ההתקן של משימות Managed Service for Apache Spark, כשמגישים משימות דרך ה-API של Managed Service for Apache Spark jobs, כולל הגשת משימות דרך מסוףCloud de Confiance , ה-CLI של gcloud וספריות הלקוח ב-Cloud.
אפשר להגדיר את המאפיינים של Managed Service for Apache Spark ו-Spark שמופיעים ברשימה באמצעות הדגל --properties כשיוצרים אשכול, והם יחולו על כל משימות Spark שמופעלות באשכול. אפשר גם להגדיר את המאפיינים של Spark באמצעות הדגל --properties (בלי הקידומת "spark:") כששולחים משימה ל-API של Managed Service for Apache Spark jobs, והם יחולו רק על המשימה.
פלט של מנהל התקן של משימות ב-Managed Service for Apache Spark
בטבלאות הבאות מפורטות ההשפעות של הגדרות שונות של מאפיינים על היעד של פלט מנהל ההתקן של משימות Managed Service for Apache Spark.
dataproc: |
תשובה |
|---|---|
| false (ברירת מחדל) |
|
| TRUE |
|
יומני מנהלי התקנים של Spark
בטבלאות הבאות מפורטת ההשפעה של הגדרות שונות של מאפיינים על היעד של יומני מנהלי ההתקנים של Spark.
spark: |
dataproc: |
dataproc: |
פלט הדרייבר |
|---|---|---|---|
| לקוח | false (ברירת מחדל) | true or false |
|
| לקוח | TRUE | true or false |
|
| אשכול | false (ברירת מחדל) | FALSE |
|
| אשכול | TRUE | TRUE |
|
יומני Spark executor
בטבלאות הבאות מפורטת ההשפעה של הגדרות שונות של מאפיינים על היעד של יומני ה-executor של Spark.
dataproc: |
יומן של Executor |
|---|---|
| false (ברירת מחדל) | ב-Logging: yarn-userlogs במשאב האשכול |
| TRUE | בכלי הרישום ביומן dataproc.job.yarn.container, מתחת למשאב המשימה |
משימות Spark שנשלחו בלי להשתמש ב-API של Managed Service for Apache Spark jobs
בקטע הזה מפורטת ההשפעה של הגדרות שונות של מאפיינים על היעד של יומני המשימות של Spark, כשמגישים משימות בלי להשתמש ב-API של Managed Service for Apache Spark jobs. לדוגמה, כשמגישים משימה ישירות בצומת של אשכול באמצעות spark-submit או כשמשתמשים ב-notebook של Jupyter או Zeppelin. למשימות האלה אין מזהי משימות או מנהלי התקנים של Managed Service for Apache Spark.
יומני מנהלי התקנים של Spark
בטבלאות הבאות מפורטות ההשפעות של הגדרות שונות של מאפיינים על היעד של יומני מנהלי ההתקנים של Spark, במשימות שלא נשלחו דרך ה-API של Managed Service for Apache Spark jobs.
spark: |
פלט הדרייבר |
|---|---|
| לקוח |
|
| אשכול |
|
יומני Spark executor
כשמשימות Spark לא נשלחות דרך ה-API של Managed Service for Apache Spark jobs, יומני ה-executor נמצאים ב-Logging yarn-userlogs במשאב האשכול.
הצגת הפלט של המשימה
אפשר לגשת לפלט של משימות Managed Service for Apache Spark במסוף Cloud de Confiance , ב-CLI של gcloud, ב-Cloud Storage או ב-Logging.
המסוף
כדי לראות את הפלט של המשימה, נכנסים לקטע Jobs ב-Managed Service for Apache Spark בפרויקט ולוחצים על מזהה משימה.
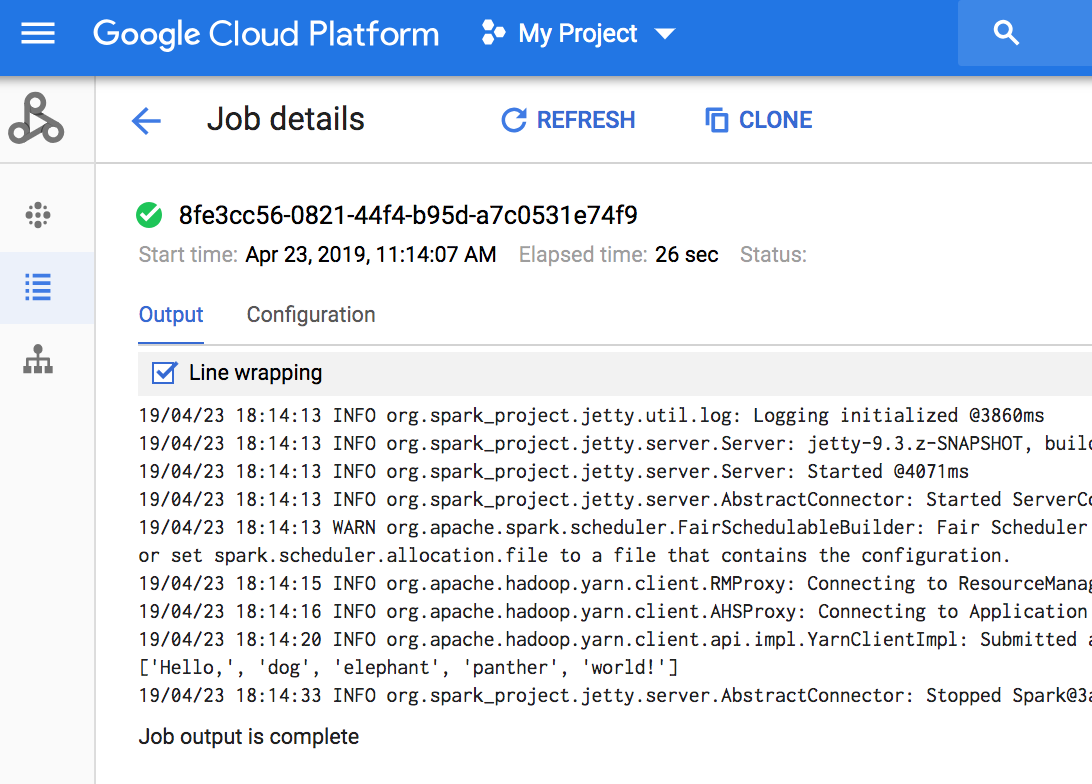
אם המשימה פועלת, הפלט של המשימה מתרענן מדי פעם עם תוכן חדש.
פקודת gcloud
כששולחים משימה באמצעות הפקודה gcloud dataproc jobs submit, הפלט של המשימה מוצג במסוף. אתם יכולים "להצטרף מחדש" לפלט בשלב מאוחר יותר, במחשב אחר או בחלון חדש, על ידי העברת מזהה המשימה לפקודה gcloud dataproc jobs wait. מזהה המשימה הוא GUID, למשל 5c1754a5-34f7-4553-b667-8a1199cb9cab. נראה דוגמה.
gcloud dataproc jobs wait 5c1754a5-34f7-4553-b667-8a1199cb9cab \
    --project my-project-id --region my-cluster-region
Waiting for job output...
... INFO gcs.GoogleHadoopFileSystemBase: GHFS version: 1.4.2-hadoop2
... 16:47:45 INFO client.RMProxy: Connecting to ResourceManager at my-test-cluster-m/
...
Cloud Storage
הפלט של המשימה נשמר ב-Cloud Storage, בקטגוריית ה-Staging או בקטגוריה שציינתם כשיצרתם את האשכול. קישור לפלט של המשימה ב-Cloud Storage מופיע בשדה Job.driverOutputResourceUri שמוחזר על ידי:
- בקשת API מסוג jobs.get.
- פקודת gcloud dataproc jobs describe job-id.
$ gcloud dataproc jobs describe spark-pi
...
driverOutputResourceUri: gs://dataproc-nnn/jobs/spark-pi/driveroutput
...