

כשאתם משתמשים ב-Managed Service for Apache Spark כדי ליצור אשכולות ולהריץ בהם משימות, השירות מגדיר בפרויקט את התפקידים וההרשאות הנדרשים של Managed Service for Apache Spark כדי לגשת למשאבי Cloud de Confiance by S3NS שדרושים לביצוע המשימות האלה ולהשתמש בהם. עם זאת, אם אתם עובדים בכמה פרויקטים, למשל כדי לגשת לנתונים בפרויקט אחר, תצטרכו להגדיר את התפקידים וההרשאות הנדרשים כדי לגשת למשאבים בפרויקטים השונים.
כדי לעזור לכם לעבוד בהצלחה בכמה פרויקטים, במאמר הזה מפורטים חשבונות המשתמשים השונים שמשתמשים ב-Managed Service for Apache Spark, והתפקידים שמכילים את ההרשאות הנדרשות לחשבונות המשתמשים האלה כדי לגשת למשאבי Cloud de Confiance ולהשתמש בהם.
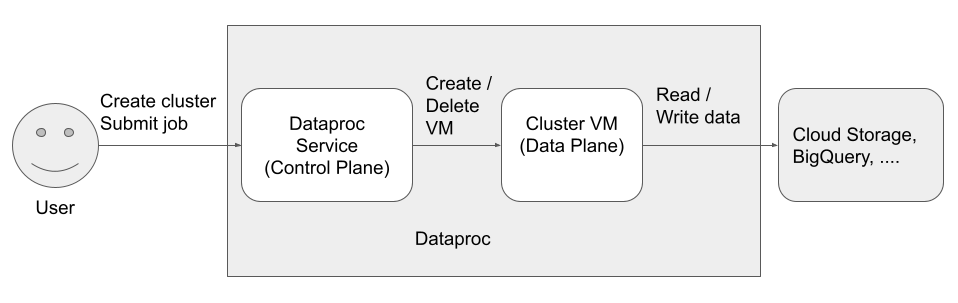
יש שלושה חשבונות משתמשים (זהויות) שניגשים ל-Managed Service for Apache Spark ומשתמשים בו:
- זהות המשתמש
- זהות במישור הבקרה
זהות במישור הנתונים
משתמש ב-Dataproc API (זהות המשתמש)
לדוגמה: username@example.com
זה המשתמש ששולח קריאות ל-Managed Service for Apache Spark כדי ליצור אשכולות, לשלוח משימות ולשלוח בקשות אחרות לשירות. המשתמש הוא בדרך כלל אדם פרטי, אבל הוא יכול להיות גם חשבון שירות אם Managed Service for Apache Spark מופעל באמצעות לקוח API או משירות אחר שלCloud de Confiance by S3NS , כמו Compute Engine, פונקציות Cloud Run או Managed Service for Apache Airflow.
תפקידים קשורים
הערות
- משימות שנשלחות באמצעות Dataproc API פועלות בתור
rootב-Linux. אשכולות של Managed Service for Apache Spark יורשים את המטא-נתונים של SSH ב-Compute Engine ברמת הפרויקט, אלא אם חוסמים אותם באופן מפורש על ידי הגדרת
--metadata=block-project-ssh-keys=trueכשיוצרים את האשכול (ראו מטא-נתונים של אשכול).ספריות משתמשים ב-HDFS נוצרות לכל משתמש SSH ברמת הפרויקט. הספריות האלה ב-HDFS נוצרות בזמן פריסת האשכול, ומשתמש SSH חדש (לאחר הפריסה) לא מקבל ספריית HDFS באשכולות קיימים.
סוכן השירות של Managed Service for Apache Spark (זהות של מישור הבקרה)
לדוגמה: service-project-number@dataproc-accounts.s3ns-system.iam.gserviceaccount.com
חשבון השירות של סוכן השירות של Managed Service for Apache Spark משמש לביצוע מגוון רחב של פעולות מערכת במשאבים שנמצאים בפרויקט שבו נוצר אשכול Managed Service for Apache Spark, כולל:
- יצירת משאבים של Compute Engine, כולל מכונות וירטואליות, קבוצות של מכונות ותבניות של הגדרות מכונה
- פעולות
getו-listכדי לאשר את הגדרת המשאבים, כמו קובצי אימג', חומות אש, פעולות אתחול של Managed Service for Apache Spark וקטגוריות של Cloud Storage - יצירה אוטומטית של קטגוריות זמניות וקטגוריות של שלבי ביניים ב-Managed Service for Apache Spark, אם המשתמש לא ציין אותן.
- כתיבת המטא-נתונים של הגדרות האשכול בקטגוריית ה-Staging
- גישה לרשתות VPC בפרויקט מארח
תפקידים קשורים
חשבון שירות של מכונה וירטואלית ב-Managed Service for Apache Spark (זהות של מישור הנתונים)
לדוגמה: project-number-compute@developer.s3ns-system.iam.gserviceaccount.com
קוד האפליקציה פועל כחשבון השירות של המכונה הווירטואלית במכונות הווירטואליות של Managed Service for Apache Spark. המשימות של המשתמשים מקבלות את התפקידים (עם ההרשאות שמשויכות אליהם) של חשבון השירות הזה.
חשבון השירות של המכונה הווירטואלית מבצע את הפעולות הבאות:
- מתקשר עם מישור הבקרה של Managed Service for Apache Spark.
- קריאה וכתיבה של נתונים מקטגוריות זמניות וקטגוריות של שלבי ביניים ב-Managed Service for Apache Spark ואליהן.
- בהתאם לצורך של המשימות ב-Managed Service for Apache Spark, קורא וכותב נתונים מ-Cloud Storage, מ-BigQuery, מ-Cloud Logging וממשאבים אחרים של Cloud de Confiance by S3NS , ואליהם.
תפקידים קשורים