

如要將工作提交至現有的 Managed Service for Apache Spark 叢集,您可以使用 jobs.submit API HTTP 或程式輔助要求、在本機終端機視窗或 Cloud Shell 使用 Google Cloud CLI gcloud 指令列工具,或是在本機瀏覽器中開啟 Cloud de Confiance 控制台。您也可以透過 SSH 連線至叢集中的主要執行個體,然後直接從執行個體執行工作,不使用 Managed Service for Apache Spark。
工作並行:建立叢集時,您可以使用 dataproc:dataproc.scheduler.max-concurrent-jobs 叢集屬性,設定並行 Managed Service for Apache Spark 工作數量上限。如果未設定這個屬性值,並行工作的上限會計算為 max((masterMemoryMb - 3584) / masterMemoryMbPerJob, 5)。masterMemoryMb 取決於主要 VM 的機型。masterMemoryMbPerJob 預設為 1024,但您可在建立叢集時,使用 dataproc:dataproc.scheduler.driver-size-mb 叢集屬性設定。
如何提交工作
Classpath 隔離和自訂 JAR:請勿將自訂「fat JAR」或套件 JAR (例如 Apache Iceberg 執行階段或 Cloud de Confiance by S3NS 套件) 直接複製到叢集系統目錄,例如 /usr/lib/spark/jars/。將自訂 JAR 放在系統目錄中,會導致 Managed Service for Apache Spark 代理程式的類別路徑受到傳遞依附元件 (例如 Guava 或 Hadoop 程式庫) 污染,與代理程式的內建程式庫發生衝突。這項衝突可能會導致類別解析錯誤 (例如 ClassNotFoundException 或 NoClassDefFoundError),在執行取消工作等工作管理作業時,造成代理程式停止運作,並使 YARN 應用程式孤立。
請改用下列其中一種支援的方法:
- 工作專屬依附元件:提交工作時,請使用 Google Cloud CLI 中的
--jars旗標、 Cloud de Confiance 控制台中的「Jar files」(Jar 檔案) 欄位,或 API 中的jarFileUris欄位,指定 JAR 的 Cloud Storage 路徑。Spark 會將依附元件發布至工作的驅動程式和執行器,不會影響代理程式的 classpath。 - 叢集層級依附元件:建立叢集時,請使用
spark:spark.jars叢集屬性指定依附元件:--properties="spark:spark.jars=gs://YOUR_BUCKET/jar-1.jar,gs://YOUR_BUCKET/jar-2.jar"
/etc/spark/conf/spark-defaults.conf,自動將依附元件發布至所有工作的 Spark 驅動程式和執行器類別路徑,同時將節點本機 Managed Service for Apache Spark 代理程式完全隔離。
控制台
在瀏覽器中開啟 Cloud de Confiance 控制台,然後前往 Managed Service for Apache Spark 的「Submit a job」(提交工作) 頁面。
Spark 工作範例
如要提交範例 Spark 工作,請按照下列指示填寫「Submit a job」(提交工作) 頁面中的欄位:
- 在「選取工作的運算類型」下方,選取「Spark on Compute Engine」。
- 在「Cluster job details」(叢集工作詳細資料) 部分,指定「Job ID」(工作 ID) (或接受預設 ID),然後從叢集清單中選取「Cluster」(叢集)。
- 在「Files and artifacts」(檔案和構件) 部分:
- 將「Job type」(工作類型) 設為「Spark (Scala / Java)」(
Spark)。 - 在「Driver configuration」(驅動程式設定) 下方,選取「Main class」(主要類別),並將「Main class」(主要類別) 設為
org.apache.spark.examples.SparkPi。 - 將「Arguments」(引數) 設為單一引數
1000。 - 將
file:///usr/lib/spark/examples/jars/spark-examples.jar新增至「Jar files」(Jar 檔案) (或 APIjarFileUris欄位):file:///表示 Hadoop LocalFileSystem 配置。Managed Service for Apache Spark 建立叢集時,會在叢集的主要節點上安裝/usr/lib/spark/examples/jars/spark-examples.jar。這個路徑僅適用於 Managed Service for Apache Spark 提供的預先安裝範例。請勿將自訂 JAR 複製到系統目錄 (請參閱「如何提交工作」中的注意事項)。- 或者,您也可以指定 Cloud Storage 路徑 (
gs://your-bucket/your-jarfile.jar) 或 Hadoop 分散式檔案系統路徑 (hdfs://path-to-jar.jar),指向其中一個 JAR。(如果您是透過 API 提交工作,請在jarFileUris欄位中指定這個路徑)。
- 將「Job type」(工作類型) 設為「Spark (Scala / Java)」(
按一下 [Submit] (提交) 以啟動工作。工作啟動後,即會加入「Jobs」[工作] 清單中。
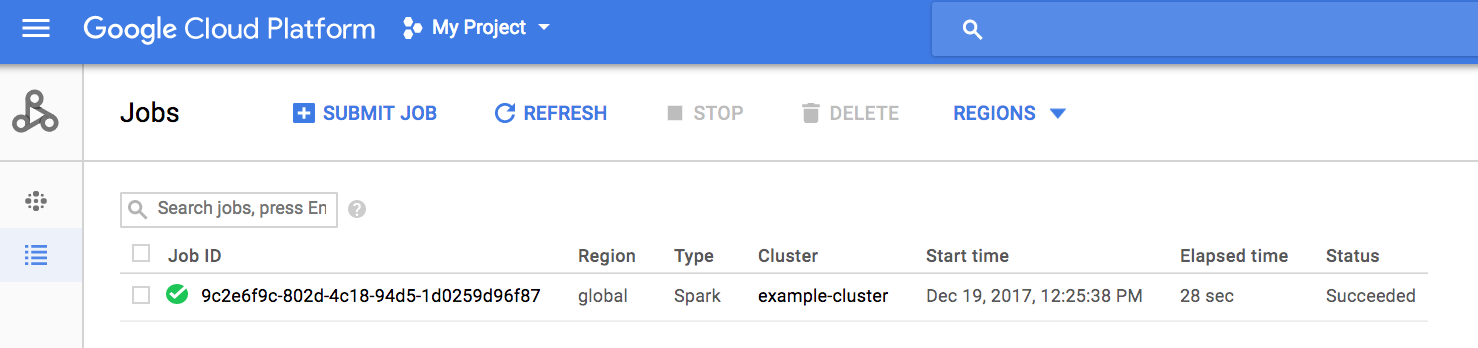
點選工作 ID 開啟「工作」頁面,即可查看工作的驅動程式輸出內容。由於這項工作會產生長度超過瀏覽器視窗寬度的輸出內容,因此您可以勾選「Line wrapping」(自動換行) 方塊,將所有輸出文字顯示在檢視畫面中,以便查看 pi 的計算結果。
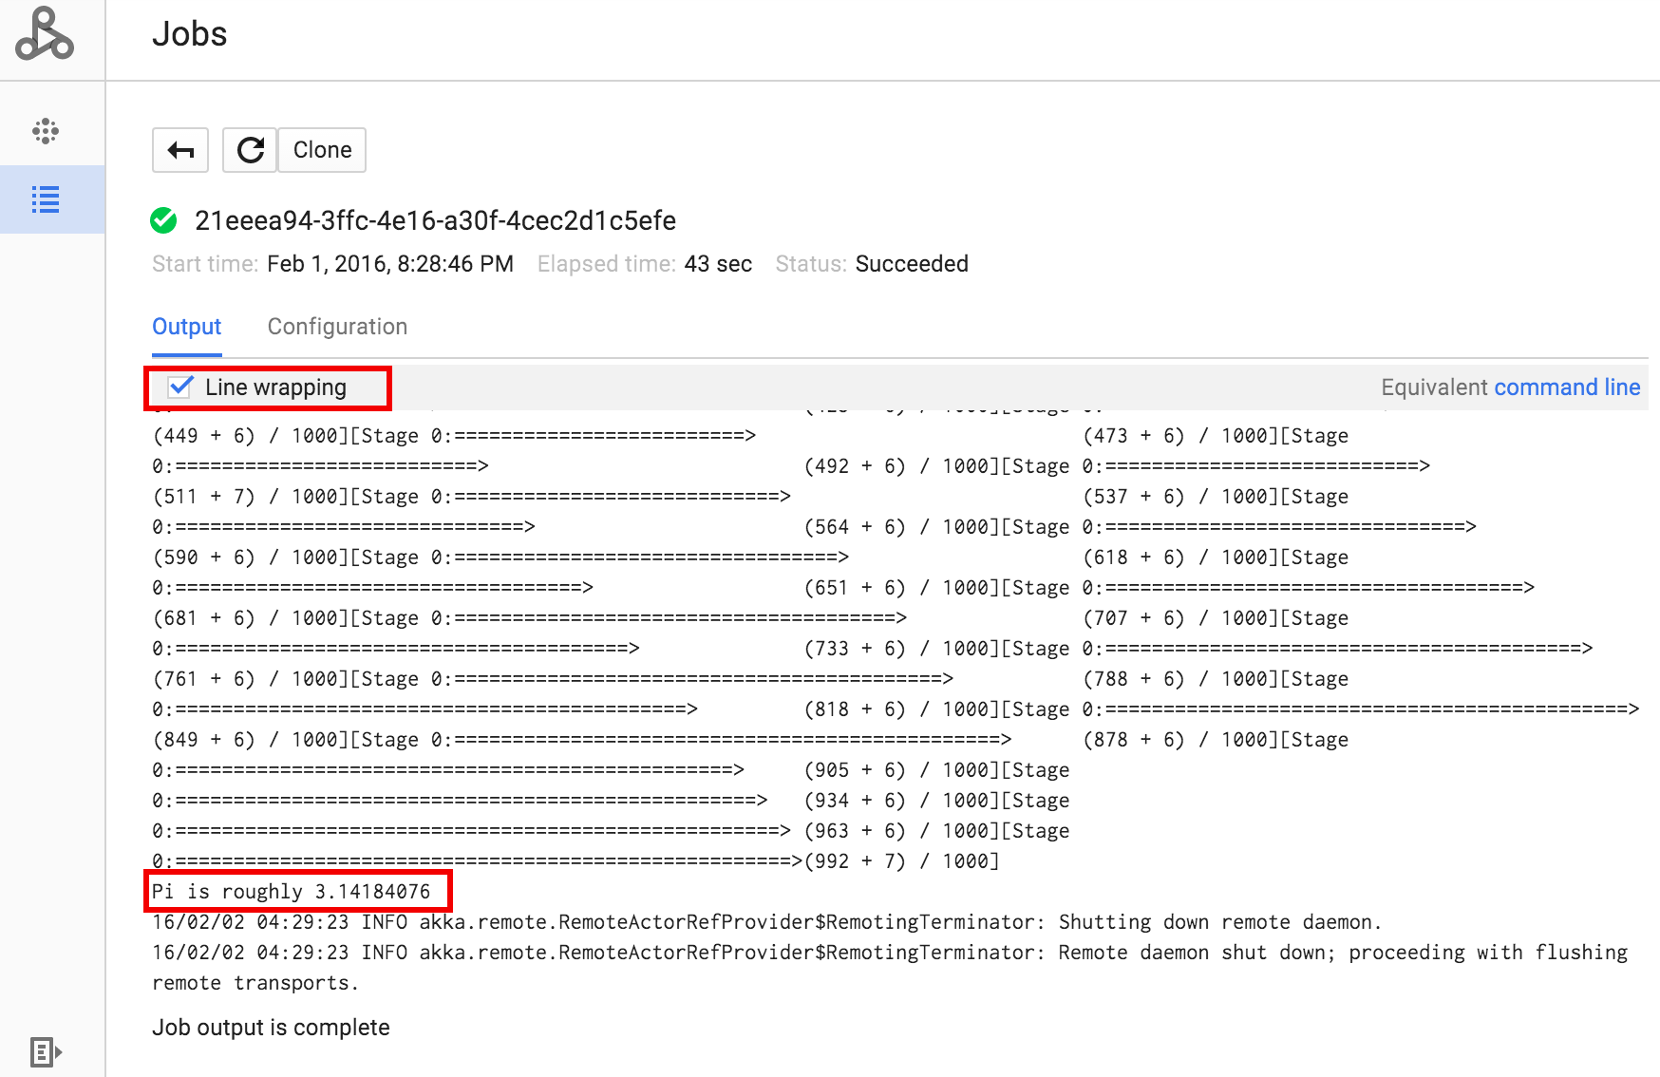
您可以使用下列 gcloud dataproc jobs wait 指令,透過指令列查看工作的驅動程式輸出內容 (詳情請參閱「查看工作輸出內容 - GCLOUD 指令」)。複製並貼上專案 ID 做為 --project 旗標的值,並將工作 ID (顯示在「工作」清單中) 做為最終引數。
gcloud dataproc jobs wait job-id \
    --project=project-id \
    --region=region
以下是範例 SparkPi 工作的驅動程式輸出內容片段:
...
2015-06-25 23:27:23,810 INFO [dag-scheduler-event-loop]
scheduler.DAGScheduler (Logging.scala:logInfo(59)) - Stage 0 (reduce at
SparkPi.scala:35) finished in 21.169 s

2015-06-25 23:27:23,810 INFO [task-result-getter-3] cluster.YarnScheduler
(Logging.scala:logInfo(59)) - Removed TaskSet 0.0, whose tasks have all
completed, from pool

2015-06-25 23:27:23,819 INFO [main] scheduler.DAGScheduler
(Logging.scala:logInfo(59)) - Job 0 finished: reduce at SparkPi.scala:35,
took 21.674931 s

Pi is roughly 3.14189648
...
Job [c556b47a-4b46-4a94-9ba2-2dcee31167b2] finished successfully.

driverOutputUri:
gs://sample-staging-bucket/google-cloud-dataproc-metainfo/cfeaa033-749e-48b9-...
...
gcloud
如要將工作提交至 Managed Service for Apache Spark 叢集,請在本機的終端機視窗或 Cloud Shell 中執行 gcloud CLI gcloud dataproc jobs submit 指令。
gcloud dataproc jobs submit job-command \
    --cluster=cluster-name \
    --region=region \
    other dataproc-flags \
    -- job-args
- 列出 Cloud Storage 中可公開存取的
hello-world.py。gcloud storage cat gs://dataproc-examples/pyspark/hello-world/hello-world.py
#!/usr/bin/python
import pyspark
sc = pyspark.SparkContext()
rdd = sc.parallelize(['Hello,', 'world!'])
words = sorted(rdd.collect())
print(words)
- 將 PySpark 工作提交至 Managed Service for Apache Spark。
gcloud dataproc jobs submit pyspark \
    gs://dataproc-examples/pyspark/hello-world/hello-world.py \
    --cluster=cluster-name  \
    --region=region
Waiting for job output...
…
['Hello,', 'world!']
Job finished successfully.
- 執行預先安裝在 Managed Service for Apache Spark 叢集主要節點上的 SparkPi 範例。(
file:///usr/lib/spark/examples/jars/spark-examples.jar路徑僅適用於預先安裝的範例;如需自訂 JAR 依附元件,請參閱「如何提交工作」中的注意事項)。gcloud dataproc jobs submit spark \ --cluster=cluster-name \ --region=region \ --class=org.apache.spark.examples.SparkPi \ --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \ -- 1000
Job [54825071-ae28-4c5b-85a5-58fae6a597d6] submitted.
Waiting for job output…
…
Pi is roughly 3.14177148
…
Job finished successfully.
…
REST
本節說明如何使用 Managed Service for Apache Spark jobs.submit API 提交 Spark 工作,計算 pi 的近似值。
使用任何要求資料之前,請先修改下列項目的值:
- project-id: Cloud de Confiance by S3NS 專案 ID
- region:叢集區域
- clusterName:叢集名稱
HTTP 方法和網址:
POST https://dataproc.googleapis.com/v1/projects/project-id/regions/region/jobs:submit
JSON 要求主體:
{
  "job": {
    "placement": {
      "clusterName": "cluster-name"
    },
    "sparkJob": {
      "args": [
        "1000"
      ],
      "mainClass": "org.apache.spark.examples.SparkPi",
      "jarFileUris": [
        "file:///usr/lib/spark/examples/jars/spark-examples.jar"
      ]
    }
  }
}
請展開以下其中一個選項,以傳送要求:
您應該會收到如下的 JSON 回覆:
{
  "reference": {
    "projectId": "project-id",
    "jobId": "job-id"
  },
  "placement": {
    "clusterName": "cluster-name",
    "clusterUuid": "cluster-Uuid"
  },
  "sparkJob": {
    "mainClass": "org.apache.spark.examples.SparkPi",
    "args": [
      "1000"
    ],
    "jarFileUris": [
      "file:///usr/lib/spark/examples/jars/spark-examples.jar"
    ]
  },
  "status": {
    "state": "PENDING",
    "stateStartTime": "2020-10-07T20:16:21.759Z"
  },
  "jobUuid": "job-Uuid"
}
Java
- 安裝用戶端程式庫
- 設定應用程式預設憑證
- 執行程式碼
Python
- 安裝用戶端程式庫
- 設定應用程式預設憑證
- 執行程式碼
Go
- 安裝用戶端程式庫
- 設定應用程式預設憑證
- 執行程式碼
Node.js
- 安裝用戶端程式庫
- 設定應用程式預設憑證
- 執行程式碼
直接在叢集中提交工作
如要直接在叢集上執行工作,而不使用 Managed Service for Apache Spark,請透過 SSH 連線至叢集的主節點,然後在主節點上執行工作。
建立與 VM 主要執行個體的 SSH 連線後,請在叢集主要節點的終端機視窗中執行指令,以便:
- 開啟 Spark 殼層。
- 執行 Spark 工作,計算公開 Cloud Storage 檔案中 (七行) Python「hello-world」檔案的行數。
結束殼層。
user@cluster-name-m:~$ spark-shell
...
scala> sc.textFile("gs://dataproc-examples"
+ "/pyspark/hello-world/hello-world.py").count
...
res0: Long = 7
scala> :quit
在 Managed Service for Apache Spark 執行 Bash 工作
您可能想將 Bash 指令碼做為 Managed Service for Apache Spark 工作執行,原因可能是您使用的引擎不支援做為頂層 Managed Service for Apache Spark 工作類型,或您需要先執行額外設定或計算引數,才能使用指令碼中的 hadoop 或 spark-submit 啟動工作。
Pig 範例
假設您將 hello.sh bash 指令碼複製到 Cloud Storage:
gcloud storage cp hello.sh gs://${BUCKET}/hello.sh由於 pig fs 指令使用 Hadoop 路徑,請將指令碼從 Cloud Storage 複製到指定為 file:/// 的目的地,確保指令碼位於本機檔案系統,而非 HDFS。後續的 sh 指令會自動參照本機檔案系統,不需要 file:/// 前置字元。
gcloud dataproc jobs submit pig --cluster=${CLUSTER} --region=${REGION} \
    -e='fs -cp -f gs://${BUCKET}/hello.sh file:///tmp/hello.sh; sh chmod 750 /tmp/hello.sh; sh /tmp/hello.sh'
或者,由於 Managed Service for Apache Spark 工作提交 --jars 引數會將檔案暫存至為工作生命週期建立的暫存目錄,因此您可以將 Cloud Storage 殼層指令碼指定為 --jars 引數:
gcloud dataproc jobs submit pig --cluster=${CLUSTER} --region=${REGION} \
    --jars=gs://${BUCKET}/hello.sh \
-e='sh chmod 750 ${PWD}/hello.sh; sh ${PWD}/hello.sh'請注意,--jars 引數也可以參照本機指令碼:
gcloud dataproc jobs submit pig --cluster=${CLUSTER} --region=${REGION} \
    --jars=hello.sh \
    -e='sh chmod 750 ${PWD}/hello.sh; sh ${PWD}/hello.sh'