Crea un clúster con bibliotecas cliente
El siguiente código de muestra indica cómo usar las bibliotecas cliente de Cloud para crear un clúster de Managed Service para Apache Spark, ejecutar un trabajo en el clúster y, luego, borrar el clúster.
También puedes realizar estas tareas con las siguientes herramientas:
- Solicitudes de la API de REST en la Guía de inicio rápido sobre el uso del Explorador de API
- la Cloud de Confiance console en Crea un clúster con la Cloud de Confiance console
- Google Cloud CLI en Crea un clúster con la CLI de Google Cloud
Antes de comenzar
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Cloud de Confiance project.
Enable the Dataproc API, if it is not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
Ejecuta el código
Prueba el instructivo: Haz clic en Abrir en Cloud Shell para ejecutar un instructivo de las bibliotecas cliente de Cloud para Python que crea un clúster, ejecuta un trabajo de PySpark y, luego, borra el clúster.
Go
- Instala la biblioteca cliente Para obtener más información, consulta la documentación sobre cómo configurar tu entorno de desarrollo.
- Configura la autenticación
- Clona y ejecuta el código de muestra de GitHub.
Java
- Instala la biblioteca cliente Para obtener más información, consulta la documentación sobre cómo configurar un entorno de desarrollo Java.
- Configura la autenticación
- Clona y ejecuta el código de muestra de GitHub.
Node.js
- Instala la biblioteca cliente Para obtener más información, consulta la documentación sobre cómo configurar un entorno de desarrollo de Node.js.
- Configura la autenticación
- Clona y ejecuta el código de muestra de GitHub.
Python
- Instala la biblioteca cliente Para obtener más información, consulta la documentación sobre cómo configurar un entorno de desarrollo de Python.
- Configura la autenticación
- Clona y ejecuta el código de muestra de GitHub.
Revise el resultado.
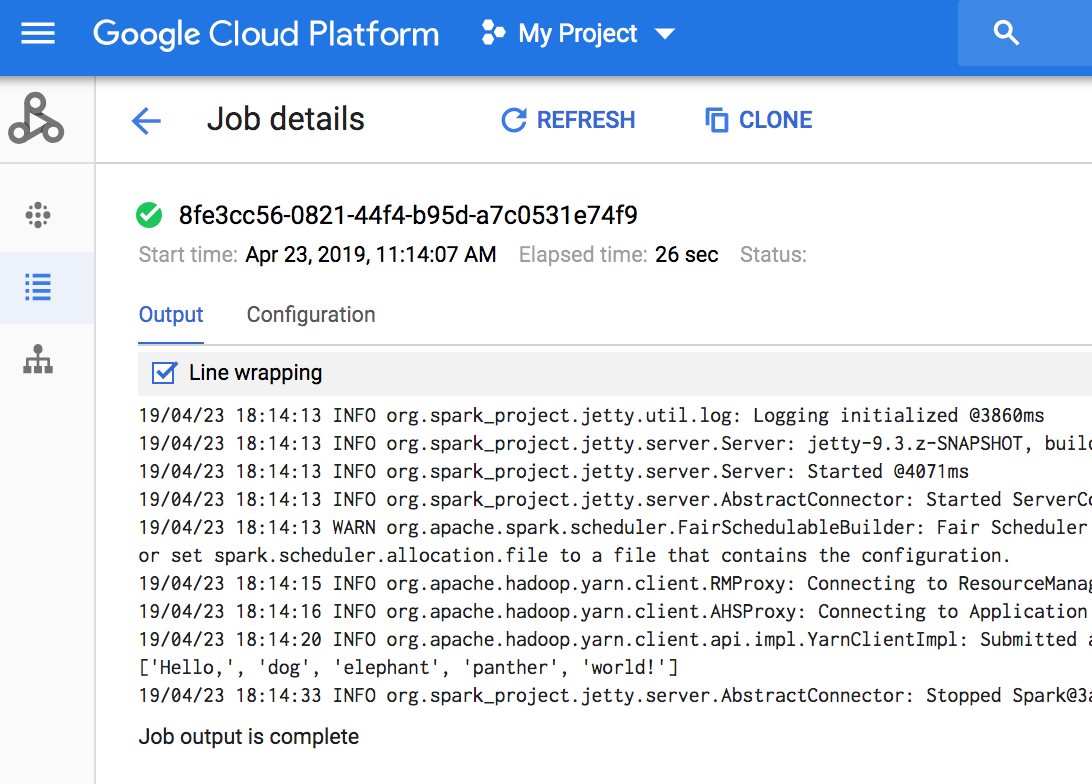
El código muestra el registro del controlador del trabajo en el bucket de etapa de pruebas predeterminado de Managed Service para Apache Spark en Cloud Storage. Puedes ver el resultado del controlador del trabajo desde la Cloud de Confiance console en la página Trabajos de Managed Service para Apache Spark de tu proyecto en la Cloud de Confiance console. Haz clic en el ID de tarea para ver el resultado del trabajo en la página Detalles del trabajo.