

מחבר spark-bigquery משמש עם Apache Spark כדי לקרוא ולכתוב נתונים מ-BigQuery ואליו. המחבר משתמש ב-BigQuery Storage API כשקוראים נתונים מ-BigQuery.
במדריך הזה מוסבר על הזמינות של המחבר שמותקן מראש, ואיך להפוך גרסה ספציפית של המחבר לזמינה למשימות Spark. קוד לדוגמה שמראה איך להשתמש במחבר Spark BigQuery באפליקציית Spark.
שימוש במחבר שהותקן מראש
מחבר Spark BigQuery מותקן מראש וזמין למשימות Spark שפועלות באשכולות של Managed Service for Apache Spark שנוצרו עם גרסאות אימג' 2.1 ואילך. גרסת המחבר שמותקנת מראש מופיעה בדפי הגרסאות של גרסאות התמונות.
הפיכת גרסה ספציפית של מחבר לזמינה למשימות Spark
אם רוצים להשתמש בגרסת מחבר שונה מהגרסה שמותקנת מראש באשכול של גרסת אימג' 2.1 ואילך, או אם רוצים להתקין את המחבר באשכול של גרסת אימג' שקודמת ל-2.1, צריך לפעול לפי ההוראות בקטע הזה.
חשוב: גרסת spark-bigquery-connector צריכה להיות תואמת לגרסת קובץ האימג' של אשכול Managed Service for Apache Spark. טבלת התאימות של תמונות ב-Connector to Managed Service for Apache Spark
אשכולות של גרסת התמונה 2.1 ואילך
כשיוצרים אשכול Managed Service for Apache Spark עם גרסת אימג' 2.1 ואילך, צריך לציין את גרסת המחבר בתור מטא-נתונים של האשכול.
דוגמה ל-CLI של gcloud:
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --image-version=2.2 \
    --metadata=SPARK_BQ_CONNECTOR_VERSION or SPARK_BQ_CONNECTOR_URL\
    other flags
הערות:
SPARK_BQ_CONNECTOR_VERSION: מציינים את גרסת המחבר. הגרסאות של מחבר Spark BigQuery מפורטות בדף spark-bigquery-connector/releases ב-GitHub.
דוגמה:
--metadata=SPARK_BQ_CONNECTOR_VERSION=0.42.1
SPARK_BQ_CONNECTOR_URL: מציינים כתובת URL שמפנה לקובץ ה-JAR ב-Cloud Storage. אפשר לציין את כתובת ה-URL של מחבר שמופיע בעמודה link בקטע Downloading and Using the Connector ב-GitHub, או את הנתיב למיקום ב-Cloud Storage שבו שמרתם קובץ JAR של מחבר בהתאמה אישית.
דוגמאות:
--metadata=SPARK_BQ_CONNECTOR_URL=gs://spark-lib/bigquery/spark-3.5-bigquery-0.42.1.jar
--metadata=SPARK_BQ_CONNECTOR_URL=gs://PATH_TO_CUSTOM_JAR
אשכולות של גרסאות תמונה מ-2.0 ומגרסאות קודמות
כדי להפוך את מחבר Spark BigQuery לזמין לאפליקציה, אפשר להשתמש באחת מהדרכים הבאות:
מתקינים את מחבר spark-bigquery בספריית ה-JAR של Spark בכל צומת, באמצעות פעולת האתחול של המחברים של Managed Service for Apache Spark כשיוצרים את האשכול.
כששולחים את המשימה לאשכול באמצעות מסוף Cloud de Confiance , ה-CLI של gcloud או Managed Service for Apache Spark API, צריך לציין את כתובת ה-URL של קובץ ה-JAR של המחבר.
המסוף
משתמשים בפריט Jars files של משימת Spark בדף Submit a job ב-Managed Service for Apache Spark.
gcloud
משתמשים בדגל
gcloud dataproc jobs submit spark --jars.API
משתמשים בשדה
SparkJob.jarFileUris.איך מציינים את קובץ ה-JAR של המחבר כשמריצים משימות Spark באשכולות עם גרסת אימג' שקודמת ל-2.0
- מציינים את קובץ ה-JAR של המחבר על ידי החלפת פרטי הגרסה של Scala ושל המחבר במחרוזת ה-URI הבאה:
gs://spark-lib/bigquery/spark-bigquery-with-dependencies_SCALA_VERSION-CONNECTOR_VERSION.jar
- שימוש ב-Scala
2.12עם גרסאות אימג' של Managed Service for Apache Spark1.5+gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-CONNECTOR_VERSION.jar
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-0.23.2.jar \
    -- job args
- שימוש ב-Scala
2.11עם גרסאות תמונה1.4וגרסאות קודמות של Managed Service for Apache Spark:gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.11-CONNECTOR_VERSION.jar
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.11-0.23.2.jar \
    -- job-args
- מציינים את קובץ ה-JAR של המחבר על ידי החלפת פרטי הגרסה של Scala ושל המחבר במחרוזת ה-URI הבאה:
מוסיפים את קובץ ה-JAR של המחבר לאפליקציית Scala או Java Spark כתלות (ראו הידור מול המחבר).
חישוב עלויות
במסמך הזה משתמשים ברכיבים הבאים של Cloud de Confiance by S3NS, והשימוש בהם כרוך בתשלום:
- Managed Service for Apache Spark
- BigQuery
- Cloud Storage
קריאה וכתיבה של נתונים מ-BigQuery ואליו
בדוגמה הזו, הנתונים נקראים מ-BigQuery ל-Spark DataFrame כדי לבצע ספירת מילים באמצעות ממשק ה-API הסטנדרטי של מקור הנתונים.
המחבר קורא נתונים מ-BigQuery באמצעות BigQuery Storage Read API, שקורא ישירות מקובצי הנתונים של הטבלה באופן מבוזר.
המחבר כותב את הנתונים ב-BigQuery באחד משני מצבים: DIRECT או INDIRECT.
- DIRECT: שימוש ב-BigQuery Storage Write API. כל מנהל כותב את הנתונים שלו, והמנהל הראשי שומר את כל הנתונים הממתינים בטבלה.
- INDIRECT: הנתונים נשמרים במאגר נתונים זמני בטבלה זמנית ב-Cloud Storage, ואז מופעלת משימת טעינה ב-BigQuery כדי להעתיק את הנתונים ל-BigQuery בפעולה אחת.
במצב INDIRECT, המחבר מנסה למחוק את הקבצים הזמניים אחרי שפעולת הטעינה של BigQuery מסתיימת, ופעם נוספת כשאפליקציית Spark מסתיימת. אם המשימה נכשלת, צריך להסיר ידנית את כל הקבצים הזמניים שנותרו ב-Cloud Storage. בדרך כלל, קובצי BigQuery זמניים נמצאים ב-gs://[bucket]/.spark-bigquery-[jobid]-[UUID].
הגדרת החיוב
כברירת מחדל, הפרויקט שמשויך לפרטי הכניסה או לחשבון השירות מחויב על השימוש ב-API. כדי לחייב פרויקט אחר, צריך להגדיר את התצורה הבאה: spark.conf.set("parentProject", "<BILLED-GCP-PROJECT>").
אפשר גם להוסיף אותו לפעולת קריאה או כתיבה, באופן הבא:
.option("parentProject", "<BILLED-GCP-PROJECT>").
מריצים את הקוד
לפני שמריצים את הדוגמה הזו, צריך ליצור מערך נתונים בשם "wordcount_dataset" או לשנות את מערך הנתונים של הפלט בקוד למערך נתונים קיים של BigQuery בפרויקט ב-Cloud de Confiance by S3NS .
משתמשים בפקודה bq כדי ליצור את wordcount_dataset:
bq mk wordcount_dataset
משתמשים בפקודה של Google Cloud CLI כדי ליצור קטגוריה של Cloud Storage, שתשמש לייצוא ל-BigQuery:
gcloud storage buckets create gs://[bucket]
Scala
- בודקים את הקוד ומחליפים את ה-placeholder [bucket] בקטגוריה של Cloud Storage שיצרתם קודם.
/*
 * Remove comment if you are not running in spark-shell.
 *
import org.apache.spark.sql.SparkSession
val spark = SparkSession.builder()
  .appName("spark-bigquery-demo")
  .getOrCreate()
*/

// Use the Cloud Storage bucket for temporary BigQuery export data used
// by the connector.
val bucket = "[bucket]"
spark.conf.set("temporaryGcsBucket", bucket)
// Enable reading from BigQuery views and materializing query results.
spark.conf.set("viewsEnabled", "true")
spark.conf.set("materializationDataset", "wordcount_dataset")

// Load data in from BigQuery. See
// https://github.com/GoogleCloudDataproc/spark-bigquery-connector#properties
// for option information.
val wordsDF =
  spark.read.bigquery("bigquery-public-data:samples.shakespeare")
  .cache()

wordsDF.createOrReplaceTempView("words")

// Perform word count.
val wordCountDF = spark.sql(
  "SELECT word, SUM(word_count) AS word_count FROM words GROUP BY word")
wordCountDF.show()
wordCountDF.printSchema()

// Saving the data to BigQuery.
(wordCountDF.write.format("bigquery")
  .save("wordcount_dataset.wordcount_output"))
- מריצים את הקוד באשכול
- משתמשים ב-SSH כדי להתחבר לצומת הראשי של אשכול Managed Service for Apache Spark
- נכנסים לדף Clusters של Managed Service for Apache Spark במסוף Cloud de Confiance ולוחצים על שם האשכול
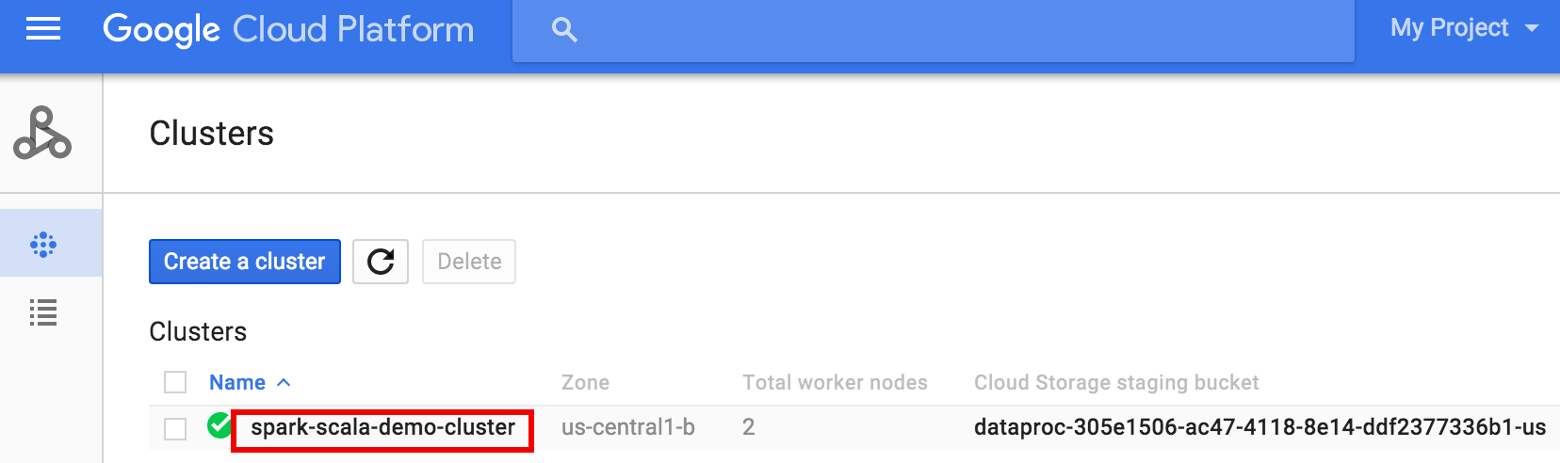 .
- בדף >Cluster details, לוחצים על הכרטיסייה VM Instances. לאחר מכן לוחצים על
SSHמשמאל לשם של צומת מאסטר האשכולות>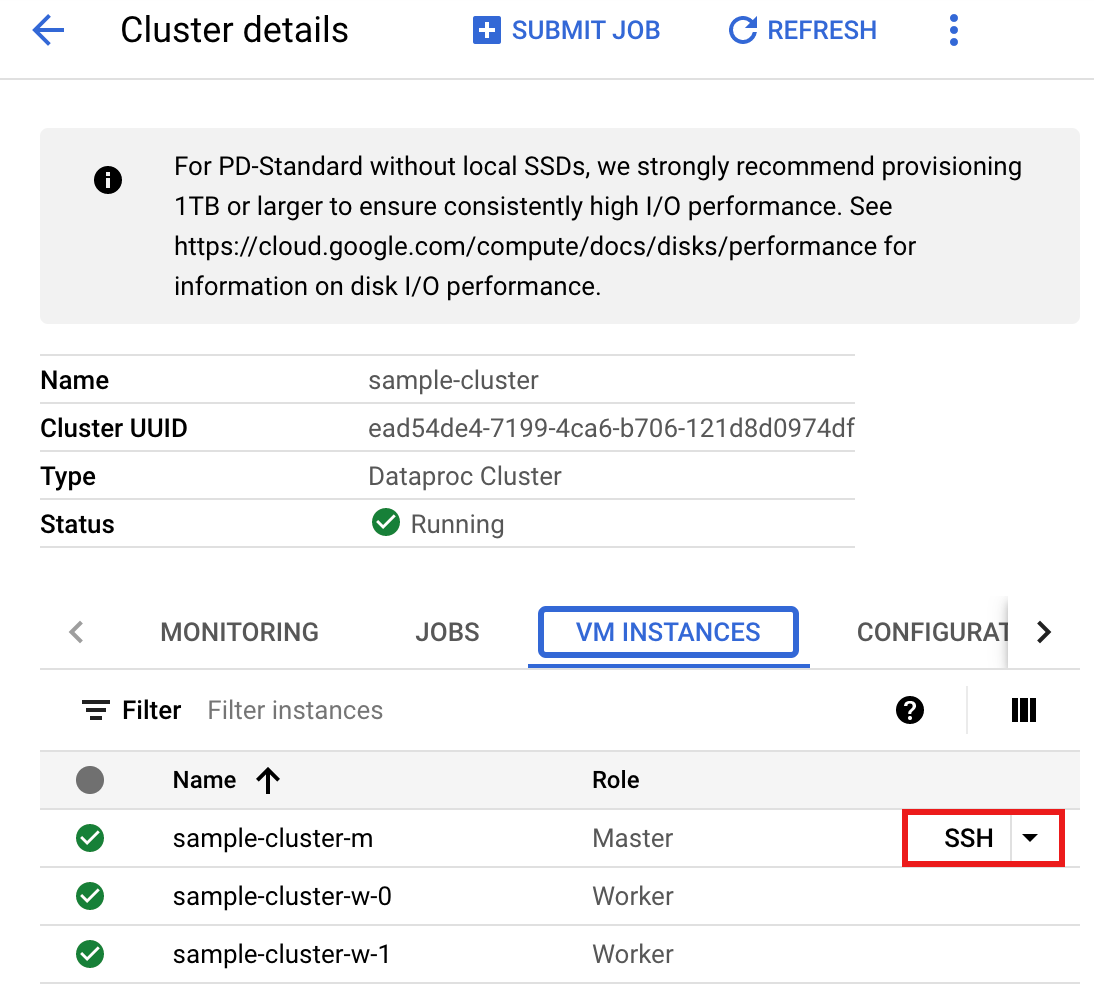
נפתח חלון דפדפן בספריית הבית של צומת המאסטר.Connected, host fingerprint: ssh-rsa 2048 ... ... user@clusterName-m:~$
- נכנסים לדף Clusters של Managed Service for Apache Spark במסוף Cloud de Confiance ולוחצים על שם האשכול
- יוצרים את
wordcount.scalaבאמצעות כלי עריכת הטקסטvi,vimאוnanoשמותקן מראש, ואז מדביקים את קוד Scala מרשימת קוד Scala.nano wordcount.scala
- מפעילים את
spark-shellREPL.$ spark-shell --jars=gs://spark-lib/bigquery/spark-bigquery-latest_2.12.jar ... Using Scala version ... Type in expressions to have them evaluated. Type :help for more information. ... Spark context available as sc. ... SQL context available as sqlContext. scala>
- מריצים את wordcount.scala באמצעות הפקודה
:load wordcount.scalaכדי ליצור את הטבלהwordcount_outputב-BigQuery. ברשימת הפלט מוצגות 20 שורות מהפלט של wordcount.:load wordcount.scala ... +---------+----------+ | word|word_count| +---------+----------+ | XVII| 2| | spoil| 28| | Drink| 7| |forgetful| 5| | Cannot| 46| | cures| 10| | harder| 13| | tresses| 3| | few| 62| | steel'd| 5| | tripping| 7| | travel| 35| | ransom| 55| | hope| 366| | By| 816| | some| 1169| | those| 508| | still| 567| | art| 893| | feign| 10| +---------+----------+ only showing top 20 rows root |-- word: string (nullable = false) |-- word_count: long (nullable = true)
כדי לראות תצוגה מקדימה של טבלת הפלט, פותחים את הדףBigQuery, בוחרים את הטבלהwordcount_outputולוחצים על Preview.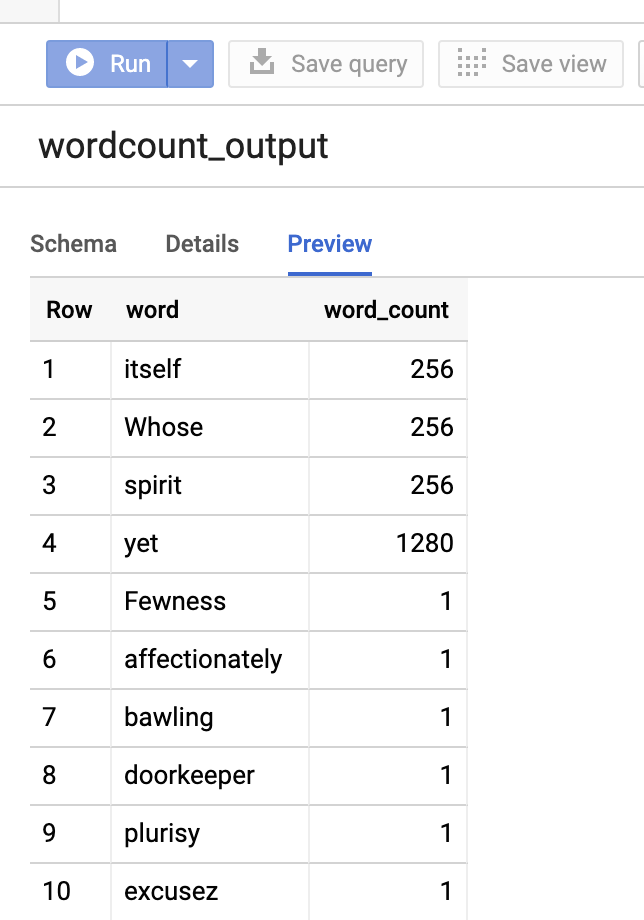
- משתמשים ב-SSH כדי להתחבר לצומת הראשי של אשכול Managed Service for Apache Spark
PySpark
- בודקים את הקוד ומחליפים את ה-placeholder [bucket] בקטגוריה של Cloud Storage שיצרתם קודם.
#!/usr/bin/env python

"""BigQuery I/O PySpark example."""

from pyspark.sql import SparkSession

spark = SparkSession \
  .builder \
  .master('yarn') \
  .appName('spark-bigquery-demo') \
  .getOrCreate()

# Use the Cloud Storage bucket for temporary BigQuery export data used
# by the connector.
bucket = "[bucket]"
spark.conf.set('temporaryGcsBucket', bucket)
# Enable reading from BigQuery views and materializing query results.
spark.conf.set('viewsEnabled', 'true')
spark.conf.set('materializationDataset', 'wordcount_dataset')

# Load data from BigQuery.
words = spark.read.format('bigquery') \
  .load('bigquery-public-data:samples.shakespeare')
words.createOrReplaceTempView('words')

# Perform word count.
word_count = spark.sql(
    'SELECT word, SUM(word_count) AS word_count FROM words GROUP BY word')
word_count.show()
word_count.printSchema()

# Save the data to BigQuery
word_count.write.format('bigquery') \
  .save('wordcount_dataset.wordcount_output')
- מריצים את הקוד באשכול
- משתמשים ב-SSH כדי להתחבר לצומת הראשי של האשכול ב-Managed Service for Apache Spark
- נכנסים לדף Clusters של Managed Service for Apache Spark במסוף Cloud de Confiance ולוחצים על שם האשכול .
- בדף Cluster details, לוחצים על הכרטיסייה VM Instances. לאחר מכן, לוחצים על
SSHמשמאל לשם של צומת מאסטר האשכולות
נפתח חלון דפדפן בספריית הבית של צומת המאסטרConnected, host fingerprint: ssh-rsa 2048 ... ... user@clusterName-m:~$
- נכנסים לדף Clusters של Managed Service for Apache Spark במסוף Cloud de Confiance ולוחצים על שם האשכול
- יוצרים את
wordcount.pyבאמצעות כלי עריכת הטקסטvi,vimאוnanoשמותקן מראש, ואז מדביקים את קוד PySpark מרשימת הקוד של PySpark.nano wordcount.py
- מריצים את wordcount עם
spark-submitכדי ליצור את הטבלהwordcount_outputב-BigQuery. רשימת הפלט מציגה 20 שורות מהפלט של wordcount.spark-submit --jars gs://spark-lib/bigquery/spark-bigquery-latest_2.12.jar wordcount.py ... +---------+----------+ | word|word_count| +---------+----------+ | XVII| 2| | spoil| 28| | Drink| 7| |forgetful| 5| | Cannot| 46| | cures| 10| | harder| 13| | tresses| 3| | few| 62| | steel'd| 5| | tripping| 7| | travel| 35| | ransom| 55| | hope| 366| | By| 816| | some| 1169| | those| 508| | still| 567| | art| 893| | feign| 10| +---------+----------+ only showing top 20 rows root |-- word: string (nullable = false) |-- word_count: long (nullable = true)
כדי לראות תצוגה מקדימה של טבלת הפלט, פותחים את הדףBigQuery, בוחרים את הטבלהwordcount_outputולוחצים על Preview.
- משתמשים ב-SSH כדי להתחבר לצומת הראשי של האשכול ב-Managed Service for Apache Spark
טיפים לפתרון בעיות
כדי לפתור בעיות במשימות Spark שמשתמשות במחבר ל-BigQuery, אתם יכולים לבדוק את יומני המשימות ב-Cloud Logging וב-Jobs Explorer ב-BigQuery.
ביומני הדרייבר של Managed Service for Apache Spark יש רשומת
BigQueryClientעם מטא-נתונים של BigQuery שכוללים אתjobId:ClassNotFoundException
INFO BigQueryClient:.. jobId: JobId{project=PROJECT_ID, job=JOB_ID, location=LOCATION} משימות ב-BigQuery מכילות את התוויות
Managed Service for Apache Spark_job_idו-Managed Service for Apache Spark_job_uuid:- רישום ביומן:
protoPayload.serviceData.jobCompletedEvent.job.jobConfiguration.labels.dataproc_job_id="JOB_ID"
protoPayload.serviceData.jobCompletedEvent.job.jobConfiguration.labels.dataproc_job_uuid="JOB_UUID"
protoPayload.serviceData.jobCompletedEvent.job.jobName.jobId="JOB_NAME"
- BigQuery Jobs Explorer: לוחצים על מזהה משימה כדי לראות את פרטי המשימה בקטע Labels שב-Job information.
- רישום ביומן: