

בדף הזה מוסבר איך יוצרים אשכול של Managed Service for Apache Spark שמשתמש במחבר Spark Spanner כדי לקרוא נתונים מ-Spanner ולכתוב אליו נתונים באמצעות Apache Spark.
המחבר של Spanner פועל עם Spark כדי לקרוא נתונים ממסד הנתונים של Spanner ולכתוב אליו נתונים באמצעות ספריית Java של Spanner. המחבר של Spanner תומך בקריאת טבלאות ותרשימים של Spanner ל-DataFrames ול-GraphFrames של Spark, ובכתיבת נתוני DataFrame לטבלאות של Spanner.
עלויות
במסמך הזה משתמשים ברכיבים הבאים של Cloud de Confiance by S3NS, והשימוש בהם כרוך בתשלום:
- Managed Service for Apache Spark
- Spanner
- Cloud Storage
לפני שמתחילים
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Cloud de Confiance project.
Enable the Spanner, Managed Service for Apache Spark, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- מקצים את התפקידים הנדרשים.
- הגדרת אשכול של Managed Service for Apache Spark.
- מגדירים מכונה של Spanner עם טבלת מסד נתונים של Singers.
מתן התפקידים הנדרשים
כדי להריץ את הדוגמאות שבדף הזה, צריך תפקידים מסוימים ב-IAM. בהתאם למדיניות הארגון, יכול להיות שהתפקידים האלה כבר הוקצו. כדי לבדוק את התפקידים שהוקצו, קראו את המאמר האם צריך להקצות תפקידים?.
כדי לקרוא הסבר על מתן תפקידים, קראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
כדי לוודא שלחשבון השירות שמשמש כברירת מחדל ב-Compute Engine יש את ההרשאות שנדרשות ליצירת אשכול Managed Service for Apache Spark, צריך לבקש מהאדמין להקצות לחשבון השירות שמשמש כברירת מחדל ב-Compute Engine את תפקידי ה-IAM הבאים בפרויקט:
- Dataproc Worker (
roles/dataproc.worker) - משתמש במסד נתונים ב-Cloud Spanner (
roles/spanner.databaseUser) - קריאה ממסד נתונים ב-Cloud Spanner עם DataBoost (
roles/spanner.databaseReaderWithDataBoost)
הגדרת אשכול של Managed Service for Apache Spark
יוצרים אשכול Managed Service for Apache Spark או משתמשים באשכול Managed Service for Apache Spark קיים שנוצר באמצעות תמונת Managed Service for Apache Spark בגרסה 2.1 ואילך. אם האשכול נוצר באמצעות תמונה בגרסה 2.0 או גרסה קודמת, הוא צריך להיווצר כשהמאפיין scope מוגדר להיקף cloud-platform.
הגדרת מכונה של Spanner עם טבלת מסד נתונים של זמרים (Singers)
יוצרים מכונה של Spanner עם מסד נתונים שמכיל טבלת Singers. שימו לב למזהה המכונה ולמזהה מסד הנתונים ב-Spanner.
שימוש במחבר של Spanner עם Spark
המחבר של Spanner זמין לגרסאות 3.1+ של Spark. אתם מציינים את גרסת המחבר כחלק ממפרט קובץ ה-JAR של המחבר של Cloud Storage כשאתם שולחים משימה לאשכול Managed Service for Apache Spark.
דוגמה: שליחת משימת Spark באמצעות ה-CLI של gcloud עם מחבר Spanner.
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar \
    ... [other job submission flags]
מחליפים את מה שכתוב בשדות הבאים:
CONNECTOR_VERSION: גרסת המחבר של Spanner.
בוחרים את הגרסה של מחבר Spanner מרשימת הגרסאות במאגר GoogleCloudDataproc/spark-spanner-connector ב-GitHub.
קריאת טבלאות Spanner
אתם יכולים להשתמש ב-Python או ב-Scala כדי לקרוא נתונים מטבלה של Spanner ל-Spark Dataframe באמצעות Spark data source API.
PySpark
כדי להריץ את קוד ה-PySpark לדוגמה שבקטע הזה באשכול, אתם יכולים לשלוח את המשימה ל-Managed Service for Apache Spark או להריץ את המשימה מ-spark-submit REPL בצומת הראשי של האשכול.
משימה ב-Managed Service for Apache Spark
- יוצרים קובץ
singers.pyבאמצעות כלי מקומי לעריכת טקסט או ב-Cloud Shell באמצעות כלי לעריכת טקסט שמותקן מראש, כמוvi,vimאוnano. - אחרי שמאכלסים את משתני ה-placeholder, מדביקים את הקוד הבא בקובץ
singers.py. שימו לב שהתכונה Data Boost של Spanner מופעלת, וההשפעה שלה על המכונה הראשית של Spanner היא כמעט אפסית.#!/usr/bin/env python """Spanner PySpark read example.""" from pyspark.sql import SparkSession spark = SparkSession \ .builder \ .master('yarn') \ .appName('spark-spanner-demo') \ .getOrCreate() # Load data from Spanner. singers = spark.read.format('cloud-spanner') \ .option("projectId", "PROJECT_ID") \ .option("instanceId", "INSTANCE_ID") \ .option("databaseId", "DATABASE_ID") \ .option("table", "TABLE_NAME") \ .option("enableDataBoost", "true") \ .load() singers.createOrReplaceTempView('Singers') # Read from Singers result = spark.sql('SELECT * FROM Singers') result.show() result.printSchema()
מחליפים את מה שכתוב בשדות הבאים:
- PROJECT_ID: מזהה הפרויקט ב- Cloud de Confiance by S3NS . מזהי הפרויקטים מופיעים בקטע Project info ב-Dashboard במסוף Cloud de Confiance .
- INSTANCE_ID, DATABASE_ID ו-TABLE_NAME : ראו הגדרת מכונה של Spanner עם טבלת מסד נתונים של
Singers.
- שומרים את קובץ ה-
singers.py. - שולחים את המשימה ל-Managed Service for Apache Spark באמצעות מסוף Cloud de Confiance , ה-CLI של gcloud או API בארכיטקטורת REST.
דוגמה: שליחת משימה ב-CLI של gcloud באמצעות המחבר של Spanner.
gcloud dataproc jobs submit pyspark singers.py \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --jars=gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar
מחליפים את מה שכתוב בשדות הבאים:
- CLUSTER_NAME: השם של האשכול החדש.
- REGION: אזור זמין ב-Compute Engine להרצת עומס העבודה.
- CONNECTOR_VERSION: גרסת המחבר של Spanner.
בוחרים את הגרסה של מחבר Spanner מרשימת הגרסאות במאגר
GoogleCloudDataproc/spark-spanner-connectorב-GitHub.
משימת spark-submit
- מתחברים לצומת הראשי של אשכול Managed Service for Apache Spark באמצעות SSH.
- נכנסים לדף Clusters של Managed Service for Apache Spark במסוף Cloud de Confiance ולוחצים על שם האשכול.
- בדף Cluster details, לוחצים על הכרטיסייה VM Instances. לאחר מכן לוחצים על
SSHמשמאל לשם של צומת מאסטר האשכולות.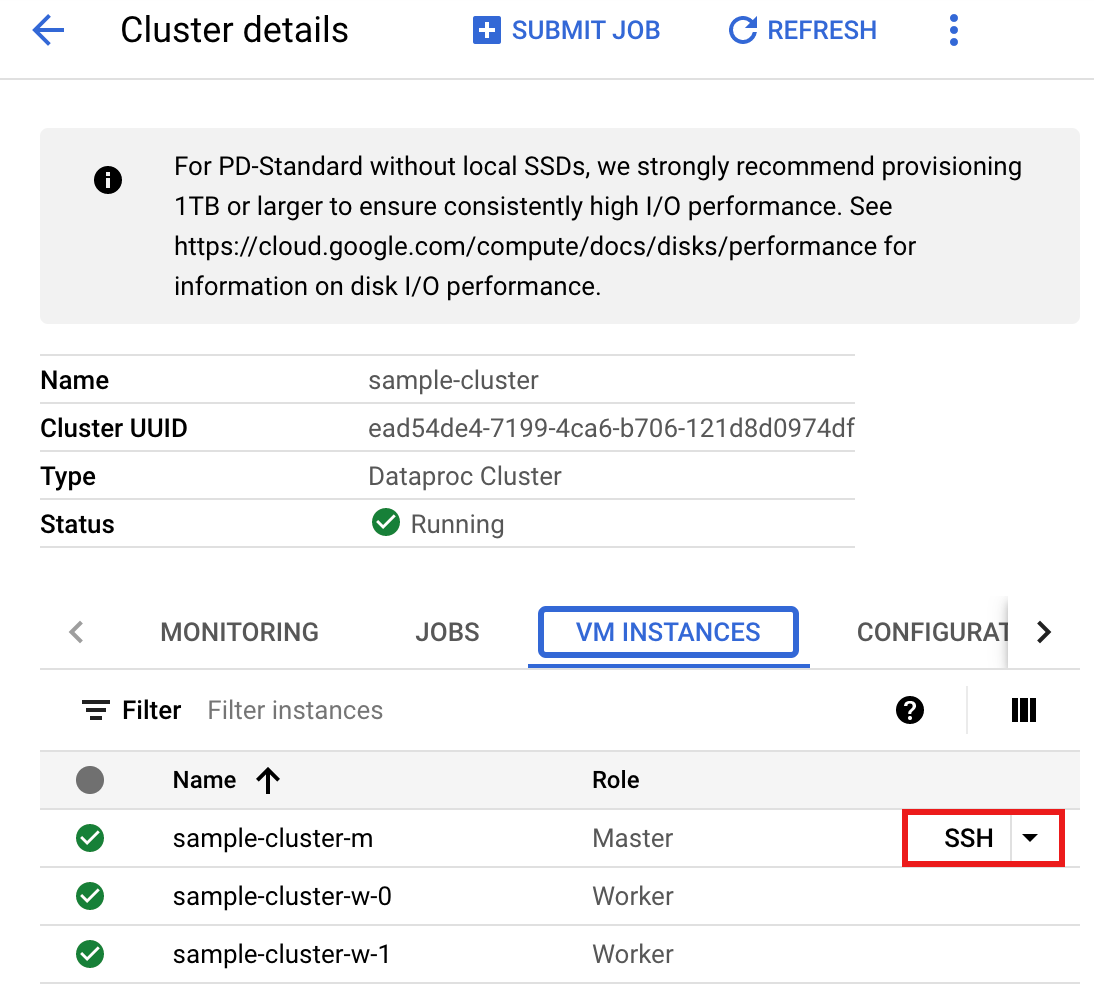
ייפתח חלון דפדפן בספריית הבית בצומת הראשי.
    Connected, host fingerprint: ssh-rsa 2048 ...
    ...
    user@clusterName-m:~$
- יוצרים קובץ
singers.pyבצומת הראשי באמצעות הכלי לעריכת טקסטvi,vimאוnanoשמותקן מראש.- מדביקים את הקוד הבא בקובץ
singers.pyאחרי שממלאים את משתני ה-placeholder בקובץsingers.py. שימו לב שהתכונה Data Boost של Spanner מופעלת, וההשפעה שלה על המכונה הראשית של Spanner היא כמעט אפסית.#!/usr/bin/env python """Spanner PySpark read example.""" from pyspark.sql import SparkSession spark = SparkSession \ .builder \ .master('yarn') \ .appName('spark-spanner-demo') \ .getOrCreate() # Load data from Spanner. singers = spark.read.format('cloud-spanner') \ .option("projectId", "PROJECT_ID") \ .option("instanceId", "INSTANCE_ID") \ .option("databaseId", "DATABASE_ID") \ .option("table", "TABLE_NAME") \ .option("enableDataBoost", "true") \ .load() singers.createOrReplaceTempView('Singers') # Read from Singers result = spark.sql('SELECT * FROM Singers') result.show() result.printSchema()
מחליפים את מה שכתוב בשדות הבאים:
- PROJECT_ID: מזהה הפרויקט ב- Cloud de Confiance by S3NS . מזהי הפרויקטים מופיעים בקטע Project info ב-Dashboard במסוף Cloud de Confiance .
- INSTANCE_ID, DATABASE_ID ו-TABLE_NAME : ראו הגדרת מכונה של Spanner עם טבלת מסד נתונים של
Singers.
- שומרים את קובץ ה-
singers.py.
- מדביקים את הקוד הבא בקובץ
- מריצים את הפקודה
singers.pyעםspark-submitכדי ליצור את הטבלהSingersב-Spanner.spark-submit --jars gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar singers.py
מחליפים את מה שכתוב בשדות הבאים:
- CONNECTOR_VERSION: גרסת המחבר של Spanner.
בוחרים את הגרסה של מחבר Spanner מרשימת הגרסאות במאגר
GoogleCloudDataproc/spark-spanner-connectorב-GitHub.
הפלט שיתקבל:
...
+--------+---------+--------+---------+-----------+
|SingerId|FirstName|LastName|BirthDate|LastUpdated|
+--------+---------+--------+---------+-----------+
|       1|     Marc|Richards|     null|       null|
|       2| Catalina|   Smith|     null|       null|
|       3|    Alice| Trentor|     null|       null|
+--------+---------+--------+---------+-----------+

root
 |-- SingerId: long (nullable = false)
 |-- FirstName: string (nullable = true)
 |-- LastName: string (nullable = true)
 |-- BirthDate: date (nullable = true)
 |-- LastUpdated: timestamp (nullable = true)
only showing top 20 rows
- CONNECTOR_VERSION: גרסת המחבר של Spanner.
בוחרים את הגרסה של מחבר Spanner מרשימת הגרסאות במאגר
Scala
כדי להריץ את קוד ה-Scala לדוגמה באשכול, מבצעים את השלבים הבאים:
- מתחברים לצומת הראשי של אשכול Managed Service for Apache Spark באמצעות SSH.
- נכנסים לדף Clusters של Managed Service for Apache Spark במסוף Cloud de Confiance ולוחצים על שם האשכול.
- בדף Cluster details, לוחצים על הכרטיסייה VM Instances. לאחר מכן לוחצים על
SSHמשמאל לשם של צומת מאסטר האשכולות.
ייפתח חלון דפדפן בספריית הבית בצומת הראשי.
    Connected, host fingerprint: ssh-rsa 2048 ...
    ...
    user@clusterName-m:~$
- יוצרים קובץ
singers.scalaבצומת הראשי באמצעות הכלי לעריכת טקסטvi,vimאוnanoשמותקן מראש.- מדביקים את הקוד הבא בקובץ
singers.scala. שימו לב שהתכונה Data Boost של Spanner מופעלת, וההשפעה שלה על המכונה הראשית של Spanner היא כמעט אפסית.object singers { def main(): Unit = { /* * Uncomment (use the following code) if you are not running in spark-shell. * import org.apache.spark.sql.SparkSession val spark = SparkSession.builder() .appName("spark-spanner-demo") .getOrCreate() */ // Load data in from Spanner. See // https://github.com/GoogleCloudDataproc/spark-spanner-connector/blob/main/README.md#properties // for option information. val singersDF = (spark.read.format("cloud-spanner") .option("projectId", "PROJECT_ID") .option("instanceId", "INSTANCE_ID") .option("databaseId", "DATABASE_ID") .option("table", "TABLE_NAME") .option("enableDataBoost", true) .load() .cache()) singersDF.createOrReplaceTempView("Singers") // Load the Singers table. val result = spark.sql("SELECT * FROM Singers") result.show() result.printSchema() } }
מחליפים את מה שכתוב בשדות הבאים:
- PROJECT_ID: מזהה הפרויקט ב- Cloud de Confiance by S3NS . מזהי הפרויקטים מופיעים בקטע Project info ב-Dashboard במסוף Cloud de Confiance .
- INSTANCE_ID, DATABASE_ID ו-TABLE_NAME : ראו הגדרת מכונה של Spanner עם טבלת מסד נתונים של
Singers.
- שומרים את קובץ ה-
singers.scala.
- מדביקים את הקוד הבא בקובץ
- מפעילים את
spark-shellREPL.$ spark-shell --jars=gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar
מחליפים את מה שכתוב בשדות הבאים:
CONNECTOR_VERSION: גרסת המחבר של Spanner. בוחרים את הגרסה של מחבר Spanner מרשימת הגרסאות במאגר
GoogleCloudDataproc/spark-spanner-connectorב-GitHub. - מריצים את
singers.scalaעם הפקודה:load singers.scalaכדי ליצור את הטבלהSingersב-Spanner. רשימת הפלט מציגה דוגמאות מהפלט של Singers.> :load singers.scala Loading singers.scala... defined object singers > singers.main() ... +--------+---------+--------+---------+-----------+ |SingerId|FirstName|LastName|BirthDate|LastUpdated| +--------+---------+--------+---------+-----------+ | 1| Marc|Richards| null| null| | 2| Catalina| Smith| null| null| | 3| Alice| Trentor| null| null| +--------+---------+--------+---------+-----------+ root |-- SingerId: long (nullable = false) |-- FirstName: string (nullable = true) |-- LastName: string (nullable = true) |-- BirthDate: date (nullable = true) |-- LastUpdated: timestamp (nullable = true)
קריאת תרשימים של Spanner
המחבר של Spanner תומך בייצוא של התרשים ל-DataFrames נפרדים של צמתים וקצוות, וגם בייצוא ישירות ל-GraphFrames.
בדוגמה הבאה מייצאים מסד נתונים של Spanner ל-GraphFrame. הוא משתמש במחלקה SpannerGraphConnector של Python, שכלולה בקובץ ה-JAR של המחבר של Spanner, כדי לקרוא את Spanner Graph.
from pyspark.sql import SparkSession

connector_jar = "gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar"

spark = (SparkSession.builder.appName("spanner-graphframe-graphx-example")
         .config("spark.jars.packages", "graphframes:graphframes:0.8.4-spark3.5-s_2.12")
         .config("spark.jars", connector_jar)
         .getOrCreate())
spark.sparkContext.addPyFile(connector_jar)

from spannergraph import SpannerGraphConnector

connector = (SpannerGraphConnector()
             .spark(spark)
             .project("PROJECT_ID")
             .instance("INSTANCE_ID")
             .database("DATABASE_ID")
             .graph("GRAPH_ID"))

g = connector.load_graph()
g.vertices.show()
g.edges.show()
מחליפים את מה שכתוב בשדות הבאים:
- CONNECTOR_VERSION: גרסת המחבר של Spanner.
בוחרים את הגרסה של מחבר Spanner מרשימת הגרסאות במאגר
GoogleCloudDataproc/spark-spanner-connectorב-GitHub. - PROJECT_ID: מזהה הפרויקט ב- Cloud de Confiance by S3NS . מזהי הפרויקטים מופיעים בקטע Project info ב-Dashboard במסוף Cloud de Confiance .
- INSTANCE_ID, DATABASE_ID ו-TABLE_NAME מזינים את מזהי המכונה, מסד הנתונים והתרשים.
כדי לייצא צומת וקצה DataFrames במקום GraphFrames, משתמשים ב-load_dfs:
df_vertices, df_edges, df_id_map = connector.load_dfs()
כתיבת טבלאות ב-Spanner
המחבר של Spanner תומך בכתיבה של Spark Dataframe לטבלה של Spanner באמצעות ממשק ה-API של מקור הנתונים של Spark.
דוגמה לכתיבת DataFrame בטבלת Spanner
מאכלסים את המשתנים לפני ששומרים ומריצים את הקוד.
"""Spanner PySpark write example."""
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName('Spanner Write App').getOrCreate()

columns = ['id', 'name', 'email']
data = [(1, 'John Doe', 'john.doe@example.com'), (2, 'Jane Doe', 'jane.doe@example.com')]
df = spark.createDataFrame(data, columns)

df.write.format('cloud-spanner') \
    .option("projectId", "PROJECT_ID")
    .option("instanceId", "INSTANCE_ID")
    .option("databaseId", "DATABASE_ID")
    .option("table", "TABLE_NAME")
    .mode("append") \
    .save()
מחליפים את הערכים הבאים:
- PROJECT_ID: מזהה הפרויקט ב- Cloud de Confiance by S3NS . מזהי הפרויקטים מופיעים בקטע Project info ב-Dashboard במסוף Cloud de Confiance .
- INSTANCE_ID, DATABASE_ID ו-TABLE_NAME: מזינים את המזהים של המכונה, מסד הנתונים והטבלה.
הסרת המשאבים
כדי להימנע מחיובים שוטפים בחשבון Cloud de Confiance by S3NS , אתם יכולים לעצור או למחוק את האשכול של Managed Service for Apache Spark ולמחוק את המכונה של Spanner.
המאמרים הבאים
- לדוגמאות של
pyspark.sql.DataFrame - למידע על השפות שנתמכות ב-Spark DataFrame, עיינו במאמרים הבאים:
- עיינו במאגר Spark Spanner Connector ב-GitHub.
- טיפים לכוונון משימות Spark