

Vous pouvez utiliser les enrichissements d'objets pour générer automatiquement des métadonnées structurées sans créer de pipelines de machine learning personnalisés. Les enrichissements d'objets appliquent les modèles de machine learning pré-entraînés de Google directement à vos objets stockés pour vous aider à rechercher, organiser et gérer vos données non structurées à grande échelle.
Pour commencer à générer des métadonnées pour vos objets, consultez Configurer les enrichissements d'objets.
Fonctionnement
Pour utiliser les enrichissements d'objets, vous devez utiliser les parties suivantes du système :
- Configuration de la fonctionnalité (
FeatureConfig) : vous créez une configuration de la fonctionnalité pour spécifier les buckets ou les projets que Cloud Storage surveille. - Modèles de machine learning : dans votre configuration, vous choisissez les modèles que vous souhaitez appliquer, par exemple des modèles qui détectent des objets, étiquettent des images, analysent des visages ou catégorisent des documents PDF.
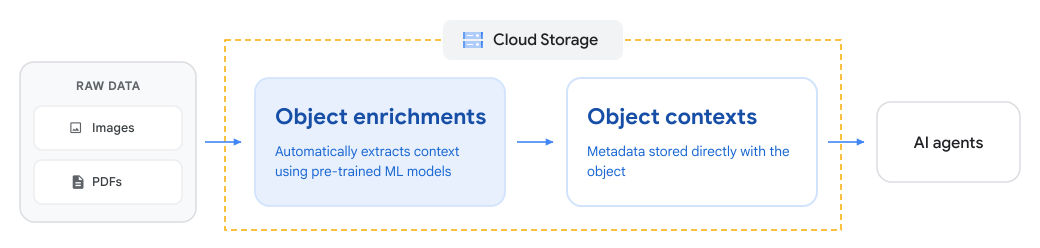
- Enrichissements d'objets (métadonnées) : Cloud Storage analyse vos objets de manière asynchrone et évalue les objets éligibles avec les modèles que vous avez sélectionnés. Cloud Storage associe ensuite les métadonnées obtenues directement à vos objets en tant que contextes d'objet.
Une fois que Cloud Storage a associé les métadonnées d'enrichissement à vos objets, elles sont prêtes à être utilisées. Vous pouvez inspecter des enrichissements d'objets individuels ou utiliser des ensembles de données Storage Insights pour analyser les métadonnées de millions d'objets à l'aide de SQL dans BigQuery.
Le schéma suivant montre comment Cloud Storage utilise les enrichissements d'objets pour extraire le contexte de données non structurées et le stocker en tant que contextes d'objets pour les workflows d'IA et d'analyse en aval :
Modèles compatibles
Lorsque vous créez une configuration de caractéristiques, vous sélectionnez les modèles de machine learning qui correspondent le mieux à vos données et à vos objectifs d'analyse. Cloud Storage évalue les objets éligibles à l'aide des modèles que vous avez choisis et génère des métadonnées structurées sous contexts.custom.
Le tableau des modèles compatibles répertorie chaque modèle, ce qu'il détecte et des exemples de données de sortie. Pour obtenir des définitions de schéma et des clés de contexte détaillées, consultez Modèles et schémas compatibles.
| Modèle | Description | Exemple de données de sortie |
|---|---|---|
| Détection d'objets | Détecte plusieurs objets dans une image, et fournit leur position et leurs limites rectangulaires. | Produit, animal, personne |
| Ajout de libellés à des images | Détecte et extrait des informations sur les entités d'une image dans un large groupe de catégories, telles que des objets, des lieux et des activités. | Paysage, Urbain, Nuit |
| Détection de visages | Détecte les visages dans les images, y compris les polygones de délimitation, les points de repère faciaux (yeux, nez, bouche), les angles d'orientation et les probabilités d'expression. | Nombre de visages, angle de roulis et d'inclinaison |
| Détection de contenu explicite | Évalue les images pour détecter les contenus sensibles ou inappropriés, y compris les contenus réservés aux adultes ou violents. | Évaluations de la probabilité de contenu réservé aux adultes et violent |
| Classification de PDF | Classe les documents PDF dans des catégories d'activité et des catégories sectorielles standards en fonction de leur contenu. | Finance, Taxes, Invoice (catégories et scores) |
Cas d'utilisation
Vous pouvez utiliser les enrichissements d'objets pour simplifier la gestion des données non structurées et préparer les objets pour les workflows d'analyse et d'IA en aval suivants :
- Organiser et cataloguer des objets non organisés : classez automatiquement des collections de documents PDF (tels que des factures, des relevés bancaires et des formulaires fiscaux) et des images. Vous pouvez utiliser ces classifications pour créer des catalogues de données interrogeables dans vos buckets sans écrire de code personnalisé.
- Ancrez les agents IA et améliorez la recherche : transformez des dépôts de documents désorganisés en bases de connaissances structurées. Vous pouvez utiliser des catégories de documents et des étiquettes d'image pour améliorer la récupération lors de la génération augmentée par récupération (RAG) et ancrer vos applications d'IA générative.
- Échantillonner et préparer les données pour l'IA générative : différenciez les types de documents pour effectuer un échantillonnage stratifié avant d'acheminer le contenu vers des grands modèles de langage (LLM) ou un examen humain.
- Organiser des ensembles de données d'entraînement de machine learning : filtrez et segmentez les images et les documents par taxonomie ou étiquettes visuelles pour assembler des ensembles de données d'entraînement spécifiques à un domaine afin d'affiner les modèles.
- Rechercher du contenu sensible ou explicite : inspectez automatiquement les images importées pour détecter tout contenu inapproprié afin de respecter vos règles de modération de contenu et de sécurité.
- Améliorer les requêtes multimodales : transmettez des métadonnées structurées, telles que des cadres de délimitation et des catégories de documents, en tant que contexte lorsque vous interrogez des modèles multimodaux comme Gemini.
- Simplifiez les architectures de données : éliminez les pipelines d'ingestion personnalisés et l'infrastructure de calcul en générant des métadonnées directement dans Cloud Storage.
Interroger et analyser vos métadonnées
Cloud Storage associe les enrichissements d'objets directement à vos objets en tant que contextes d'objet. En fonction de votre échelle et de votre workflow, vous pouvez accéder à ces métadonnées et les analyser de différentes manières :
- Inspecter des objets individuels : utilisez la console Cloud de Confiance ou les API Cloud Storage pour inspecter les enrichissements d'objets spécifiques. Pour obtenir des instructions, consultez Gérer les enrichissements d'objets.
- Analysez à grande échelle avec SQL : utilisez les ensembles de données Storage Insights pour exporter des métadonnées sur des millions ou des milliards d'objets directement dans BigQuery. Une fois que Storage Insights a exporté les métadonnées, vous pouvez interroger la vue
object_contexts_catalog_viewà l'aide du langage SQL standard. Par exemple, vous pouvez rechercher des étiquettes, filtrer par catégorie ou rechercher des objets ayant des scores de confiance élevés.
Pour commencer à utiliser des requêtes SQL et des exemples de recettes, consultez Analyser les enrichissements d'objets dans BigQuery.
Remarques et limites
Avant de configurer les enrichissements d'objets, tenez compte des points suivants :
Emplacement de traitement
Les enrichissements d'objets traitent les données dans trois emplacements géographiques : us, eu et asia. Lorsque vous sélectionnez un emplacement de traitement, tenez compte des points suivants :
- Conformité : assurez-vous que l'emplacement de traitement choisi répond à vos exigences réglementaires et de souveraineté des données.
- Performances : choisissez l'emplacement de traitement le plus proche de la région de stockage de votre bucket.
- Coût : pour éviter les frais en double, ne configurez qu'un seul emplacement de traitement pour chaque bucket et modèle. Si vous configurez plusieurs emplacements pour le même bucket et le même modèle, Cloud Storage traite vos objets dans chaque emplacement et vous facture chaque exécution.
Traitement et performances
Examinez les contraintes suivantes concernant les types de contenu, les tailles d'objets et les délais de traitement :
Traitement asynchrone : Cloud Storage traite les objets de manière asynchrone.
Taille maximale des objets : les objets (images et PDF) ne doivent pas dépasser 20 Mio.
Types de contenu compatibles : Cloud Storage utilise le champ de métadonnées
Content-Typedéfini sur un objet pour déterminer s'il doit l'évaluer. Si un objet comporte unContent-Typenon valide ou manquant, Cloud Storage ne le traite pas, même si les données sous-jacentes sont une image ou un PDF valide. Pour vous assurer que Cloud Storage traite l'objet, remplacez les métadonnéesContent-Typepar l'un des types compatibles suivants :- Images : BMP, GIF, ICO, JPEG, PNG, TIFF et WEBP.
- Documents : PDF (
application/pdf).
Fonctionnalités non compatibles
Les enrichissements d'objets ne sont pas compatibles avec les types de buckets et les opérations suivants :
- Relocalisation de bucket : les enrichissements d'objets ne sont pas compatibles avec la relocalisation de bucket. Supprimez le bucket de vos configurations de fonctionnalités avant de le déplacer.
- Types de buckets non compatibles : vous ne pouvez pas activer les enrichissements d'objets sur les buckets rapides ni sur les buckets pour lesquels l'espace de noms hiérarchique est activé.
Gestion de la configuration et du champ d'application
Lorsque vous définissez et gérez des buckets cibles dans vos configurations de fonctionnalités, les exigences suivantes s'appliquent :
- Champ d'application du bucket : spécifiez les noms exacts des buckets dans la configuration de votre fonctionnalité. Cloud Storage n'est pas compatible avec les expressions régulières ni les schémas de caractères génériques.
- Cycle de vie des buckets : Cloud Storage n'ajoute pas automatiquement les buckets nouvellement créés, recréés ou déplacés aux configurations existantes. Vous devez mettre à jour la configuration de votre fonctionnalité pour inclure ces buckets.
Coûts et sécurité
Consultez les détails opérationnels suivants concernant les clés de chiffrement et les frais d'accès aux données :
- Clés fournies par le client (CSEK) : les enrichissements d'objets ne sont pas compatibles avec les objets chiffrés à l'aide de clés de chiffrement fournies par le client.
- Accès au stockage et Autoclass : pour générer des métadonnées, les enrichissements d'objets lisent les données de vos objets. Ces opérations de lecture entraînent des frais d'accès aux données standards. De plus, si la classe automatique est activée sur votre bucket, ces lectures déclenchent des transitions de classe de stockage.
Tarifs
L'utilisation des enrichissements d'objets entraîne des frais pour l'inférence de modèle, le stockage des métadonnées, les opérations d'accès aux données et la mise en réseau. Pour en savoir plus, reportez-vous à la page Tarifs.
Surveiller et résoudre des problèmes
Pour suivre la progression de la génération des métadonnées et résoudre les problèmes lors de la configuration des enrichissements d'objets, utilisez les ressources suivantes :
- Surveiller les opérations : pour suivre les objets en attente, le nombre d'exécutions de modèles et l'état du traitement dans Cloud Monitoring, consultez Surveiller les métriques d'enrichissement d'objets.
- Résoudre les problèmes : si des enrichissements sont manquants ou si vous rencontrez des erreurs d'autorisation, consultez Résoudre les problèmes liés aux enrichissements d'objets.