

המסמך הזה מיועד למפתחי תוכנה ולאדמינים של מסדי נתונים שרוצים להעביר אפליקציות קיימות או לתכנן אפליקציות חדשות לשימוש עם Bigtable כמסד נתונים. במסמך הזה אנחנו משתמשים בידע שלכם ב-Apache Cassandra כדי לתאר מושגים שחשוב להבין לפני המעבר ל-Bigtable. מידע על כלים בקוד פתוח שאפשר להשתמש בהם כדי להשלים את ההעברה זמין במאמר העברה מ-Cassandra ל-Bigtable.
Bigtable ו-Cassandra הם מסדי נתונים מבוזרים. הם מטמיעים מאגרי מפתח/ערך רב-ממדיים שיכולים לתמוך בעשרות אלפי שאילתות לשנייה (QPS), בקריאות ובכתיבות עם זמן אחזור קצר, באחסון שניתן להרחבה עד לפטה-בייטים של נתונים ובסבילות לכשל בצומת.
מתי Bigtable הוא יעד טוב לעומסי עבודה של Cassandra
השירות של Cloud de Confiance by S3NS שהכי מתאים לעומס העבודה של Cassandra תלוי ביעדי ההעברה ובפונקציונליות של Cassandra שאתם צריכים אחרי ההעברה.
אם מתקיים אחד או יותר מהתנאים הבאים, Bigtable היא מערכת אופטימלית:
- אתם רוצים שירות שמנוהל במלואו, בלי חלונות זמן לתחזוקה ועם זמינות גבוהה.
- אתם צריכים התאמה דינמית לעומס (elastic scaling) שמגיבה לשינויים בתעבורת השרת באופן אוטומטי.
- אתם צריכים השהיה עקבית של מילי-שניות חד-ספרתיות לקריאה ולכתיבה.
- אתם משתמשים בסוגי אוספים, במונים או בתצוגות מהותיות של Cassandra, בנוסף לסוגים סקלריים ש-Bigtable מותאם להם.
- יש לכם אפליקציה שמשתמשת בפרמטר
USING TIMESTAMP. - קצב העברת הנתונים לכתיבה וזמן האחזור חשובים בדיוק כמו קצב העברת הנתונים לקריאה.
- אתם מסתמכים על אחד ממודלי הרפליקציה של Cassandra שמתבססים על מודל עקביות הדרגתי.
- תרחיש השימוש שלכם דורש אחסון חסכוני.
כדי להעביר אפליקציות בלי לבצע שינויים בקוד, אפשר לנהל את Cassandra ב-GKE באופן עצמאי או להשתמש בשותף כמו DataStax או ScyllaDB. Cloud de Confianceאם האפליקציה שלכם מתמקדת בקריאה ואתם מוכנים לארגן את הקוד מחדש כדי לקבל יכולות של מסד נתונים רלציוני ומודל עקביות חזק, כדאי לשקול את Spanner.
במאמר הזה נסביר מה כדאי להביא בחשבון כשמאגרנים את הקוד מחדש של האפליקציה, אם בוחרים ב-Bigtable כיעד למיגרציה של עומסי העבודה של Cassandra.
איך להשתמש במסמך הזה
אתם לא צריכים לקרוא את המסמך הזה מההתחלה ועד הסוף. למרות שהמסמך הזה מספק השוואה בין שני מסדי הנתונים, אתם יכולים גם להתמקד בנושאים שרלוונטיים לתרחיש לדוגמה או לתחומי העניין שלכם.
כדי לעזור לכם להשוות בין Bigtable ל-Cassandra, במאמר הזה:
- השוואה בין המונחים, שיכולים להיות שונים בין שני מסדי הנתונים.
- סקירה כללית של שתי מערכות מסדי הנתונים.
- איך כל מסד נתונים מטפל במודלים של נתונים, כדי להבין שיקולי תכנון שונים.
- השוואה בין הנתיב שבו הנתונים עוברים במהלך כתיבה וקריאה.
- הכלי בודק את פריסת הנתונים הפיזית כדי להבין היבטים של ארכיטקטורת מסד הנתונים.
- איך להגדיר שכפול גיאוגרפי בהתאם לדרישות שלכם, ואיך לגשת לקביעת גודל האשכול.
- סקירת פרטים על ניהול, מעקב ואבטחה של אשכולות.
השוואת מונחים
הרבה מהמושגים שמשמשים ב-Bigtable וב-Cassandra דומים, אבל לכל מסד נתונים יש מוסכמות שמות שונות במקצת והבדלים קלים.
אחת מאבני הבניין המרכזיות של שני מסדי הנתונים היא טבלת המחרוזות הממוינות (SSTable). בשתי הארכיטקטורות, טבלאות SSTable נוצרות כדי לשמר נתונים שמשמשים למענה על שאילתות קריאה.
בפוסט בבלוג (2012), איליה גריגוריק כתב את הדברים הבאים: "SSTable הוא הפשטה פשוטה לאחסון יעיל של מספרים גדולים של זוגות של מפתח-ערך, תוך אופטימיזציה של תפוקה גבוהה, קריאה או כתיבה רציפות של עומסי עבודה".
בטבלה הבאה מפורטים מושגים משותפים והמינוח המתאים שבו משתמש כל מוצר:
| Cassandra | Bigtable |
|---|---|
|
מפתח ראשי: ערך ייחודי של שדה אחד או כמה שדות שקובע את המיקום והסדר של הנתונים. מפתח מחיצה: ערך של שדה יחיד או של כמה שדות שקובע את מיקום הנתונים לפי גיבוב עקבי (consistent hash). עמודת אשכולות: ערך של שדה אחד או של כמה שדות שקובע את מיון הנתונים הלקסיקוגרפי בתוך מחיצה. |
מפתח שורה: מחרוזת בייטים ייחודית אחת שקובעת את מיקום הנתונים לפי מיון לקסיקוגרפי. כדי לחקות מפתחות מורכבים, מאחדים את הנתונים של כמה עמודות באמצעות תו מפריד נפוץ, כמו סולמית (#) או אחוז (%). |
| צומת: מכונה שאחראית על קריאה וכתיבה של נתונים שמשויכים לסדרה של טווחי גיבוב (hash) של מחיצות מפתח ראשי. ב-Cassandra, הנתונים מאוחסנים באחסון ברמת הבלוק שמחובר לשרת הצומת. | node: משאב וירטואלי של מחשוב שאחראי על קריאה וכתיבה של נתונים שמשויכים לסדרה של טווחי מפתחות שורות. ב-Bigtable, הנתונים לא ממוקמים יחד עם צמתי החישוב. במקום זאת, הוא מאוחסן ב-Colossus, מערכת הקבצים המבוזרת של Google. הצמתים מקבלים אחריות זמנית על הצגת טווחים שונים של נתונים, בהתאם לעומס הפעולות ולתקינות של צמתים אחרים באשכול. |
|
מרכז נתונים: דומה לאשכול Bigtable, אבל אפשר להגדיר ב-Cassandra חלק מההיבטים של הטופולוגיה ואסטרטגיית השכפול. rack (מתלה): קבוצה של צמתים במרכז נתונים שמשפיעה על מיקום העותקים. |
אשכול: קבוצה של צמתים באותו אזור גיאוגרפיCloud de Confiance by S3NS , שמוקמו יחד כדי לטפל בבעיות של השהיה ושכפול. |
| cluster: פריסת Cassandra שמורכבת מאוסף של מרכזי נתונים. | מכונה: קבוצה של אשכולות Bigtable באזורים שונים Cloud de Confiance , שביניהם מתרחשים שכפול וניתוב חיבורים. |
| vnode: טווח קבוע של ערכי גיבוב שמוקצה לצומת פיזי ספציפי. הנתונים ב-vnode מאוחסנים פיזית בצומת Cassandra בסדרה של SSTables. | tablet: טבלת SSTable שמכילה את כל הנתונים לטווח רציף של מפתחות שורות שממוינים לפי סדר מילוני. הטבלאות לא מאוחסנות בצמתים ב-Bigtable, אלא בסדרה של טבלאות SSTable ב-Colossus. |
| גורם השכפול: מספר העותקים של צומת וירטואלי שמתעדכנים בכל הצמתים במרכז הנתונים. גורם השכפול מוגדר בנפרד לכל מרכז נתונים. | שכפול: תהליך השכפול של הנתונים שמאוחסנים ב-Bigtable לכל האשכולות במופע. רפליקציה באשכול אזורי מטופלת על ידי שכבת האחסון Colossus. |
| table (לשעבר קבוצת עמודות): ארגון לוגי של ערכים שמקבל אינדקס לפי המפתח הראשי הייחודי. | טבלה: ארגון לוגי של ערכים שנוספו לאינדקס לפי מפתח השורה הייחודי. |
| keyspace: מרחב שמות לוגי של טבלה שמגדיר את גורם השכפול של הטבלאות שהוא מכיל. | לא רלוונטי. Bigtable מטפל בבעיות של מרחב מפתחות באופן שקוף. |
| map: סוג אוסף של Cassandra שמכיל צמדי מפתח/ערך. | משפחת עמודות: מרחב שמות שמוגדר על ידי המשתמש ומקבץ מזהי עמודות כדי לאפשר קריאה וכתיבה יעילות יותר. כששולחים שאילתות ל-Bigtable באמצעות SQL, קבוצות העמודות מטופלות כמו מפות של Cassandra. |
| map key: מפתח שמזהה באופן ייחודי רשומה של מפתח/ערך במפת Cassandra | מגדיר העמודה: תווית לערך שמאוחסן בטבלה, שנוסף לאינדקס לפי מפתח השורה הייחודי. כשמבצעים שאילתות ב-Bigtable באמצעות SQL, העמודות נחשבות כמפתחות של מפה. |
| עמודה: התווית של ערך שמאוחסן בטבלה, שנוסף לאינדקס לפי המפתח הראשי הייחודי. | column: התווית של ערך שמאוחסן בטבלה שמסודרת לפי מפתח השורה הייחודי. שם העמודה מורכב משילוב של קבוצת העמודות עם מגדיר העמודה. |
| תא: ערך של חותמת זמן בטבלה שמשויך להצטלבות של מפתח ראשי עם העמודה. | cell: ערך של חותמת זמן בטבלה שמשויך לנקודת החיתוך של מפתח שורה עם שם העמודה. אפשר לאחסן ולשחזר כמה גרסאות עם חותמת זמן לכל תא. |
| מונה: סוג שדה שניתן להגדלה, שמותאם לפעולות של סכום מספרים שלמים. | counters: תאים שמשתמשים בסוגי נתונים מיוחדים לפעולות של סכום מספרים שלמים. מידע נוסף זמין במאמר יצירה ועדכון של מונים. |
| מדיניות איזון עומסים: מדיניות שמגדירים בלוגיקה של האפליקציה כדי לנתב פעולות לצומת מתאים באשכול. המדיניות מביאה בחשבון את הטופולוגיה של מרכז הנתונים ואת טווחי הטוקנים של vnode. | פרופיל אפליקציה: הגדרות שמורות ל-Bigtable איך לנתב קריאה ל-API של לקוח לאשכול המתאים במכונה. אפשר גם להשתמש בפרופיל האפליקציה כתג לפילוח מדדים. אתם מגדירים את פרופיל האפליקציה בשירות. |
| CQL: Cassandra Query Language, שפה כמו SQL שמשמשת ליצירת טבלאות, לשינויים בסכימה, למוטציות בשורות ולשאילתות. | הלקוח של Cassandra ל-Bigtable ל-Java הוא תחליף חלק לדרייברים של Cassandra. לקוח Java מבין את שאילתות ה-CQL שלכם, ומאפשר לכם להשתמש ב-Bigtable באופן שקוף עם האפליקציה הקיימת שמבוססת על Cassandra, בלי לשכתב את הקוד. מתאם ה-proxy של Cassandra ל-Bigtable הוא שכבה עצמאית שאפשר להריץ במקביל לאפליקציה ולהתחבר ל-Bigtable כעוד צומת של Cassandra. מתאם ה-proxy מספק תאימות ל-CQL ותומך בהעברות בכתיבה כפולה ובכמות גדולה. הפונקציונליות הזו דומה למה שמציע הלקוח Cassandra to Bigtable ל-Java. Bigtable APIs הן ספריות הלקוח ו-gRPC APIs שמשמשות ליצירת מופעים ואשכולות, ליצירת טבלאות ומשפחות עמודות, לשינוי שורות ולהרצת שאילתות. ממשק SQL API של Bigtable מוכר למשתמשי CQL. |
תצוגה חומרית: הצהרת SELECT שמגדירה קבוצה של שורות שתואמת לשורות בטבלת מקור בסיסית. כשטבלת המקור משתנה, Cassandra מעדכנת את התצוגה המהותית באופן אוטומטי.
|
תצוגה מהותית רציפה: תוצאה מנוהלת באופן מלא ומחושבת מראש של שאילתת SQL, שמתעדכנת באופן מצטבר ואוטומטי מטבלת מקור. מידע נוסף זמין במאמר תצוגות מהותיות רציפות. |
סקירות כלליות של מוצרים
בקטעים הבאים מופיעה סקירה כללית של פילוסופיית העיצוב והמאפיינים העיקריים של Bigtable ו-Cassandra.
Bigtable
ב-Bigtable יש הרבה מהתכונות העיקריות שמתוארות במאמר Bigtable: A Distributed Storage System for Structured Data. ב-Bigtable, הצמתים של המחשוב שמשרתים את בקשות הלקוח מופרדים מניהול האחסון הבסיסי. הנתונים נשמרים ב-Colossus. שכבת האחסון משכפלת את הנתונים באופן אוטומטי כדי לספק עמידות שחורגת מהרמות שמספק שכפול תלת-כיווני רגיל של מערכת הקבצים המבוזרת של Hadoop (HDFS).
הארכיטקטורה הזו מספקת קריאות וכתיבות עקביות בתוך אשכול, מאפשרת הגדלה והקטנה של הקיבולת בלי עלות של חלוקה מחדש של האחסון, ויכולה לבצע איזון מחדש של עומסי עבודה בלי לשנות את האשכול או את הסכימה. אם צומת עיבוד נתונים כלשהו נפגע, שירות Bigtable מחליף אותו באופן שקוף. Bigtable תומך גם בשכפול אסינכרוני.
בנוסף ל-gRPC ולספריות לקוח לשפות תכנות שונות, Bigtable שומר על תאימות ל-Apache HBase בקוד פתוח, ספריית לקוח Java, הטמעה חלופית של המנוע של מסד הנתונים בקוד פתוח של מאמר Bigtable.
בתרשים הבא אפשר לראות איך Bigtable מפריד פיזית בין צומתי העיבוד לבין שכבת האחסון:
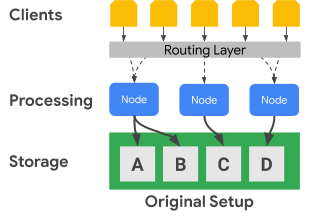
בתרשים הקודם, צומת העיבוד האמצעי אחראי רק על הצגת בקשות נתונים עבור מערך הנתונים C בשכבת האחסון. אם Bigtable מזהה שנדרש איזון מחדש של הקצאת הטווחים של מערך נתונים, קל לשנות את טווחי הנתונים של צומת עיבוד כי שכבת האחסון מופרדת משכבת העיבוד.
התרשים הבא מציג, במונחים פשוטים, איזון מחדש של טווח מפתחות ושינוי גודל של אשכול:
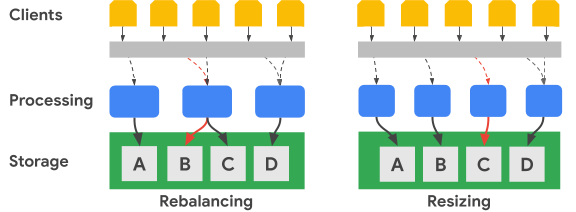
התמונה Rebalancing ממחישה את המצב של אשכול Bigtable אחרי שצומת העיבוד השמאלי ביותר מקבל מספר גדול יותר של בקשות למערך הנתונים A. אחרי האיזון מחדש, הצומת האמצעי, במקום הצומת השמאלי ביותר, אחראי על הטיפול בבקשות הנתונים של מערך הנתונים B. הצומת השמאלי ביותר ממשיך לטפל בבקשות של מערך הנתונים A.
מערכת Bigtable יכולה לסדר מחדש את טווחי מפתחות השורות כדי לאזן את טווחי קבוצת הנתונים במספר גדול יותר של צמתי עיבוד זמינים. בתמונה שינוי גודל מוצג המצב של אשכול Bigtable אחרי שמוסיפים צומת.
Cassandra
Apache Cassandra הוא מסד נתונים בקוד פתוח שמושפע בחלקו מרעיונות שמופיעים במאמר על Bigtable. היא משתמשת בארכיטקטורת צמתים מבוזרת, שבה האחסון ממוקם באותו מקום כמו השרתים שמגיבים לפעולות בנתונים. סדרה של צמתים וירטואליים (vnodes) מוקצים באופן אקראי לכל שרת כדי לשרת חלק ממרחב המפתחות של האשכול.
הנתונים מאוחסנים בצמתים הווירטואליים על סמך מפתח המחיצה. בדרך כלל, פונקציית גיבוב עקבי (consistent hashing) משמשת ליצירת אסימון כדי לקבוע את מיקום הנתונים. כמו ב-Bigtable, אפשר להשתמש במחיצה ששומרת על הסדר כדי ליצור טוקנים, וכך גם כדי למקם את הנתונים. עם זאת, בתיעוד של Cassandra לא ממליצים על הגישה הזו כי סביר להניח שהאשכול לא יהיה מאוזן, וקשה לתקן את המצב הזה. לכן, במסמך הזה אנחנו מניחים שאתם משתמשים באסטרטגיית גיבוב עקבי (consistent hashing) כדי ליצור אסימונים שמובילים להפצת נתונים בין הצמתים.
Cassandra מספקת עמידות בפני תקלות באמצעות רמות זמינות שקשורות לרמת העקביות הניתנת לכוונון, וכך מאפשרת לאשכול לשרת לקוחות בזמן שצומת אחד או יותר פגומים. אתם מגדירים שכפול גיאוגרפי באמצעות אסטרטגיה להגדרת טופולוגיה של שכפול נתונים.
מגדירים רמת עקביות לכל פעולה. ההגדרה הרגילה היא QUORUM (או LOCAL_QUORUM בטופולוגיות מסוימות של כמה מרכזי נתונים). כדי שהפעולה תיחשב כמוצלחת, הגדרת רמת העקביות הזו דורשת שרוב צומתי הרפליקה יגיבו לצומת המתאם. מקדם השכפול, שאתם מגדירים לכל מרחב מפתחות, קובע את מספר העותקים המשוכפלים של הנתונים שמאוחסנים בכל מרכז נתונים באשכול. לדוגמה, בדרך כלל משתמשים בערך 3 כפקטור רפליקציה כדי לספק איזון מעשי בין עמידות לבין נפח אחסון.
בתרשים הבא מוצג אשכול של שישה צמתים, כשכל טווח מפתחות של צומת מחולק לחמישה צמתים וירטואליים. בפועל, יכולים להיות יותר צמתים, וכנראה יהיו יותר צמתים וירטואליים.
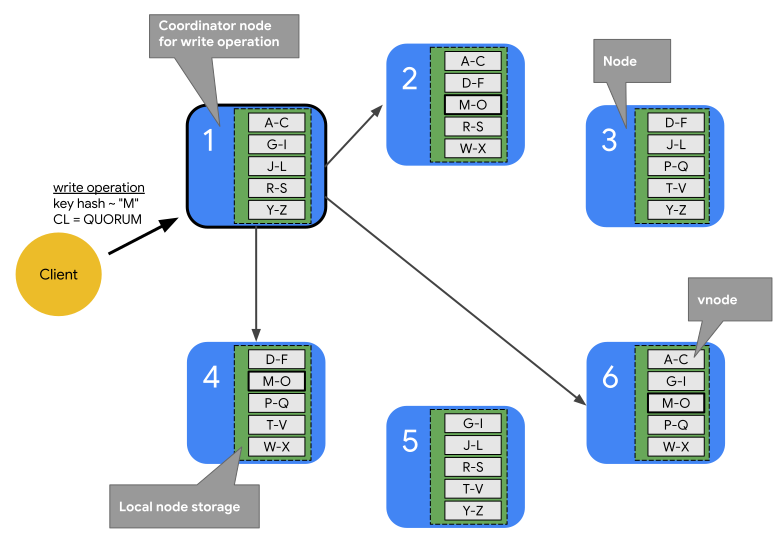
בתרשים שלמעלה אפשר לראות את הנתיב של פעולת כתיבה, עם רמת עקביות של QUORUM, שמקורה באפליקציית לקוח או בשירות (Client). לצורך התרשים הזה, טווחי המפתחות מוצגים כטווחי אותיות. בפועל, האסימונים שנוצרים מגיבוב של המפתח הראשי הם מספרים שלמים חתומים גדולים מאוד.
בדוגמה הזו, גיבוב המפתח הוא M, והצמתים הווירטואליים של M נמצאים בצמתים 2, 4 ו-6. המתאם צריך ליצור קשר עם כל צומת שבו טווחי הגיבוב של המפתחות מאוחסנים באופן מקומי, כדי שהכתיבה תוכל להתבצע. מכיוון שרמת העקביות היא QUORUM, שני עותקים (רוב) צריכים להגיב לצומת המתאם לפני שהלקוח מקבל הודעה שהכתיבה הושלמה.
בניגוד ל-Bigtable, כדי להעביר או לשנות טווחי מפתחות ב-Cassandra צריך להעתיק פיזית את הנתונים מצומת אחד לאחר. אם צומת אחד עמוס בבקשות לטווח גיבוב נתונים נתון של אסימונים, הוספת עיבוד לטווח האסימונים הזה מורכבת יותר ב-Cassandra בהשוואה ל-Bigtable.
שכפול גיאוגרפי ועקביות
ב-Bigtable וב-Cassandra, השכפול והעקביות הגיאוגרפיים (שנקראים גם multi- region) מטופלים באופן שונה. קלאסטר של Cassandra מורכב מצמתים לעיבוד שמקובצים למתלים, והמתלים מקובצים למרכזי נתונים. Cassandra משתמשת באסטרטגיית טופולוגיה של רשת שאתם מגדירים כדי לקבוע איך עותקים משוכפלים של vnode מופצים בין מארחים במרכז נתונים. האסטרטגיה הזו חושפת את המקורות של Cassandra כמסד נתונים שנפרס במקור במרכזי נתונים פיזיים מקומיים. ההגדרה הזו גם מציינת את מקדם הרפליקציה לכל מרכז נתונים באשכול.
Cassandra משתמשת בהגדרות של מרכזי נתונים ומתלים כדי לשפר את הסבילות לשגיאות של העתקי הנתונים. במהלך פעולות קריאה וכתיבה, הטופולוגיה קובעת את הצמתים המשתתפים שנדרשים כדי לספק עקביות. כשיוצרים או מרחיבים אשכול, צריך להגדיר באופן ידני את הצמתים, המדפים ומרכזי הנתונים. בסביבת ענן, פריסת Cassandra טיפוסית מתייחסת לאזור בענן כאל מתלה ולאזור בענן כאל מרכז נתונים.
אתם יכולים להשתמש באמצעי הבקרה של קוורום ב-Cassandra כדי להתאים את הבטחות העקביות לכל פעולת קריאה או כתיבה. רמות החוזק של העקביות בסופו של דבר יכולות להשתנות, כולל אפשרויות שדורשות צומת רפליקה יחיד (ONE), רוב של צומתי רפליקה במרכז נתונים יחיד (LOCAL_QUORUM) או רוב של כל צומתי הרפליקה בכל מרכזי הנתונים (QUORUM).
ב-Bigtable, אשכולות הם משאבים של תחום מוגדר. מכונה של Bigtable יכולה להכיל אשכול אחד, או קבוצה של אשכולות משוכפלים באופן מלא. אתם יכולים למקם אשכולות של מכונות בכל שילוב של אזורים בכל המחוזות שבהם Cloud de Confiance זמין. אפשר להוסיף אשכולות למכונה ולהסיר אותם ממנה, עם השפעה מינימלית על אשכולות אחרים במכונה.
ב-Bigtable, פעולות כתיבה מתבצעות (עם עקביות של קריאה אחרי כתיבה) באשכול יחיד, ובסופו של דבר הן יהיו עקביות באשכולות של מופעים אחרים. התאים הבודדים הם בעלי גרסאות שנקבעות לפי חותמת זמן, כך שאף פעולת כתיבה לא אובדת, וכל אשכול מציג את התאים עם חותמות הזמן העדכניות ביותר.
השירות חושף את סטטוס העקביות של האשכול. ב-Cloud Bigtable API יש מנגנון לקבלת אסימון עקביות ברמת הטבלה. אפשר להשתמש בטוקן הזה כדי לוודא שכל השינויים שבוצעו בטבלה לפני יצירת הטוקן שוכפלו באופן מלא.
תמיכה בעסקאות
למרות שאף אחת מהמסדי נתונים לא תומכת בעסקאות מורכבות של כמה שורות, לכל אחת מהן יש תמיכה מסוימת בעסקאות.
ל-Cassandra יש שיטה של טרנזקציות קלות משקל (LWT) שמאפשרת לבצע עדכונים אטומיים של ערכי עמודות במחיצה אחת. ל-Cassandra יש גם סמנטיקה של השוואה והגדרה, שמשלימה את פעולת הקריאה של השורה ואת השוואת הערכים לפני שמתחילה פעולת הכתיבה.
Bigtable תומך בכתיבה עקבית לחלוטין של שורה אחת בתוך אשכול. טרנזקציות בשורה אחת מתאפשרות גם באמצעות הפעולות read-modify-write ו-check-and-mutate. פרופילים של אפליקציות לניתוב בין כמה אשכולות לא תומכים בעסקאות של שורה אחת.
מודל נתונים
גם ב-Bigtable וגם ב-Cassandra הנתונים מאורגנים בטבלאות שתומכות בחיפושים ובסריקות של טווחים באמצעות המזהה הייחודי של השורה. שתי המערכות מסווגות כמאגרי NoSQL מסוג wide-column.
ב-Cassandra, צריך להשתמש ב-CQL כדי ליצור מראש את סכימת הטבלה המלאה, כולל הגדרת המפתח הראשי, שמות העמודות והסוגים שלהן. מפתחות ראשיים ב-Cassandra הם ערכים מורכבים ייחודיים שמורכבים ממפתח מחיצה חובה וממפתח אשכול אופציונלי. מפתח המחיצה קובע את מיקום הצומת של השורה, ומפתח האשכול קובע את סדר המיון בתוך המחיצה. כשיוצרים סכימות, חשוב להיות מודעים לפשרות האפשריות בין ביצוע סריקות יעילות במחיצה אחת לבין עלויות המערכת שקשורות לתחזוקת מחיצות גדולות.
ב-Bigtable, צריך רק ליצור את הטבלה ולהגדיר מראש את קבוצות העמודות שלה. העמודות לא מוצהרות כשיוצרים טבלאות, אלא נוצרות כשקריאות ל-API של האפליקציה מוסיפות תאים לשורות בטבלה.
מפתחות השורות מסודרים בסדר לקסיקוגרפי בכל אשכול Bigtable. הצמתים ב-Bigtable מאזנים באופן אוטומטי את האחריות של הצמתים לטווחים של מפתחות, שלרוב נקראים טאבלטים ולפעמים פיצולים. מפתחות השורות ב-Bigtable מורכבים בדרך כלל מכמה ערכי שדות שמחוברים באמצעות תו מפריד נפוץ לבחירתכם (למשל סימן אחוז). כשמפרידים את רכיבי המחרוזת, הם מקבילים לשדות של מפתח ראשי ב-Cassandra.
עיצוב מפתח שורה
ב-Bigtable, המזהה הייחודי של שורה בטבלה הוא מפתח השורה. מפתח השורה חייב להיות ערך ייחודי אחד בכל הטבלה. אפשר ליצור מפתחות עם כמה חלקים על ידי שרשור של רכיבים שונים שמופרדים באמצעות תו מפריד נפוץ. מפתח השורה קובע את סדר המיון הגלובלי של הנתונים בטבלה. שירות Bigtable קובע באופן דינמי את טווחי המפתחות שמוקצים לכל צומת.
בניגוד ל-Cassandra, שבה הגיבוב של מפתח המחיצה קובע את מיקום השורה והעמודות של האשכול קובעות את הסדר, מפתח השורה ב-Bigtable מספק גם הקצאה צומתית וגם סדר. כמו ב-Cassandra, צריך לתכנן מפתח שורה ב-Bigtable כך ששורות שרוצים לאחזר ביחד יאוחסנו ביחד. עם זאת, ב-Bigtable לא צריך לתכנן את מפתח השורה למיקום ולסדר לפני שמשתמשים בטבלה.
סוגי הנתונים
שירות Bigtable לא אוכף את סוגי הנתונים של העמודות שהלקוח שולח. ספריות הלקוח מספקות שיטות עזר לכתיבת ערכי תאים כבייטים, מחרוזות בקידוד UTF-8 ומספרים שלמים בקידוד 64 ביט ב-big-endian (מספרים שלמים בקידוד big-endian נדרשים לפעולות של הגדלה אטומית).
קבוצת עמודות
ב-Bigtable, קבוצת עמודות קובעת אילו עמודות בטבלה מאוחזרות ונשמרות ביחד. לכל טבלה צריכה להיות לפחות קבוצת עמודות אחת, אבל בדרך כלל יש יותר (המגבלה היא 100 קבוצות עמודות לכל טבלה). צריך ליצור במפורש קבוצות של עמודות לפני שאפליקציה תוכל להשתמש בהן בפעולה.
מסנני עמודות
כל ערך שמאוחסן בטבלה במפתח שורה משויך לתווית שנקראת מגדיר העמודה. מכיוון שמוספי העמודות הם רק תוויות, אין מגבלה מעשית על מספר העמודות שיכולות להיות במשפחת עמודות. ב-Bigtable, מגדירי העמודות משמשים לעיתים קרובות לייצוג נתוני אפליקציה.
תאים
ב-Bigtable, תא הוא נקודת המפגש של מפתח השורה ושם העמודה (קבוצת עמודות בשילוב עם מגדיר העמודה). כל תא מכיל ערך אחד או יותר עם חותמת זמן, שיכולים להיות מסופקים על ידי הלקוח או להיות מוחלים אוטומטית על ידי השירות. ערכי תאים ישנים נשמרים על סמך מדיניות איסוף אשפה שתצורתה מוגדרת ברמת משפחת העמודות.
אינדקסים משניים
אתם יכולים להשתמש בתצוגות המהותיות הרציפות כאינדקסים משניים אסינכרוניים לטבלאות, כדי לשלוח שאילתות לאותם נתונים באמצעות דפוסי חיפוש או מאפיינים שונים. מידע נוסף זמין במאמר יצירת אינדקס משני אסינכרוני.
מודלים של נתונים: גמישות עם אוספים
מתאם ה-proxy של Cassandra ל-Bigtable הופך סוגי אוספים של Cassandra, כמו מפות, קבוצות ורשימות, למשפחות של עמודות ב-Bigtable. לכן השימוש ב-Bigtable עם סוגי אוספים של Cassandra הוא יעיל מאוד, כי אפשר לכתוב ולקרוא עמודות ספציפיות הרבה יותר מהר מאשר קובצי blob בודדים.
בעזרת Bigtable, אתם יכולים ליצור אפליקציות עם אוספים גדולים ודינמיים בלי הפשרות בביצועים שנדרשות ב-Cassandra, מהסיבות הבאות:
- ב-Bigtable, רכיבי האוסף מאוחסנים כתאים נפרדים, כך שהפעולות על הרכיבים הן ברמת פירוט גבוהה. כלומר, עדכון מפה בודד מתורגם לכתיבה קלה של תא, מה שמאפשר ביצועים גבוהים ומדרגיות.
- אין מגבלת גודל מעשית לקולקציות Bigtable, מלבד מגבלות הגודל הכלליות של השורות.
- ב-Bigtable נשמר זמן אחזור נמוך ועקבי, בלי קשר לגודל האוסף, כמו שמוצג באיור 4.
לעומת זאת, במסמכי התיעוד של Cassandra מומלץ להגביל מאוד את השימוש בסוגי אוספים, ולעיתים קרובות להגביל את מספר הרכיבים למספרים קטנים בגלל פגיעה בביצועים. מכיוון ש-Cassandra קורא עמודות של אוספים כיחידה אחת, אוספים גדולים גורמים בהכרח לעליות פתאומיות בזמן האחזור של הקריאה ולאי-יציבות פוטנציאלית של הצומת.
אפשר לעקוף את המגבלות האלה באמצעות פתרונות עקיפים כמו אוספים קפואים או אחסון נתונים כמחרוזות JSON, אבל הפתרונות האלה פוגעים בביצועים כי הם מוסיפים read-modify-write tax. התקורה הזו מאלצת את מסד הנתונים לקרוא, לבטל את ההמשכיות, לעדכן ולכתוב מחדש את כל האובייקט בכל שינוי. בנוסף, מערכת Cassandra מתייחסת ל-blob-ים של JSON האלה כאל טקסט אטום, ולכן כל לוגיקת הניתוח נדרשת בשכבת האפליקציה. זה שונה מ-Bigtable, שבו יש עיבוד מובנה בצד השרת של מחרוזות JSON באמצעות פונקציות של SQL API.
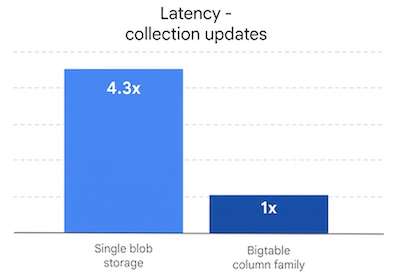
ב-Bigtable אפשר לשלב רכיבי סכימה קבועים עם רכיבים דינמיים בלי להתפשר. כך האפליקציות שלכם יכולות לאכוף מבנה במקומות שבהם הוא חשוב, ועדיין להישאר גמישות, מה שמאפשר לכם לפתח את מודל הנתונים בלי העברות נרחבות או זמני השבתה. הוא גם תומך בעומסי עבודה מודרניים, כמו למידת מכונה ו-AI, שדורשים איטרציה תכופה ב-Feature Store ובהצגה בזמן אמת בקנה מידה גלובלי.
איזון עומסים ומעבר לגיבוי (failover) בצד הלקוח
ב-Cassandra, הלקוח שולט באיזון העומסים של הבקשות. מנהל ההתקן של הלקוח מגדיר מדיניות שמוגדרת כחלק מההגדרה או באופן פרוגרמטי במהלך יצירת הסשן. האשכול מודיע למדיניות על מרכזי נתונים שהכי קרובים לאפליקציה, והלקוח מזהה צמתים ממרכזי הנתונים האלה כדי לטפל בפעולה.
שירות Bigtable מנתב קריאות ל-API לאשכול יעד על סמך פרמטר (מזהה פרופיל אפליקציה) שמסופק עם כל פעולה. פרופילי אפליקציות מנוהלים בתוך שירות Bigtable. פעולות של לקוחות שלא בוחרים פרופיל משתמשות בפרופיל ברירת המחדל.
ב-Bigtable יש שני סוגים של מדיניות ניתוב לפרופיל של אפליקציה: אשכול יחיד ומספר אשכולות. פרופיל של כמה אשכולות מנתב את הפעולות לאשכול הזמין הקרוב ביותר. אשכולות באותו אזור נחשבים במרחק שווה מנקודת המבט של נתב הפעולות. אם הצומת שאחראי לטווח המפתחות המבוקש עמוס מדי או לא זמין זמנית באשכול, סוג הפרופיל הזה מספק מעבר גיבוי אוטומטי.
ב-Cassandra, מדיניות מרובת אשכולות מספקת את היתרונות של מעבר אוטומטי לגיבוי של מדיניות איזון עומסים שמודעת למרכזי נתונים.
פרופיל אפליקציה עם ניתוב לאשכול יחיד מפנה את כל התנועה לאשכול יחיד. עקביות חזקה בשורות ועסקאות בשורה אחת זמינות רק בפרופילים עם ניתוב לאשכול יחיד.
החיסרון בגישה של אשכול יחיד הוא שבמעבר לגיבוי, האפליקציה צריכה להיות מסוגלת לנסות שוב באמצעות מזהה פרופיל אפליקציה חלופי, או שצריך לבצע את המעבר לגיבוי באופן ידני של פרופילי ניתוב מושפעים של אשכול יחיד.
ניתוב פעולות
Cassandra ו-Bigtable משתמשות בשיטות שונות לבחירת צומת העיבוד לפעולות קריאה וכתיבה. ב-Cassandra מזוהה מפתח המחיצה, ואילו ב-Bigtable נעשה שימוש במפתח השורה.
ב-Cassandra, הלקוח בודק קודם את מדיניות איזון העומסים. האובייקט בצד הלקוח הזה קובע את מרכז הנתונים שאליו הפעולה מנותבת.
אחרי שמרכז הנתונים מזוהה, Cassandra יוצרת קשר עם צומת מתאם כדי לנהל את הפעולה. אם המדיניות מזהה טוקנים, הרכיב המתאם הוא צומת שמספק נתונים ממחיצת הצומת הווירטואלי של היעד. אחרת, הרכיב המתאם הוא צומת אקראי. צומת התיאום מזהה את הצמתים שבהם נמצאות הרפליקות של הנתונים של מפתח המחיצה של הפעולה, ואז מורה לצמתים האלה לבצע את הפעולה.
כמו שצוין קודם, ב-Bigtable כל פעולה כוללת מזהה של פרופיל אפליקציה. פרופיל האפליקציה מוגדר ברמת השירות. שכבת הניתוב של Bigtable בודקת את הפרופיל כדי לבחור את אשכול היעד המתאים לפעולה. שכבת הניתוב מספקת נתיב לפעולה כדי להגיע לצומתי העיבוד הנכונים באמצעות מפתח השורה של הפעולה.
תהליך כתיבת הנתונים
שני מסדי הנתונים מותאמים לכתיבה מהירה ומשתמשים בתהליך דומה להשלמת הכתיבה. עם זאת, השלבים שמסדי הנתונים מבצעים משתנים מעט, במיוחד ב-Cassandra, שבה, בהתאם לרמת העקביות של הפעולה, יכול להיות שתידרש תקשורת עם צומתי משתתפים נוספים.
אחרי שבקשת הכתיבה מנותבת לצמתים המתאימים (Cassandra) או לצומת המתאים (Bigtable), הכתיבה נשמרת קודם בדיסק באופן רציף ביומן commit (Cassandra) או ביומן משותף (Bigtable). לאחר מכן, פעולות הכתיבה מוכנסות לטבלה בזיכרון (שנקראת גם memtable) שמסודרת כמו ה-SSTables.
אחרי שני השלבים האלה, הצומת מגיב כדי לציין שהכתיבה הושלמה. ב-Cassandra, כמה רפליקות (בהתאם לרמת העקביות שצוינה לכל פעולה) צריכות להגיב לפני שהרכז מודיע ללקוח שהכתיבה הושלמה. ב-Bigtable, כל מפתח שורה מוקצה לצומת אחד בלבד בכל נקודת זמן, ולכן תגובה מהצומת היא כל מה שצריך כדי לאשר שהכתיבה הצליחה.
בשלב מאוחר יותר, אם יש צורך, אפשר להעביר את טבלת ה-memtable לדיסק בצורה של SSTable חדשה. ב-Cassandra, הפעולה flush מתרחשת כשיומן הטרנזקציות מגיע לגודל מקסימלי, או כש-memtable חורג מסף שהגדרתם. ב-Bigtable, מתבצעת פעולת flush כדי ליצור קובצי SSTable חדשים בלתי ניתנים לשינוי כשגודל ה-memtable מגיע לגודל מקסימלי שמוגדר על ידי השירות. מדי פעם, תהליך דחיסה ממזג טבלאות SSTable של טווח מפתחות נתון לטבלת SSTable אחת.
עדכוני נתונים
שני מסדי הנתונים מטפלים בעדכוני נתונים באופן דומה. עם זאת, ב-Cassandra אפשר להזין רק ערך אחד בכל תא, בעוד שב-Bigtable אפשר לשמור מספר גדול של ערכים עם גרסאות בכל תא.
כשמשנים את הערך בנקודת החיתוך של מזהה שורה ייחודי ועמודה, העדכון נשמר כמו שמתואר בקטע תהליך כתיבת הנתונים. חותמת הזמן של הכתיבה מאוחסנת לצד הערך במבנה של SSTable.
אם לא ביצעתם פעולת Flush לתא מעודכן ב-SSTable, תוכלו לאחסן רק את ערך התא ב-Memtable, אבל יש הבדלים בין מסדי הנתונים לגבי מה שמאוחסן. Cassandra שומרת רק את הערך החדש ביותר ב-memtable, בעוד ש-Bigtable שומרת את כל הגרסאות ב-memtable.
לחלופין, אם שמרתם בדיסק לפחות גרסה אחת של ערך תא בטבלאות SSTable נפרדות, מסדי הנתונים מטפלים בבקשות לנתונים האלה באופן שונה. כשמבקשים את התא מ-Cassandra, מוחזר רק הערך העדכני ביותר לפי חותמת הזמן. במילים אחרות, הכתיבה האחרונה היא זו שקובעת. ב-Bigtable, משתמשים במסננים כדי לקבוע אילו גרסאות של תאים יוחזרו בבקשת קריאה.
מחיקות של שורות
מכיוון ששני מסדי הנתונים משתמשים בקובצי SSTable בלתי ניתנים לשינוי כדי לשמור נתונים בדיסק, אי אפשר למחוק שורה באופן מיידי. כדי לוודא שהשאילתות יחזירו את התוצאות הנכונות אחרי מחיקת שורה, שני מסדי הנתונים מטפלים במחיקות באמצעות אותו מנגנון. סמן (שנקרא tombstone ב-Cassandra) נוסף קודם ל-memtable. בסופו של דבר, טבלת SSTable חדשה שנכתבה מכילה סמן עם חותמת זמן שמציין שמזהה השורה הייחודי נמחק, ושהוא לא אמור להופיע בתוצאות השאילתה.
זמן חיים (TTL)
היכולות של אורך החיים (TTL) בשני מסדי הנתונים דומות, חוץ מהבדל אחד. ב-Cassandra אפשר להגדיר את ה-TTL לעמודה או לטבלה, ואילו ב-Bigtable אפשר להגדיר את ה-TTL רק לקבוצת העמודות. ב-Bigtable יש שיטה שמאפשרת לדמות TTL ברמת התא.
Garbage collection
כמו שהוסבר קודם, אי אפשר לעדכן או למחוק נתונים באופן מיידי בטבלאות SSTable שלא ניתנות לשינוי, ולכן מנגנון איסוף הזבל פועל במהלך תהליך שנקרא דחיסה. התהליך מסיר תאים או שורות שלא אמורים להופיע בתוצאות השאילתה.
תהליך איסוף הגרבג' לא כולל שורה או תא כשמתבצע מיזוג של SSTable. אם יש סמן או מצבה לשורה, השורה הזו לא נכללת ב-SSTable שמתקבל. בשני מסדי הנתונים אפשר להחריג תא ממיזוג ה-SSTable. אם חותמת הזמן של התא חורגת מהתנאי של TTL, מסדי הנתונים לא כוללים את התא. אם יש שתי גרסאות עם חותמת זמן לתא נתון, Cassandra כוללת ב-SSTable הממוזג רק את הערך האחרון.
נתיב קריאת הנתונים
כשפעולת קריאה מגיעה לצומת העיבוד המתאים, תהליך הקריאה לקבלת נתונים כדי לענות על תוצאת שאילתה זהה בשני מסדי הנתונים.
לכל SSTable בדיסק שעשוי להכיל תוצאות של שאילתות, המערכת בודקת מסנן בלום כדי לקבוע אם כל קובץ מכיל שורות שצריך להחזיר. מסנני בלום אף פעם לא מספקים תוצאה שלילית שגויה, ולכן כל טבלאות ה-SSTable שעומדות בדרישות מתווספות לרשימת מועמדים שתיכלל בעיבוד נוסף של תוצאות הקריאה.
פעולת הקריאה מתבצעת באמצעות תצוגה מאוחדת שנוצרת מטבלת הזיכרון ומקובצי ה-SSTable הפוטנציאליים בדיסק. כל המפתחות ממוינים לפי סדר לקסיקוגרפי, ולכן אפשר לקבל ביעילות תצוגה ממוזגת שנסרקת כדי לקבל את תוצאות השאילתה.
ב-Cassandra, קבוצה של צמתי עיבוד שנקבעים לפי רמת העקביות של הפעולה חייבת להשתתף בפעולה. ב-Bigtable, צריך להתייעץ רק עם הצומת שאחראי על טווח המפתחות. ב-Cassandra, צריך להביא בחשבון את ההשלכות על גודל המחשוב, כי סביר להניח שכמה צמתים יעבדו כל קריאה.
אפשר להגביל את תוצאות הקריאה בצומת העיבוד בדרכים שונות.
ב-Cassandra, התנאי WHERE בשאילתת CQL מגביל את השורות שמוחזרות. המגבלה היא שאפשר להשתמש בעמודות במפתח הראשי או בעמודות שכלולות באינדקס משני כדי להגביל את התוצאות.
ב-Bigtable יש מגוון עשיר של מסננים שמשפיעים על השורות או התאים ששאילתת קריאה מאחזרת.
יש שלוש קטגוריות של מסננים:
- מסננים מגבילים, שקובעים אילו שורות או תאים ייכללו בתגובה.
- שינוי מסננים, שמשפיעים על הנתונים או המטא-נתונים של תאים ספציפיים.
- ליצור מסננים מורכבים, שמאפשרים לשלב כמה מסננים למסנן אחד.
מסננים מגבילים הם המסננים הנפוצים ביותר – לדוגמה, הביטוי הרגולרי של משפחת העמודות והביטוי הרגולרי של מסווג העמודות .
אחסון פיזי של נתונים
גם Bigtable וגם Cassandra מאחסנים נתונים ב-SSTables, שמתמזגים באופן קבוע במהלך שלב הדחיסה. דחיסת נתונים של SSTable מציעה יתרונות דומים להקטנת נפח האחסון. עם זאת, הדחיסה מופעלת אוטומטית ב-Bigtable, והיא אפשרות הגדרה ב-Cassandra.
כשמשווים בין שני מסדי הנתונים, חשוב להבין איך כל אחד מהם מאחסן את הנתונים באופן פיזי, בהיבטים הבאים:
- אסטרטגיית הפצת הנתונים
- מספר הגרסאות של התא שזמינות
- סוג דיסק האחסון
- מנגנון עמידות הנתונים והרפליקציה
התפלגות הנתונים
ב-Cassandra, הדרך המומלצת לקבוע את חלוקת הנתונים בין טבלאות ה-SSTable השונות שמוצגות על ידי צמתי האשכול היא באמצעות גיבוב עקבי של עמודות המחיצה של המפתח הראשי.
Bigtable משתמש בתחילית משתנה למפתח השורה המלא כדי למקם נתונים ב-SSTables באופן לקסיקוגרפי.
גרסאות של תאים
ב-Cassandra נשמרת רק גרסה אחת של ערך תא פעיל. אם מתבצעות שתי פעולות כתיבה לתא, מדיניות של 'הכתיבה האחרונה קובעת' מבטיחה שיוחזר רק ערך אחד.
ב-Bigtable אין הגבלה על מספר הגרסאות עם חותמת זמן לכל תא. יכול להיות שיחולו מגבלות נוספות על גודל השורה. אם חותמת הזמן לא מוגדרת על ידי בקשת הלקוח, שירות Bigtable קובע את חותמת הזמן ברגע שצומת העיבוד מקבל את השינוי. אפשר לגזום גרסאות של תאים באמצעות מדיניות איסוף אשפה שיכולה להיות שונה לכל משפחת עמודות בטבלה, או לסנן אותן ממערך תוצאות של שאילתה באמצעות ה-API.
נפח אחסון בדיסק
Cassandra מאחסנת טבלאות SSTable בדיסקים שמחוברים לכל צומת באשכול. כדי לאזן מחדש את הנתונים ב-Cassandra, צריך להעתיק פיזית את הקבצים בין השרתים.
Bigtable משתמש ב-Colossus כדי לאחסן SSTables. מכיוון ש-Bigtable משתמש במערכת הקבצים המבוזרת הזו, שירות Bigtable יכול להקצות מחדש טבלאות SSTable לצמתים שונים כמעט באופן מיידי.
עמידות ושכפול של נתונים
Cassandra מספקת עמידות של הנתונים באמצעות הגדרת גורם השכפול. פקטור הרפליקציה קובע את מספר העותקים של SSTable שמאוחסנים בצמתים שונים באשכול. הגדרה אופיינית של גורם השכפול היא 3, שעדיין מאפשרת הבטחות חזקות יותר לעקביות עם QUORUM או LOCAL_QUORUM גם אם מתרחשת כשל בצומת.
ב-Bigtable, עמידות גבוהה של נתונים מובטחת באמצעות הרפליקציה ש-Colossus מספק.
התרשים הבא ממחיש את פריסת הנתונים הפיזיים, צומתי העיבוד של המחשוב ושכבת הניתוב של Bigtable:
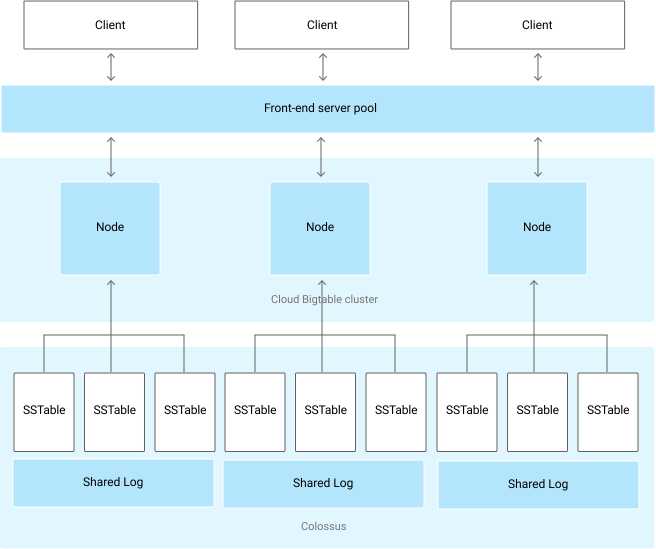
בשכבת האחסון של Colossus, כל צומת מוקצה להצגת הנתונים שמאוחסנים בסדרה של SSTables. טבלאות ה-SSTable האלה מכילות את הנתונים של טווחי מפתחות השורות שמוקצים באופן דינמי לכל צומת. בדיאגרמה מוצגים שלושה קובצי SSTable לכל צומת, אבל סביר להניח שיש יותר כי קובצי SSTable נוצרים באופן רציף כשהצמתים מקבלים שינויים חדשים בנתונים.
לכל צומת יש יומן משותף. פעולות כתיבה שעובדו על ידי כל צומת נשמרות מיד ביומן המשותף לפני שהלקוח מקבל אישור כתיבה. מכיוון שפעולת כתיבה ב-Colossus משוכפלת מספר פעמים, העמידות מובטחת גם אם מתרחשת כשל בחומרה של הצומת לפני שהנתונים נשמרים ב-SSTable עבור טווח השורות.
ממשקי אפליקציות
במקור, הגישה למסד הנתונים של Cassandra נחשפה באמצעות ממשק API של Thrift, אבל שיטת הגישה הזו הוצאה משימוש. האינטראקציה המומלצת עם הלקוח היא באמצעות CQL.
בדומה ל-Thrift API המקורי של Cassandra, הגישה למסד הנתונים של Bigtable מתבצעת דרך API שקורא וכותב נתונים על סמך מפתחות השורות שסופקו.
כמו ל-Cassandra, גם ל-Bigtable יש ממשק שורת פקודה שנקרא cbt CLI, וספריות לקוח שתומכות בהרבה שפות תכנות נפוצות. הספריות האלה מבוססות על ממשקי ה-API של gRPC ו-REST. אפליקציות שנכתבו ל-Hadoop ומסתמכות על ספריית הקוד הפתוח Apache HBase ל-Java יכולות להתחבר ל-Bigtable בלי שינוי משמעותי. לאפליקציות שלא דורשות תאימות ל-HBase, מומלץ להשתמש בלקוח Java המובנה של Bigtable.
אמצעי הבקרה של ניהול הזהויות והרשאות הגישה (IAM) ב-Bigtable משולבים באופן מלא ב- Cloud de Confiance, ואפשר גם להשתמש בטבלאות כמקור נתונים חיצוני מ-BigQuery.
הגדרת מסד נתונים
כשמגדירים אשכול Cassandra, צריך לקבל כמה החלטות לגבי ההגדרות ולבצע כמה שלבים. קודם צריך להגדיר את צומתי השרת כדי לספק קיבולת מחשוב ולהקצות נפח אחסון מקומי. כשמשתמשים בפקטור שכפול של שלוש, ההגדרה המומלצת והנפוצה ביותר, צריך להקצות נפח אחסון שגדול פי שלושה מכמות הנתונים שאתם מצפים להחזיק באשכול. אתם צריכים גם לקבוע ולהגדיר את ההגדרות של צמתי vnode, מתלים ושכפול.
ההפרדה בין המחשוב לאחסון ב-Bigtable מפשטת את הגדלת האשכולות והקטנתם בהשוואה ל-Cassandra. בדרך כלל, כשמריצים אשכול בצורה רגילה, צריך להתייחס רק לנפח האחסון הכולל שמשמש את הטבלאות המנוהלות, שקובע את המספר המינימלי של הצמתים, ולוודא שיש מספיק צמתים כדי לעמוד בקצב הנוכחי של שאילתות לשנייה.
אתם יכולים לשנות במהירות את הגודל של אשכול Bigtable אם האשכול מוקצה יתר על המידה או פחות מדי על סמך עומס הייצור.
אחסון ב-Bigtable
מלבד המיקום הגיאוגרפי של האשכול הראשוני, הבחירה היחידה שצריך לעשות כשיוצרים מכונה של Bigtable היא סוג האחסון. ב-Bigtable יש שתי אפשרויות לאחסון: כונני SSD או כוננים קשיחים (HDD). כל האשכולות במכונה חייבים להיות מאותו סוג אחסון.
כשמתכננים את נפח האחסון ב-Bigtable, לא צריך לקחת בחשבון עותקים משוכפלים של האחסון, כמו שצריך לעשות כשקובעים את הגודל של אשכול Cassandra. אין ירידה בצפיפות האחסון כדי להשיג סובלנות לתקלות, כמו שקורה ב-Cassandra. בנוסף, מכיוון שלא צריך להקצות אחסון באופן מפורש, אתם מחויבים רק על האחסון שבשימוש.
SSD
קיבולת הצומת של ה-SSD היא 5TB, והיא עדיפה לרוב עומסי העבודה. היא מספקת צפיפות אחסון גבוהה יותר בהשוואה להגדרות המומלצות למכונות Cassandra, שבהן צפיפות האחסון המקסימלית בפועל היא פחות מ-2TB לכל צומת. כשאתם מעריכים את צורכי קיבולת האחסון, זכרו שב-Bigtable נספר רק עותק אחד של הנתונים. לעומת זאת, ב-Cassandra צריך להביא בחשבון שלושה עותקים של הנתונים ברוב ההגדרות.
מספר השאילתות לשנייה לכתיבה ב-SSD דומה לזה שב-HDD, אבל מספר השאילתות לשנייה לקריאה ב-SSD גבוה משמעותית מזה שב-HDD. המחיר של אחסון SSD דומה לעלויות של דיסקים מתמידים מבוססי-SSD שהוקצו, והוא משתנה בהתאם לאזור.
HDD
סוג האחסון HDD מאפשר צפיפות אחסון משמעותית – 16 TB לכל צומת. החיסרון הוא שקריאות אקראיות איטיות משמעותית, ותומכות רק ב500 שורות שנקראות בשנייה לכל צומת. עדיף להשתמש ב-HDD לעומסי עבודה שכוללים הרבה פעולות כתיבה, שבהם פעולות הקריאה צפויות להיות סריקות טווח שמשויכות לעיבוד באצווה. התמחור של אחסון ב-HDD דומה לעלות שמשויכת ל-Cloud Storage, והוא משתנה בהתאם לאזור.
שיקולים לגבי גודל האשכול
כשמתאימים את הגודל של מופע Bigtable כדי להתכונן להעברת עומס עבודה של Cassandra, יש כמה שיקולים בהשוואה בין אשכולות Cassandra של מרכז נתונים יחיד לבין מופעי Bigtable של אשכול יחיד, ובין אשכולות Cassandra של כמה מרכזי נתונים לבין מופעי Bigtable של כמה אשכולות. ההנחיות בקטעים הבאים מבוססות על ההנחה שלא נדרשים שינויים משמעותיים במודל הנתונים לצורך ההעברה, ושיש דחיסת אחסון מקבילה בין Cassandra ל-Bigtable.
אשכול של מרכז נתונים אחד
כשמשווים בין אשכול במרכז נתונים יחיד לבין מכונה של Bigtable עם אשכול יחיד, קודם כל צריך להביא בחשבון את דרישות האחסון. כדי להעריך את הגודל של כל מרחב מפתחות ללא רפליקציה, אפשר להשתמש בפקודה nodetool tablestats ולחלק את נפח האחסון הכולל שנמחק בפקטור הרפליקציה של מרחב המפתחות. לאחר מכן, מחלקים את נפח האחסון ללא שכפול של כל מרחבי המפתחות ב-3.5TB (5TB * .70) כדי לקבוע את המספר המוצע של צומתי SSD לטיפול באחסון בלבד. כמו שצוין, Bigtable מטפל בשכפול ובאמינות של האחסון בשכבה נפרדת ששקופה למשתמש.
בשלב הבא, צריך להביא בחשבון את דרישות המחשוב למספר הצמתים. אפשר לעיין במדדים של אפליקציית הלקוח ושל שרת Cassandra כדי לקבל מספר משוער של פעולות קריאה וכתיבה מתמשכות שבוצעו. כדי להעריך את המספר המינימלי של צומתי SSD לביצוע עומס העבודה, מחלקים את המדד הזה ב-10,000. כנראה שתצטרכו יותר צמתים לאפליקציות שדורשות תוצאות של שאילתות עם זמן אחזור נמוך. Google ממליצה לבדוק את הביצועים של Bigtable עם נתונים ושאילתות מייצגים, כדי לקבוע מדד ל-QPS לכל צומת שאפשר להשיג בעומס העבודה שלכם.
מספר הצמתים שנדרשים לאשכול צריך להיות שווה לערך הגדול יותר מבין צורכי האחסון והחישוב. אם אתם לא בטוחים לגבי צורכי האחסון או התפוקה שלכם, אתם יכולים להתאים את מספר הצמתים של Bigtable למספר מכונות Cassandra טיפוסיות. אתם יכולים להגדיל או להקטין את הגודל של אשכול Bigtable בהתאם לצרכים של עומס העבודה, במינימום מאמץ וללא השבתה.
אשכול של כמה מרכזי נתונים
באשכולות עם כמה מרכזי נתונים, קשה יותר לקבוע את ההגדרות של מכונה ב-Bigtable. במצב אידיאלי, צריך שיהיה אשכול בכל מופע לכל מרכז נתונים בטופולוגיה של Cassandra. כל אשכול Bigtable במכונה צריך לאחסן את כל הנתונים במכונה, ולהיות מסוגל לטפל בקצב ההוספה הכולל בכל האשכול. אפשר ליצור אשכולות במופע בכל אזור נתמך בענן ברחבי העולם.
הטכניקה להערכת צורכי האחסון דומה לגישה שבה משתמשים באשכולות של מרכזי נתונים יחידים. אתם משתמשים ב-nodetool כדי לתעד את גודל האחסון של כל מרחב מפתחות באשכול Cassandra, ואז מחלקים את הגודל הזה במספר הרפליקות. חשוב לזכור שלמרחב המפתחות של טבלה יכולים להיות גורמי שכפול שונים לכל מרכז נתונים.
מספר הצמתים בכל אשכול במכונה צריך להיות מסוגל לטפל בכל פעולות הכתיבה באשכול ובכל פעולות הקריאה בשני מרכזי נתונים לפחות, כדי לשמור על יעדי רמת השירות (SLO) במהלך הפסקה זמנית בפעילות של האשכול. גישה נפוצה היא להתחיל עם כל האשכולות עם קיבולת צמתים ששווה לקיבולת של מרכז הנתונים העמוס ביותר באשכול Cassandra. אפשר להגדיל או להקטין את האשכולות של Bigtable במכונה בנפרד, בהתאם לצורכי עומס העבודה, בלי זמן השבתה.
ניהול
Bigtable מספק רכיבים שמנוהלים במלואם לפונקציות ניהול נפוצות שמבוצעות ב-Cassandra.
גיבוי ושחזור
יש שתי שיטות ב-Bigtable שמתאימות לצרכי גיבוי נפוצים: גיבויים ב-Bigtable וייצוא נתונים מנוהל.
אפשר לחשוב על הגיבויים של Bigtable כגרסה מנוהלת של תכונת תמונת המצב של nodetool ב-Cassandra. גיבויים של Bigtable יוצרים עותקים של טבלה שאפשר לשחזר, והם מאוחסנים כאובייקטים של חברים באשכול. אפשר לשחזר גיבויים כטבלה חדשה באשכול שבו נוצר הגיבוי. הגיבויים מיועדים ליצירת נקודות שחזור אם מתרחשת השחתה ברמת האפליקציה. גיבויים שיוצרים באמצעות כלי השירות הזה לא צורכים משאבי צומת, והתמחור שלהם זהה לתמחור של Cloud Storage או דומה לו. אפשר להפעיל גיבויים של Bigtable באופן פרוגרמטי או דרך מסוף Cloud de Confiance של Bigtable.
דרך נוספת לגבות את Bigtable היא להשתמש בייצוא נתונים מנוהל ל-Cloud Storage. אפשר לייצא לפורמטים Avro, Parquet או Hadoop Sequence. בהשוואה לגיבויים של Bigtable, הייצוא נמשך זמן רב יותר וגורם לעלויות מחשוב נוספות כי הייצוא משתמש ב-Dataflow. עם זאת, הייצוא הזה יוצר קובצי נתונים ניידים שאפשר לשלוח אליהם שאילתות אופליין או לייבא אותם למערכת אחרת.
שינוי הגודל
מכיוון שב-Bigtable האחסון והמחשוב מופרדים, אפשר להוסיף או להסיר צמתים של Bigtable בתגובה לביקוש של שאילתות בצורה חלקה יותר מאשר ב-Cassandra. בארכיטקטורה ההומוגנית של Cassandra צריך לאזן מחדש את הצמתים (או הצמתים הווירטואליים) בין המכונות באשכול.
אפשר לשנות את גודל האשכול באופן ידני במסוף Cloud de Confiance או באופן פרוגרמטי באמצעות Cloud Bigtable API. הוספת צמתים לאשכול יכולה להניב שיפורים משמעותיים בביצועים תוך דקות. חלק מהלקוחות השתמשו בהצלחה במידרוג אוטומטי בקוד פתוח שפותח על ידי Spotify.
תחזוקה פנימית
שירות Bigtable מטפל בצורה חלקה במשימות נפוצות של תחזוקה פנימית של Cassandra, כמו תיקון של מערכת ההפעלה, שחזור צמתים, תיקון צמתים, ניטור של דחיסת אחסון ורוטציה של אישורי SSL.
מעקב
כדי לחבר את Bigtable להצגת מדדים או להתראות, לא צריך להשקיע מאמץ בניהול או בפיתוח. בדף של Bigtable במסוףCloud de Confiance יש מרכזי בקרה מוכנים מראש למעקב אחרי מדדי התפוקה והניצול ברמות המכונה, האשכול והטבלה. אפשר ליצור תצוגות והתראות בהתאמה אישית בלוחות הבקרה של Cloud Monitoring, שבהם המדדים זמינים באופן אוטומטי.
Key Visualizer של Bigtable הוא תכונת מעקב במסוף Cloud de Confiance שמאפשרת לכם לבצע כוונון מתקדם של הביצועים.
IAM ואבטחה
ב-Bigtable, ההרשאה משולבת באופן מלא במסגרת ה-IAM שלCloud de Confiance, ודורשת הגדרה ותחזוקה מינימליות. חשבונות משתמשים מקומיים וסיסמאות לא משותפים עם אפליקציות לקוח. במקום זאת, הרשאות ותפקידים מפורטים ניתנים למשתמשים ברמת הארגון ולחשבונות שירות.
ב-Bigtable כל הנתונים מוצפנים באופן אוטומטי גם כשהם באחסון וגם כשהם מועברים. אין אפשרות להשבית את התכונות האלה. כל הרשאות האדמין מתועדות ביומן באופן מלא. אתם יכולים להשתמש ב-VPC Service Controls כדי לשלוט בגישה למכונות של Bigtable מחוץ לרשתות שאושרו.
המאמרים הבאים
- מידע נוסף על עיצוב סכימות ב-Bigtable
- מידע נוסף על Apache Cassandra
- נסו את ה-Codelab של Bigtable למשתמשי Cassandra.
- מידע על אמולטור Bigtable
- כדאי להעמיק את הקריאה ולהכיר דוגמאות לארכיטקטורות, תרשימים ושיטות מומלצות בנושאי Google Cloud. כל אלה זמינים במרכז הארכיטקטורה של Cloud.