

Ringkasan Bigtable
Bigtable adalah tabel yang jarang diisi data dan dapat diskalakan hingga miliaran baris dan ribuan kolom, sehingga Anda dapat menyimpan data berukuran terabyte atau bahkan petabyte. Bigtable cocok untuk menyimpan data dengan satu kunci dalam jumlah besar dengan latensi rendah. Bigtable mendukung throughput baca dan tulis yang tinggi pada latensi rendah, serta merupakan sumber data yang ideal untuk operasi MapReduce.
Bigtable diekspos ke aplikasi melalui beberapa library klien, termasuk ekstensi yang didukung ke library Apache HBase untuk Java. Oleh karena itu, Dataproc terintegrasi dengan ekosistem Apache yang ada untuk software big data open source.
Server backend Bigtable yang andal menawarkan beberapa keunggulan utama:
- Skalabilitas yang luar biasa. Bigtable menskalakan dalam proporsi langsung dengan jumlah mesin di cluster Anda. Penginstalan HBase yang dikelola sendiri memiliki hambatan desain yang membatasi performa setelah batas tertentu tercapai. Bigtable tidak memiliki hambatan ini, sehingga Anda dapat meningkatkan skala cluster untuk menangani lebih banyak operasi baca dan tulis.
- Administrasi yang sederhana. Bigtable menangani upgrade dan memulai ulang secara transparan, serta secara otomatis mempertahankan daya tahan data yang tinggi. Untuk mereplikasi data, tambahkan cluster kedua ke instance Anda, dan replikasi akan dimulai secara otomatis. Tidak perlu lagi mengelola replika atau region; cukup desain skema tabel Anda, dan Bigtable akan menangani sisanya untuk Anda.
- Pengubahan ukuran cluster tanpa periode nonaktif. Anda dapat meningkatkan ukuran cluster Bigtable selama beberapa jam untuk menangani beban besar, lalu mengurangi ukuran cluster lagi—semuanya tanpa periode nonaktif. Setelah Anda mengubah ukuran cluster, biasanya hanya perlu waktu beberapa menit saat beban agar Bigtable menyeimbangkan performa di semua node dalam cluster Anda.
- Penskalaan otomatis. Anda dapat mengonfigurasi Bigtable untuk terus-menerus memantau kapasitas CPU cluster dan menyesuaikan jumlah node dalam cluster secara otomatis jika diperlukan.
- Uji coba gratis. Anda dapat menjelajahi fitur dan kemampuan Bigtable tanpa biaya selama 10 hari, dengan opsi untuk memperpanjang uji coba gratis hingga 90 hari. Bigtable menyediakan instance Bigtable uji coba gratis dengan penyimpanan SSD hingga 500 GB dan cluster 1 node, sehingga Anda dapat menguji performa aplikasi dengan menjalankan operasi baca dan tulis bervolume tinggi terhadap tabel Bigtable untuk melihat cara Bigtable menangani operasi dengan performa yang didukung SSD.
Efektif untuk
Bigtable sangat cocok untuk aplikasi yang memerlukan throughput tinggi dan skalabilitas untuk data kunci-nilai, dengan setiap nilai biasanya tidak lebih besar dari 10 MB. Bigtable juga unggul sebagai mesin penyimpanan untuk operasi MapReduce batch, stream processing/analisis, dan aplikasi machine learning.
Anda dapat menggunakan Bigtable untuk menyimpan dan mengkueri semua jenis data berikut:
- Data deret waktu, seperti penggunaan CPU dan memori dari waktu ke waktu untuk beberapa server.
- Data pemasaran, seperti histori pembelian dan preferensi pelanggan.
- Data keuangan, seperti histori transaksi, harga saham, dan nilai tukar mata uang.
- Data Internet of Things, seperti laporan penggunaan dari meteran energi dan peralatan rumah tangga.
- Data grafik, seperti informasi tentang cara pengguna terhubung dengan satu sama lain.
Model penyimpanan Bigtable
Bigtable menyimpan data dalam tabel yang sangat skalabel, yang masing-masing merupakan peta nilai kunci yang diurutkan. Tabel terdiri dari baris, yang masing-masing biasanya menggambarkan satu entity, dan kolom, yang berisi nilai individu untuk setiap baris. Satu nilai di setiap baris diindeks. Nilai ini dikenal sebagai row key. Kolom yang terkait satu sama lain biasanya dikelompokkan ke dalam grup kolom. Setiap kolom diidentifikasi dengan kombinasi grup kolom dan penentu kolom, yang merupakan nama unik dalam grup kolom.
Setiap persimpangan baris dan kolom dapat berisi beberapa sel. Setiap sel berisi versi data yang diberi stempel waktu unik untuk baris dan kolom tersebut. Menyimpan beberapa sel dalam kolom memberikan catatan tentang bagaimana data yang disimpan untuk baris dan kolom tersebut telah berubah dari waktu ke waktu. Tabel Bigtable bersifat renggang; jika kolom tidak digunakan dalam baris tertentu, kolom tidak memakan ruang apa pun.
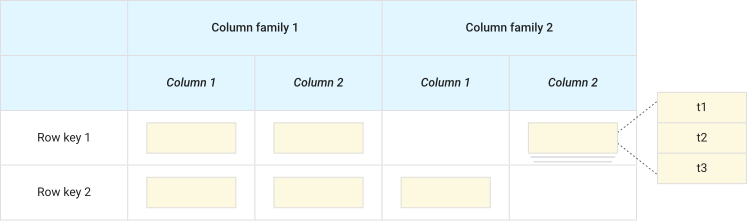
Beberapa hal yang perlu diperhatikan dalam ilustrasi ini:
- Kolom dapat tidak digunakan dalam baris.
- Setiap sel dalam baris dan kolom tertentu memiliki stempel waktu (t) yang unik.
Arsitektur Bigtable
Diagram berikut menunjukkan versi sederhana dari arsitektur resource keseluruhan Bigtable:
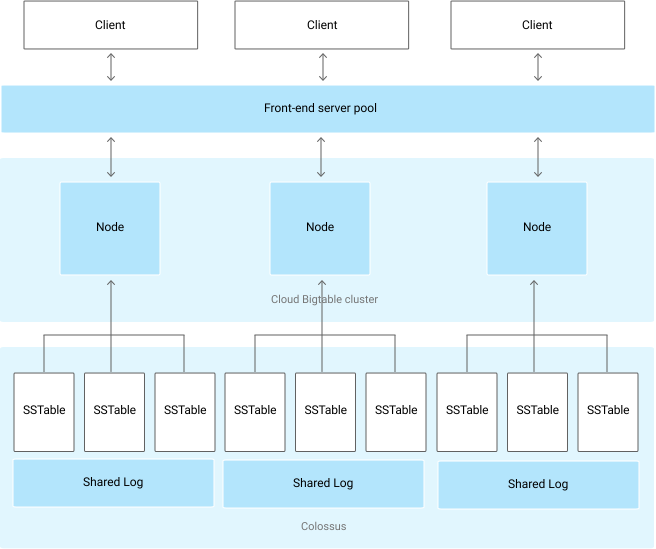
Seperti yang diilustrasikan dalam diagram, semua permintaan klien melewati server frontend sebelum dikirim ke node Bigtable. (Dalam makalah Bigtable asli, node ini disebut "server tablet".) Node diatur ke dalam cluster Bigtable, yang merupakan bagian dari instance Bigtable, yaitu container untuk cluster.
Setiap node dalam cluster menangani sebagian kecil permintaan ke cluster. Dengan menambahkan node ke cluster, Anda dapat meningkatkan jumlah permintaan serentak yang dapat ditangani cluster. Menambahkan node juga meningkatkan throughput maksimum untuk cluster. Jika mengaktifkan replikasi dengan menambahkan cluster lain, Anda juga dapat mengirim berbagai jenis traffic ke cluster yang berbeda. Kemudian, jika satu cluster tidak tersedia, Anda dapat melakukan failover ke cluster lain.
Tabel Bigtable di-sharding menjadi blok baris yang berdekatan, yang disebut tablet, untuk membantu menyeimbangkan beban kerja kueri. (Tablet mirip dengan region HBase.) Tablet disimpan di Colossus, sistem file yang dikembangkan Google, dalam format SSTable. SSTable menyediakan peta persisten yang tersusun dan tidak dapat diubah dari kunci ke nilai, di mana kunci dan nilai adalah string byte arbitrer. Setiap tablet dikaitkan dengan node Bigtable tertentu. Selain file SSTable, semua penulisan disimpan dalam log bersama Colossus segera setelah dikonfirmasi oleh Bigtable, sehingga memberikan peningkatan daya tahan.
Yang penting, data tidak pernah disimpan di node Bigtable itu sendiri; setiap node memiliki pointer ke sekumpulan tablet yang disimpan di Colossus. Akibatnya:
- Penyeimbangan ulang tablet dari satu node ke node lain terjadi dengan cepat, karena data sebenarnya tidak disalin. Bigtable memperbarui penunjuk untuk setiap node.
- Pemulihan dari kegagalan node Bigtable berlangsung cepat, karena hanya metadata yang harus dimigrasikan ke node pengganti.
- Jika node Bigtable gagal, tidak ada data yang hilang.
Untuk mengetahui informasi selengkapnya tentang cara menggunakan elemen penyusun mendasar ini, lihat Instance, cluster, dan node. Untuk mengetahui detail tentang cara berinteraksi dengan data Anda di seluruh tingkat ini, lihat Mengakses data.
Load balancing
Setiap zona Bigtable dikelola oleh proses utama, yang menyeimbangkan workload dan volume data dalam cluster. Proses ini membagi dua tablet yang lebih sibuk atau lebih besar dan menggabungkan tablet yang lebih jarang diakses/lebih kecil, serta mendistribusikannya kembali di antara node sesuai kebutuhan. Jika tablet tertentu mengalami lonjakan traffic, Bigtable akan membagi tablet tersebut menjadi dua, lalu memindahkan salah satu tablet baru ke node lain. Bigtable mengelola pemisahan, penggabungan, dan penyeimbangan ulang secara otomatis, sehingga Anda tidak perlu berupaya mengelola tablet secara manual. Memahami performa memberikan detail lebih lanjut tentang proses ini.
Untuk mendapatkan performa penulisan terbaik dari Bigtable, penting untuk mendistribusikan penulisan secara merata di seluruh node. Salah satu cara untuk mencapai tujuan ini adalah dengan menggunakan kunci baris yang tidak mengikuti urutan yang dapat diprediksi. Misalnya, nama pengguna cenderung didistribusikan secara merata di seluruh alfabet, sehingga menyertakan nama pengguna di awal row key akan cenderung mendistribusikan penulisan secara merata.
Pada saat yang sama, akan berguna untuk mengelompokkan baris terkait sehingga baris tersebut bersebelahan, yang membuat pembacaan beberapa baris secara bersamaan menjadi jauh lebih efisien. Misalnya, jika Anda menyimpan berbagai jenis data cuaca dari waktu ke waktu, row key Anda mungkin berupa lokasi tempat data dikumpulkan, diikuti dengan stempel waktu (misalnya, WashingtonDC#201803061617). Jenis row key ini akan mengelompokkan semua data dari satu lokasi ke dalam rentang baris yang berdekatan. Untuk
lokasi lain, baris akan dimulai dengan ID yang berbeda; dengan banyak
lokasi yang mengumpulkan data pada kecepatan yang sama, penulisan akan tetap didistribusikan secara merata
di seluruh tablet.
Lihat Memilih kunci baris untuk mengetahui detail selengkapnya tentang cara memilih kunci baris yang sesuai untuk data Anda.
Jenis data yang didukung
Bigtable memperlakukan semua data sebagai string byte mentah untuk sebagian besar tujuan. Satu-satunya saat Bigtable mencoba menentukan jenisnya adalah untuk operasi penambahan, dengan target harus berupa bilangan bulat 64-bit yang dienkode sebagai nilai big-endian 8 byte.
Penggunaan memori dan disk
Bagian berikut menjelaskan pengaruh beberapa komponen Bigtable terhadap penggunaan memori dan disk untuk instance Anda.
Kolom yang tidak digunakan
Kolom yang tidak digunakan dalam baris Bigtable tidak menggunakan ruang apa pun dalam baris tersebut. Setiap baris pada dasarnya adalah kumpulan entri key-value, dengan kunci berupa kombinasi grup kolom, penentu kolom, dan stempel waktu. Jika baris tidak menyertakan nilai untuk kolom tertentu, entri nilai kunci tidak ada.
Penentu kolom
Penentu kolom menggunakan ruang dalam baris, karena setiap penentu kolom yang digunakan dalam baris disimpan dalam baris tersebut. Oleh karena itu, sering kali lebih efisien menggunakan penentu kolom sebagai data.
Untuk mengetahui informasi selengkapnya tentang penentu kolom, lihat Kolom.
Pemadatan
Bigtable secara berkala menulis ulang tabel Anda untuk menghapus entri yang dihapus, dan untuk mengatur ulang data Anda sehingga pembacaan dan penulisan menjadi lebih efisien. Proses ini dikenal sebagai pemadatan. Tidak ada setelan konfigurasi untuk pemadatan— Bigtable memadatkan data Anda secara otomatis. Rata-rata, pemadatan memerlukan waktu satu minggu untuk diselesaikan dan menjalankan tugas seperti penghapusan data.Pemadatan melakukan penghapusan yang diidentifikasi oleh proses pembersihan sampah memori. Untuk mengetahui informasi selengkapnya, lihat Pengumpulan sampah.
Mutasi dan penghapusan
Mutasi, atau perubahan, pada baris memerlukan ruang penyimpanan tambahan, karena Bigtable menyimpan mutasi secara berurutan dan memadatkan mutasi hanya secara berkala. Saat memadatkan tabel, Bigtable akan menghapus nilai yang tidak lagi diperlukan. Jika Anda memperbarui nilai dalam sel, nilai asli dan nilai baru akan disimpan di disk selama beberapa waktu hingga data dipadatkan.
Penghapusan juga menggunakan ruang penyimpanan tambahan, setidaknya dalam jangka pendek, karena penghapusan sebenarnya adalah jenis mutasi khusus. Hingga tabel dipadatkan, penghapusan menggunakan penyimpanan ekstra, bukan mengosongkan ruang.
Kompresi data
Bigtable mengompresi data Anda secara otomatis menggunakan algoritma cerdas. Anda tidak dapat mengonfigurasi setelan kompresi untuk tabel. Namun, penting untuk mengetahui cara menyimpan data agar dapat dikompresi secara efisien:
- Data acak tidak dapat dikompresi seefisien data berpola. Data berpola mencakup teks, seperti halaman yang sedang Anda baca saat ini.
- Kompresi berfungsi paling baik jika nilai yang identik berdekatan, baik dalam baris yang sama atau dalam baris yang berdekatan. Jika Anda mengatur kunci baris sehingga baris dengan potongan data yang identik saling berdekatan, data dapat dikompresi secara efisien.
- Bigtable mengompresi nilai yang berukuran hingga 1 MiB. Jika Anda menyimpan nilai yang lebih besar dari 1 MiB, kompres nilai tersebut sebelum menulisnya ke Bigtable, sehingga Anda dapat menghemat siklus CPU, memori server, dan bandwidth jaringan.
Ketahanan data
Saat Anda menggunakan Bigtable, data Anda disimpan di Colossus, sistem file yang sangat andal dan dikembangkan oleh Google, menggunakan perangkat penyimpanan di pusat dataCloud de Confiance by S3NS. Anda tidak perlu menjalankan cluster HDFS atau sistem file lainnya untuk menggunakan Bigtable. Di balik layar, Colossus menggunakan metode penyimpanan eksklusif untuk mencapai ketahanan data di luar yang disediakan oleh replikasi tiga arah HDFS standar.
Daya tahan ditingkatkan lebih lanjut saat menggunakan replikasi. Bigtable menyimpan salinan data Anda secara terpisah di lokasi yang Anda pilih untuk setiap cluster instance yang direplikasi.
Model konsistensi
Instance Bigtable cluster tunggal memberikan konsistensi kuat. Secara default, instance yang memiliki lebih dari satu cluster memberikan konsistensi pada akhirnya, tetapi untuk beberapa kasus penggunaan, instance tersebut dapat dikonfigurasi untuk memberikan konsistensi baca-tulis atau konsistensi kuat, bergantung pada setelan profil aplikasi dan beban kerja.
Keamanan
Akses ke tabel Bigtable Anda dikontrol oleh project Cloud de Confiance by S3NS dan peran Identity and Access Management (IAM) yang Anda tetapkan kepada pengguna. Misalnya, Anda dapat menetapkan peran IAM yang mencegah pengguna tertentu membaca dari tabel, menulis ke tabel, atau membuat instance baru. Jika seseorang tidak memiliki akses ke project Anda atau tidak memiliki peran IAM dengan izin yang sesuai untuk Bigtable, orang tersebut tidak dapat mengakses tabel Anda.
Anda dapat mengelola keamanan di tingkat project, instance, dan tabel. Bigtable tidak mendukung pembatasan keamanan tingkat baris, tingkat kolom, atau tingkat sel.Enkripsi
Secara default, semua data yang disimpan dalam Cloud de Confiance, termasuk data dalam tabel Bigtable, dienkripsi dalam penyimpanan menggunakan sistem pengelolaan kunci hasil hardening yang sama dengan yang kami gunakan untuk data terenkripsi kami sendiri.
Jika Anda menginginkan kontrol yang lebih besar atas kunci yang digunakan untuk mengenkripsi data Bigtable dalam penyimpanan, Anda dapat menggunakan kunci enkripsi yang dikelola pelanggan (CMEK).
Cadangan
Cadangan Bigtable memungkinkan Anda menyimpan salinan skema dan data tabel, lalu memulihkannya ke tabel baru di lain waktu. Dengan menggunakan cadangan, Anda dapat memulihkan ke tabel baru di region atau project mana pun tempat Anda memiliki instance Bigtable, terlepas dari lokasi tabel sumber.
Merutekan permintaan dengan profil aplikasi
Kebijakan perutean profil aplikasi memungkinkan Anda mengontrol cluster yang menangani permintaan masuk dari aplikasi Anda. Bigtable menawarkan jenis profil aplikasi berikut berdasarkan model komputasi yang digunakan:
Profil aplikasi standar: menggunakan node cluster yang disediakan untuk menangani permintaan. Kebijakan ini mendukung kebijakan pemilihan rute berikut:
Perutean cluster tunggal: mengirim semua permintaan ke satu cluster.
Perutean multi-cluster ke cluster mana pun: mengirim permintaan ke cluster terdekat yang tersedia dalam instance, baik di antara semua cluster atau grup cluster tertentu.
Profil aplikasi Data Boost: gunakan komputasi serverless, bukan node cluster untuk mengisolasi tugas baca dengan throughput tinggi dari traffic aplikasi inti Anda. Profil ini dibatasi untuk kebijakan perutean satu cluster.
Opsi penyimpanan dan database lainnya
Bigtable bukanlah database relasional tradisional. Kasus penggunaan tertentu mungkin lebih cocok untuk opsi database lain.
- Jika Anda memerlukan kueri interaktif dalam sistem pemrosesan analisis online (OLAP), pertimbangkan BigQuery.
Untuk mengetahui informasi selengkapnya tentang opsi database lainnya, lihat ringkasan layanan database. Cloud de Confiance by S3NS juga memiliki berbagai opsi penyimpanan.
Langkah berikutnya
- Pelajari perbedaan Bigtable di Cloud de Confiance dengan Google Cloud.
- Coba panduan memulai Bigtable menggunakan CLI
cbt, alat command line untuk Bigtable. - Pelajari instance, cluster, dan node Bigtable.
- Pelajari cara membuat instance Bigtable.
- Pelajari cara bermigrasi ke Bigtable.
- Pelajari library klien untuk Cloud Bigtable.
- Baca laporan OSDI asli tentang Bigtable.