

In dieser Anleitung wird gezeigt, wie Sie mit Managed Service for Apache Airflow einen Apache Airflow-DAG (gerichteter azyklischer Graph) erstellen, der einen Apache Hadoop-Wordcount-Job in einem Managed Service for Apache Spark-Cluster ausführt.
Ziele
- Greifen Sie auf Ihre Managed Airflow-Umgebung zu und verwenden Sie die Airflow-UI.
- Airflow-Umgebungsvariablen erstellen und aufrufen
- DAG mit nachfolgenden Aufgaben erstellen und ausführen:
- Erstellt einen Managed Service for Apache Spark-Cluster.
- Führt einen Apache Hadoop-Wordcount-Job im Cluster aus.
- Gibt die Ergebnisse der Wortzählung in einen Cloud Storage-Bucket aus.
- Löscht den Cluster.
Kosten
In diesem Dokument verwenden Sie die folgenden kostenpflichtigen Komponenten von Cloud de Confiance by S3NS:
- Managed Airflow
- Managed Service for Apache Spark
- Cloud Storage
Hinweis
Prüfen Sie, ob die folgenden APIs in Ihrem Projekt aktiviert sind:
Console
Aktivieren Sie die Managed Service for Apache Spark- und Cloud Storage-APIs, falls sie noch nicht aktiviert sind.
Rollen, die zum Aktivieren von APIs erforderlich sind
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Rolle „Inhaber“ (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollengcloud
Aktivieren Sie den Managed Service for Apache Spark und die Cloud Storage APIs, falls noch nicht geschehen:
Rollen, die zum Aktivieren von APIs erforderlich sind
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Rolle „Inhaber“ (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollengcloud services enable dataproc.googleapis.com
storage-component.googleapis.com Erstellen Sie in Ihrem Projekt einen Cloud Storage-Bucket mit einer beliebigen Speicherklasse und Region, um die Ergebnisse des Hadoop-WordCount-Jobs zu speichern.
Notieren Sie sich den Pfad des Buckets, den Sie erstellt haben, z. B.
gs://example-bucket. Im nächsten Schritt definieren Sie für diesen Pfad eine Airflow-Variable und verwenden sie im Beispiel-DAG.Managed Airflow-Umgebung mit Standardparametern erstellen Warten Sie, bis die Erstellung der Umgebung abgeschlossen ist. Wenn der Vorgang abgeschlossen ist, wird links neben dem Umgebungsnamen ein grünes Häkchen angezeigt.
Notieren Sie sich die Region, in der Sie Ihre Umgebung erstellt haben, z. B.
us-central. Im nächsten Schritt definieren Sie für diese Region eine Airflow-Variable und verwenden sie im Beispiel-DAG, um einen Managed Service for Apache Spark-Cluster in derselben Region auszuführen.
Airflow-Variablen festlegen
Airflow-Variablen festlegen, die später im Beispiel-DAG verwendet werden. Sie können beispielsweise Airflow-Variablen in der Airflow-Benutzeroberfläche festlegen.
| Airflow-Variable | Wert |
|---|---|
gcp_project
|
Die Projekt-ID des Projekts, das Sie für diese Anleitung verwenden, z. B. example-project. |
gcs_bucket
|
Der URI des Cloud Storage-Bucket, den Sie für diese Anleitung erstellt haben, z. B. gs://example-bucket |
gce_region
|
Die Region, in der Sie Ihre Umgebung erstellt haben, z. B. us-central1.
In dieser Region wird Ihr Managed Service for Apache Spark-Cluster erstellt. |
Beispielworkflow ansehen
Ein Airflow-DAG ist eine Sammlung organisierter Aufgaben, die Sie planen und ausführen möchten. DAGs werden in Standard-Python-Dateien definiert. Der Code in hadoop_tutorial.py ist der Workflowcode.
Operatoren
Zur Orchestrierung der drei Aufgaben im Beispielworkflow werden die folgenden drei Airflow-Operatoren für den DAG importiert:
DataprocClusterCreateOperator: Erstellt einen Managed Service for Apache Spark-Cluster.DataProcHadoopOperator: Sendet einen Hadoop-Job zum Zählen von Wörtern und schreibt die Ergebnisse in einen Cloud Storage-Bucket.DataprocClusterDeleteOperator: Löscht den Cluster, um laufende Gebühren für Compute Engine zu vermeiden.
Abhängigkeiten
Sie strukturieren die Aufgaben, die Sie ausführen möchten, so, dass die Struktur deren Beziehungen und Abhängigkeiten widerspiegelt. Die Aufgaben in diesem DAG werden sequenziell ausgeführt.
Planung
Der Name des DAG ist composer_hadoop_tutorial und der DAG wird einmal täglich ausgeführt. Da start_date, das an default_dag_args übergeben wird, auf yesterday festgelegt ist, plant Managed Airflow den Workflow so, dass er sofort nach dem Hochladen des DAG in den Bucket der Umgebung gestartet wird.
DAG in den Bucket der Umgebung hochladen
In Managed Airflow werden DAGs im Ordner /dags im Bucket Ihrer Umgebung gespeichert.
So laden Sie den DAG hoch:
Speichern Sie
hadoop_tutorial.pyauf Ihrem lokalen Computer.Rufen Sie in der Cloud de Confiance Console die Seite Umgebungen auf.
Klicken Sie in der Liste der Umgebungen in der Spalte DAGs-Ordner für Ihre Umgebung auf den Link DAGs.
Klicken Sie auf Dateien hochladen.
Wählen Sie
hadoop_tutorial.pyauf Ihrem lokalen Computer aus und klicken Sie auf Öffnen.
Managed Airflow fügt den DAG zu Airflow hinzu und plant ihn automatisch. DAG-Änderungen werden innerhalb von 3 bis 5 Minuten wirksam.
DAG-Ausführungen ansehen
Aufgabenstatus ansehen
Wenn Sie Ihre DAG-Datei in den Ordner dags/ in Cloud Storage hochladen, parst Managed Airflow die Datei. Wenn der Vorgang erfolgreich abgeschlossen wurde, wird der Name des Workflows in der DAG-Liste angezeigt und der Workflow wird in die Warteschlange gestellt, um sofort ausgeführt zu werden.
Rufen Sie zur Anzeige des Aufgabenstatus die Airflow-Weboberfläche auf und klicken Sie in der Symbolleiste auf DAGs.
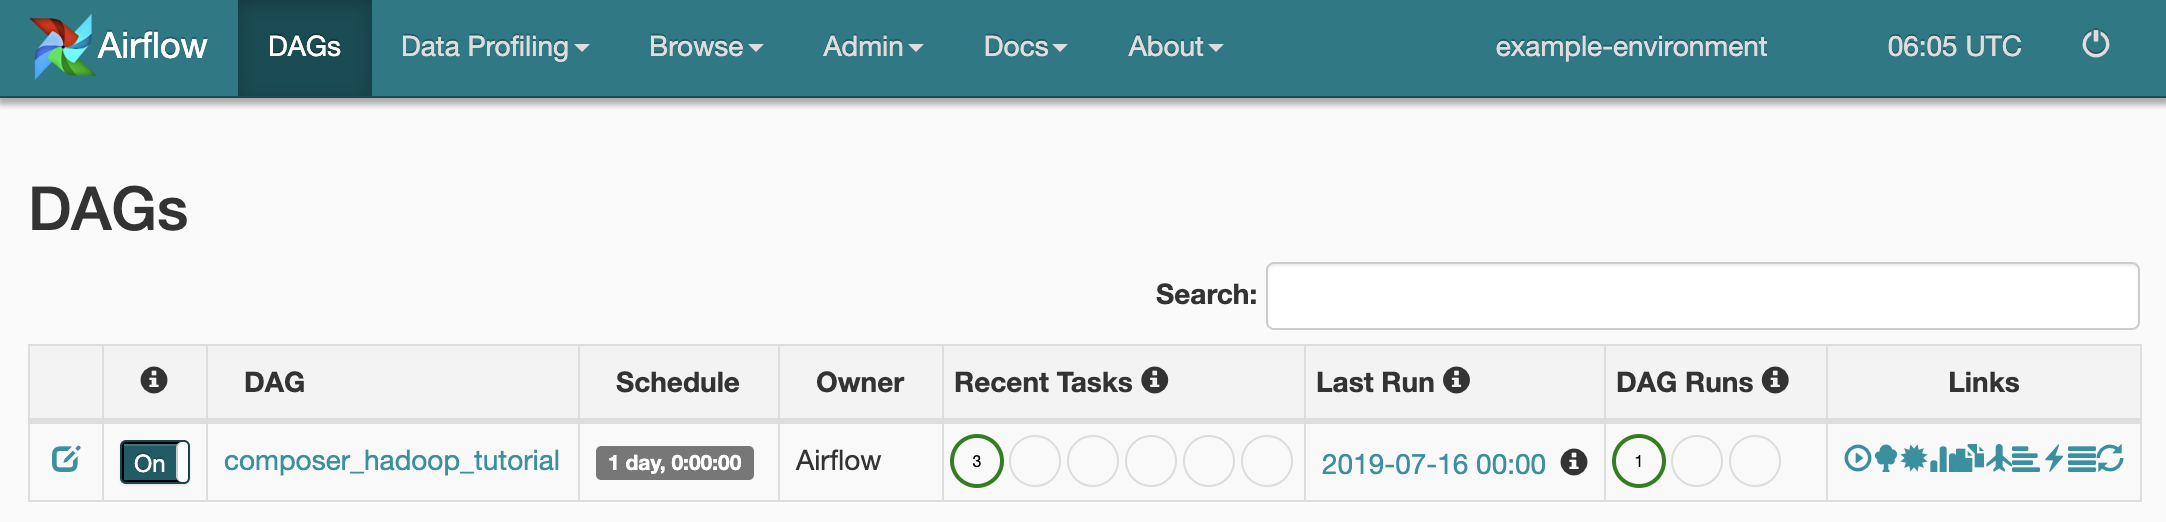
Klicken Sie zum Öffnen der DAG-Detailseite auf
composer_hadoop_tutorial. Sie enthält eine grafische Darstellung der Workflowaufgaben und ‑abhängigkeiten.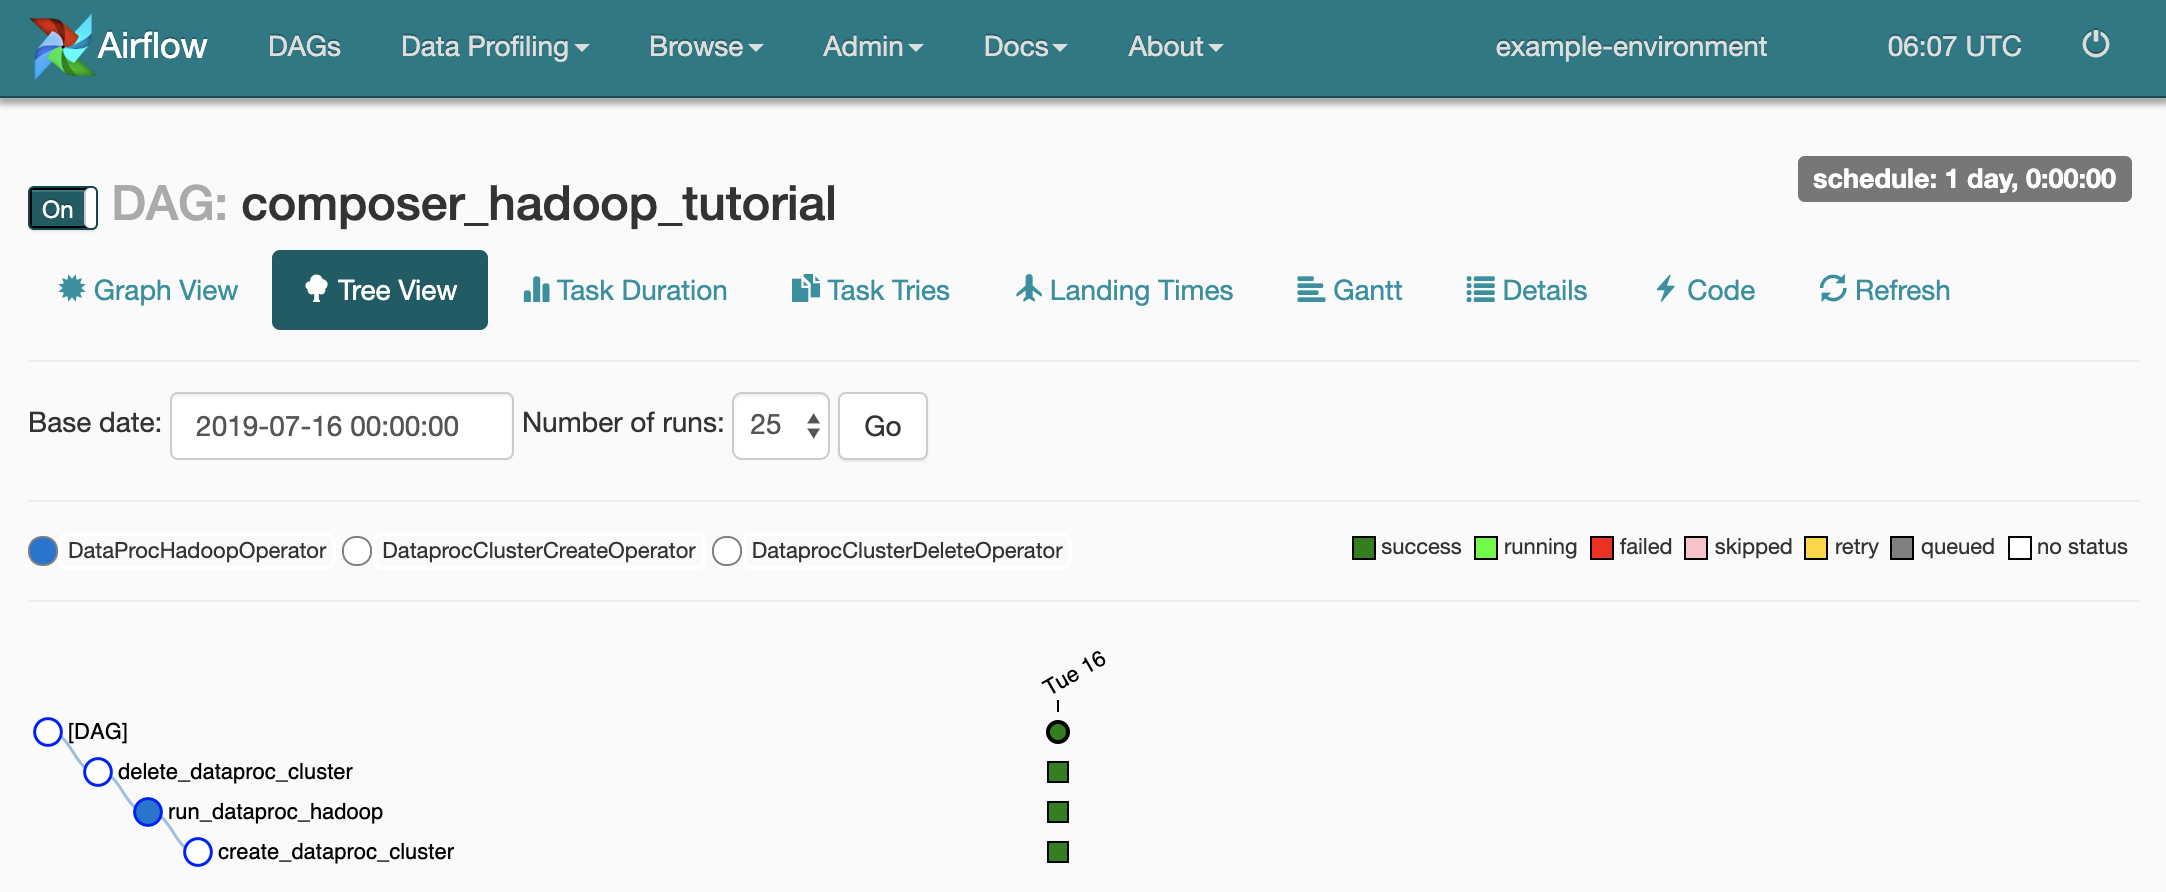
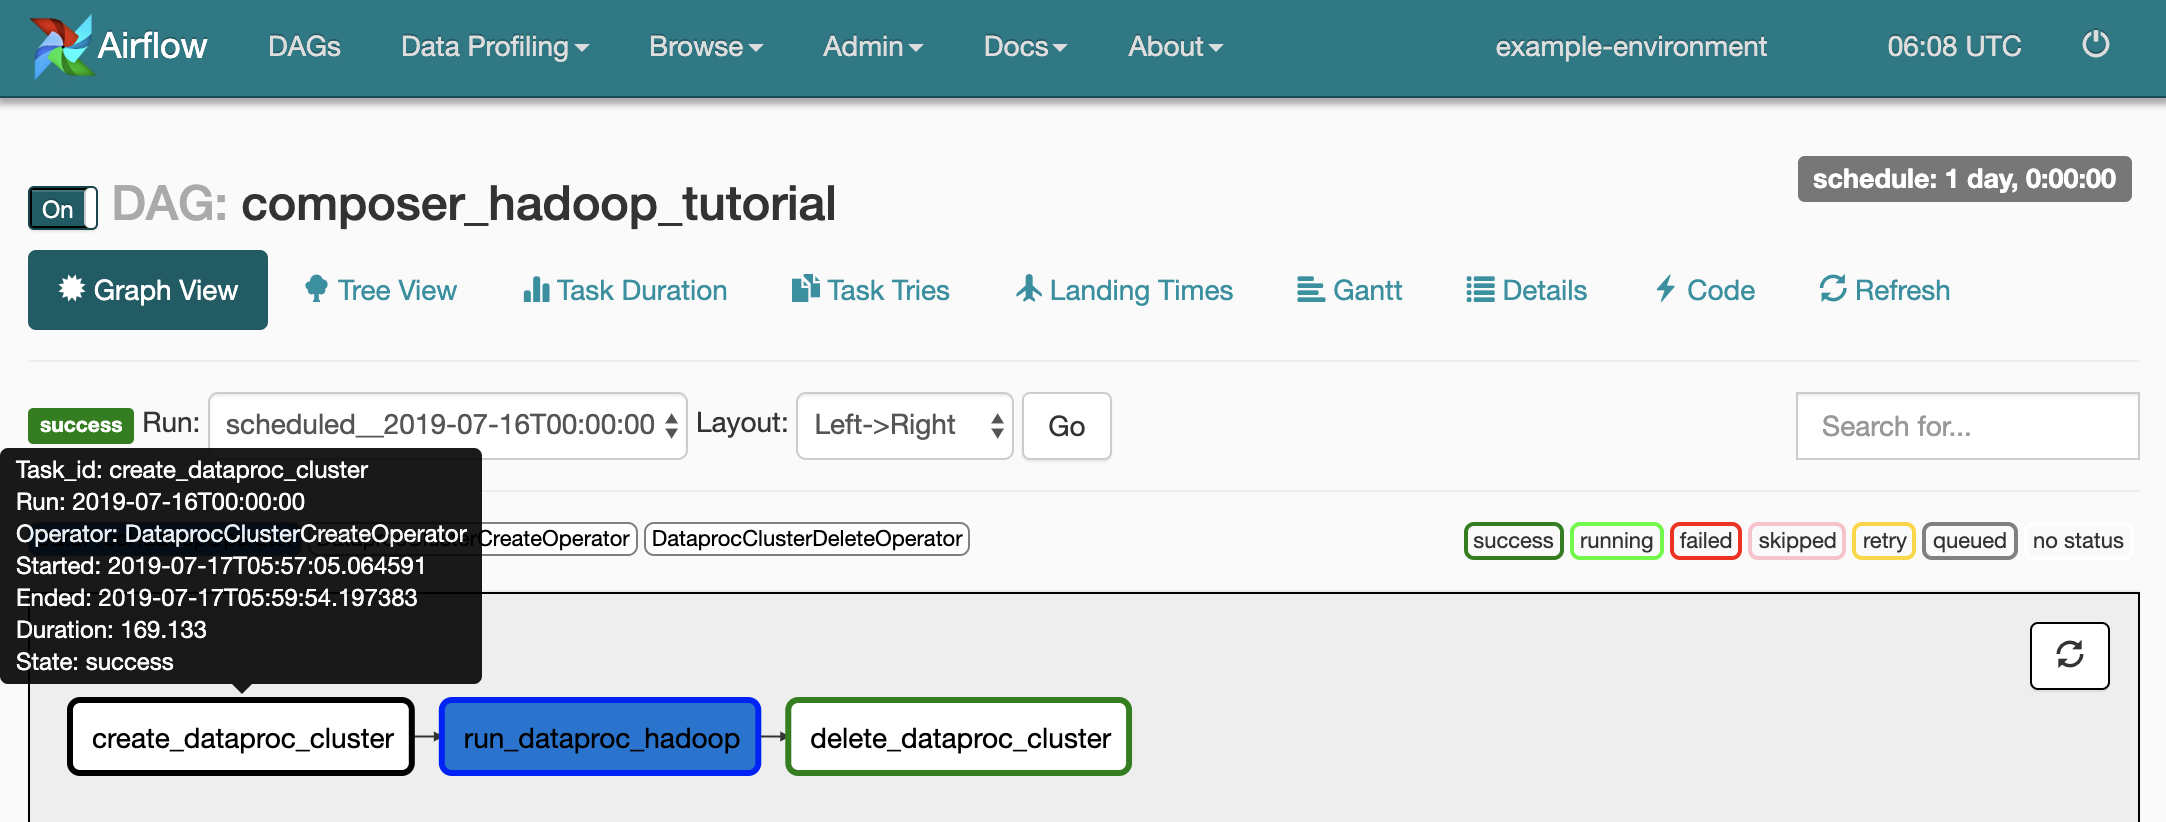
Klicken Sie zur Anzeige des Status jeder Aufgabe auf Graph View und bewegen Sie den Mauszeiger auf die Grafik für jede Aufgabe.
Workflow wieder in die Warteschlange stellen
So führen Sie den Workflow über die Grafikansicht noch einmal aus:
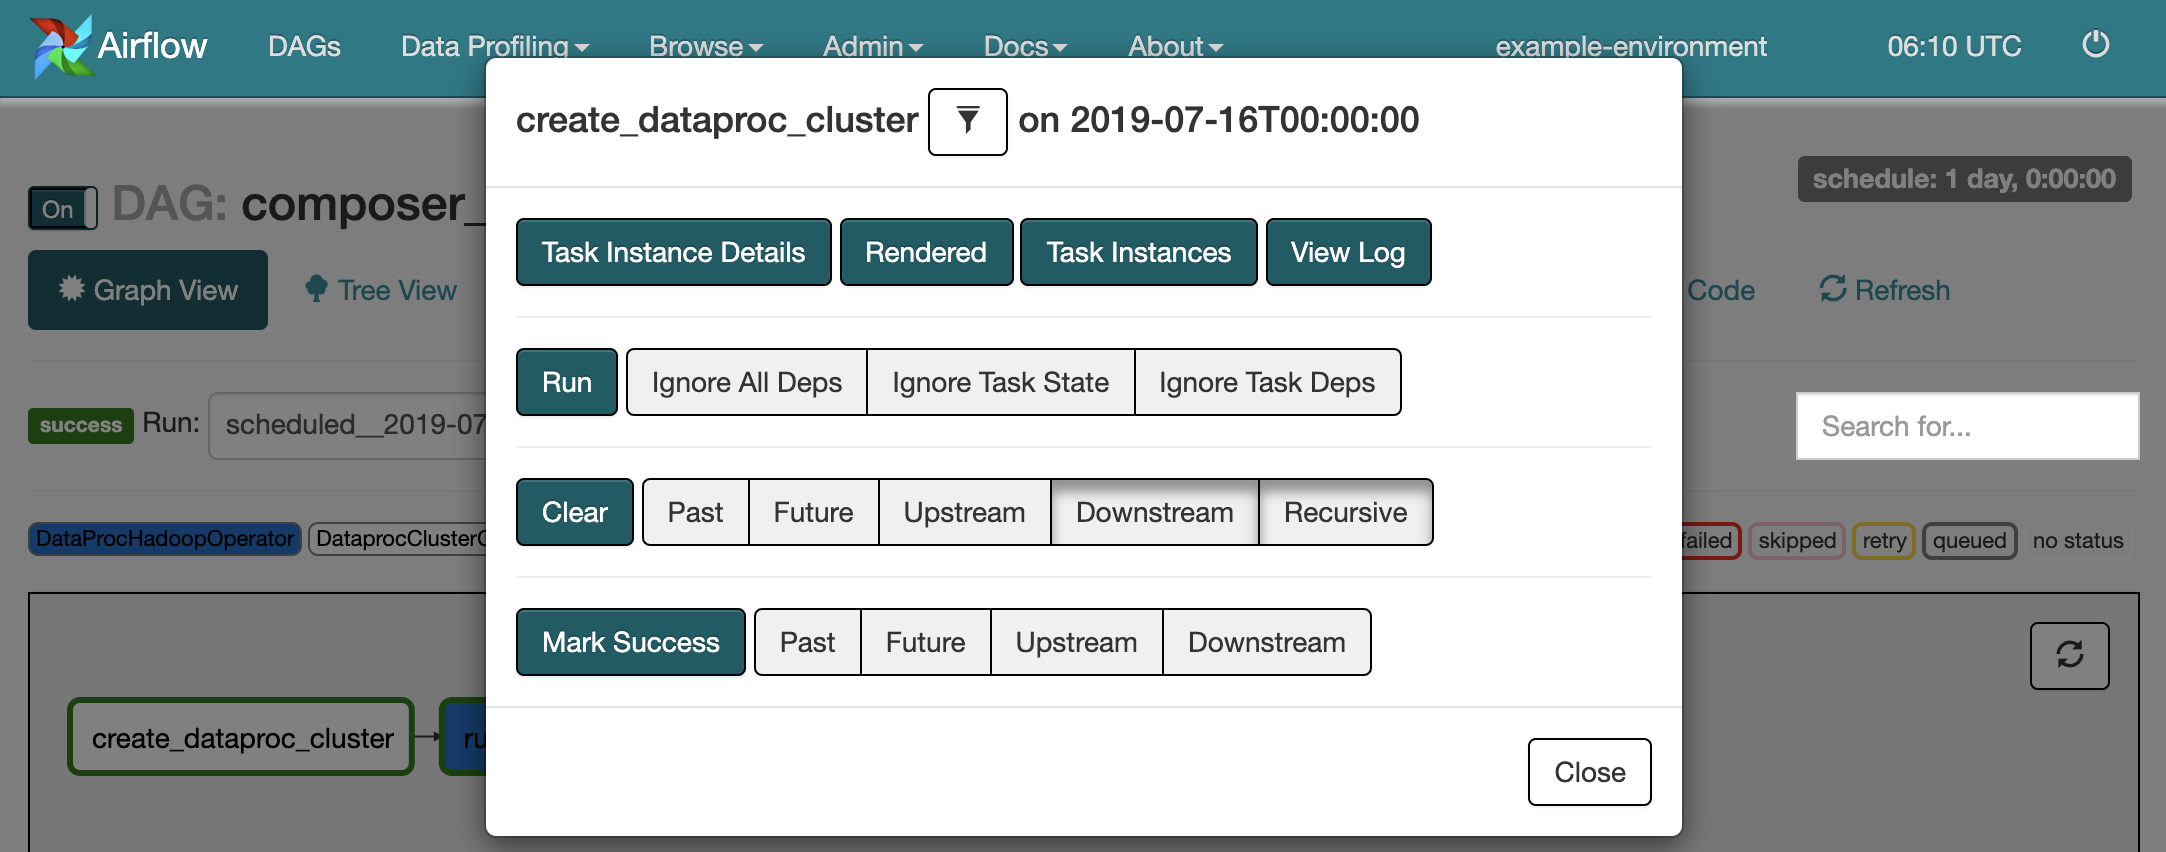
- Klicken Sie in der Grafikansicht der Airflow-Benutzeroberfläche auf die Grafik
create_dataproc_cluster. - Klicken Sie zum Zurücksetzen der drei Aufgaben auf Clear und anschließend auf OK.
- Klicken Sie in der Grafikansicht noch einmal auf
create_dataproc_cluster. - Zum nochmaligen Übergeben des Workflows an die Warteschlange klicken Sie auf Run.
Taskergebnisse ansehen
Sie können den Status und die Ergebnisse des composer_hadoop_tutorialWorkflows Cloud de Confiance auch auf den folgenden Konsolenseiten prüfen:
Managed Service for Apache Spark-Cluster: zum Überwachen der Clustererstellung und ‑löschung. Der vom Workflow erstellte Cluster ist temporär. Er ist nur für die Dauer des Workflows vorhanden und wird im Rahmen der letzten Workflowaufgabe gelöscht.
Managed Service for Apache Spark-Jobs zur Anzeige oder zum Monitoring eines Apache Hadoop-Wordcount-Jobs. Klicken Sie auf die Job-ID, um die Ausgabe des Job-Logs aufzurufen.
Cloud Storage-Browser: zur Anzeige der Ergebnisse der Wortzählung im Ordner
wordcountdes Cloud Storage-Bucket, den Sie für diese Anleitung erstellt haben.
Bereinigen
Löschen Sie die in dieser Anleitung verwendeten Ressourcen:
Löschen Sie die Managed Airflow-Umgebung, einschließlich des manuellen Löschens des Buckets der Umgebung.
Löschen Sie den Cloud Storage-Bucket, in dem die Ergebnisse des Hadoop-Wordcount-Jobs gespeichert sind.