

חיפוש וקטורי תומך בחיפוש היברידי, שהוא דפוס ארכיטקטורה פופולרי באחזור מידע (IR) שמשלב בין חיפוש סמנטי לחיפוש מילות מפתח (שנקרא גם חיפוש מבוסס-טוקנים). חיפוש היברידי מאפשר למפתחים ליהנות מהיתרונות של שתי הגישות, וכך לשפר את איכות החיפוש.
בדף הזה מוסבר על המושגים של חיפוש היברידי, חיפוש סמנטי וחיפוש מבוסס-טוקנים, ומופיעות בו דוגמאות להגדרת חיפוש מבוסס-טוקנים וחיפוש היברידי:
- למה חשוב להשתמש בחיפוש היברידי?
- דוגמה: איך משתמשים בחיפוש מבוסס-טוקנים
- דוגמה: איך משתמשים בחיפוש היברידי
- איך מתחילים להשתמש בחיפוש היברידי
- מושגים נוספים
למה חשוב להשתמש בחיפוש היברידי?
כפי שמתואר במאמר סקירה כללית של Vector Search, חיפוש סמנטי באמצעות Vector Search יכול למצוא פריטים עם דמיון סמנטי באמצעות שאילתות.
מודלים של הטמעה כמו Gemini Enterprise Agent Platform
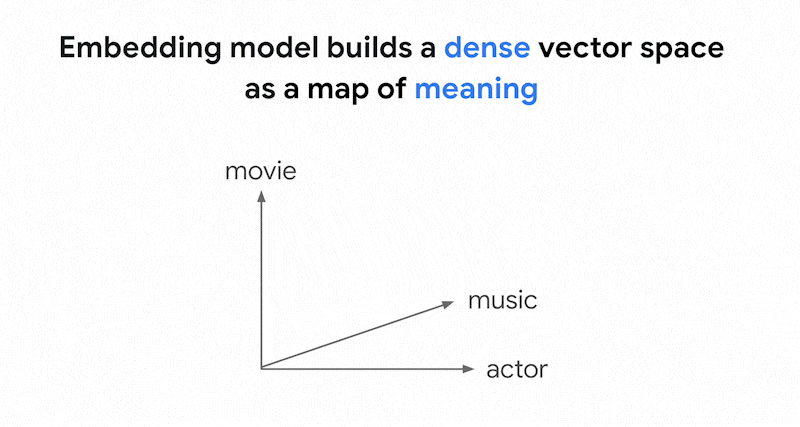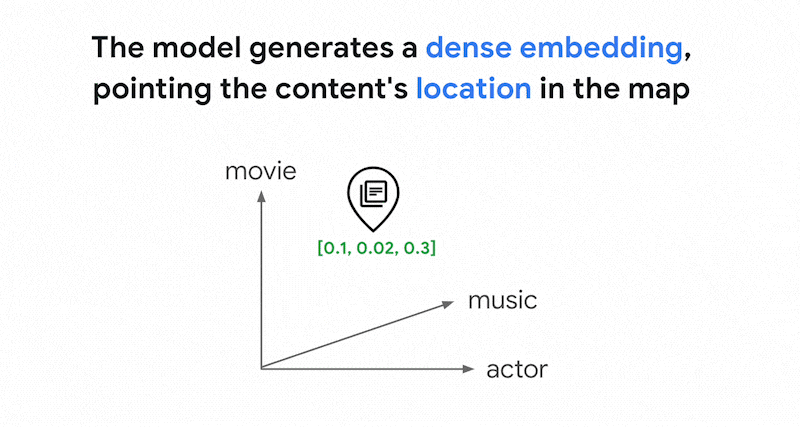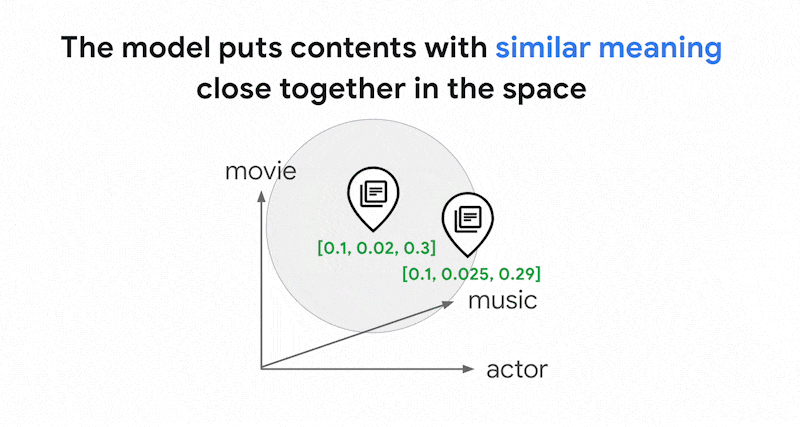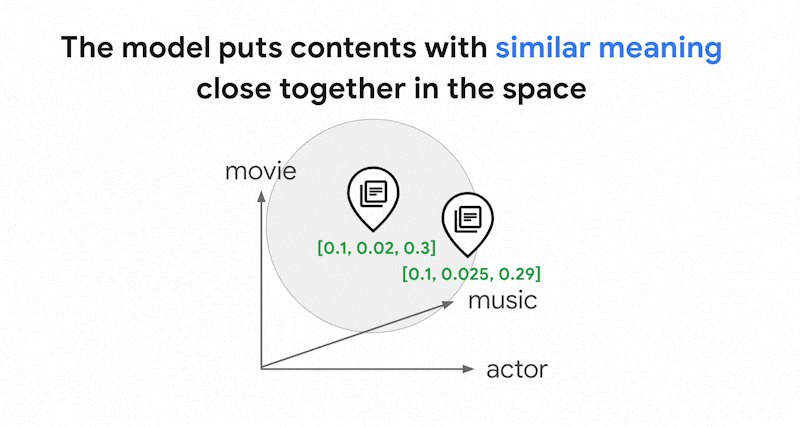
Embeddings יוצרים מרחב וקטורי כמפה של משמעויות התוכן. כל הטמעה של טקסט או של נתונים מרובי-אופנים היא מיקום במפה שמייצג את המשמעות של תוכן מסוים. לדוגמה, כשמודל הטמעה מקבל טקסט שדן בסרטים ב-10%, במוזיקה ב-2% ובשחקנים ב-30%, הוא יכול לייצג את הטקסט הזה באמצעות הטמעה [0.1, 0.02, 0.3]. באמצעות Vector Search, אפשר למצוא במהירות הטמעות אחרות בסביבה שלו. החיפוש הזה לפי משמעות התוכן נקרא חיפוש סמנטי.
חיפוש סמנטי עם הטמעות וחיפוש וקטורי יכולים לעזור להפוך מערכות IT לחכמות כמו ספרנים מנוסים או מוכרים בחנות. אפשר להשתמש בהטמעות כדי לקשר בין נתונים עסקיים שונים לבין המשמעויות שלהם. למשל, שאילתות ותוצאות חיפוש, טקסטים ותמונות, פעילויות משתמשים ומוצרים מומלצים, טקסטים באנגלית וטקסטים ביפנית, או נתוני חיישנים ותנאים להתרעה. היכולת הזו מאפשרת להשתמש בהטמעות במגוון רחב של תרחישי שימוש.
למה כדאי לשלב חיפוש סמנטי עם חיפוש מבוסס מילות מפתח?
חיפוש סמנטי לא מכסה את כל הדרישות האפשריות לאפליקציות לאחזור מידע, כמו יצירה משופרת באחזור (RAG). חיפוש סמנטי יכול למצוא רק נתונים שהמודל להטמעה יכול להבין. לדוגמה, שאילתות או מערכי נתונים עם מספרי מוצרים או מק"טים שרירותיים, שמות של מוצרים חדשים שנוספו לאחרונה ושמות קוד קנייניים של חברות לא פועלים עם חיפוש סמנטי כי הם לא נכללים במערך הנתונים של האימון של מודל ההטמעה. הנתונים האלה נקראים נתונים 'מחוץ לדומיין'.
במקרים כאלה, תצטרכו לשלב בין חיפוש סמנטי לבין חיפוש מבוסס מילות מפתח (שנקרא גם חיפוש מבוסס טוקנים) כדי ליצור חיפוש היברידי. חיפוש היברידי מאפשר לכם ליהנות מחיפוש סמנטי ומחיפוש מבוסס-טוקנים כדי להשיג איכות חיפוש גבוהה יותר.
אחת ממערכות החיפוש ההיברידיות הפופולריות ביותר היא חיפוש Google. השירות שילב חיפוש סמנטי בשנת 2015 עם מודל RankBrain, בנוסף לאלגוריתם החיפוש של מילות מפתח מבוסס-טוקנים. עם השקת החיפוש ההיברידי, חיפוש Google הצליח לשפר באופן משמעותי את איכות החיפוש על ידי מענה לשני הדרישות: חיפוש לפי משמעות וחיפוש לפי מילת מפתח.
בעבר, בניית מנוע חיפוש היברידי הייתה משימה מורכבת. בדומה לחיפוש Google, צריך ליצור ולהפעיל שני סוגים שונים של מנועי חיפוש (חיפוש סמנטי וחיפוש מבוסס-טוקנים), למזג את התוצאות שלהם ולדרג אותן. התמיכה בחיפוש היברידי בחיפוש וקטורי מאפשרת לכם לבנות מערכת חיפוש היברידית משלכם עם אינדקס חיפוש וקטורי יחיד, שמותאם לדרישות העסקיות שלכם.
איך פועל חיפוש מבוסס-טוקנים
איך עובד חיפוש מבוסס-טוקנים בחיפוש וקטורי? אחרי פיצול הטקסט לטוקנים (כמו מילים או חלקי מילים), אפשר להשתמש באלגוריתמים פופולריים של הטמעה דלילה כמו TF-IDF, BM25 או SPLADE כדי ליצור הטמעה דלילה של הטקסט.
הסבר פשוט על הטמעות דלילות הוא שהן וקטורים שמייצגים כמה פעמים כל מילה או חלק ממילה מופיעים בטקסט. הטמעה דלילה טיפוסית לא לוקחת בחשבון את הסמנטיקה של הטקסט.
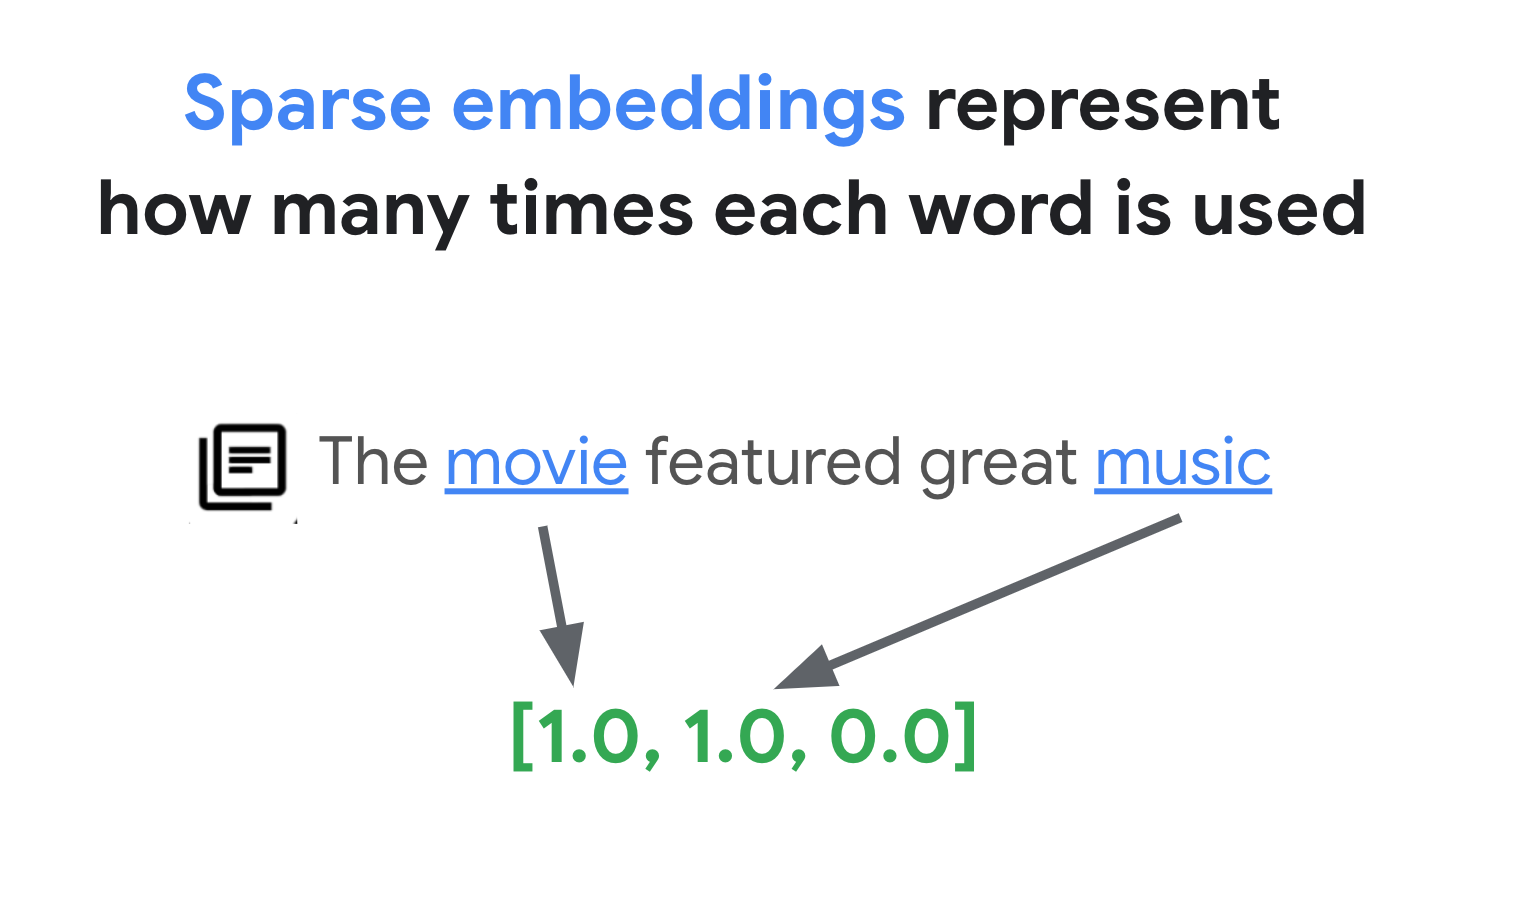
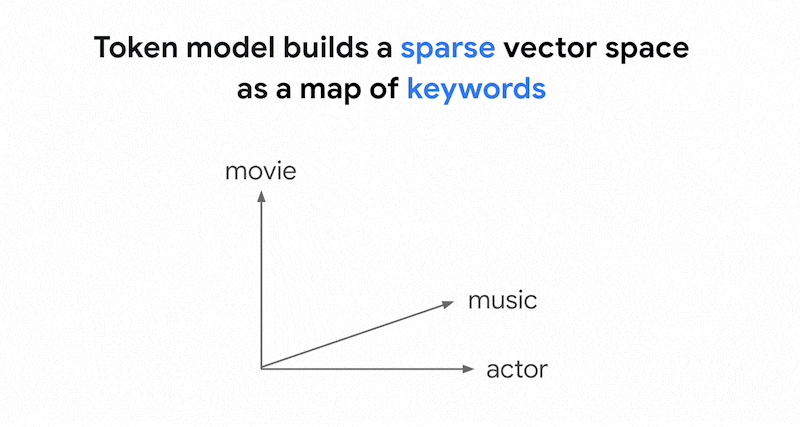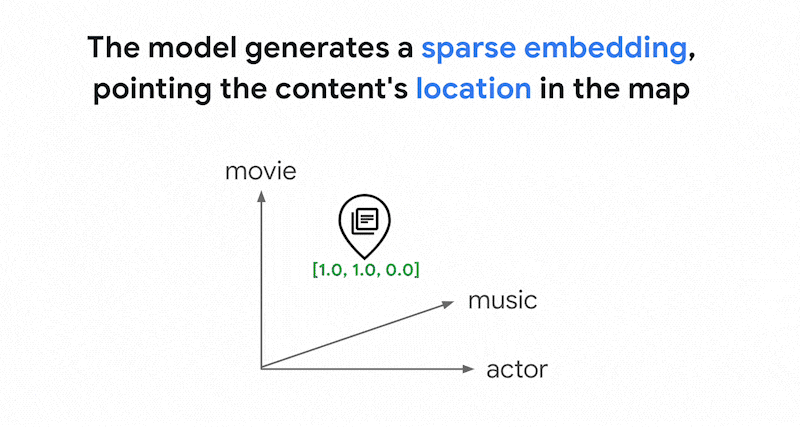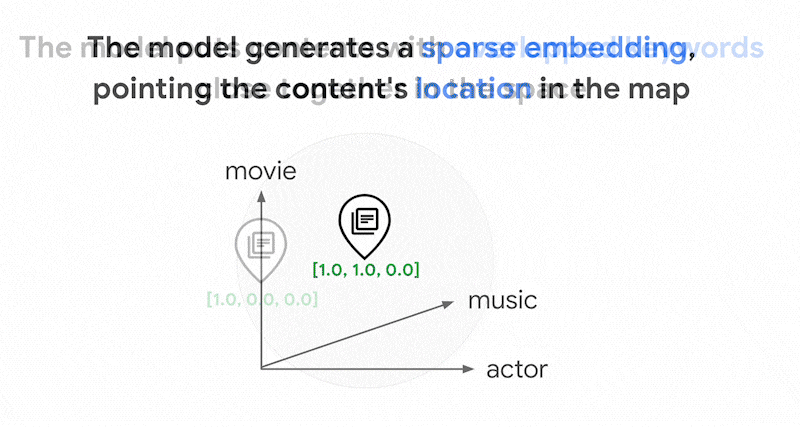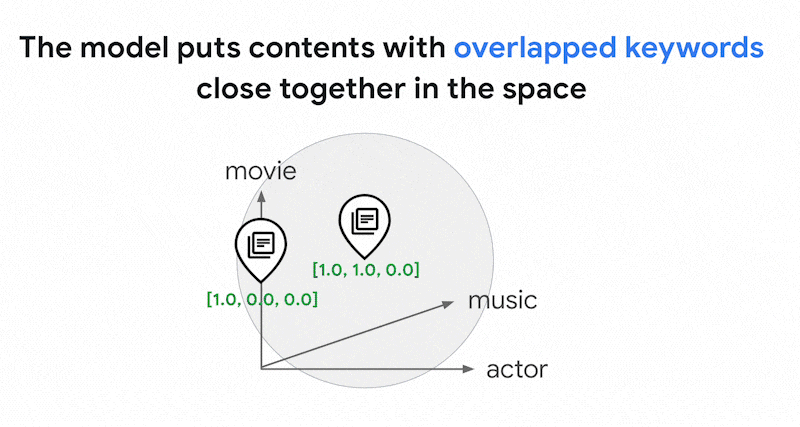
יכול להיות שמשתמשים באלפי מילים שונות בטקסטים. לכן, בדרך כלל יש להטמעה הזו עשרות אלפי מאפיינים, ורק למעט מאפיינים יש ערכים שאינם אפס. לכן הם נקראים הטמעות דלילות. רוב הערכים הם אפסים. מרחב ההטמעה הדליל הזה פועל כמו מפה של מילות מפתח, בדומה לאינדקס של ספרים.
במרחב ההטמעה הדליל הזה, אפשר למצוא הטמעות דומות על ידי בחינת הסביבה של הטמעת שאילתה. ההטמעות האלה דומות מבחינת הפיזור של מילות המפתח שמשמשות בטקסטים שלהן.
זהו המנגנון הבסיסי של חיפוש מבוסס-טוקנים עם הטמעות דלילות. בעזרת חיפוש היברידי ב-Vector Search, אפשר לשלב הטמעות צפופות ודלילות באינדקס וקטורי יחיד ולהריץ שאילתות עם הטמעות צפופות, הטמעות דלילות או שילוב של שתיהן. התוצאה היא שילוב של חיפוש סמנטי ותוצאות חיפוש מבוססות-טוקנים.
בנוסף, חיפוש היברידי מספק חביון נמוך יותר של שאילתות בהשוואה למנוע חיפוש מבוסס-טוקנים עם עיצוב של אינדקס הפוך. בדיוק כמו חיפוש וקטורי לחיפוש סמנטי, כל שאילתה עם הטמעות צפופות או דלילות מסתיימת תוך אלפיות שנייה, גם אם יש מיליוני או מיליארדי פריטים.
דוגמה: איך משתמשים בחיפוש מבוסס-טוקנים
כדי להסביר איך להשתמש בחיפוש מבוסס-טוקנים, בקטעים הבאים יש דוגמאות לקוד שיוצר הטבעות דלילות ובונה איתן אינדקס בחיפוש וקטורי.
כדי לנסות את דוגמת הקוד הזו, אפשר להשתמש במחברת: שילוב של חיפוש סמנטי וחיפוש מילות מפתח: מדריך לחיפוש היברידי עם Gemini Enterprise Agent Platform חיפוש וקטורי.
השלב הראשון הוא להכין קובץ נתונים כדי ליצור אינדקס להטמעות דלילות, על סמך פורמט הנתונים שמתואר במאמר פורמט ומבנה של נתוני קלט.
בקובץ הנתונים בפורמט JSON, הנתונים נראים כך:
{"id": "3", "sparse_embedding": {"values": [0.1, 0.2], "dimensions": [1, 4]}}
{"id": "4", "sparse_embedding": {"values": [-0.4, 0.2, -1.3], "dimensions": [10, 20, 30]}}
לכל פריט צריך להיות מאפיין sparse_embedding עם מאפיינים values ו-dimensions. להטמעות דלילות יש אלפי ממדים עם כמה ערכים שונים מאפס. פורמט הנתונים הזה יעיל כי הוא מכיל רק את הערכים ששונים מאפס, עם המיקומים שלהם במרחב.
הכנת מערך נתונים לדוגמה
כמערך נתונים לדוגמה, נשתמש במערך הנתונים של Google Merch Shop, שמכיל כ-200 שורות של מוצרים עם מיתוג Google.
0                          Google Sticker
1                    Google Cloud Sticker
2                       Android Black Pen
3                   Google Ombre Lime Pen
4                    For Everyone Eco Pen
                      ...
197        Google Recycled Black Backpack
198    Google Cascades Unisex Zip Sweater
199    Google Cascades Womens Zip Sweater
200         Google Cloud Skyline Backpack
201       Google City Black Tote Backpack
הכנה של וקטוריזציה של TF-IDF
בעזרת קבוצת הנתונים הזו, נאמן וקטוריזטור, מודל שיוצר הטמעות מפוזרות מטקסט. בדוגמה הזו נעשה שימוש ב-TfidfVectorizer ב-scikit-learn, שהוא וקטור בסיסי שמשתמש באלגוריתם TF-IDF.
from sklearn.feature_extraction.text import TfidfVectorizer

# Make a list of the item titles
corpus = df.title.tolist()

# Initialize TfidfVectorizer
vectorizer = TfidfVectorizer()

# Fit and Transform
vectorizer.fit_transform(corpus)
המשתנה corpus מכיל רשימה של 200 שמות פריטים, כמו Google Sticker או Chrome Dino Pin. לאחר מכן, הקוד מעביר אותם ל-Vectorizer על ידי קריאה לפונקציה fit_transform(). כך, ה-Vectorizer מוכן ליצור הטבעות דלילות.
הפונקציה TF-IDF vectorizer מנסה לתת משקל גבוה יותר למילים ייחודיות במערך הנתונים (כמו 'חולצות' או 'דינו') בהשוואה למילים טריוויאליות (כמו 'ה', 'a' או 'of'), וסופרת כמה פעמים המילים הייחודיות האלה משמשות במסמך שצוין. כל ערך של הטמעה דלילה מייצג תדירות של כל מילה על סמך הספירות. למידע נוסף על TF-IDF, אפשר לעיין במאמר איך פועלות הפונקציות TF-IDF ו-TfidfVectorizer?.
בדוגמה הזו, אנחנו משתמשים בטוקניזציה בסיסית ברמת המילה ובווקטוריזציה של TF-IDF כדי לשמור על פשטות. בפיתוח בסביבת ייצור, אתם יכולים לבחור באפשרויות אחרות של טוקניזציה ווקטוריזציה כדי ליצור הטמעות דלילות בהתאם לדרישות שלכם. במקרה של טוקנייזרים, ברוב המקרים טוקנייזרים של תת-מילים פועלים היטב בהשוואה לטוקנייזרים ברמת המילה, והם בחירה פופולרית. לוקטוריזטורים, BM25 הוא פופולרי כגרסה משופרת של TF-IDF. SPLADE הוא עוד אלגוריתם פופולרי ליצירת וקטורים שמשתמש בסמנטיקה מסוימת להטמעה דלילה.
קבלת הטמעה דלילה
כדי להקל על השימוש ב-Vectorizer עם Vector Search, נגדיר פונקציית wrapper, get_sparse_embedding():
def get_sparse_embedding(text):

  # Transform Text into TF-IDF Sparse Vector
  tfidf_vector = vectorizer.transform([text])

  # Create Sparse Embedding for the New Text
  values = []
  dims = []
  for i, tfidf_value in enumerate(tfidf_vector.data):
    values.append(float(tfidf_value))
    dims.append(int(tfidf_vector.indices[i]))
  return {"values": values, "dimensions": dims}
הפונקציה הזו מעבירה את הפרמטר 'text' ל-vectorizer כדי ליצור הטמעה דלילה. לאחר מכן ממירים אותה לפורמט {"values": ...., "dimensions": ...} שצוין קודם ליצירת אינדקס דליל של חיפוש וקטורי.
כדי לבדוק את הפונקציה הזו:
text_text = "Chrome Dino Pin"
get_sparse_embedding(text_text)
הפלט שיתקבל יהיה ההטמעה הדלילה הבאה:
{'values': [0.6756557405747007, 0.5212913389979028, 0.5212913389979028],
 'dimensions': [157, 48, 33]}
יצירת קובץ נתוני קלט
בדוגמה הזו, ניצור הטמעות דלילות לכל 200 הפריטים.
items = []
for i in range(len(df)):
  id = i
  title = df.title[i]
  sparse_embedding = get_sparse_embedding(title)
  items.append({"id": id, "title": title, "sparse_embedding": sparse_embedding})
הקוד הזה יוצר את השורה הבאה לכל פריט:
{
  'id': 0,
  'title': 'Google Sticker',
  'sparse_embedding': {
    'values': [0.933008728540452, 0.359853737603667],
    'dimensions': [191, 78]
  }
}
לאחר מכן, שומרים אותם כקובץ JSONL בשם items.json ומעלים אותם לקטגוריה של Cloud Storage.
# output as a JSONL file and save to bucket
with open("items.json", "w") as f:
  for item in items:
    f.write(f"{item}\n")
! gcloud storage cp items.json $BUCKET_URI
יצירת אינדקס של הטמעה דלילה ב-Vector Search
בשלב הבא, ניצור ונפרוס אינדקס של הטמעה דלילה בחיפוש וקטורי. זהו אותו הליך שמתועד במדריך לתחילת העבודה עם חיפוש וקטורי.
# create Index
my_index = aiplatform.MatchingEngineIndex.create_tree_ah_index(
  display_name = f"vs-hybridsearch-index-{UID}",
  contents_delta_uri = BUCKET_URI,
  dimensions = 768,
  approximate_neighbors_count = 10,
)
כדי להשתמש באינדקס, צריך ליצור נקודת קצה של האינדקס. היא פועלת כמו מופע שרת שמקבל בקשות שאילתה לאינדקס.
# create IndexEndpoint
my_index_endpoint = aiplatform.MatchingEngineIndexEndpoint.create(
  display_name = f"vs-quickstart-index-endpoint-{UID}",
  public_endpoint_enabled = True
)
כדי לפרוס את האינדקס באמצעות נקודת הקצה של האינדקס, צריך לציין מזהה ייחודי של אינדקס שנפרס.
DEPLOYED_INDEX_ID = f"vs_quickstart_deployed_{UID}"
# deploy the Index to the Index Endpoint
my_index_endpoint.deploy_index(
    index = my_index, deployed_index_id = DEPLOYED_INDEX_ID
)
אחרי שמחכים לפריסה, אפשר להריץ שאילתת בדיקה.
הרצת שאילתה עם אינדקס הטמעה דליל
כדי להריץ שאילתה עם אינדקס הטמעה דלילה, צריך ליצור אובייקט HybridQuery
כדי להקיף את ההטמעה הדלילה של טקסט השאילתה, כמו בדוגמה הבאה:
from google.cloud.aiplatform.matching_engine.matching_engine_index_endpoint import HybridQuery

# create HybridQuery
query_text = "Kids"
query_emb = get_sparse_embedding(query_text)
query = HybridQuery(
  sparse_embedding_dimensions=query_emb['dimensions'],
  sparse_embedding_values=query_emb['values'],
)
בדוגמת הקוד הזו נעשה שימוש בטקסט Kids (ילדים) בשאילתה. עכשיו מריצים שאילתה עם האובייקט HybridQuery.
# build a query request
response = my_index_endpoint.find_neighbors(
  deployed_index_id=DEPLOYED_INDEX_ID,
  queries=[query],
  num_neighbors=5,
)

# print results
for idx, neighbor in enumerate(response[0]):
  title = df.title[int(neighbor.id)]
  print(f"{title:<40}")
הפלט שיתקבל אמור להיראות כך:
Google Blue Kids Sunglasses
Google Red Kids Sunglasses
YouTube Kids Coloring Pencils
YouTube Kids Character Sticker Sheet
מתוך 200 הפריטים, התוצאה מכילה את שמות הפריטים שכוללים את מילת המפתח Kids.
דוגמה: איך משתמשים בחיפוש היברידי
בדוגמה הזו, חיפוש מבוסס-טוקנים משולב עם חיפוש סמנטי כדי ליצור חיפוש היברידי בחיפוש וקטורי.
איך יוצרים אינדקס היברידי
כדי ליצור אינדקס היברידי, לכל פריט צריך להיות גם 'embedding' (להטמעה צפופה) וגם 'sparse_embedding':
items = []
for i in range(len(df)):
  id = i
  title = df.title[i]
  dense_embedding = get_dense_embedding(title)
  sparse_embedding = get_sparse_embedding(title)
  items.append(
    {"id": id, "title": title,
      "embedding": dense_embedding,
      "sparse_embedding": sparse_embedding,}
  )
items[0]
הפונקציה get_dense_embedding() משתמשת ב-Agent Platform Embedding API כדי ליצור הטמעות טקסט עם עד 768 ממדים. עכשיו, גם הטמעות צפופות וגם הטמעות דלילות משולבות בפורמט הבא:
{
  "id": 0,
  "title": "Google Sticker",
  "embedding":
    [0.022880317643284798,
    -0.03315234184265137,
    ...
    -0.03309667482972145,
    0.04621824622154236],
  "sparse_embedding": {
    "values": [0.933008728540452, 0.359853737603667],
    "dimensions": [191, 78]
  }
}
שאר התהליך זהה לזה שמתואר בדוגמה: איך משתמשים בחיפוש מבוסס-טוקנים: מעלים את קובץ ה-JSONL לקטגוריית Cloud Storage, יוצרים אינדקס של חיפוש וקטורי עם הקובץ ומפרסים את האינדקס לנקודת הקצה של האינדקס.
הרצת שאילתה היברידית
אחרי פריסת האינדקס ההיברידי, אפשר להריץ שאילתה היברידית:
# create HybridQuery
query_text = "Kids"
query_dense_emb = get_dense_embedding(query_text)
query_sparse_emb = get_sparse_embedding(query_text)
query = HybridQuery(
  dense_embedding=query_dense_emb,
  sparse_embedding_dimensions=query_sparse_emb['dimensions'],
  sparse_embedding_values=query_sparse_emb['values'],
  rrf_ranking_alpha=0.5,
)
עבור טקסט השאילתה 'ילדים', צריך ליצור הטמעות צפופות ודלילות למילה, ולכלול אותן באובייקט HybridQuery. ההבדל מהאובייקט HybridQuery הקודם הוא שני פרמטרים נוספים: dense_embedding ו-rrf_ranking_alpha.
הפעם, נדפיס את המרחקים של כל פריט:
# print results
for idx, neighbor in enumerate(response[0]):
  title = df.title[int(neighbor.id)]
  dense_dist = neighbor.distance if neighbor.distance else 0.0
  sparse_dist = neighbor.sparse_distance if neighbor.sparse_distance else 0.0
  print(f"{title:<40}: dense_dist: {dense_dist:.3f}, sparse_dist: {sparse_dist:.3f}")
בכל אובייקט neighbor יש מאפיין distance שמכיל את המרחק בין השאילתה לבין הפריט עם ההטמעה הצפופה, ומאפיין sparse_distance שמכיל את המרחק עם ההטמעה הדלילה. הערכים האלה הם מרחקים הפוכים, כך שערך גבוה יותר מציין מרחק קצר יותר.
אם מריצים שאילתה עם HybridQuery, מקבלים את התוצאה הבאה:
Google Blue Kids Sunglasses             : dense_dist: 0.677, sparse_dist: 0.606
Google Red Kids Sunglasses              : dense_dist: 0.665, sparse_dist: 0.572
YouTube Kids Coloring Pencils           : dense_dist: 0.655, sparse_dist: 0.478
YouTube Kids Character Sticker Sheet    : dense_dist: 0.644, sparse_dist: 0.468
Google White Classic Youth Tee          : dense_dist: 0.645, sparse_dist: 0.000
Google Doogler Youth Tee                : dense_dist: 0.639, sparse_dist: 0.000
Google Indigo Youth Tee                 : dense_dist: 0.637, sparse_dist: 0.000
Google Black Classic Youth Tee          : dense_dist: 0.632, sparse_dist: 0.000
Chrome Dino Glow-in-the-Dark Youth Tee  : dense_dist: 0.632, sparse_dist: 0.000
Google Bike Youth Tee                   : dense_dist: 0.629, sparse_dist: 0.000
בנוסף לתוצאות החיפוש שמבוססות על טוקנים וכוללות את מילת המפתח Kids, יש גם תוצאות חיפוש סמנטיות. לדוגמה, הפריט 'חולצת טי לבנה קלאסית של Google לילדים' נכלל כי מודל ההטמעה יודע שהמילים 'ילדים' ו'נוער' דומות מבחינה סמנטית.
כדי למזג את תוצאות החיפוש הסמנטי ואת תוצאות החיפוש שמבוסס על טוקנים, החיפוש ההיברידי משתמש במיזוג הדדי של דירוגים (RRF). מידע נוסף על RRF ועל האופן שבו מציינים את הפרמטר rrf_ranking_alpha זמין במאמר מהו מיזוג הדדי של דירוגים?
דירוג מחדש
RRF מספק דרך למזג את הדירוג מתוצאות חיפוש סמנטיות ומתוצאות חיפוש מבוססות-טוקנים. במערכות רבות לאחזור מידע או להמלצות על מוצרים, התוצאות עוברות אלגוריתמים נוספים לדירוג לפי דיוק – מה שנקרא דירוג מחדש. השילוב של אחזור מהיר ברמת המילי-שנייה עם חיפוש וקטורי ודירוג מחדש מדויק של התוצאות מאפשר לכם לבנות מערכות רב-שלביות שמספקות איכות חיפוש גבוהה יותר או ביצועים טובים יותר של המלצות.
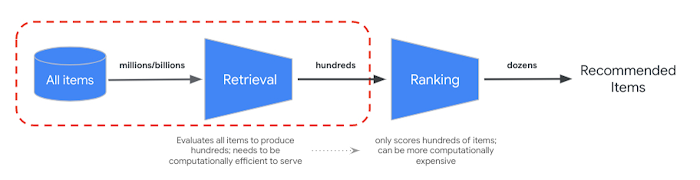
Gemini Enterprise Agent Platform Ranking API מספק דרך להטמיע את הדירוג על סמך רלוונטיות כללית בין טקסט השאילתה לבין טקסט תוצאות החיפוש באמצעות המודל שאומן מראש. TensorFlow Ranking מספק גם מבוא לאופן התכנון והאימון של מודלים של למידה לדירוג (LTR) לדירוג מחדש מתקדם שאפשר להתאים אותו לדרישות עסקיות שונות.
איך מתחילים להשתמש בחיפוש היברידי
מקורות המידע הבאים יעזרו לכם להתחיל להשתמש בחיפוש היברידי ב-Vector Search.
מקורות מידע על חיפוש היברידי
- שילוב של חיפוש סמנטי וחיפוש מבוסס מילות מפתח: הדרכה בנושא חיפוש היברידי באמצעות פלטפורמת הסוכנים של Gemini Enterprise חיפוש וקטורי: מחברת לדוגמה לתחילת העבודה עם חיפוש היברידי
- פורמט נתונים ומבנה של קלט: פורמט נתונים של קלט ליצירת אינדקס של הטמעה דלילה
- Query public index to get nearest neighbors: How to run queries with hybrid search
- השיטה Reciprocal Rank Fusion (שילוב דרגות הדדיות) עדיפה על השיטה Condorcet ועל שיטות נפרדות של Rank Learning (למידת דירוג): דיון באלגוריתם RRF
מקורות מידע על Vector Search
מושגים נוספים
בקטעים הבאים מתוארים בפירוט TF-IDF ו-TfidVectorizer, Reciprocal Rank Fusion ופרמטר האלפא.
איך פועלים TF-IDF ו-TfidfVectorizer?
הפונקציה fit_transform() מבצעת שני תהליכים חשובים של אלגוריתם TF-IDF:
Fit: הווקטוריזטור מחשב את תדירות המסמך ההפוכה (IDF) לכל מונח באוצר המילים. המדד IDF משקף את מידת החשיבות של מונח מסוים בכל הקורפוס. מונחים נדירים מקבלים ציוני IDF גבוהים יותר:
IDF(t) = log_e(Total number of documents / Number of documents containing term t)שינוי:
- טוקניזציה: פירוק המסמכים למונחים נפרדים (מילים או ביטויים)
חישוב תדירות המונחים (TF): ספירת התדירות שבה כל מונח מופיע בכל מסמך באמצעות:
TF(t, d) = (Number of times term t appears in document d) / (Total
number of terms in document d)
חישוב TF-IDF: משלב את ה-TF של כל מונח עם ה-IDF שחושב מראש כדי ליצור ציון TF-IDF. הציון הזה מייצג את החשיבות של מונח במסמך מסוים ביחס לכלל הקורפוס.
TF-IDF(t, d) = TF(t, d) * IDF(t)הפונקציה TF-IDF vectorizer מנסה לתת משקל גבוה יותר למילים ייחודיות במערך הנתונים, כמו 'חולצות' או 'דינו', בהשוואה למילים טריוויאליות כמו 'ה', 'א' או 'של', וסופרת כמה פעמים המילים הייחודיות האלה מופיעות במסמך שצוין. כל ערך של הטמעה דלילה מייצג את התדירות של כל מילה על סמך הספירות.
מהו מיזוג הדדי של דירוגים?
כדי למזג את תוצאות החיפוש הסמנטי ואת תוצאות החיפוש שמבוסס על טוקנים, נעשה שימוש בחיפוש היברידי ב-Reciprocal Rank Fusion (RRF). RRF הוא אלגוריתם לשילוב של כמה רשימות מדורגות של פריטים לדירוג מאוחד אחד. זו טכניקה פופולרית למיזוג תוצאות חיפוש ממקורות שונים או משיטות אחזור שונות, במיוחד במערכות חיפוש היברידיות ובמודלים גדולים של שפה.
במקרה של חיפוש היברידי בחיפוש וקטורי, המרחק הצפוף והמרחק הדליל נמדדים במרחבים שונים, ואי אפשר להשוות ביניהם ישירות. לכן, RRF פועל ביעילות למיזוג ולדירוג התוצאות משני המרחבים השונים.
כך פועל RRF:
- דירוג הדדי: לכל פריט ברשימה מדורגת, מחשבים את הדירוג ההדדי שלו. המשמעות היא שצריך לחשב את ההופכי של מיקום הפריט (הדירוג) ברשימה. לדוגמה, הפריט שמדורג במקום הראשון מקבל דירוג הפוך של 1/1 = 1, והפריט שמדורג במקום השני מקבל דירוג הפוך של 1/2 = 0.5.
- סיכום הדירוגים ההדדיים: סיכום הדירוגים ההדדיים של כל פריט בכל הרשימות המדורגות. כך מתקבל ציון סופי לכל פריט.
- מיון לפי ציון סופי: מיון הפריטים לפי הציון הסופי שלהם בסדר יורד. הפריטים עם הציונים הכי גבוהים נחשבים לרלוונטיים או לחשובים ביותר.
בקיצור, הפריטים עם הדירוגים הגבוהים ביותר בתוצאות הצפופות והדלילות יוצגו בראש הרשימה. לכן, הפריט 'משקפי שמש לילדים בצבע כחול של Google' נמצא בראש הרשימה כי יש לו דירוגים גבוהים בתוצאות החיפוש הצפופות והדלילות. לפריטים כמו 'חולצת טי קלאסית לבנה לילדים של Google' יש דירוג נמוך כי הם מופיעים רק בתוצאות החיפוש הצפופות.
התנהגות הפרמטר אלפא
בדוגמה לשימוש בחיפוש היברידי, הפרמטר rrf_ranking_alphaמוגדר כ-0.5 כשיוצרים את האובייקט HybridQuery. אפשר לציין משקל לדירוג של תוצאות החיפוש הצפופות והדלילות באמצעות הערכים הבאים של rrf_ranking_alpha:
-
1, או לא צוין: חיפוש היברידי משתמש רק בתוצאות חיפוש צפופות ומתעלם מתוצאות חיפוש דלילות. -
0: חיפוש היברידי משתמש רק בתוצאות חיפוש דלילות ומתעלם מתוצאות חיפוש צפופות. -
0עד1: חיפוש היברידי ממזג את התוצאות מחיפוש צפוף ומחיפוש דליל עם המשקל שצוין בערך. 0.5 אומר שהם ימוזגו עם אותו משקל.