

Vector Search supporta la ricerca ibrida, un pattern di architettura diffuso nel recupero delle informazioni (IR) che combina la ricerca semantica e la ricerca per parole chiave (chiamata anche ricerca basata su token). Con la ricerca ibrida, gli sviluppatori possono sfruttare al meglio i due approcci, fornendo in modo efficace una qualità di ricerca superiore.
Questa pagina spiega i concetti di ricerca ibrida, ricerca semantica e ricerca basata su token e include esempi di come configurare la ricerca basata su token e la ricerca ibrida:
- Perché la ricerca ibrida è importante?
- Esempio: come utilizzare la ricerca basata su token
- Esempio: come utilizzare la ricerca ibrida
- Inizia a utilizzare la ricerca ibrida
- Concetti aggiuntivi
Perché la ricerca ibrida è importante?
Come descritto in Panoramica di Vector Search, la ricerca semantica con Vector Search può trovare elementi con somiglianza semantica utilizzando le query.
I modelli di embedding come Gemini Enterprise Agent Platform
Embeddings creano uno spazio vettoriale
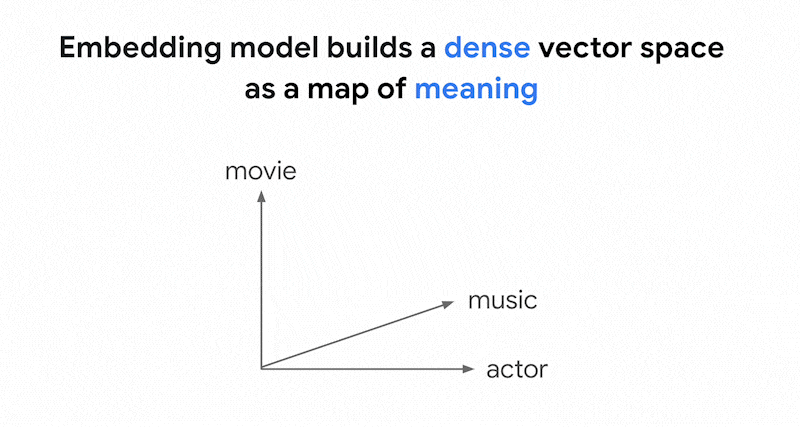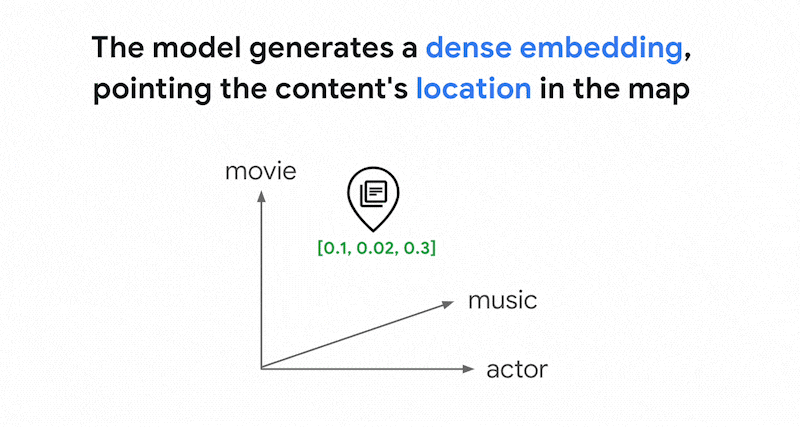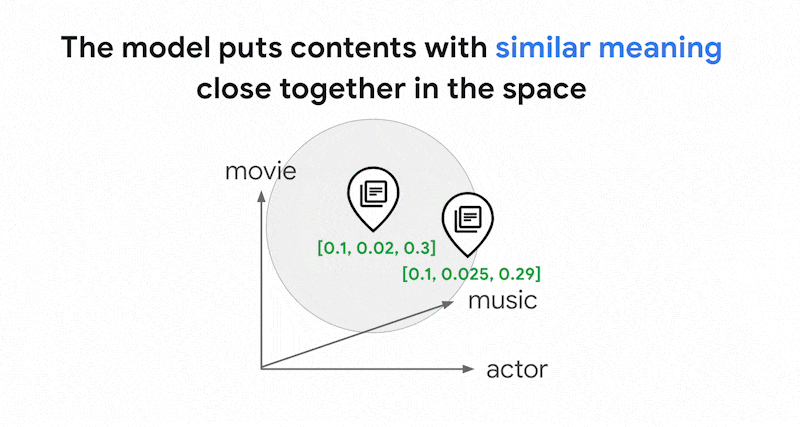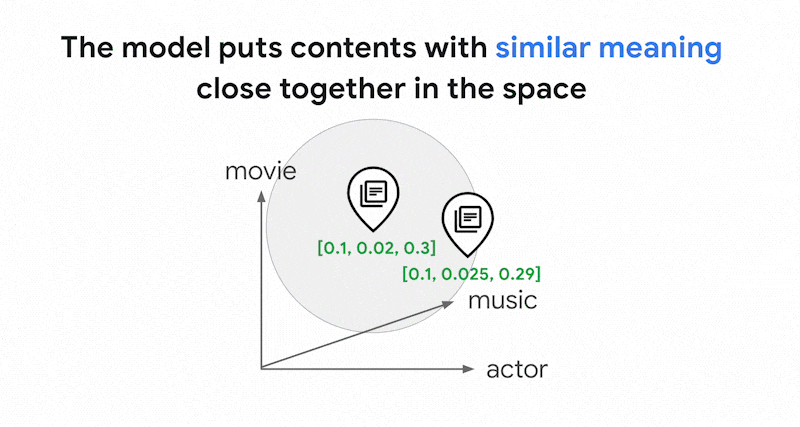
come mappa dei significati dei contenuti. Ogni embedding di testo o multimodale è una posizione nella mappa che rappresenta il significato di alcuni contenuti. Ad esempio, in modo semplificato, quando un modello di embedding prende un testo che parla di film per il 10%, di musica per il 2% e di attori per il 30%, potrebbe rappresentare questo testo con un embedding [0.1, 0.02, 0.3]. Con Vector Search, puoi trovare rapidamente altri embedding nelle vicinanze. Questa ricerca in base al significato dei contenuti è chiamata ricerca semantica.
La ricerca semantica con embedding e la ricerca vettoriale possono contribuire a rendere i sistemi IT intelligenti come i bibliotecari o il personale del negozio esperti. Gli embedding possono essere utilizzati per collegare diversi dati aziendali ai loro significati, ad esempio query e risultati di ricerca, testi e immagini, attività degli utenti e prodotti consigliati, testi in inglese e testi in giapponese o dati dei sensori e condizioni di avviso. Con questa funzionalità, gli embedding hanno una vasta gamma di casi d'uso.
Perché combinare la ricerca semantica con la ricerca basata su parole chiave?
La ricerca semantica non copre tutti i possibili requisiti per le applicazioni di recupero delle informazioni, come la Retrieval-Augmented Generation (RAG). La ricerca semantica può trovare solo i dati che il modello di embedding può comprendere. Ad esempio, le query o i set di dati con numeri di prodotto o SKU arbitrari, i nomi di prodotti nuovi aggiunti di recente e i nomi in codice proprietari aziendali non funzionano con la ricerca semantica perché non sono inclusi nel set di dati di addestramento del modello di embedding. Questi dati sono chiamati "fuori dominio".
In questi casi, dovrai combinare la ricerca semantica con la ricerca basata su parole chiave (chiamata anche ricerca basata su token) per formare una ricerca ibrida. Con la ricerca ibrida, puoi sfruttare sia la ricerca semantica sia quella basata su token per ottenere una qualità di ricerca superiore.
Uno dei sistemi di ricerca ibrida più diffusi è la Ricerca Google. Nel 2015, il servizio ha incorporato la ricerca semantica con il modello RankBrain , oltre al suo algoritmo di ricerca per parole chiave basato su token . Con l'introduzione della ricerca ibrida, la Ricerca Google è stata in grado di migliorare significativamente la qualità della ricerca soddisfacendo i due requisiti: ricerca per significato e ricerca per parola chiave.
In passato, la creazione di un motore di ricerca ibrido era un'attività complessa. Proprio come con la Ricerca Google, devi creare e gestire due tipi diversi di motori di ricerca (ricerca semantica e ricerca basata su token) e unire e classificare i risultati. Con il supporto della ricerca ibrida in Vector Search, puoi creare il tuo sistema di ricerca ibrida con un singolo indice della Ricerca vettoriale, personalizzato in base alle tue esigenze aziendali.
Come funziona la ricerca basata su token
Come funziona la ricerca basata su token in Vector Search? Dopo aver suddiviso il testo in token (come parole o sotto-parole), puoi utilizzare algoritmi di embedding sparsi diffusi come TF-IDF, BM25 o SPLADE per generare embedding sparsi per il testo.
Una spiegazione semplificata degli embedding sparsi è che sono vettori che rappresentano il numero di volte in cui ogni parola o sotto-parola appare nel testo. Gli embedding sparsi tipici non tengono conto della semantica del testo.
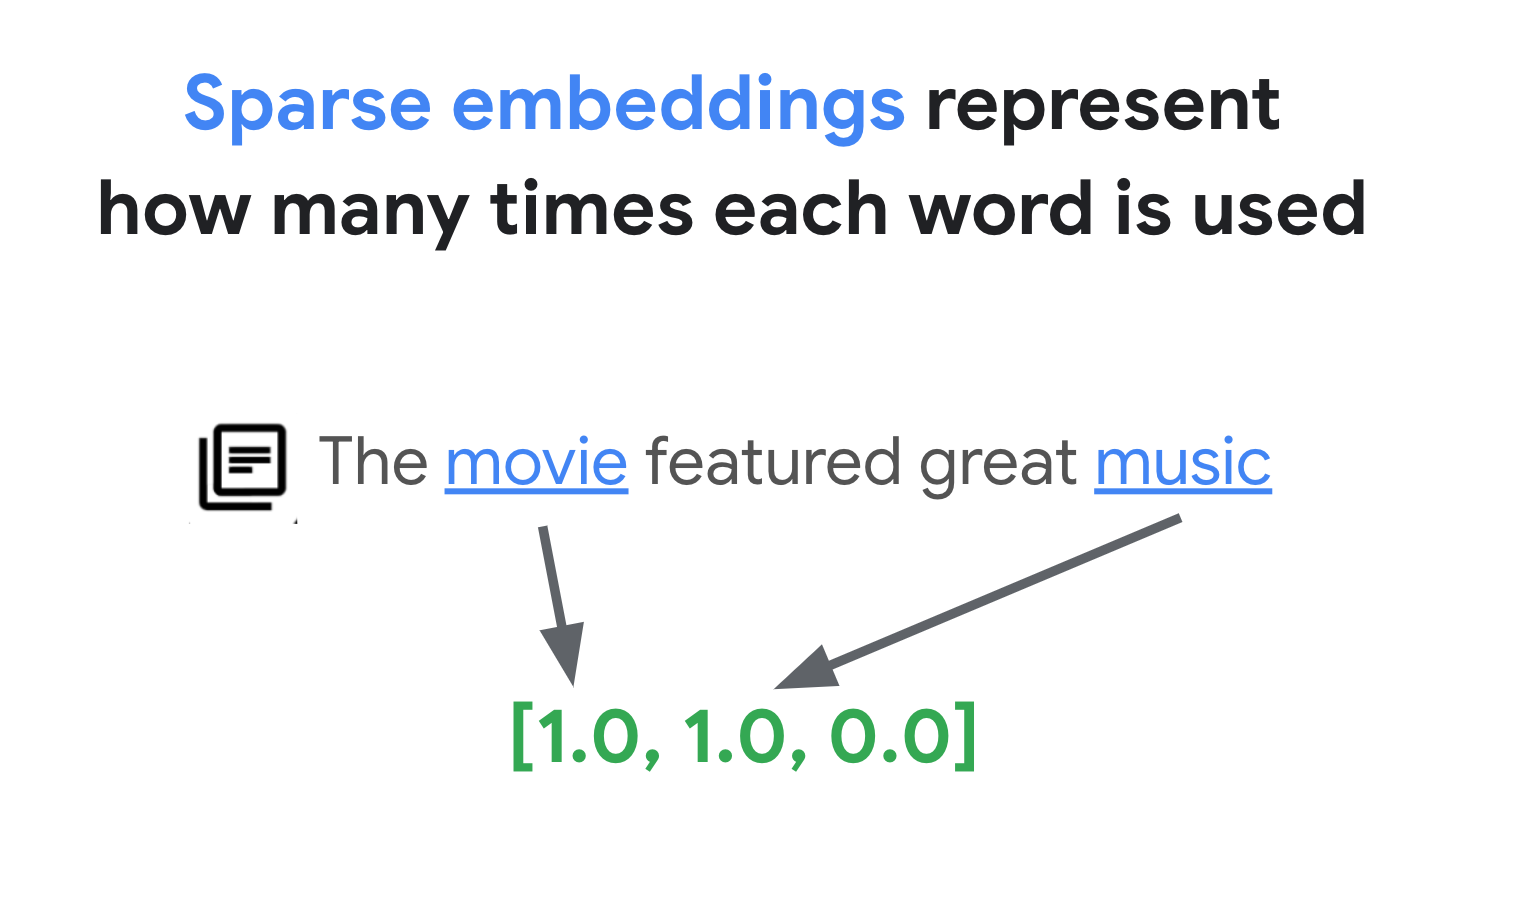
Nei testi potrebbero essere utilizzate migliaia di parole diverse. Pertanto, questo embedding di solito ha decine di migliaia di dimensioni, con solo alcune dimensioni che hanno valori diversi da zero. Per questo motivo vengono chiamati embedding "sparsi". La maggior parte dei loro valori è pari a zero. Questo spazio di embedding sparsi funziona come una mappa di parole chiave, simile a un indice di libri.
In questo spazio di embedding sparsi, puoi trovare embedding simili esaminando le vicinanze di un embedding di query. Questi embedding sono simili in termini di distribuzione delle parole chiave utilizzate nei testi.
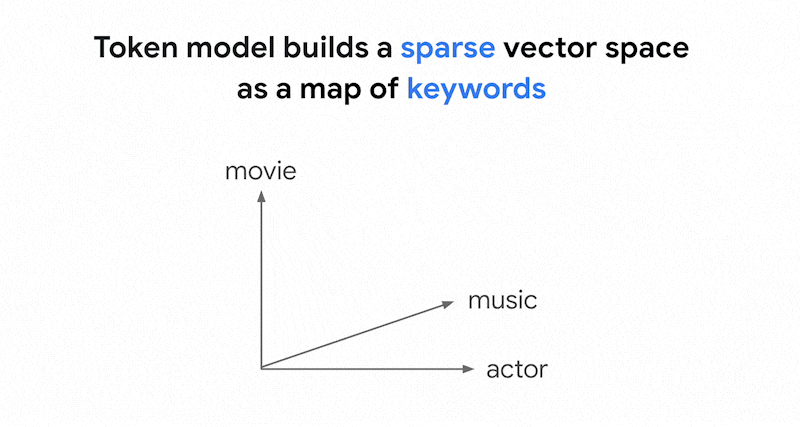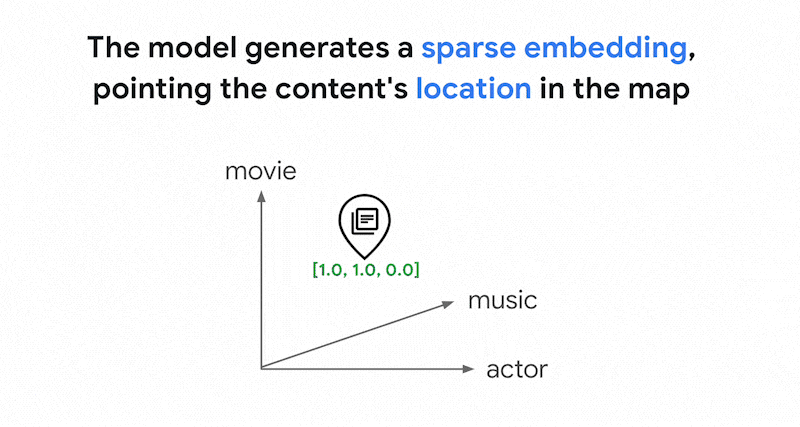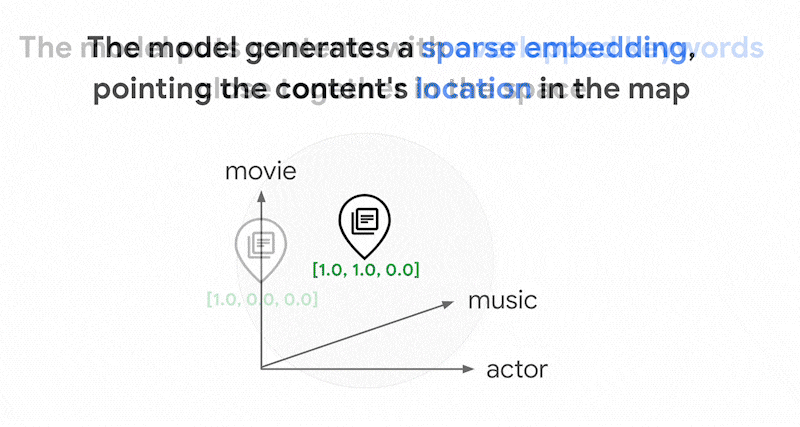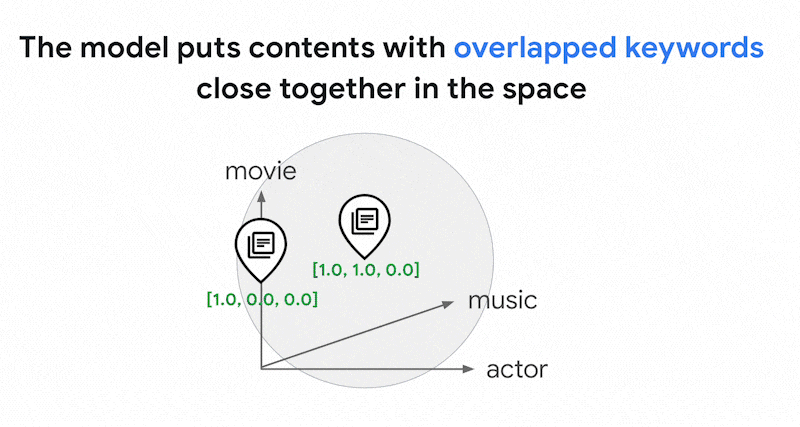
Questo è il meccanismo di base della ricerca basata su token con embedding sparsi. Con la ricerca ibrida in Vector Search, puoi combinare embedding densi e sparsi in un singolo indice vettoriale ed eseguire query con embedding densi, embedding sparsi o entrambi. Il risultato è una combinazione di risultati di ricerca semantica e di ricerca basata su token.
La ricerca ibrida offre anche una latenza delle query inferiore rispetto a un motore di ricerca basato su token con una progettazione di indice invertito index. Proprio come la ricerca vettoriale per la ricerca semantica, ogni query con embedding densi o sparsi termina in pochi millisecondi, anche con milioni o miliardi di elementi.
Esempio: come utilizzare la ricerca basata su token
Per spiegare come utilizzare la ricerca basata su token, le sezioni seguenti includono esempi di codice che generano embedding sparsi e creano un indice con questi in Vector Search.
Per provare questo codice campione, utilizza il notebook: Combining Semantic & Keyword Search: A Hybrid Search Tutorial with Gemini Enterprise Agent Platform Vector Search.
Il primo passaggio consiste nel preparare un file di dati per creare un indice per gli embedding sparsi, in base al formato dei dati descritto in Formato e struttura dei dati di input.
In JSON, il file di dati è simile al seguente:
{"id": "3", "sparse_embedding": {"values": [0.1, 0.2], "dimensions": [1, 4]}}
{"id": "4", "sparse_embedding": {"values": [-0.4, 0.2, -1.3], "dimensions": [10, 20, 30]}}
Ogni elemento deve avere una proprietà sparse_embedding con le proprietà values e dimensions. Gli embedding sparsi hanno migliaia di dimensioni con alcuni valori diversi da zero. Questo formato di dati funziona in modo efficiente perché contiene solo i valori diversi da zero con le relative posizioni nello spazio.
Preparare un set di dati di esempio
Come set di dati di esempio, utilizzeremo il set di dati Google Merch Shop, che contiene circa 200 righe di prodotti con brand Google.
0                          Google Sticker
1                    Google Cloud Sticker
2                       Android Black Pen
3                   Google Ombre Lime Pen
4                    For Everyone Eco Pen
                      ...
197        Google Recycled Black Backpack
198    Google Cascades Unisex Zip Sweater
199    Google Cascades Womens Zip Sweater
200         Google Cloud Skyline Backpack
201       Google City Black Tote Backpack
Preparare un vectorizer TF-IDF
Con questo set di dati, addestreremo un vectorizer, un modello che genera embedding sparsi da un testo. Questo esempio utilizza TfidfVectorizer in scikit-learn, un vectorizer di base che utilizza l' algoritmo TF-IDF.
from sklearn.feature_extraction.text import TfidfVectorizer

# Make a list of the item titles
corpus = df.title.tolist()

# Initialize TfidfVectorizer
vectorizer = TfidfVectorizer()

# Fit and Transform
vectorizer.fit_transform(corpus)
La variabile corpus contiene un elenco dei 200 nomi degli articoli, ad esempio "Google Sticker" o "Dino di Chrome Pin". Il codice li passa quindi al vectorizer chiamando la funzione fit_transform(). In questo modo, il vectorizer si prepara a generare embedding sparsi.
Il vectorizer TF-IDF tenta di assegnare un peso maggiore alle parole di firma nel set di dati (ad esempio "Shirts" o "Dino") rispetto alle parole banali (ad esempio "The", "a" o "of") e conta il numero di volte in cui queste parole di firma vengono utilizzate nel documento specificato. Ogni valore di un embedding sparso rappresenta la frequenza di ogni parola in base ai conteggi. Per ulteriori informazioni su TF-IDF, vedi Come funzionano TF-IDF e TfidfVectorizer?.
In questo esempio, per semplicità, utilizziamo la tokenizzazione di base a livello di parola e la vettorizzazione TF-IDF. Nello sviluppo di produzione, puoi scegliere qualsiasi altra opzione per la tokenizzazione e la vettorizzazione per generare embedding sparsi in base ai tuoi requisiti. Per i tokenizzatori, in molti casi tokenizzatori di sotto-parole hanno un buon rendimento rispetto alla tokenizzazione a livello di parola e sono scelte comuni. Per i vectorizer, BM25 è diffuso come versione migliorata di TF-IDF. SPLADE è un altro algoritmo di vettorizzazione diffuso che prende in considerazione alcuni aspetti semantici per l'embedding sparso.
Ottenere un embedding sparso
Per semplificare l'utilizzo del vectorizer con Vector Search, definiremo una funzione wrapper, get_sparse_embedding():
def get_sparse_embedding(text):

  # Transform Text into TF-IDF Sparse Vector
  tfidf_vector = vectorizer.transform([text])

  # Create Sparse Embedding for the New Text
  values = []
  dims = []
  for i, tfidf_value in enumerate(tfidf_vector.data):
    values.append(float(tfidf_value))
    dims.append(int(tfidf_vector.indices[i]))
  return {"values": values, "dimensions": dims}
Questa funzione passa il parametro "text" al vectorizer per generare un embedding sparso. Convertilo poi nel formato {"values": ...., "dimensions": ...}
menzionato in precedenza per creare un indice sparso di Vector Search.
Puoi testare questa funzione:
text_text = "Chrome Dino Pin"
get_sparse_embedding(text_text)
Dovrebbe essere restituito il seguente embedding sparso:
{'values': [0.6756557405747007, 0.5212913389979028, 0.5212913389979028],
 'dimensions': [157, 48, 33]}
Creare un file di dati di input
In questo esempio, genereremo embedding sparsi per tutti i 200 articoli.
items = []
for i in range(len(df)):
  id = i
  title = df.title[i]
  sparse_embedding = get_sparse_embedding(title)
  items.append({"id": id, "title": title, "sparse_embedding": sparse_embedding})
Questo codice genera la seguente riga per ogni articolo:
{
  'id': 0,
  'title': 'Google Sticker',
  'sparse_embedding': {
    'values': [0.933008728540452, 0.359853737603667],
    'dimensions': [191, 78]
  }
}
Salvali poi come file JSONL "items.json" e caricali in un bucket Cloud Storage.
# output as a JSONL file and save to bucket
with open("items.json", "w") as f:
  for item in items:
    f.write(f"{item}\n")
! gcloud storage cp items.json $BUCKET_URI
Creare un indice di embedding sparsi in Vector Search
Ora creeremo e implementeremo un indice di embedding sparsi in Vector Search. Questa è la stessa procedura documentata nella guida rapida di Vector Search.
# create Index
my_index = aiplatform.MatchingEngineIndex.create_tree_ah_index(
  display_name = f"vs-hybridsearch-index-{UID}",
  contents_delta_uri = BUCKET_URI,
  dimensions = 768,
  approximate_neighbors_count = 10,
)
Per utilizzare l'indice, devi creare un endpoint indice. Funziona come un'istanza del server che accetta le richieste di query per l'indice.
# create IndexEndpoint
my_index_endpoint = aiplatform.MatchingEngineIndexEndpoint.create(
  display_name = f"vs-quickstart-index-endpoint-{UID}",
  public_endpoint_enabled = True
)
Con l'endpoint indice, implementa l'indice specificando un ID indice implementato univoco.
DEPLOYED_INDEX_ID = f"vs_quickstart_deployed_{UID}"
# deploy the Index to the Index Endpoint
my_index_endpoint.deploy_index(
    index = my_index, deployed_index_id = DEPLOYED_INDEX_ID
)
Dopo aver atteso l'implementazione, possiamo eseguire una query di test.
Eseguire una query con un indice di embedding sparsi
Per eseguire una query con un indice di embedding sparsi, devi creare un oggetto HybridQuery per incapsulare l'embedding sparso del testo della query, come nell'esempio seguente:
from google.cloud.aiplatform.matching_engine.matching_engine_index_endpoint import HybridQuery

# create HybridQuery
query_text = "Kids"
query_emb = get_sparse_embedding(query_text)
query = HybridQuery(
  sparse_embedding_dimensions=query_emb['dimensions'],
  sparse_embedding_values=query_emb['values'],
)
Questo codice di esempio utilizza il testo "Kids" per la query. Ora esegui una query con l'oggetto HybridQuery.
# build a query request
response = my_index_endpoint.find_neighbors(
  deployed_index_id=DEPLOYED_INDEX_ID,
  queries=[query],
  num_neighbors=5,
)

# print results
for idx, neighbor in enumerate(response[0]):
  title = df.title[int(neighbor.id)]
  print(f"{title:<40}")
Dovrebbe essere restituito un output simile al seguente:
Google Blue Kids Sunglasses
Google Red Kids Sunglasses
YouTube Kids Coloring Pencils
YouTube Kids Character Sticker Sheet
Dei 200 articoli, il risultato contiene i nomi degli articoli che hanno la parola chiave "Kids".
Esempio: come utilizzare la ricerca ibrida
Questo esempio combina la ricerca basata su token con la ricerca semantica per creare la ricerca ibrida in Vector Search.
Come creare un indice ibrido
Per creare un indice ibrido, ogni elemento deve avere sia "embedding" (per l'embedding denso) sia "sparse_embedding":
items = []
for i in range(len(df)):
  id = i
  title = df.title[i]
  dense_embedding = get_dense_embedding(title)
  sparse_embedding = get_sparse_embedding(title)
  items.append(
    {"id": id, "title": title,
      "embedding": dense_embedding,
      "sparse_embedding": sparse_embedding,}
  )
items[0]
La funzione get_dense_embedding() utilizza l'API Embedding
della piattaforma agentica per
generare embedding di testo con un massimo di 768 dimensioni. Ora gli embedding densi e sparsi
vengono combinati nel seguente formato:
{
  "id": 0,
  "title": "Google Sticker",
  "embedding":
    [0.022880317643284798,
    -0.03315234184265137,
    ...
    -0.03309667482972145,
    0.04621824622154236],
  "sparse_embedding": {
    "values": [0.933008728540452, 0.359853737603667],
    "dimensions": [191, 78]
  }
}
Il resto della procedura è lo stesso descritto in Esempio: come utilizzare la ricerca basata su token: carica il file JSONL nel bucket Cloud Storage, crea un indice Vector Search con il file e implementa l'indice nell'endpoint indice.
Eseguire una query ibrida
Dopo aver implementato l'indice ibrido, puoi eseguire una query ibrida:
# create HybridQuery
query_text = "Kids"
query_dense_emb = get_dense_embedding(query_text)
query_sparse_emb = get_sparse_embedding(query_text)
query = HybridQuery(
  dense_embedding=query_dense_emb,
  sparse_embedding_dimensions=query_sparse_emb['dimensions'],
  sparse_embedding_values=query_sparse_emb['values'],
  rrf_ranking_alpha=0.5,
)
Per il testo della query "Kids", genera embedding densi e sparsi per la parola e incapsulali nell'oggetto HybridQuery. La differenza rispetto al precedente HybridQuery è costituita da due parametri aggiuntivi: dense_embedding e rrf_ranking_alpha.
Questa volta, stamperemo le distanze per ogni articolo:
# print results
for idx, neighbor in enumerate(response[0]):
  title = df.title[int(neighbor.id)]
  dense_dist = neighbor.distance if neighbor.distance else 0.0
  sparse_dist = neighbor.sparse_distance if neighbor.sparse_distance else 0.0
  print(f"{title:<40}: dense_dist: {dense_dist:.3f}, sparse_dist: {sparse_dist:.3f}")
In ogni oggetto neighbor, è presente una proprietà distance che indica la distanza
tra la query e l'articolo con l'embedding denso e una proprietà sparse_distance
che indica la distanza con l'embedding sparso. Questi valori sono distanze invertite, quindi un valore più alto indica una distanza più breve.
Eseguendo una query con HybridQuery, ottieni il seguente risultato:
Google Blue Kids Sunglasses             : dense_dist: 0.677, sparse_dist: 0.606
Google Red Kids Sunglasses              : dense_dist: 0.665, sparse_dist: 0.572
YouTube Kids Coloring Pencils           : dense_dist: 0.655, sparse_dist: 0.478
YouTube Kids Character Sticker Sheet    : dense_dist: 0.644, sparse_dist: 0.468
Google White Classic Youth Tee          : dense_dist: 0.645, sparse_dist: 0.000
Google Doogler Youth Tee                : dense_dist: 0.639, sparse_dist: 0.000
Google Indigo Youth Tee                 : dense_dist: 0.637, sparse_dist: 0.000
Google Black Classic Youth Tee          : dense_dist: 0.632, sparse_dist: 0.000
Chrome Dino Glow-in-the-Dark Youth Tee  : dense_dist: 0.632, sparse_dist: 0.000
Google Bike Youth Tee                   : dense_dist: 0.629, sparse_dist: 0.000
Oltre ai risultati di ricerca basati su token che contengono la parola chiave "Kids", sono inclusi anche i risultati di ricerca semantica. Ad esempio, "Google White Classic Youth Tee" è incluso perché il modello di embedding sa che "Youth" e "Kids" sono semanticamente simili.
Per unire i risultati di ricerca basati su token e semantici, la ricerca ibrida utilizza
Reciprocal Rank Fusion
(RRF). Per ulteriori informazioni su RRF e su come
specificare il rrf_ranking_alpha parametro, vedi Che cos'è Reciprocal Rank
Fusion?.
Re-ranking
RRF fornisce un modo per unire la classificazione dei risultati di ricerca semantica e basata su token. In molti sistemi di recupero di informazioni o di consigli di produzione, i risultati vengono sottoposti ad algoritmi di ranking di precisione aggiuntivi, chiamati re-ranking. Grazie alla combinazione del recupero rapido a livello di millisecondi con Vector Search e del re-ranking di precisione sui risultati, puoi creare sistemi multifase che offrono una qualità di ricerca o un rendimento dei consigli superiori.
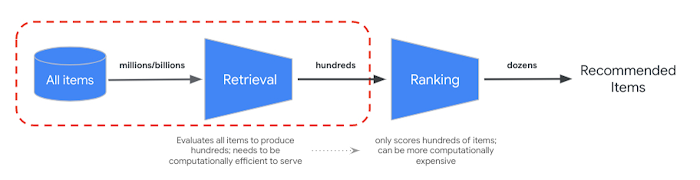
L'API Ranking della piattaforma agentica Gemini Enterprise fornisce un modo per implementare la classificazione in base alla pertinenza generica tra il testo della query e i testi dei risultati di ricerca con il modello preaddestrato. TensorFlow Ranking fornisce anche un'introduzione su come progettare e addestrare i modelli di apprendimento per la classificazione (LTR) per il re-ranking avanzato che può essere personalizzato per vari requisiti aziendali.
Inizia a utilizzare la ricerca ibrida
Le seguenti risorse possono aiutarti a iniziare a utilizzare la ricerca ibrida in Vector Search.
Risorse per la ricerca ibrida
- Combining Semantic & Keyword Search: A Hybrid Search Tutorial with Gemini Enterprise Agent Platform Vector Search: notebook di esempio per iniziare a utilizzare la ricerca ibrida
- Formato e struttura dei dati di input: formato dei dati di input per la creazione dell'indice di embedding sparsi
- Eseguire query sull'indice pubblico per ottenere i vicini più prossimi: come eseguire query con la ricerca ibrida
- Reciprocal Rank Fusion supera Condorcet e i metodi di apprendimento della classificazione individuale Metodi: discussione dell'algoritmo RRF
Risorse per Vector Search
- Panoramica di Vector Search della piattaforma agentica Gemini Enterprise
- Guida rapida di Vector Search
Concetti aggiuntivi
Le sezioni seguenti descrivono in modo più dettagliato TF-IDF e TfidfVectorizer, Reciprocal Rank Fusion e il parametro alpha.
Come funzionano TF-IDF e TfidfVectorizer?
La funzione fit_transform() esegue due processi importanti dell'algoritmo TF-IDF:
Fit: il vectorizer calcola la frequenza inversa del documento (IDF) per ogni termine nel vocabolario. L'IDF riflette l'importanza di un termine nell'intero corpus. I termini rari ottengono punteggi IDF più elevati:
IDF(t) = log_e(Total number of documents / Number of documents containing term t)Transform:
- Tokenizzazione: suddivide i documenti in singoli termini (parole o frasi)
Calcolo della frequenza dei termini (TF): conta la frequenza con cui ogni termine appare in ogni documento con:
TF(t, d) = (Number of times term t appears in document d) / (Total
number of terms in document d)
Calcolo TF-IDF: combina il TF per ogni termine con l' IDF precalcolato per creare un punteggio TF-IDF. Questo punteggio rappresenta l'importanza di un termine in un documento specifico rispetto all'intero corpus.
TF-IDF(t, d) = TF(t, d) * IDF(t)Il vectorizer TF-IDF tenta di assegnare un peso maggiore alle parole di firma nel set di dati, ad esempio "Shirts" o "Dino", rispetto alle parole banali, ad esempio "The", "a" o "of", e conta il numero di volte in cui queste parole di firma vengono utilizzate nel documento specificato. Ogni valore di un embedding sparso rappresenta la frequenza di ogni parola in base ai conteggi.
Che cos'è Reciprocal Rank Fusion?
Per unire i risultati di ricerca basati su token e semantici, la ricerca ibrida utilizza Reciprocal Rank Fusion (RRF). RRF è un algoritmo per combinare più elenchi classificati di elementi in una singola classificazione unificata. È una tecnica diffusa per unire i risultati di ricerca provenienti da diverse origini o metodi di recupero, in particolare nei sistemi di ricerca ibrida e nei modelli linguistici di grandi dimensioni.
Nel caso della ricerca ibrida di Vector Search, la distanza densa e la distanza sparsa vengono misurate in spazi diversi e non possono essere confrontate direttamente tra loro. Pertanto, RRF funziona in modo efficace per unire e classificare i risultati dei due spazi diversi.
Ecco come funziona RRF:
- Classificazione reciproca: per ogni elemento in un elenco classificato, calcola la relativa classificazione reciproca. Ciò significa prendere l'inverso della posizione (classificazione) dell'elemento nell'elenco. Ad esempio, l'elemento classificato al primo posto ottiene una classificazione reciproca di 1/1 = 1 e l'elemento classificato al secondo posto ottiene 1/2 = 0, 5.
- Somma delle classificazioni reciproche: somma le classificazioni reciproche per ogni elemento in tutti gli elenchi classificati. In questo modo si ottiene un punteggio finale per ogni elemento.
- Ordina per punteggio finale: ordina gli elementi in base al punteggio finale in ordine decrescente. Gli elementi con i punteggi più alti sono considerati i più pertinenti o importanti.
In breve, gli elementi con classificazioni più elevate nei risultati densi e sparsi verranno spostati in cima all'elenco. Pertanto, l'elemento "Google Blue Kids Sunglasses" è in cima perché ha classificazioni più elevate nei risultati di ricerca densi e sparsi. Gli elementi come "Google White Classic Youth Tee" hanno una classificazione bassa perché hanno classificazioni solo nel risultato di ricerca denso.
Comportamento del parametro alpha
L'esempio di come utilizzare la ricerca ibrida imposta il parametro rrf_ranking_alpha su 0,5 durante la creazione dell'oggetto HybridQuery. Puoi specificare un peso per la classificazione dei risultati di ricerca densi e sparsi utilizzando i seguenti valori per rrf_ranking_alpha:
1o non specificato: la ricerca ibrida utilizza solo i risultati di ricerca densi e ignora i risultati di ricerca sparsi.0: la ricerca ibrida utilizza solo i risultati di ricerca sparsi e ignora i risultati di ricerca densi.0a1: la ricerca ibrida unisce i risultati densi e sparsi con il peso specificato dal valore. 0,5 significa che verranno uniti con lo stesso peso.