

Questa pagina descrive i passaggi per la risoluzione dei problemi, utili in caso di problemi nell'utilizzo dei servizi di machine learning su Gemini Enterprise Agent Platform.
Per filtrare i contenuti di questa pagina, fai clic su un argomento:
Risoluzione dei problemi con le indagini di Cloud Assist
Quando connetti Agent Platform ad altri prodotti Cloud de Confiance , potresti trovare utile Cloud Assist Investigations per risolvere i problemi di integrazione complessi.
- Abilita e configura l'API Cloud Assist Investigations.
- Determina quali dei prodotti da cui dipende il nome del workload sono presenti nell'elenco dei prodotti supportati.
- Crea un'indagine e descrivi i sintomi in dettaglio. Assicurati di menzionare tutte le risorse su cui si basa la pipeline.
- Durante la digitazione, noterai che la finestra di dialogo suggerisce le risorse da aggiungere all'indagine. Esamina questo elenco e aggiungi le risorse pertinenti prima di eseguire l'indagine.
Modelli AutoML
Questa sezione descrive i passaggi per la risoluzione dei problemi che potrebbero esserti utili se riscontri problemi con AutoML.
Etichette mancanti nel set di test, convalida o training set
Problema
Quando utilizzi la suddivisione dei dati predefinita durante l'addestramento di un modello di classificazione AutoML, Agent Platform potrebbe assegnare un numero troppo basso di istanze di una classe a un determinato set (test, convalida o addestramento), causando un errore durante l'addestramento. Questo problema si verifica più di frequente quando hai classi non bilanciate o una piccola quantità di dati di addestramento.
Soluzione
Per risolvere il problema, aggiungi altri dati di addestramento, suddividi manualmente i dati per assegnare un numero sufficiente di classi a ogni set o rimuovi dal set di dati le etichette che si verificano meno di frequente. Per saperne di più, consulta Informazioni sulle suddivisioni dei dati per i modelli AutoML.
Agent Studio su Gemini Enterprise Agent Platform
Quando lavori con Agent Studio, potresti ricevere i seguenti errori:
Il tentativo di ottimizzare un modello restituisce Internal error encountered
Problema
Si verifica un errore Internal error encountered quando provi ad ottimizzare un modello.
Soluzione
Esegui questo comando curl per creare un set di dati Gemini Enterprise Agent Platform vuoto. Assicurati di configurare l'ID progetto nel comando.
PROJECT_ID=PROJECT_ID

curl \
-X POST \
-H "Authorization: Bearer $(gcloud auth print-access-token)" \
-H "Content-Type: application/json" \
https://europe-west4-aiplatform.googleapis.com/ui/projects/$PROJECT_ID/locations/europe-west4/datasets \
-d '{
    "display_name": "test-name1",
    "metadata_schema_uri": "gs://google-cloud-aiplatform/schema/dataset/metadata/image_1.0.0.yaml",
    "saved_queries": [{"display_name": "saved_query_name", "problem_type": "IMAGE_CLASSIFICATION_MULTI_LABEL"}]
}'
Al termine del comando, attendi cinque minuti e riprova l'ottimizzazione del modello.
Codice di errore: 429
Problema
Viene visualizzato il seguente errore:
429: The online prediction request quota is exceeded for
PUBLIC_BASE_MODEL_NAME.
Soluzione
Riprova più tardi con backoff. Se gli errori persistono, contatta l'assistenza di Gemini Enterprise Agent Platform.
Codice di errore: 410
Problema
Viene visualizzato il seguente errore:
410: The request is missing the required authentication credential. Expected
OAuth 2.0 access token, login cookie, or other valid authentication credential.
Soluzione
Per saperne di più, consulta la Panoramica dell'autenticazione.
Codice di errore: 403
Problema
Viene visualizzato il seguente errore:
403: Permission denied.
Soluzione
Assicurati che l'account che accede all'API disponga delle autorizzazioni corrette.
Pipeline Agent Platform
Questa sezione descrive i passaggi per la risoluzione dei problemi che potrebbero esserti utili se riscontri problemi con le pipeline della piattaforma degli agenti.
Non hai l'autorizzazione per agire come account di servizio
Problema
Quando esegui il workflow delle pipeline di Gemini Enterprise Agent Platform, potresti visualizzare il seguente messaggio di errore:
You do not have permission to act as service account: SERVICE_ACCOUNT. (or it may not exist).
Soluzione
Questo errore indica che il account di servizio che esegue il workflow non ha accesso alle risorse che deve utilizzare.
Per risolvere il problema, concedi all'utente l'autorizzazione iam.serviceAccounts.actAs sul account di servizio.
Errore: gli hash dei pacchetti Python non corrispondono nel componente delle pipeline di Gemini Enterprise Agent Platform
Problema
Quando esegui il workflow delle pipeline di Gemini Enterprise Agent Platform, potresti riscontrare il seguente errore:
ERROR: THESE PACKAGES DO NOT MATCH THE HASHES FROM THE REQUIREMENTS FILE. If you have updated the package versions, please update the hashes. Otherwise, examine the package contents carefully; someone may have tampered with them.
Ciò è causato da conflitti di versione tra le librerie Python nell'immagine di base per il componente Gemini Enterprise Agent Platform Pipelines e quelle che la pipeline tenta di installare.
Soluzione
Crea tutte le dipendenze elencate insieme a questo messaggio nell'immagine utilizzata dal componente Gemini Enterprise Agent Platform Pipelines.
Campo Internal error happened dell'errore
Problema
Se la pipeline non va a buon fine con un messaggio Internal error happened, controlla Esplora log e cerca il nome della pipeline. Potresti visualizzare un errore simile al seguente:
java.lang.IllegalStateException: Failed to validate vpc network projects/PROJECT_ID/global/networks/VPC_NETWORK.APPLICATION_ERROR;google.cloud.servicenetworking.v1/ServicePeeringManagerV1.GetConsumerConfig;Reserved range: 'RANGE_NAME' not found for consumer project: 'PROJECT_ID' network: 'VPC_NETWORK'. com.google.api.tenant.error.TenantManagerException: Reserved range: 'RANGE_NAME' not found for consumer project
Ciò significa che il peering VPC per Agent Platform include un intervallo IP che è stato eliminato.
Soluzione
Per risolvere il problema, aggiorna il peering VPC utilizzando il comando update e includi intervalli IP validi.
Ambito OAuth o audience del token ID forniti non validi
Problema
Quando esegui il workflow delle pipeline di Gemini Enterprise Agent Platform, viene visualizzato il seguente messaggio di errore:
google.auth.exceptions.RefreshError: ('invalid_scope: Invalid OAuth scope
or ID token audience provided.', {'error': 'invalid_scope',
'error_description': 'Invalid OAuth scope or ID token audience provided.'})
Soluzione
Ciò significa che non hai fornito le credenziali in uno dei componenti della pipeline o non hai utilizzato ai_platform.init() per impostare le credenziali.
Per risolvere il problema, imposta le credenziali per il componente della pipeline pertinente o imposta le credenziali dell'ambiente e utilizza ai_platform.init() all'inizio del codice.
os.environ['GOOGLE_APPLICATION_CREDENTIALS'] = PATH_TO_JSON_KEY
I componenti delle pipeline di Agent Platform richiedono più di 100 GB di spazio su disco
Problema
Lo spazio su disco predefinito allocato ai componenti delle pipeline di Agent Platform è di 100 GB e l'aumento dello spazio su disco non è supportato. Consulta l'Issue Tracker pubblico per questo problema.
Soluzione
Affinché un componente possa utilizzare più di 100 GB di spazio su disco, convertilo in un job personalizzato utilizzando il metodo dei componenti. Con questo operatore, puoi assegnare il tipo di macchina e la dimensione del disco utilizzati dal componente.
Per un esempio di come utilizzare questo operatore, consulta Agent Platform Pipelines: Custom training with prebuilt Cloud de Confiance by S3NS Pipeline Components, nella sezione Convert the component to an Agent Platform job personalizzato.
Problemi di networking di Agent Platform
Questa sezione descrive i passaggi per la risoluzione dei problemi che potrebbero esserti utili se riscontri problemi con il networking per la piattaforma dell'agente.
gcloud services vpc-peerings get-vpc-service-controls \
  --network YOUR_NETWORK
I workload non possono accedere agli endpoint nella tua rete VPC quando utilizzano intervalli IP pubblici utilizzati privatamente per Gemini Enterprise Agent Platform
Problema
Gli intervalli IP pubblici utilizzati privatamente non vengono importati per impostazione predefinita.
Soluzione
Per utilizzare intervalli IP pubblici utilizzati privatamente, devi abilitare l'importazione di intervalli IP pubblici utilizzati privatamente.
com.google.api.tenant.error.TenantManagerException:
Reserved range: nnn not found for consumer project
Problema
Ricevi errori nel formato com.google.api.tenant.error.TenantManagerException:
Reserved range: nnn not found for consumer project durante l'esecuzione dei workload o il deployment degli endpoint.
Questo accade quando modifichi le prenotazioni di accesso privato ai servizi per i tuoi workload. Gli intervalli eliminati potrebbero non essere stati registrati con l'API Agent Platform.
Soluzione
Esegui gcloud services vpc-peerings update per servicenetworking dopo aver aggiornato le allocazioni di accesso privato ai servizi.
La pipeline o il job non possono accedere agli endpoint all'interno della tua rete VPC in peering
Problema
La pipeline di Gemini Enterprise Agent Platform va in timeout quando tenta di connettersi alle risorse nella tua rete VPC.
Soluzione
Per risolvere il problema, prova quanto segue:
- Assicurati di aver completato tutti i passaggi descritti in Configura il peering di rete VPC.
Esamina la configurazione della rete VPC in peering. Assicurati che la tua rete importi le route dall'intervallo di networking dei servizi corretto mentre il job è in esecuzione.
Assicurati di avere una regola firewall che consenta le connessioni da questo intervallo alla destinazione nella tua rete.
Se la connessione in peering non importa route mentre il job è in esecuzione, significa che la configurazione di networking dei servizi non è in uso. Questo è probabilmente dovuto al fatto che hai completato la configurazione del peering con una rete diversa da quella predefinita. In questo caso, assicurati di specificare la tua rete quando avvii un job. Utilizza il nome completo della rete nel seguente formato:
projects/$PROJECT_ID/global/networks/$NETWORK_NAME.Per saperne di più, consulta la panoramica del percorso.
La pipeline o il job non possono accedere agli endpoint in altre reti oltre alla tua rete
Problema
La pipeline o il job non può accedere agli endpoint in reti esterne alla tua rete.
Soluzione
Per impostazione predefinita, la configurazione del peering esporta solo le route alle subnet locali nel VPC.
Inoltre, il peering transitivo non è supportato e solo le reti in peering diretto possono comunicare.
- Per consentire a Gemini Enterprise Agent Platform di connettersi tramite la tua rete e raggiungere gli endpoint in altre reti, devi esportare le route di rete nella connessione in peering. Modifica la configurazione della rete VPC in peering e attiva
Export custom routes.
Poiché il peering transitivo non è supportato, Gemini Enterprise Agent Platform non apprende le route verso altre reti e servizi in peering, anche con Export Custom Routes abilitato. Per informazioni sulle soluzioni alternative, consulta
Estensione della connettività di rete delle pipeline della piattaforma agente.
No route to host senza conflitti di route evidenti nella console Cloud de Confiance
Problema
Le uniche route che puoi visualizzare nella console Cloud de Confiance sono quelle note al tuo VPC, nonché gli intervalli riservati quando completi la configurazione del peering di rete VPC.
In rare occasioni, un job di Gemini Enterprise Agent Platform potrebbe generare un reclamo no route to host
quando tenta di raggiungere un indirizzo IP che il tuo VPC sta esportando nella rete di Gemini Enterprise Agent Platform.
Questo potrebbe essere dovuto al fatto che i job di Gemini Enterprise Agent Platform vengono eseguiti all'interno di uno spazio dei nomi di networking in un cluster GKE gestito il cui intervallo IP è in conflitto con l'IP di destinazione. Per saperne di più, consulta Concetti fondamentali di networking GKE.
In queste condizioni, il workload tenta di connettersi all'IP all'interno del proprio spazio dei nomi di networking e genera l'errore se non riesce a raggiungerlo.
Soluzione
Crea il tuo workload in modo che restituisca gli indirizzi IP dello spazio dei nomi locale e verifica che non siano in conflitto con le route che stai esportando tramite la connessione in peering.
In caso di conflitto, passa un elenco di reservedIpRanges[] nei parametri del job che non si sovrappongono ad alcun intervallo nella tua rete VPC.
Il job utilizza questi intervalli per gli indirizzi IP interni del workload.
RANGES_EXHAUSTED, RANGES_NOT_RESERVED
Problema
Gli errori nel formato RANGES_EXHAUSTED, RANGES_NOT_RESERVED e RANGES_DELETED_LATER indicano un problema con la configurazione del peering di rete VPC sottostante. Si tratta di errori di rete e non di errori del servizio Agent Platform stesso.
Soluzione
Quando si verifica un errore RANGES_EXHAUSTED, devi innanzitutto valutare se questo reclamo è valido.
Consulta la tabella dei suggerimenti per le subnet per assicurarti che la prenotazione IP per l'accesso privato ai servizi sia sufficientemente ampia da supportare il tuo workload.
Visita Network Analyzer nella console Cloud e cerca insight del tipo "Riepilogo dell'allocazione degli indirizzi IP" nella rete VPC. Se questi indicano che l'allocazione è pari o vicina al 100%, puoi eseguire uno dei seguenti passaggi:
- Aggiungi un nuovo intervallo alla prenotazione o estendi quello esistente. Ricorda che tutti gli intervalli devono essere contigui.
- Se hai intervalli IP non contigui allocati, ma non utilizzati, avvia nuovi workload di Gemini Enterprise Agent Platform in un'altra regione.
Considera anche il numero massimo di job paralleli che possono essere eseguiti con una prenotazione di una determinata dimensione.
Per saperne di più, consulta Errori di convalida di Service Infrastructure
Se l'errore persiste, contatta l'assistenza.
Router status is temporarily unavailable
Problema
Quando avvii le pipeline di Agent Platform, ricevi un messaggio di errore simile al seguente:
Router status is temporarily unavailable. Please try again later
Soluzione
Il messaggio di errore indica che si tratta di una condizione temporanea. Prova ad avviare di nuovo Agent Platform Pipelines.
Se l'errore persiste, contatta l'assistenza.
I workload non riescono a risolvere i nomi host per i domini DNS nel tuo VPC
Problema
I workload di Gemini Enterprise Agent Platform non riescono a connettersi ai nomi host configurati nel VPC. Hai già confermato che questi nomi host sono accessibili dai client all'interno del tuo VPC.
Questo perché i workload vengono eseguiti in un progetto gestito da Google. Il VPC in questo ambiente gestito deve essere in peering con il tuo per utilizzare le tue risorse di networking. Inoltre, tutte le zone DNS a cui questi workload devono accedere devono essere condivise specificamente con il VPC gestito da Google.
Soluzione
- Assicurati di aver configurato il peering di rete VPC per Gemini Enterprise Agent Platform nella tua rete VPC.
Completa i passaggi per condividere la tua zona DNS privata con la rete producer di Gemini Enterprise Agent Platform. Tieni presente che la procedura dipende dal tuo caso d'uso:
Assicurati che i workload di Gemini Enterprise Agent Platform vengano avviati con il flag
--networkche specifica la tua rete VPC. In questo modo, possono essere eseguiti nella rete gestita da Google e accedere alle zone DNS che hai condiviso.Abilita il logging DNS nella policy dei server DNS, riproduci il problema ed esegui un altro test. Se la risposta DNS del workload ha esito positivo, un filtro di Cloud Logging per
resource.type="dns_query"mostrerà voci di questo tipo:"resource": { "type": "dns_query", "labels": { "location": REGION, "project_id": PROJECT_ID, "source_type": "peering-zone", "target_name": "QUERY_TARGET, "target_type": "forwarding-zone" } }Verifica che una query DNS da un'istanza nella stessa subnet possa risolvere i nomi host utilizzando il tuo server DNS.
Se il server DNS non si trova in Cloud de Confiance, assicurati che le regole firewall remote consentano le connessioni da
35.199.192.0/19.Esegui un test di connettività dall'istanza di test alla porta
53/UDPsull'indirizzo IP del server DNS. Ad esempio, se il percorso porta a una regola di forwarding, assicurati che:- Se si tratta di una regola di forwarding regionale, deve trovarsi nella stessa regione del client.
- Accetta le connessioni su
53/UDPe le inoltra al server DNS corretto.
Problemi di connettività causati da comportamenti lato client
Se riscontri problemi di connettività quando provi a utilizzare le API Cloud de Confiance by S3NS, la causa principale potrebbe essere lato client. Questa sezione suggerisce soluzioni lato client che potrebbero migliorare la tua esperienza.
Reimpostazione delle connessioni e pacchetti eliminati
Problema
Quando provi a utilizzare le API Cloud de Confiance , si verificano reimpostazioni della connessione e pacchetti persi.
Soluzione
Per risolvere il problema, tieni presente quanto segue:
- Per un traffico di transazioni ad alto volume con requisiti di bassa latenza, valuta se eventuali problemi noti con le schede di linea dei client on-premise potrebbero causare la reimpostazione delle connessioni TCP o la perdita di pacchetti.
- Valuta se i servizi lato client nel percorso della richiesta utilizzano iptables. Questi possono includere cluster Kubernetes o alcuni firewall stateful e dispositivi NAT. Per impostazione predefinita, il sottosistema di monitoraggio delle connessioni Linux (conntrack) segue rigorosamente le specifiche del protocollo TCP e, ad esempio, elimina i pacchetti TCP fuori sequenza. Per disattivare questo comportamento, attiva il parametro del kernel Linux
net.netfilter.nf_conntrack_tcp_be_liberalo il suo equivalente.
Connessioni incomplete
Problema
Quando provi a utilizzare le API Cloud de Confiance , le connessioni sono incomplete.
Soluzione
Per risolvere il problema, tieni presente quanto segue:
- Quando il percorso di andata ha più route di ritorno al client, assicurati di comprendere il concetto di Reverse Path Forwarding. Disattiva questo comportamento se sospetti che blocchi le connessioni.
- Per le connessioni con bilanciamento del carico, valuta se le regole del firewall in entrata consentono i pacchetti di risposta a entrambi i bilanciatori del carico.
Altri problemi di connessione non relativi alle API
Per risolvere i problemi di connessione non API, tieni presente quanto segue:
- Se nel percorso della richiesta sono presenti proxy, valuta se possono introdurre uno dei problemi che stai riscontrando. Consulta la documentazione e assicurati di risolvere i problemi del proxy quando si verificano problemi come latenza inspiegabile, connessioni interrotte, override DNS, blocchi multiorigine e altri problemi simili.
- In particolare, quando gestisci le risposte
429dalle API Cloud de Confiance , la logica lato client che riprova immediatamente la connessione può peggiorare il problema. Assicurati di comprendere e implementare il backoff esponenziale quando implementi i nuovi tentativi.
Inferenza di Agent Platform
Questa sezione descrive i passaggi per la risoluzione dei problemi che potresti trovare utili se riscontri problemi con l'inferenza della piattaforma agente.
Errore di superamento della quota batch
Problema
Quando esegui job di inferenza batch, ricevi un errore simile al seguente.
Quota exhausted. Please reach out to ai-platform-unified-feedback@google.com for
batch prediction quota increase.
Un job di previsione in batch di Gemini Enterprise Agent Platform utilizza la quota del progetto tenant di previsione in batch. Per ulteriori informazioni sulla richiesta di un aumento della quota, consulta Quote e limiti di Gemini Enterprise Agent Platform.
Errore di superamento dei nuovi tentativi
Problema
Quando esegui job di inferenza batch, ricevi un errore simile al seguente, che indica che la macchina che esegue il modello personalizzato potrebbe non essere in grado di completare le inferenze entro il limite di tempo.
('Post request fails. Cannot get predictions. Error: Exceeded retries: Non-OK
result 504 (upstream request timeout) from server, retry=3, elapsed=600.04s.', 16)
Questo può accadere quando il servizio di inferenza della piattaforma agente si registra con il servizio Google Front End, che funge da proxy per le connessioni dal client all'API di inferenza della piattaforma agente.
Il servizio Google Front End interrompe la connessione e restituisce un codice di risposta HTTP 500 al client se non riceve una risposta dall'API entro 10 minuti.
Soluzione
Per risolvere il problema, prova una delle seguenti soluzioni:
- Aumenta i nodi di computing o modifica il tipo di macchina.
- Crea il container di inferenza in modo che invii periodicamente codici di risposta HTTP 102. In questo modo, il timer di 10 minuti sul servizio Google Front End (GFE) viene reimpostato.
Progetto già collegato al VPC
Problema
Quando esegui il deployment di un endpoint, potresti visualizzare un messaggio di errore come il seguente, che indica che gli endpoint della piattaforma agente hanno utilizzato in precedenza una rete Virtual Private Cloud e che le risorse non sono state pulite in modo appropriato.
Currently only one VPC network per user project is supported. Your project is
already linked to
"projects/YOUR_SHARED_VPC_HOST_PROJECT/global/networks/YOUR_SHARED_VPC_NETWORK".
To change the VPC network, please undeploy all Agent Platform deployment
resources, delete all endpoint resources, and then retry creating resources in
30 mins.
Soluzione
Per risolvere il problema, prova a eseguire questo comando in Cloud Shell.
gcloud services vpc-peerings delete \
    --service=servicenetworking.googleapis.com \
    --network=YOUR_SHARED_VPC_NETWORK \
    --project=YOUR_SHARED_VPC_HOST_PROJECT
In questo modo, la vecchia rete VPC viene disconnessa manualmente dal VPC di Service Networking.
Errore di deployment o eliminazione dell'endpoint imprevisti
Problema
Il deployment di un modello non riesce in modo imprevisto, un endpoint risulta eliminato o un modello di cui è stato eseguito il deployment in precedenza non è più disponibile.
Il tuo account di fatturazione potrebbe non essere valido. Se rimane non valido per un periodo di tempo prolungato, alcune risorse potrebbero essere rimosse dai progetti associati al tuo account. Ad esempio, i tuoi endpoint e modelli potrebbero essere eliminati. Le risorse rimosse non sono recuperabili.
Soluzione
Per risolvere il problema, puoi provare quanto segue:
- Verifica lo stato di fatturazione dei progetti.
- Contatta l'assistenza per la fatturazione Cloud per richiedere assistenza in merito a domande sulla fatturazione.
Per saperne di più, consulta Domande sulla fatturazione.
Problemi relativi al account di servizio personalizzato di Agent Platform
Questa sezione descrive le procedure per la risoluzione dei problemi che potrebbero esserti utili se riscontri problemi con i service account.
Il deployment del modello non riesce con l'errore del account di servizio serviceAccountAdmin
Problema
Il deployment del modello non va a buon fine e viene visualizzato un errore simile al seguente:
Failed to deploy model MODEL_NAME to
endpoint ENDPOINT_NAME due to the error: Failed to add IAM policy binding.
Please grant SERVICE_ACC_NAME@gcp-sa-aiplatform.s3ns-system.iam.gserviceaccount.com the
iam.serviceAccountAdmin role on service account
vertex-prediction-role@PROJECT_INFO.s3ns.iam.gserviceaccount.com
Soluzione
Questo errore indica che il account di servizio personalizzato potrebbe non essere stato configurato correttamente. Per creare un account di servizio personalizzato con le autorizzazioni IAM corrette, consulta Utilizza un service account personalizzato.
Impossibile recuperare il token di identità quando si utilizza un account di servizio personalizzato
Problema
Quando utilizzi un account di servizio personalizzato, i job di addestramento eseguiti su una singola replica non possono raggiungere il servizio di metadati di Compute Engine richiesto per recuperare un token.
Verrà visualizzato un errore simile al seguente:
Failed to refresh jwt, retry number 0: ("Failed to retrieve http://metadata.google.internal/computeMetadata/v1/instance/service-accounts/default/identity?audience=...&format=full
from the Google Compute Engine Metadata service. Status: 404 Response:
\nb'Not Found\n'", <google.auth.transport.requests._Response object at
0x7fb19f058c50>)
Soluzione
Per recuperare il token di identità con un account di servizio personalizzato, devi utilizzare iamcredentials.googleapis.com.
Modelli con addestramento personalizzato
Questa sezione descrive i passaggi per la risoluzione dei problemi che potrebbero esserti utili se riscontri problemi con i modelli con addestramento personalizzato.
Problemi di addestramento personalizzato
Durante l'addestramento personalizzato possono verificarsi i seguenti problemi. I problemi si applicano alle risorse CustomJob e HyperparameterTuningJob, incluse quelle create dalle risorse TrainingPipeline.
Codice di errore: 400
Problema
Viene visualizzato il seguente errore:
400 Machine type MACHINE_TYPE is not supported.
Potresti visualizzare questo messaggio di errore se il tipo di macchina selezionato non è supportato per l'addestramento di Gemini Enterprise Agent Platform o se una risorsa specifica non è disponibile nella regione selezionata.
Soluzione
Utilizza solo i tipi di macchine disponibili nelle regioni appropriate.
La replica è stata chiusa con un codice di stato diverso da zero
Problema
Durante l'addestramento distribuito, un errore di un worker causa l'errore dell'addestramento.
Soluzione
Per controllare l'analisi dello stack per il worker, visualizza i log di addestramento personalizzato nella consoleCloud de Confiance .
Visualizza gli altri argomenti per la risoluzione dei problemi per correggere gli errori comuni, quindi crea una nuova risorsa CustomJob, HyperparameterTuningJob o TrainingPipeline. In molti casi, i codici di errore sono causati da problemi nel codice di addestramento, non dal servizio Agent Platform. Per determinare se questo è il caso, puoi eseguire il codice di addestramento sulla tua macchina locale o su Compute Engine.
La replica ha esaurito la memoria
Problema
Può verificarsi un errore se un'istanza di macchina virtuale (VM) di addestramento esaurisce la memoria durante l'addestramento.
Soluzione
Puoi visualizzare la memoria utilizzata dalle VM di addestramento nella console Cloud de Confiance .
Anche se ricevi questo errore, potresti non visualizzare la memoria utilizzata al 100% sulla VM, perché anche i servizi diversi dall'applicazione di addestramento in esecuzione sulla VM consumano risorse. Per i tipi di macchine con meno memoria, altri servizi potrebbero consumare una percentuale di memoria relativamente elevata.
Ad esempio, su una VM n1-standard-4, i servizi possono utilizzare fino al 40% della memoria.
Puoi ottimizzare il consumo di memoria della tua applicazione di addestramento oppure puoi scegliere un tipo di macchina più grande con più memoria.
Risorse insufficienti in una regione
Problema
Si verifica un problema di esaurimento scorte in una regione.
Soluzione
Agent Platform addestra i tuoi modelli utilizzando le risorse Compute Engine. Agent Platform non può pianificare il workload se Compute Engine ha raggiunto la capacità massima per una determinata CPU o GPU in una regione. Questo problema non è correlato alla quota del progetto.
Quando viene raggiunta la capacità di Compute Engine, Agent Platform riprova automaticamente a eseguire CustomJob o HyperparameterTuningJob fino a tre volte. Il job non riesce se tutti i nuovi tentativi non vanno a buon fine.
Un esaurimento delle scorte si verifica di solito quando utilizzi le GPU. Se riscontri questo errore quando utilizzi le GPU, prova a passare a un altro tipo di GPU. Se puoi utilizzare un'altra regione, prova ad addestrare il modello in una regione diversa.
Errore di autorizzazione durante l'accesso a un altro servizio Cloud de Confiance
Se riscontri un errore di autorizzazione durante l'accesso a un altro servizio Cloud de Confiance
dal tuo codice di addestramento (ad esempio:
google.api_core.exceptions.PermissionDenied: 403), potresti avere uno
dei seguenti problemi:
-
Problema
L'agente di servizio o il account di servizio che esegue il codice (l'agente di servizio per il codice personalizzato di Gemini Enterprise Agent Platform per il tuo progetto o un service account personalizzato) non dispone dell'autorizzazione richiesta.
Soluzione
Scopri come concedere le autorizzazioni all'agente di servizio per il codice personalizzato di Gemini Enterprise Agent Platform o configurare un account di servizio personalizzato con le autorizzazioni necessarie.
-
Problema
L'agente di servizio o l'account di servizio che esegue il codice dispone dell'autorizzazione richiesta, ma il codice sta tentando di accedere a una risorsa nel progetto sbagliato. È molto probabile che il problema sia questo se il messaggio di errore fa riferimento a un ID progetto che termina con
-tp.Soluzione
A causa del modo in cui Agent Platform esegue il codice di addestramento, questo problema può verificarsi inavvertitamente se non specifichi esplicitamente un ID progetto o un numero di progetto nel codice.
Scopri come risolvere il problema specificando un ID progetto o un numero di progetto.
-
Problema
Il job di Vertex AI Training viene eseguito correttamente con i dati locali, ma non con i dati di Cloud Storage.
Soluzione
Aggiungi l'autorizzazione
storage.buckets.createal tuo ruolo Gemini Enterprise Agent Platform Custom Code Service Agent per il progetto.Scopri come risolvere il problema aggiungendo ruoli specifici agli agenti di servizio di Agent Platform.
Problemi di prestazioni durante l'utilizzo di Cloud Storage FUSE
Problema
I job Cloud Storage FUSE vengono eseguiti lentamente.
Soluzione
Consulta "Linee guida per l'ottimizzazione delle prestazioni" in Utilizza Cloud Storage come file system montato.
pip install non riesce quando utilizzi KFP con i Controlli di servizio VPC
Problema
Viene visualizzato il seguente errore:
ModuleNotFoundError: No module named MODULE_NAME. WARNING: Retrying (Retry(total=0, connect=None, read=None, redirect=None, status=None)) after connection broken by 'ConnectTimeoutError(<pip._vendor.urllib3.connection.HTTPSConnection object at 0x7f70250bac10>, 'Connection to pypi.org timed out. (connect timeout=15)')': /simple/nltk/
Soluzione
Il perimetro di servizio dei Controlli di servizio VPC blocca l'accesso dalla piattaforma dell'agente alle API e ai servizi di terze parti su internet. Per installare i pacchetti, utilizza packageUris per installare le dipendenze dai bucket Cloud Storage. Per una discussione generale sull'utilizzo di questa tecnica, consulta "Utilizza container personalizzati" in Controlli di servizio VPC con Agent Platform.
Errore interno
Problema
L'addestramento non è riuscito a causa di un errore di sistema.
Soluzione
Il problema potrebbe essere temporaneo; prova a inviare nuovamente CustomJob, HyperparameterTuningJob o TrainingPipeline. Se l'errore persiste, contatta l'assistenza.
Codice di errore 500 quando si utilizza un'immagine container personalizzata
Problema
Visualizzi un errore 500 nei log.
Soluzione
Questo tipo di errore è probabilmente un problema con l'immagine container personalizzata e non un errore di Agent Platform.
Il service account non può accedere al bucket Cloud Storage durante il deployment in un endpoint
Problema
Quando provi a eseguire il deployment di un modello in un endpoint e il tuo account di servizio non dispone dell'accesso storage.objects.list al bucket Cloud Storage correlato, potresti visualizzare il seguente errore:
custom-online-prediction@TENANT_PROJECT_ID.s3ns.iam.gserviceaccount.com
does not have storage.objects.list access to the Cloud Storage bucket.
Per impostazione predefinita, il container personalizzato che esegue il deployment del modello utilizza un account di servizio che non ha accesso al bucket Cloud Storage.
Soluzione
Per risolvere il problema, prova una delle seguenti soluzioni:
Copia il file a cui stai tentando di accedere dal container negli artefatti del modello quando carichi il modello. Gemini Enterprise Agent Platform lo copierà in una posizione a cui ha accesso il account di servizio predefinito, in modo simile a tutti gli altri artefatti del modello.
Copia il file nel container nell'ambito del processo di compilazione del container.
Specifica un service account personalizzato.
Agent Platform Neural Architecture Search
Problemi noti
- Dopo l'annullamento del job NAS, il job principale (padre) si interrompe, ma alcune delle prove secondarie continuano a mostrare lo stato In esecuzione. In questo caso, ignora lo stato della prova secondaria che mostra In esecuzione. Le prove sono state interrotte, ma la UI continua a mostrare lo stato In esecuzione. Se il job principale è stato interrotto, non ti verranno addebitati costi aggiuntivi.
- Dopo aver segnalato i premi nel trainer, attendi (sleep) 10 minuti prima che i job di prova vengano chiusi.
Quando utilizzi Cloud Shell per eseguire
TensorBoard, il link di output generato potrebbe non funzionare. In questo caso, annota il numero di porta, utilizza lo strumento Anteprima web e seleziona il numero di porta corretto per visualizzare i grafici.Accesso allo strumento
Web Preview: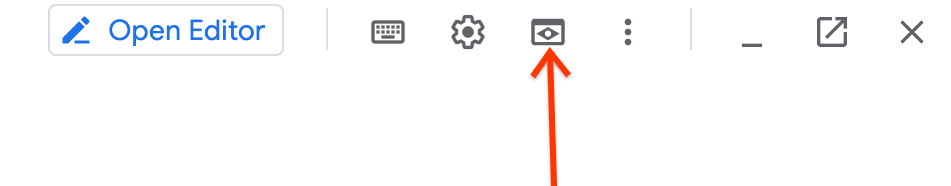
Se nei log del trainer vengono visualizzati messaggi di errore simili ai seguenti:
gcsfuse errors: fuse: writeMessage: no such file or directory [16 0 0 0 218 255 255 255 242 25 111 1 0 0 0 0]utilizza una macchina con più RAM, perché questo errore è causato da una condizione OOM.
Se il tuo addestratore personalizzato non riesce a trovare il flag della directory del job
job-dir, importajob_dircon un trattino basso anziché un trattino. Una nota in tutorial-1 spiega questo aspetto.Errore NaN durante l'addestramento Nel job di addestramento potrebbero verificarsi errori NaN come
NaN : Tensor had NaN
values
. Il tasso di apprendimento potrebbe essere troppo elevato per l'architettura suggerita. Per saperne di più, consulta Errori relativi alla memoria esaurita (OOM) e al tasso di apprendimento.Errore OOM durante l'addestramento Potrebbero verificarsi errori OOM (memoria esaurita) nel job di addestramento. La dimensione del batch potrebbe essere troppo grande per la memoria dell'acceleratore. Per saperne di più, consulta Errori relativi alla memoria esaurita (OOM) e al tasso di apprendimento.
Il job del controller di selezione del modello di attività proxy si interrompe Nel raro caso in cui il job del controller di selezione del modello di attività proxy si interrompa, puoi riprenderlo seguendo questi passaggi.
Il job del controller di ricerca dell'attività proxy si interrompe Nel raro caso in cui il job del controller di ricerca dell'attività proxy si interrompa, puoi riprenderlo seguendo questi passaggi.
Il service account non dispone dell'autorizzazione per accedere ad Artifact Registry o al bucket. Se ricevi un errore come
Agent Platform Service Agent
service-123456789@gcp-sa-aiplatform-cc.s3ns-system.iam.gserviceaccount.com does
not have permission to access Artifact Registry
repository projects/my-project/locations/my-region/repositories/nas
o un errore simile per l'accesso al bucket, assegna a questo account di servizio un ruolo Storage Editor nel tuo progetto.
Agent Platform Feature Store
Questa sezione descrive i passaggi per la risoluzione dei problemi che potrebbero esserti utili se riscontri problemi con Feature Store su Gemini Enterprise Agent Platform.
Errore Resource not found durante l'invio di una richiesta di acquisizione di importazione di flussi di dati o di erogazione online
Problema
Dopo aver configurato un archivio di caratteristiche, un tipo di entità o le risorse delle caratteristiche, si verifica un ritardo prima che queste risorse vengano propagate al servizio FeaturestoreOnlineServingService. A volte questa propagazione ritardata
potrebbe causare un errore resource not found quando invii una richiesta di acquisizione di importazione di flussi di dati
o di erogazione online subito dopo aver creato una risorsa.
Soluzione
Se ricevi questo errore, attendi qualche minuto e riprova.
L'importazione in batch è riuscita per le caratteristiche appena create, ma la richiesta di erogazione online restituisce valori vuoti
Problema
Solo per le funzionalità appena create, esiste un ritardo prima che vengano propagate al servizio FeaturestoreOnlineServingService. Le funzionalità e i valori esistono, ma la loro propagazione richiede tempo. Questo potrebbe comportare la restituzione di valori vuoti per la richiesta di erogazione online.
Soluzione
Se noti questa incoerenza, attendi qualche minuto e poi riprova a inviare la richiesta di erogazione online.
L'utilizzo della CPU è elevato per un nodo di erogazione online
Problema
L'utilizzo della CPU per un nodo di erogazione online è elevato.
Soluzione
Per mitigare questo problema, puoi aumentare il numero di nodi di erogazione online aumentando manualmente il numero di nodi o attivando la scalabilità automatica. Tieni presente che, anche se la scalabilità automatica è abilitata, Agent Platform Feature Store ha bisogno di tempo per riequilibrare i dati quando i nodi vengono aggiunti o rimossi. Per informazioni su come visualizzare le metriche di distribuzione dei valori delle caratteristiche nel tempo, consulta Visualizza le metriche dei valori delle caratteristiche.
L'utilizzo della CPU è elevato per il nodo di erogazione online più attivo
Problema
Se l'utilizzo della CPU è elevato per il nodo più attivo, puoi aumentare il numero di nodi di distribuzione o modificare il pattern di accesso alle entità in pseudo-random.
Soluzione
L'impostazione del pattern di accesso alle entità su pseudo-random riduce l'utilizzo elevato della CPU derivante dall'accesso frequente alle entità che si trovano vicine tra loro nell'archivio di caratteristiche. Se nessuna delle due soluzioni è efficace, implementa una cache lato client per evitare di accedere ripetutamente alle stesse entità.
La latenza di erogazione online è elevata quando le QPS sono basse
Problema
Il periodo di inattività o di attività ridotta con QPS basse potrebbe comportare la scadenza di alcune cache lato server. Ciò può comportare una latenza elevata quando il traffico verso i nodi di erogazione online riprende con QPS regolari o superiori.
Soluzione
Per mitigare questo problema, devi mantenere attiva la connessione inviando un traffico artificiale di almeno 5 QPS all'archivio di caratteristiche.
Il job di importazione batch non va a buon fine dopo sei ore
Problema
Il job di importazione batch può non riuscire perché la sessione di lettura scade dopo sei ore.
Soluzione
Per evitare il timeout, aumenta il numero di worker per completare il job di importazione entro il limite di sei ore.
Errore Resource exceeded durante l'esportazione dei valori delle caratteristiche
Problema
L'esportazione di un volume elevato di dati può non riuscire con un errore di risorse superate se il job di esportazione supera la quota interna.
Soluzione
Per evitare questo errore, puoi configurare i parametri dell'intervallo di tempo, start_time
e end_time, per elaborare quantità di dati inferiori alla volta. Per informazioni sulla pubblicazione dei dati storici delle caratteristiche, consulta Pubblica i valori storici delle caratteristiche.
Agent Platform Vizier
Quando utilizzi Agent Platform Vizier, potresti riscontrare i seguenti problemi.
Errore interno
Problema
L'errore interno si verifica quando si verifica un errore di sistema.
Soluzione
Potrebbe essere temporaneo. Prova a inviare nuovamente la richiesta e, se l'errore persiste, contatta l'assistenza.
Errori di autorizzazione durante l'utilizzo dei ruoli dei account di servizio con Agent Platform
Problema
Ricevi errori di autorizzazioni generali quando utilizzi i ruoli dei account di servizio con la piattaforma dell'agente.
Questi errori possono essere visualizzati in Cloud Logging nei log dei componenti del prodotto o negli audit log. Potrebbero anche essere visualizzati in qualsiasi combinazione dei progetti interessati.
Questi problemi possono essere causati da uno o entrambi i seguenti fattori:
Utilizzo del ruolo
Service Account Token Creatorquando avrebbe dovuto essere utilizzato il ruoloService Account Usero viceversa. Questi ruoli concedono autorizzazioni diverse su un account di servizio e non sono intercambiabili. Per scoprire le differenze tra i ruoliService Account Token CreatoreService Account User, consulta Ruoli dei service account.Hai concesso a un account di servizio le autorizzazioni per più progetti, cosa che non è consentita per impostazione predefinita.
Soluzione
Per risolvere il problema, prova una o più delle seguenti operazioni:
Determina se è necessario il ruolo
Service Account Token CreatoroService Account User. Per saperne di più, consulta la documentazione IAM per i servizi Agent Platform che utilizzi, nonché per qualsiasi altra integrazione di prodotto che utilizzi.Se hai concesso a un account di servizio le autorizzazioni per più progetti, consenti il collegamento dei service account tra i progetti assicurandoti che
iam.disableCrossProjectServiceAccountUsage. non è applicata in modo forzato. Per assicurarti cheiam.disableCrossProjectServiceAccountUsagenon venga applicato, esegui questo comando:gcloud resource-manager org-policies disable-enforce \ iam.disableCrossProjectServiceAccountUsage \ --project=PROJECT_ID