

במאמר הזה מוסבר איך פועל תהליך יצירת הזיכרון, איך להתאים אישית את חילוץ הזיכרון באמצעות נושאים ואיך להפעיל בקשות ליצירת זיכרון.
מידע על הגדרת הסביבה זמין במאמר הגדרה של Memory Bank.
הסבר על תהליך יצירת הזיכרון
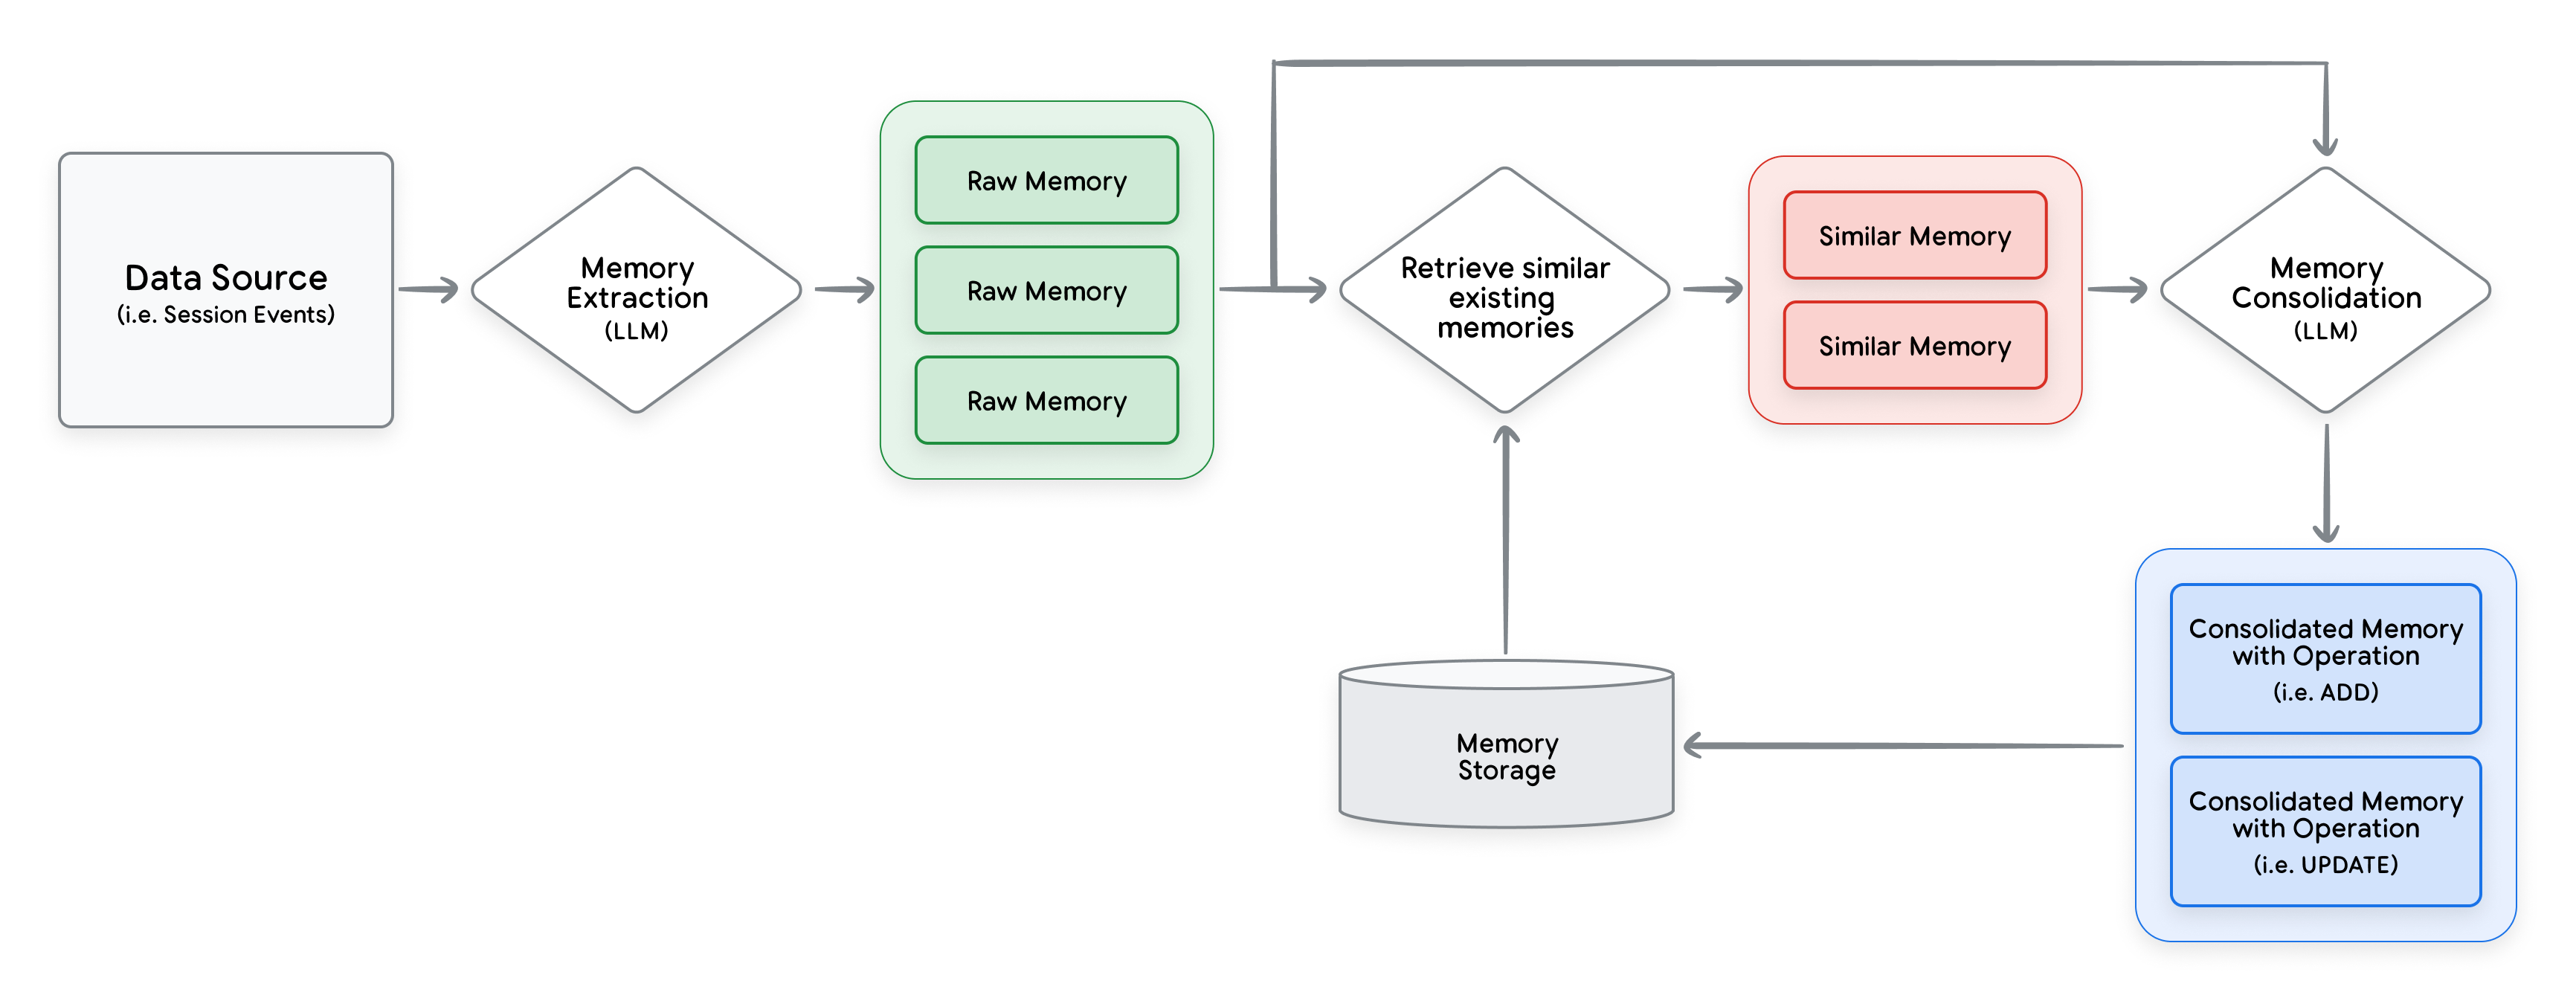
התכונה 'מאגר הזיכרונות' מחלצת זיכרונות מנתוני המקור ומארגנת אותם באופן אוטומטי לאוסף זיכרונות ספציפי (מוגדר על ידי scope) על ידי הוספה, עדכון והסרה של זיכרונות לאורך זמן.
כשמפעילים את תהליך יצירת הזיכרון, Memory Bank מבצע את הפעולות הבאות:
חילוץ: חילוץ מידע על המשתמש מהשיחות שלו עם הסוכן. רק מידע שתואם לפחות לאחד מנושאי הזיכרון של המופע יישמר.
איחוד: המערכת מזהה אם צריך למחוק או לעדכן זיכרונות קיימים באותו היקף על סמך המידע שחולץ. התכונה 'בנק הזיכרון' בודקת שהזיכרונות החדשים לא כפולים או סותרים לפני שהיא ממזגת אותם עם הזיכרונות הקיימים. אם הזיכרונות הקיימים לא חופפים למידע החדש, ייווצר זיכרון חדש.
כברירת מחדל, במהלך האיחוד, Memory Bank יתייחס לכל הזיכרונות הקיימים באותו היקף. אם רוצים להגביל בצורה מפורטת יותר את הזיכרונות שמתאימים לאיחוד באמצעות מטא-נתונים, אפשר להשתמש באסטרטגיית מיזוג המטא-נתונים
REQUIRE_EXACT_MATCH.כברירת מחדל, רק הגרסה האחרונה של הזיכרון משמשת להשוואה. כדי לזהות טוב יותר מגמות לטווח ארוך ולאמת נתונים, אתם יכולים להגדיל את הערך של
revisions_per_candidate_countכשאתם יוצרים את המכונה של Agent Platform, כדי לכלול יותר גרסאות היסטוריות בלוגיקת האיחוד.
אתם יכולים לבדוק את השלבים שמתרחשים בין לבין ביצירת הזיכרון ולראות איך הזיכרון משתנה בין כמה בקשות באמצעות גרסאות של הזיכרון. כל גרסה כוללת את הפלט הזמני של שלב החילוץ (extracted_memories) ואת שלב האיחוד הסופי (fact) לכל בקשה ליצירת זיכרון.
list(client.memory_banks.memories.revisions.list(
  name="projects/.../locations/.../reasoningEngines/.../memories/.../revisions/..."))

"""
[
  MemoryRevision(
    name="projects/123/locations/us-central1/reasoningEngines/456/memories/789/revision/456",
    fact="This is my updated fact",
    extracted_memories=[
      IntermediateExtractedMemory(
        fact='This is the output of extraction for a single request.'
      ),
    ],
    ...
  ),
  MemoryRevision(
    name="projects/123/locations/us-central1/reasoningEngines/456/memories/789/revision/123",
    fact="This is my original fact",
    extracted_memories=[
      IntermediateExtractedMemory(
        fact='This is my original fact.'
      ),
    ],
    ...
  )
]
"""
נושאי זיכרונות
התכונה 'נושאי זיכרון' מזהה אילו נתונים ב-Memory Bank נחשבים משמעותיים ולכן צריך לשמור אותם כזיכרונות שנוצרו. ב-Memory Bank יש תמיכה בשני סוגים של נושאי זיכרון:
נושאים מנוהלים: התווית וההוראות מוגדרות על ידי Memory Bank. צריך לציין רק את שם הנושא המנוהל. לדוגמה:
מילון
memory_topic = {
    "managed_memory_topic": {
        "managed_topic_enum": "USER_PERSONAL_INFO"
    }
}
מבוסס-כיתה
from agentplatform.types import ManagedTopicEnum
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopic as MemoryTopic
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopicManagedMemoryTopic as ManagedMemoryTopic

memory_topic = MemoryTopic(
    managed_memory_topic=ManagedMemoryTopic(
        managed_topic_enum=ManagedTopicEnum.USER_PERSONAL_INFO
    )
)
נושאים בהתאמה אישית: התווית וההוראות מוגדרות על ידכם כשמגדירים את המופע של Memory Bank. הם ישמשו בהנחיה לשלב החילוץ של מאגר הזיכרון. לדוגמה:
מילון
memory_topic = {
    "custom_memory_topic": {
        "label": "business_feedback",
        "description": """Specific user feedback about their experience
        at the coffee shop. This includes opinions on drinks, food,
        pastries, ambiance, staff friendliness, service speed,
        cleanliness, and any suggestions for improvement."""
    }
}
מבוסס-כיתה
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopic as MemoryTopic
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopicCustomMemoryTopic as CustomMemoryTopic

memory_topic = MemoryTopic(
    custom_memory_topic=CustomMemoryTopic(
        label="business_feedback",
        description="""Specific user feedback about their experience at
        the coffee shop. This includes opinions on drinks, food,
        pastries, ambiance, staff friendliness, service speed,
        cleanliness, and any suggestions for improvement."""
    )
)
כשמשתמשים בנושאים מותאמים אישית, מומלץ לספק גם דוגמאות של few-shot כדי להדגים איך צריך לחלץ זיכרונות מהשיחה.
כברירת מחדל, ב-Memory Bank נשמרים כל הנושאים המנוהלים הבאים:
פרטי משתמש (
USER_PERSONAL_INFO): מידע חשוב על המשתמש, כמו שמות, קשרים, תחביבים ותאריכים חשובים. לדוגמה, "אני עובד ב-Google" או "יום הנישואין שלי הוא ב-31 בדצמבר".העדפות המשתמש (
USER_PREFERENCES): דברים שהמשתמש אוהב או לא אוהב, סגנונות או דפוסים מועדפים, בין אם הם צוינו במפורש ובין אם לא. לדוגמה, "אני מעדיף את המושב האמצעי".אירועים מרכזיים בשיחה ותוצאות של משימות (
KEY_CONVERSATION_DETAILS): ציוני דרך או מסקנות חשובים בשיחה. לדוגמה, "הזמנתי כרטיסי טיסה הלוך ושוב בין JFK ל-SFO. אני יוצא לחופשה ב-1 ביוני 2025 וחוזר ב-7 ביוני 2025".הוראות מפורשות לזכירה או לשכחה (
EXPLICIT_INSTRUCTIONS): מידע שהמשתמש מבקש מהסוכן לזכור או לשכוח. לדוגמה, אם המשתמש אומר "תזכור שאני משתמש בעיקר ב-Python", Memory Bank יוצר זיכרון כמו "אני משתמש בעיקר ב-Python".
זה שווה לשימוש בקבוצת הנושאים הבאה של זיכרון מנוהל:
מילון
  memory_topics = [
      {"managed_memory_topic": {"managed_topic_enum": "USER_PERSONAL_INFO"}},
      {"managed_memory_topic": {"managed_topic_enum": "USER_PREFERENCES"}},
      {"managed_memory_topic": {"managed_topic_enum": "KEY_CONVERSATION_DETAILS"}},
      {"managed_memory_topic": {"managed_topic_enum": "EXPLICIT_INSTRUCTIONS"}},
  ]
מבוסס-כיתה
from agentplatform.types import ManagedTopicEnum
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopic as MemoryTopic
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopicManagedMemoryTopic as ManagedMemoryTopic

memory_topics = [
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.USER_PERSONAL_INFO)),
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.USER_PREFERENCES)),
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.KEY_CONVERSATION_DETAILS)),
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.EXPLICIT_INSTRUCTIONS)),
]
אם אתם רוצים להתאים אישית את הנושאים שיישמרו ב-Memory Bank, אתם יכולים להגדיר את נושאי הזיכרונות בהגדרות ההתאמה האישית כשאתם מגדירים את Memory Bank.
שימוש במטא-נתונים במהלך האיחוד
אתם יכולים לצרף מטא-נתונים לזיכרונות שנוצרו. מטא-נתונים מאפשרים לאחסן מידע מובנה (מחרוזות, ערכים מסוג double, ערכים בוליאניים או חותמות זמן) לצד עובדה בזיכרון. האפשרות הזו שימושית לסינון או לניהול מחזורי החיים של הזיכרונות.
מילון
import datetime

client.memory_banks.memories.generate(
    ...,
    config={
        "metadata": {
            "my_string_key": {"string_value": "my_string_value"},
            "my_double_key": {"double_value": 123.456},
            "my_boolean_key": {"bool_value": True},
            "my_timestamp_key": {
                "timestamp_value": datetime.datetime(
                    2027, 1, 1, 12, 30, 00, tzinfo=datetime.timezone.utc
                )
            }
        },
        "metadata_merge_strategy": "MERGE"
    },
)
מבוסס-כיתה
import datetime

from agentplatform import types

client.memory_banks.memories.generate(
    ...,
    config=types.GenerateMemoriesConfig(
        metadata={
            "my_string_key": types.MemoryMetadataValue(string_value="my_string_value"),
            "my_double_key": types.MemoryMetadataValue(double_value=123.456),
            "my_boolean_key": types.MemoryMetadataValue(bool_value=True),
            "my_timestamp_key": types.MemoryMetadataValue(
                timestamp_value=datetime.datetime(
                    2027, 1, 1, 12, 30, 00, tzinfo=datetime.timezone.utc
                )
            ),
        },
        metadata_merge_strategy=types.MemoryMetadataMergeStrategy.MERGE,
    )
)
באמצעות metadata_merge_strategy, אתם יכולים לקבוע איך המטא-נתונים החדשים יתקשרו עם הזיכרונות הקיימים במהלך האיחוד:
MERGE: (ברירת מחדל) שילוב של מטא-נתונים חדשים עם מטא-נתונים קיימים. אם המפתח כבר קיים, הערך החדש מחליף את הערך הישן.
OVERWRITE: החלפת המטא-נתונים של הזיכרונות המעודכנים במטא-נתונים החדשים.
REQUIRE_EXACT_MATCH: הגבלת האיחוד לזיכרונות שיש להם בדיוק את אותם מטא-נתונים כמו בבקשה. אם לזיכרון אין את אותם מטא-נתונים, הוא לא כשיר לאיחוד ולא יעודכן.
יצירת זיכרונות בנושאים ספציפיים
כברירת מחדל, תכונת יצירת הזיכרון מחלצת נתונים מכל נושאי הזיכרון שהגדרתם כשקבעתם את הגדרות המופע של מאגר הזיכרונות.
עבור בקשת GenerateMemories ספציפית, אפשר להגביל את החילוץ לקבוצת משנה של נושאים שהוגדרו. כדי להגדיר נושאים מותרים, משתמשים בשדה allowed_topics.
מילון
client.memory_banks.memories.generate(
    ...,
    config={
        "allowed_topics": [
            {"managed_memory_topic": "USER_PERSONAL_INFO"},
            {"custom_memory_topic_label": "business_feedback"}
        ]
    },
)
מבוסס-כיתה
from agentplatform import types

client.memory_banks.memories.generate(
    ...,
    config=types.GenerateMemoriesConfig(
        allowed_topics=[
            types.MemoryTopicId(
                managed_memory_topic=types.ManagedTopicEnum.USER_PERSONAL_INFO
            ),
            types.MemoryTopicId(
                custom_memory_topic_label="business_feedback"
            )
        ]
    )
)
הפעלת יצירת זיכרון
כדי להפעיל את תהליך יצירת הזיכרון, אתם יכולים להשתמש באחת מהשיטות הבאות:
-
GenerateMemories: העברת נתונים ל-Memory Bank והפעלת יצירת הזיכרון באופן מיידי. השיטה הזו שימושית כשרוצים ליצור זיכרונות בנקודת זמן ספציפית, למשל בסוף סשן או במרווחי זמן קבועים במהלך סשן. -
IngestEvents: הטמעת נתונים ב-Memory Bank באופן רציף, ועיבוד הנתונים ב-Memory Bank כשמתקיימים הקריטריונים להפעלה. השיטה הזו שימושית כשיש לכם זרם רציף של אירועים ואתם רוצים ש-Memory Bank יטפל באופן אוטומטי במאגר הנתונים הזמני ויפעיל את תהליך יצירת הזיכרון על סמך נפח או זמן. מידע נוסף זמין במאמר הטמעת אירועים.
בתהליך יצירת הזיכרון, Gemini מחלץ את ההקשר העיקרי מהשיחות ומשלב אותו עם הזיכרונות הקיימים באותו היקף. לדוגמה, אפשר ליצור זיכרונות ברמת הסשן באמצעות היקף כמו {"user_id": "123",
"session_id": "456"}. אפשר לאחד זיכרונות עם אותו היקף ולשלוף אותם יחד.
GenerateMemories היא פעולה ממושכת.
אחרי שהפעולה מסתיימת, התיקייה GenerateMemoriesOperation מכילה רשימה של זיכרונות שנוצרו, אם נוצרו כאלה:
GenerateMemoriesOperation(
  name="projects/.../locations/.../reasoningEngines/.../operations/...",
  done=True,
  response=GenerateMemoriesResponse(
    generatedMemories=[
      GenerateMemoriesResponseGeneratedMemory(
        memory=Memory(
          "name": "projects/.../locations/.../reasoningEngines/.../memories/..."
        ),
        action="CREATED",
      ),
      GenerateMemoriesResponseGeneratedMemory(
        memory=Memory(
          "name": "projects/.../locations/.../reasoningEngines/.../memories/..."
        ),
        action="UPDATED",
      ),
      GenerateMemoriesResponseGeneratedMemory(
        memory=Memory(
          "name": "projects/.../locations/.../reasoningEngines/.../memories/..."
        ),
        action="DELETED",
      ),
    ]
  )
)
כל זיכרון שנוצר כולל את action שבוצע בזיכרון הזה:
CREATED: מציין שנוסף זיכרון חדש, שמייצג מושג חדש שלא נכלל בזיכרונות הקיימים.
UPDATED: מציין שזיכרון קיים עודכן. זה קורה אם הזיכרון כולל מושגים דומים למידע החדש שחולץ. יכול להיות שהעובדה בזיכרון תעודכן במידע חדש או תישאר ללא שינוי.
DELETED: מציין שהזיכרון הקיים נמחק, כי המידע שבו היה סותר למידע חדש שחולץ מהשיחה.
כדי לשחזר את התוכן המלא של זיכרון CREATED או UPDATED, אפשר להשתמש ב-GetMemories .
שליפת הזיכרונות של DELETED מובילה לשגיאה 404.
הזיכרונות נוצרים ברקע
GenerateMemories היא פעולה ממושכת. כברירת מחדל, client.memory_banks.memories.generate היא פונקציית חסימה שדוגמת את הפעולה עד שהיא מסתיימת. הפעלת יצירת זיכרונות כפעולה חוסמת שימושית כשרוצים לבדוק ידנית את הזיכרונות שנוצרו או להודיע למשתמשי הקצה אילו זיכרונות נוצרו.
עם זאת, בנציגים בסביבת הייצור, בדרך כלל כדאי להריץ את תהליך יצירת הזיכרון ברקע כתהליך אסינכרוני. ברוב המקרים, הלקוח לא צריך להשתמש בפלט של ההרצה הנוכחית, ולכן אין צורך להוסיף זמן אחזור בהמתנה לתשובה. אם רוצים שתהליך יצירת הזיכרון יתבצע ברקע, מגדירים את wait_for_completion ל-False:
client.memory_banks.memories.generate(
    ...,
    config={
        "wait_for_completion": False
    }
)
במקום להפעיל את GenerateMemories באופן אסינכרוני, אפשר להשתמש ב-IngestEvents, שמפריד בין קליטת האירועים לבין יצירת הזיכרון, ומעבד את האירועים ברקע כברירת מחדל.
מקורות נתונים
יש כמה דרכים לספק נתוני מקור ליצירת זיכרון:
מספקים עובדות שחולצו מראש כדי לאחד אותן עם זיכרונות קיימים באותו היקף.
כשמספקים אירועים ישירות במטען הייעודי (payload) או משתמשים בסשנים, המידע מחולץ מהשיחה ומאוחד עם הזיכרונות הקיימים. אם אתם רוצים רק לחלץ מידע ממקורות הנתונים האלה, אתם יכולים להשבית את האיחוד:
client.memory_banks.memories.generate(
    ...
    config={
        "disable_consolidation": True
    }
)
שימוש באירועים במטען הייעודי (payload) כמקור הנתונים
משתמשים ב-direct_contents_source כשרוצים ליצור זיכרונות באמצעות אירועים שמופיעים ישירות במטען הייעודי (payload). מידע משמעותי מחולץ מהאירועים האלה ומאוחד עם מידע קיים באותו היקף. אפשר להשתמש בגישה הזו אם אתם משתמשים באחסון סשנים שונה מזה של סשנים בפלטפורמת הסוכנים.
מילון
האירועים צריכים לכלול מילונים מסוג
Content.
events =  [
  {
    "content": {
      "role": "user",
      "parts": [
        {"text": "I work with LLM agents!"}
      ]
    }
  }
]

client.memory_banks.memories.generate(
    name=memory_bank.name,
    direct_contents_source={
      "events": EVENTS
    },
    # For example, `scope={"user_id": "123"}`.
    scope=SCOPE,
    config={
        "wait_for_completion": True
    }
)
מחליפים את מה שכתוב בשדות הבאים:
-
SCOPE: מילון שמייצג את היקף הזיכרונות שנוצרו. לדוגמה,{"session_id": "MY_SESSION"}. רק פרטים עם אותו היקף נלקחים בחשבון לאיחוד.
מבוסס-כיתה
האירועים צריכים לכלול אובייקטים של Content.
from google import genai
from agentplatform import types

events = [
  types.GenerateMemoriesRequestDirectContentsSourceEvent(
    content=genai.types.Content(
      role="user",
      parts=[
        genai.types.Part.from_text(text="I work with LLM agents!")
      ]
    )
  )
]

client.memory_banks.memories.generate(
    name=memory_bank.name,
    direct_contents_source={
      "events": events
    },
    # For example, `scope={"user_id": "123"}`.
    scope=SCOPE,
    config={
        "wait_for_completion": True
    }
)
מחליפים את מה שכתוב בשדות הבאים:
-
SCOPE: מילון שמייצג את היקף הזיכרונות שנוצרו. לדוגמה,{"session_id": "MY_SESSION"}. רק זיכרונות עם אותו היקף נלקחים בחשבון לאיחוד.
שימוש בסשנים של פלטפורמת הסוכנים כמקור הנתונים
ב-Sessions, בנק הזיכרון משתמש באירועי סשן כמקור לשיחה ליצירת הזיכרון.
כדי להגדיר את היקף הזיכרונות שנוצרו, Memory Bank מחלץ ומשתמש במזהה המשתמש מהסשן כברירת מחדל. לדוגמה, היקף הזיכרונות נשמר בתור {"user_id": "123"} אם user_idשל הסשן הוא "123". אפשר גם לספק scope ישירות, ואז הוא יחליף את השימוש ב-user_id של הסשן כהיקף.
מילון
client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source={
      # For example, projects/.../locations/.../reasoningEngines/.../sessions/...
      "session": "SESSION_NAME"
  },
  # Optional when using Sessions. Defaults to {"user_id": session.user_id}.
  scope=SCOPE,
  config={
      "wait_for_completion": True
  }
)
מחליפים את מה שכתוב בשדות הבאים:
SESSION_NAME: שם הסשן המלא.(אופציונלי)
SCOPE: מילון שמייצג את היקף הזיכרונות שנוצרו. לדוגמה,{"session_id": "MY_SESSION"}. רק זיכרונות עם אותו היקף נלקחים בחשבון לאיחוד. אם לא מציינים ערך, המערכת משתמשת בערך{"user_id": session.user_id}.
מבוסס-כיתה
from agentplatform import types

client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source=types.GenerateMemoriesRequestVertexSessionSource(
      # For example, projects/.../locations/.../reasoningEngines/.../sessions/...
      session="SESSION_NAME"
  ),
  # Optional when using Sessions. Defaults to {"user_id": session.user_id}.
  scope=SCOPE,
  config={
      "wait_for_completion": True
  }
)
אפשר גם לציין טווח תאריכים כדי להגדיר אילו אירועים בסשן ייכללו. אם לא מציינים ערך, כל האירועים בסשן נכללים.
מילון
import datetime

client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source={
      "session": "SESSION_NAME",
      # Extract memories from the last hour of events.
      "start_time": datetime.datetime.now(tz=datetime.timezone.utc) - datetime.timedelta(seconds=24 * 60),
      "end_time": datetime.datetime.now(tz=datetime.timezone.utc)
  },
  scope=SCOPE
)
מבוסס-כיתה
import datetime

from agentplatform import types

client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source=types.GenerateMemoriesRequestVertexSessionSource(
      session="SESSION_NAME",
      # Extract memories from the last hour of events.
      start_time=datetime.datetime.now(tz=datetime.timezone.utc) - datetime.timedelta(seconds=24 * 60),
      end_time=datetime.datetime.now(tz=datetime.timezone.utc)
  ),
  scope=SCOPE
)
איחוד זיכרונות שחולצו מראש
במקום להשתמש בתהליך החילוץ האוטומטי של Memory Bank, אפשר לספק זיכרונות שחולצו מראש. זיכרונות ממקור ישיר יאוחדו עם זיכרונות קיימים באותו היקף. זה יכול להיות שימושי כשרוצים שהנציג או האדם שבתהליך יהיו אחראים לחילוץ הזיכרונות, אבל עדיין רוצים לנצל את היתרונות של איחוד הזיכרונות ב-Memory Bank כדי לוודא שאין זיכרונות כפולים או סותרים.
client.memory_banks.memories.generate(
    name=memory_bank.name,
    direct_memories_source={"direct_memories": [{"fact": "FACT"}]},
    scope=SCOPE
)
מחליפים את מה שכתוב בשדות הבאים:
FACT: עובדה שחולצה מראש וצריך לאחד אותה עם זיכרונות קיימים. אפשר לספק עד 5 עובדות שחולצו מראש ברשימה כמו זו:{"direct_memories": [{"fact": "fact 1"}, {"fact": "fact 2"}]}
SCOPE: מילון שמייצג את היקף הזיכרונות שנוצרו. לדוגמה,{"session_id": "MY_SESSION"}. רק זיכרונות עם אותו היקף נלקחים בחשבון לאיחוד.
שימוש בקלט מולטימודאלי
אתם יכולים לחלץ זיכרונות מקלט רב-אופני. עם זאת, הזיכרונות נשלפים רק מטקסט, מקבצים מוטבעים ומנתוני קבצים בתוכן המקור. כל התוכן האחר, כולל בקשות להפעלת פונקציות ותשובות, לא נכלל ביצירת הזיכרונות.
אפשר לחלץ זיכרונות מתמונות, מסרטונים ומאודיו שהמשתמש מספק. אם ההקשר שסופק על ידי הקלט המולטימודלי נחשב על ידי Memory Bank כמשמעותי לאינטראקציות עתידיות, יכול להיות שייווצר זיכרון טקסטואלי שכולל מידע שחולץ מהקלט. לדוגמה, אם המשתמש מספק תמונה של גולדן רטריבר עם הטקסט "זה הכלב שלי", אז מאגר הזיכרונות יוצר זיכרון כמו "הכלב שלי הוא גולדן רטריבר".
לדוגמה, אתם יכולים לספק תמונה והקשר שלה במטען הייעודי (payload):
מילון
with open(file_name, "rb") as f:
    inline_data = f.read()

events =  [
  {
    "content": {
      "role": "user",
      "parts": [
        {"text": "This is my dog"},
        {
          "inline_data": {
            "mime_type": "image/jpeg",
            "data": inline_data
          }
        },
        {
          "file_data": {
            "file_uri": "gs://cloud-samples-data/generative-ai/image/dog.jpg",
            "mime_type": "image/jpeg"
          }
        },
      ]
    }
  }
]
מבוסס-כיתה
from google import genai
from agentplatform import types

with open(file_name, "rb") as f:
    inline_data = f.read()

events = [
  types.GenerateMemoriesRequestDirectContentsSourceEvent(
    content=genai.types.Content(
      role="user",
      parts=[
        genai.types.Part.from_text(text="This is my dog"),
        genai.types.Part.from_bytes(
          data=inline_data,
          mime_type="image/jpeg",
        ),
        genai.types.Part.from_uri(
          file_uri="gs://cloud-samples-data/generative-ai/image/dog.jpg",
          mime_type="image/jpeg",
        )
      ]
    )
  )
]