

En esta página, se proporciona una descripción general conceptual de Google Kubernetes Engine (GKE) para cargas de trabajo de IA/ML. GKE es una implementación administrada por Google de la plataforma de organización de contenedores de código abierto de Kubernetes.
Google Kubernetes Engine proporciona una plataforma escalable, flexible y rentable para ejecutar todas tus cargas de trabajo alojadas en contenedores, incluidas las aplicaciones de inteligencia artificial y aprendizaje automático (IA/AA). Ya sea que entrenes modelos de base grandes, entregues solicitudes de inferencia a gran escala o crees una plataforma de IA integral, GKE ofrece el control y el rendimiento que necesitas.
Esta página está dirigida a especialistas en IA y datos, arquitectos de Cloud, operadores y desarrolladores que buscan una solución de Kubernetes escalable, automatizada y administrada para ejecutar cargas de trabajo de IA/AA. Para obtener más información sobre los roles comunes, consulta Roles y tareas comunes del usuario de GKE.
Comienza a usar cargas de trabajo de IA/AA en GKE
Puedes comenzar a explorar GKE en minutos con el nivel gratuito de GKE, que te permite comenzar a usar Kubernetes sin incurrir en costos por la administración de clústeres.
- Prueba estas guías de inicio rápido:
- Inferencia en GKE: Implementa un modelo de lenguaje grande (LLM) de IA en GKE para la inferencia con una arquitectura predefinida.
- Entrenamiento en GKE: Implementa un modelo de entrenamiento de IA en GKE y almacena las predicciones en Cloud Storage.
- Lee Acerca de las opciones de consumo de aceleradores para cargas de trabajo de IA/AA, que tiene orientación y recursos para planificar y obtener aceleradores (GPUs y TPUs) para tu plataforma.
- Obtén asistencia potenciada por IA para planificar y diseñar la infraestructura de tus clústeres de GKE solicitando ayuda a Gemini en la Cloud de Confiance consola. Para obtener más información, consulta Diseña y optimiza clústeres de GKE con Compute Advisor.
Casos de uso habituales
GKE proporciona una plataforma unificada que puede admitir todas tus cargas de trabajo de IA.
- Crea una plataforma de IA: Para los equipos de plataformas empresariales, GKE proporciona la flexibilidad necesaria para crear una plataforma estandarizada de múltiples inquilinos que satisfaga diversas necesidades.
- Entrega en línea de baja latencia: Para los desarrolladores que crean aplicaciones de IA generativa, GKE con Inference Gateway proporciona el enrutamiento optimizado y el escalado automático necesarios para ofrecer una experiencia del usuario responsiva y, al mismo tiempo, controlar los costos.
Elige la plataforma adecuada para tu carga de trabajo de IA/AA
Cloud de Confiance by S3NS ofrece un espectro de productos de infraestructura de IA para respaldar tu recorrido de AA, desde completamente administrados hasta completamente configurables. Elegir la plataforma adecuada depende de tus necesidades específicas de control, flexibilidad y nivel de administración.
Elige GKE cuando necesites un control profundo, portabilidad y la capacidad de compilar una plataforma de IA personalizada y de alto rendimiento.
- Control y flexibilidad de la infraestructura: Necesitas un alto grado de control sobre tu infraestructura, usar canalizaciones personalizadas o realizar personalizaciones a nivel del kernel.
- Entrenamiento e inferencia a gran escala: Deseas entrenar modelos muy grandes o entregar modelos con una latencia mínima, para lo cual puedes usar la escalabilidad y el alto rendimiento de GKE.
- Rentabilidad a gran escala: Deseas priorizar la optimización de costos usando la integración de GKE con las VMs Spot y las VMs Flex-start para administrar los costos de manera eficaz.
- Portabilidad y estándares abiertos: Deseas evitar la dependencia de un solo proveedor y ejecutar tus cargas de trabajo en cualquier lugar con Kubernetes, y ya tienes experiencia en Kubernetes o una estrategia de múltiples nubes.
También puedes considerar estas alternativas:
| Servicio deCloud de Confiance by S3NS | Ideal para |
|---|---|
| Vertex AI | Una plataforma de extremo a extremo completamente administrada para acelerar el desarrollo y descargar la administración de la infraestructura. Funciona bien para los equipos que se enfocan en MLOps y en obtener valor rápidamente. Para obtener más información, mira Cómo elegir entre los modelos de IA alojados en GKE autohospedado y los modelos de IA alojados en Vertex AI administrado. |
Cómo GKE potencia las cargas de trabajo de IA/AA
GKE ofrece un paquete de componentes especializados que simplifican y aceleran cada etapa del ciclo de vida de la IA/AA, desde el entrenamiento a gran escala hasta la inferencia de baja latencia.
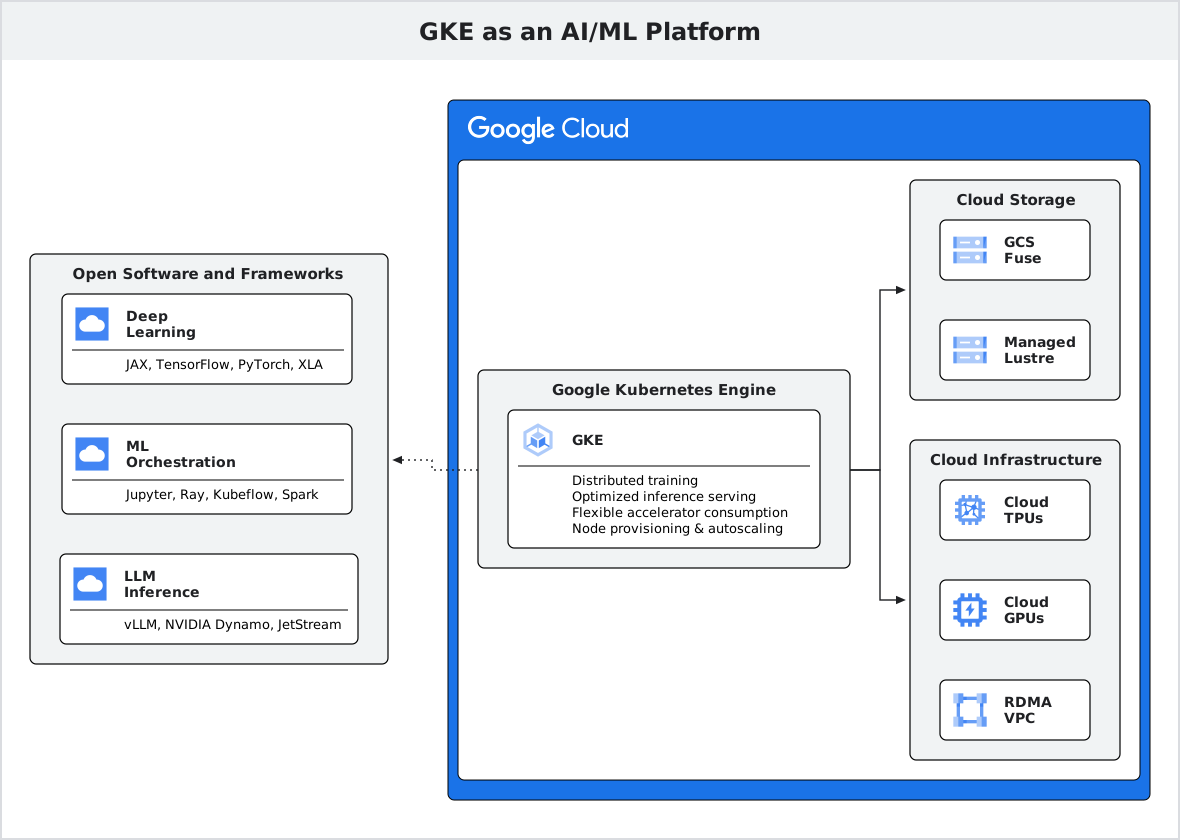
En la siguiente tabla, se resumen las funciones de GKE que admiten tus cargas de trabajo de IA/AA o tus objetivos operativos.
| Carga de trabajo o operación de IA/AA | Cómo te ayuda GKE | Características clave |
|---|---|---|
| Inferencia y publicación | Está optimizada para entregar modelos de IA de forma elástica, con baja latencia, alta capacidad de procesamiento y rentabilidad. |
|
| Entrenamiento y ajuste | Proporciona las capacidades de escala y organización necesarias para entrenar de manera eficiente modelos muy grandes y, al mismo tiempo, minimizar los costos. |
|
¿Qué sigue?
Más información sobre la inferencia de modelos de IA/AA en GKE.
Explora muestras experimentales para aprovechar GKE y acelerar tus iniciativas de IA/AA en GKE AI Labs.
Consulta los detalles de tus cargas de trabajo de IA/AA en la Cloud de Confiance consola, incluidos los recursos como JobSets, RayJobs, PyTorchJobs y Deployments para la publicación de inferencias.