

En este documento, se describe la federación de identidades para cargas de trabajo para GKE, incluido cómo funciona, cómo habilitarla afecta a tus clústeres de GKE y cómo otorgar roles a las entidades de Kubernetes en las políticas de Identity and Access Management. En la mayoría de los casos, la federación de identidades para cargas de trabajo para GKE es la forma recomendada de ayudar a proteger y administrar cómo las cargas de trabajo que se ejecutan en GKE acceden a los servicios de Cloud de Confiance by S3NS .
Este documento está dirigido a especialistas en seguridad y operadores que administran cargas de trabajo en GKE que requieren acceso a otros servicios de Cloud de Confiance by S3NS. Para obtener más información sobre los roles comunes y las tareas de ejemplo a las que hacemos referencia en el contenido de Cloud de Confiance by S3NS , consulta Roles y tareas comunes del usuario de GKE.
Terminología
En este documento, se distingue entre cuentas de servicio de Kubernetes y cuentas de servicio de Identity and Access Management (IAM).
- Cuentas de servicio de Kubernetes
- Recursos de Kubernetes que proporcionan una identidad para los procesos que se ejecutan en tus Pods de GKE.
- Cuentas de servicio de IAM
- Cloud de Confiance by S3NS recursos que permiten a las aplicaciones realizar llamadas autorizadas a las APIs deCloud de Confiance by S3NS
¿Qué es la federación de identidades para cargas de trabajo para GKE?
Es posible que las aplicaciones que se ejecutan en GKE necesiten acceso a las APIs deCloud de Confiance by S3NS , como la API de Compute Engine, la API de BigQuery Storage o las APIs de aprendizaje automático.
Workload Identity Federation for GKE te permite usar políticas de IAM para otorgar a las cargas de trabajo de Kubernetes en tu clúster de GKE acceso a APIs deCloud de Confiance específicas sin necesidad de una configuración manual ni métodos menos seguros, como los archivos de claves de la cuenta de servicio. El uso de la federación de identidades para cargas de trabajo para GKE te permite asignar identidades y autorizaciones distintas y detalladas para cada aplicación en el clúster.
La federación de identidades para cargas de trabajo para GKE reemplaza la necesidad de usar ocultamiento de metadatos. Los metadatos sensibles protegidos con la ocultación de metadatos también están protegidos por la federación de identidades para cargas de trabajo para GKE.
Workload Identity Federation for GKE está disponible a través de la federación de identidades para cargas de trabajo de IAM, que proporciona identidades para las cargas de trabajo que se ejecutan en entornos dentro y fuera de Cloud de Confiance. Puedes usar la federación de identidades para cargas de trabajo de IAM para autenticarte de forma segura en las APIs de Cloud de Confiance compatibles desde cargas de trabajo que se ejecutan en, por ejemplo, AWS, Azure y Kubernetes autoadministrado. En GKE, Cloud de Confiance administra el grupo de identidades para cargas de trabajo y el proveedor por ti y no requiere un proveedor de identidad externo.
Cómo funciona la federación de identidades para cargas de trabajo para GKE
Cuando habilitas la federación de identidades para cargas de trabajo para GKE en un clúster, GKE hace lo siguiente:
Crea un grupo de identidades para cargas de trabajo fijo para el proyecto Cloud de Confiance by S3NSdel clúster con el siguiente formato:
PROJECT_ID.s3ns.svc.id.googEl grupo de identidades para cargas de trabajo proporciona un formato de nombre que permite a IAM comprender y confiar en las credenciales de la cuenta de servicio de Kubernetes. GKE no borra este grupo de identidades para cargas de trabajo, incluso si borras todos los clústeres de tu proyecto.
Registra el clúster de GKE como un proveedor de identidad en el grupo de identidades para cargas de trabajo.
Implementa el servidor de metadatos de GKE, que intercepta las solicitudes de credenciales de las cargas de trabajo en cada nodo.
Crea políticas de permisos de IAM en los recursos de Cloud de Confiance
Para proporcionar acceso con la federación de identidades para cargas de trabajo para GKE, crea una política de permisos de IAM
que otorgue acceso en un recurso específico de Cloud de Confiance
a una principal que corresponda a la identidad de tu aplicación. Por ejemplo, puedes otorgar permisos de lectura en un bucket de Cloud Storage a todos los Pods que usan la ServiceAccount de Kubernetes database-reader.
Para obtener una lista de los recursos que admiten políticas de permisos, consulta Tipos de recursos que aceptan políticas de permisos.
Usa condiciones en las políticas de IAM
También puedes limitar el permiso del acceso si configuras condiciones en las políticas de permisos. Las condiciones son un método extensible para especificar cuándo se debe aplicar una política de permisos. Por ejemplo, podrías usar condiciones para otorgar acceso temporal a una carga de trabajo en un recurso de Cloud de Confiance específico, lo que elimina la necesidad de administrar ese acceso de forma manual.
Las condiciones también pueden ser útiles si configuras tus políticas de permisos a nivel de proyecto, carpeta u organización, en lugar de hacerlo en recursos específicos, como secretos de Secret Manager o buckets de Cloud Storage.
Para agregar una condición a tu política de permisos, usa los siguientes recursos:
- Administra vinculaciones de roles condicionales: Agrega, modifica o quita vinculaciones de roles condicionales.
- Configura el acceso temporal: Usa condiciones para establecer el acceso con vencimiento a los recursos de Cloud de Confiance en las políticas de permisos.
- Etiquetas y acceso condicional: Usa condiciones para aplicar solo políticas de permiso cuando los recursos tengan etiquetas específicas.
Las siguientes expresiones de ejemplo son para situaciones comunes en las que puedes usar condiciones. Para obtener una lista de los atributos disponibles en las expresiones, consulta Referencia de atributos para las condiciones de IAM.
| Ejemplos de expresiones de condición | ||
|---|---|---|
| Permitir el acceso antes de la hora especificada | request.time < timestamp('Reemplaza |
|
| Permite el acceso si el recurso de la solicitud tiene la etiqueta especificada | resource.matchTag('Reemplaza lo siguiente:
|
|
Recursos de referencia de Kubernetes en las políticas de IAM
En tu política de IAM, haces referencia a un recurso de Kubernetes mediante un identificador principal de IAM para seleccionar el recurso. Este identificador tiene la siguiente sintaxis:
PREFIX://iam.googleapis.com/projects/1234567890/locations/global/workloadIdentityPools/example-project.s3ns.svc.id.goog/SELECTOR
En este ejemplo, considera los siguientes campos:
PREFIX: Debe serprincipaloprincipalSet, según el recurso que selecciones.principales para un recurso específico, como una sola ServiceAccount.principalSetes para varios recursos que pertenecen al recurso especificado, como todos los Pods en un clúster específico.SELECTOR: una string que selecciona un tipo de principal. Por ejemplo,kubernetes.serviceaccount.uid/SERVICEACCOUNT_UIDselecciona una ServiceAccount por su UID.
En la siguiente tabla, se muestran los tipos de principales compatibles en GKE:
| Tipo de identificador principal | Sintaxis |
|---|---|
| Todos los pods que usan una ServiceAccount de Kubernetes específica | Selecciona la ServiceAccount por nombre:
principal://iam.googleapis.com/projects/Reemplaza lo siguiente:
Selecciona la ServiceAccount por UID: principal://iam.googleapis.com/projects/Reemplaza lo siguiente:
|
| Todos los Pods en un espacio de nombres, sin importar la cuenta de servicio o el clúster | principalSet://iam.googleapis.com/projects/PROJECT_NUMBER/locations/global/workloadIdentityPools/PROJECT_ID.s3ns.svc.id.goog/namespace/NAMESPACE Reemplaza lo siguiente:
|
| Todos los Pods en un clúster específico | principalSet://iam.googleapis.com/projects/PROJECT_NUMBER/locations/global/workloadIdentityPools/PROJECT_ID.s3ns.svc.id.goog/kubernetes.cluster/https://container.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/clusters/CLUSTER_NAME Reemplaza lo siguiente:
|
Flujo de credenciales
Cuando una carga de trabajo envía una solicitud para acceder a una API de Cloud de Confiance , por ejemplo, cuando se usa una biblioteca cliente de Cloud de Confiance , se producen los siguientes pasos de autenticación:
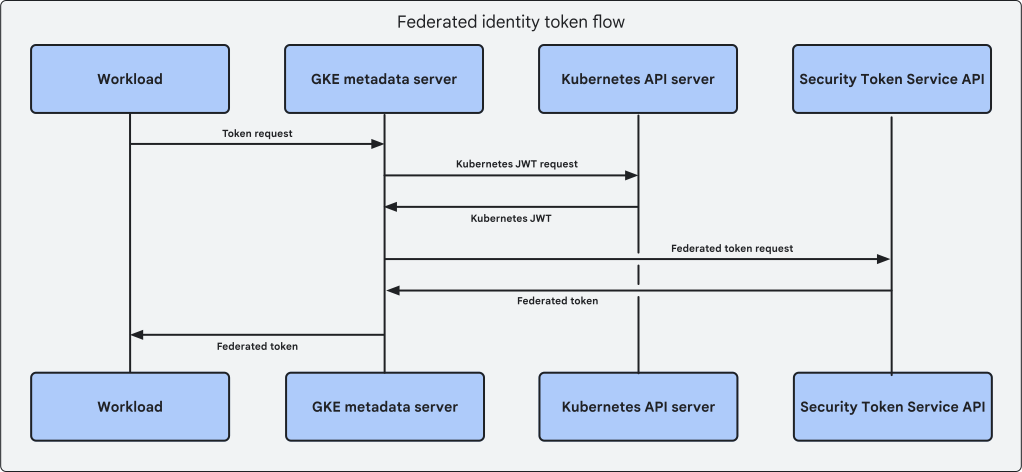
- Las credenciales predeterminadas de la aplicación (ADC) solicitan un token de acceso de Cloud de Confiance desde el servidor de metadatos de Compute Engine que se ejecuta en la VM.
- El servidor de metadatos de GKE intercepta la solicitud del token y solicita al servidor de la API de Kubernetes un token de cuenta de servicio de Kubernetes que identifique la carga de trabajo solicitante. Esta credencial es un token web JSON (JWT) firmado por el servidor de la API.
- El servidor de metadatos de GKE usa el servicio de tokens de seguridad para intercambiar el JWT por un token de acceso federado de corta duración que hace referencia a la identidad de la carga de trabajo de Kubernetes.
El token de acceso federado que devuelve Security Token Service puede tener limitaciones cuando se intenta acceder a algunos Cloud de Confiance servicios, como se describe en Productos admitidos y limitaciones. Si el servicio Cloud de Confiance que seleccionaste tiene limitaciones, puedes configurar de forma opcional la suplantación de identidad de la cuenta de servicio. Este método genera un token de acceso para una cuenta de servicio de IAM que tu carga de trabajo puede usar para acceder al servicio de destino. Para obtener más detalles, consulta Vincula las cuentas de servicio de Kubernetes a IAM.
Luego, la carga de trabajo puede acceder a cualquier API de Cloud de Confiance a la que pueda acceder el identificador principal de IAM de la carga de trabajo.
Cuota para la API de Exchange Token en el servicio de tokens de seguridad
La API de Exchange Token en Security Token Service tiene un límite de cuota de 6,000 solicitudes por minuto. Si ves errores QUOTA_EXCEEDED, puedes
solicitar un aumento de la cuota Token exchange requests per minute a través de
la página Cuotas y límites del sistema.
Similitud de identidad
Si los metadatos en tu identificador principal son los mismos para las cargas de trabajo en varios clústeres que comparten un grupo de identidades para cargas de trabajo porque pertenecen al mismo proyecto Cloud de Confiance , IAM identifica esas cargas de trabajo como iguales. Por ejemplo, si tienes el mismo espacio de nombres en dos clústeres y otorgas acceso a ese espacio de nombres en IAM, las cargas de trabajo en ese espacio de nombres en ambos clústeres obtienen ese acceso. Puedes limitar este acceso a clústeres específicos mediante las políticas de IAM condicionales.
Por ejemplo, considera el siguiente diagrama. Los clústeres A y B pertenecen al
mismo grupo de identidades para cargas de trabajo. Cloud de Confiance identifica las aplicaciones que usan
la ServiceAccount back-ksa en el espacio de nombres backend del clúster A y
el clúster B como la misma identidad. IAM no distingue entre los clústeres que realizan las llamadas.

Esta similitud de identidad también significa que debes poder confiar en cada clúster de un grupo de identidades para cargas de trabajo específico. Por ejemplo, si un clúster nuevo, el clúster C
del ejemplo anterior, fuera propiedad de un equipo no confiable, este podría crear un
espacio de nombres backend y acceder a las APIs de Cloud de Confiance by S3NS con la ServiceAccount
back-ksa, al igual que el clúster A y el clúster B.
Para evitar el acceso no confiable, coloca tus clústeres en proyectos separados para asegurarte de que tengan grupos de identidades para cargas de trabajo diferentes o asegúrate de que los nombres de los espacios de nombres sean distintos para evitar un identificador principal común.
Servidor de metadatos de GKE
Cuando habilitas Workload Identity Federation for GKE para un clúster, cada nodo del clúster almacena metadatos en el servidor de metadatos de GKE. El servidor de metadatos de GKE es un subconjunto de los extremos del servidor de metadatos de Compute Engine necesarios para las cargas de trabajo de Kubernetes.
El servidor de metadatos de GKE se ejecuta como un DaemonSet, con un Pod en cada nodo de Linux o un servicio nativo de Windows en cada nodo de Windows del clúster. El servidor de metadatos intercepta las solicitudes HTTP a http://metadata.google.internal (169.254.169.254:80). Por ejemplo, la solicitud GET
/computeMetadata/v1/instance/service-accounts/default/token recupera un token para la cuenta de servicio de IAM a la que el Pod está configurado en nombre de una cuenta.
El tráfico del servidor de metadatos de GKE nunca sale de la instancia de VM que aloja al Pod.
Duración del token
De forma predeterminada, el token de acceso que se devuelve tiene una vida útil de 1 hora (3,600 segundos). Para reducir la latencia del cliente, el servidor de metadatos de GKE almacena en caché los tokens de acceso. En algunas situaciones, es posible que el token almacenado en caché que devuelve el servidor de metadatos esté cerca de su hora de vencimiento.
Las bibliotecas cliente de Cloud tienen una lógica integrada que, de forma predeterminada, verifica si el token de acceso vence en los próximos 3 minutos y 45 segundos. Si el token está dentro del período de vencimiento, GKE lo actualiza. Las llamadas a la API consecutivas pueden usar el token actualizado.
Si usas tu propio código para acceder directamente a las APIs de Cloud de Confiance , implementa una lógica similar para controlar el vencimiento del token. Tu código debería hacer lo siguiente:
- Verifica si el token de acceso vence después de un período de 3 minutos y 45
segundos. El parámetro
expen la carga útil del token indica la marca de tiempo de vencimiento del token. - Si el token vence en los próximos 3 minutos y 45 segundos, realiza una solicitud de token.
En las siguientes tablas, se describe el subconjunto de extremos del servidor de metadatos de Compute Engine disponibles con el servidor de metadatos de GKE. Para obtener una lista completa de los extremos disponibles en el servidor de metadatos de Compute Engine, consulta los valores de metadatos de VM predeterminados.
Metadatos de la instancia
Los metadatos de la instancia se almacenan en el siguiente directorio.
http://metadata.google.internal/computeMetadata/v1/instance/
| Entrada | Descripción |
|---|---|
hostname |
El nombre de host de tu nodo. |
id |
El ID único de tu nodo. |
service-accounts/ |
Un directorio de cuentas de servicio asociadas a la instancia. Para cada cuenta de servicio, está disponible la siguiente información:
|
zone |
La zona de Compute Engine de tu nodo de GKE. |
Atributos de la instancia
Los atributos de instancias se almacenan en el siguiente directorio:
http://metadata.google.internal/computeMetadata/v1/instance/attributes/
| Entrada | Descripción |
|---|---|
cluster-location |
La zona o región de Compute Engine de tu clúster. |
cluster-name |
El nombre del clúster de GKE. |
cluster-uid |
El UID del clúster de GKE. |
Los atributos que se indican en la tabla son los únicos compatibles. Si
intentas acceder a cualquier atributo no compatible, el Pod gke-metadata-server en
el espacio de nombres kube-system genera y registra un error 404.
El error es similar al siguiente:
HTTP/404: generic::not_found: no child "", Reason: "NOT_FOUND", UserMessage: "Not Found"
Si usas istio-proxy, verás un mensaje de error como el siguiente:
Error fetching GCP Metadata property gcp_gce_instance_template: metadata: GCE metadata "instance/attributes/UNSUPPORTED_ATTRIBUTE" not defined
Metadatos del proyecto
Los metadatos del proyecto del clúster se almacenan en el siguiente directorio.
http://metadata.google.internal/computeMetadata/v1/project/
| Entrada | Descripción |
|---|---|
project-id |
Es el ID de tu proyecto de Cloud de Confiance by S3NS . |
numeric-project-id |
Es el número de tu proyecto de Cloud de Confiance by S3NS . |
Restricciones de la federación de identidades para cargas de trabajo para GKE
No puedes cambiar el nombre del grupo de identidades para cargas de trabajo que GKE crea para tu proyecto Cloud de Confiance by S3NS .
Si vinculas las ServiceAccounts de Kubernetes a las cuentas de servicio de IAM para configurar la federación de identidades para cargas de trabajo para GKE, el servidor de metadatos de GKE devuelve un valor de
SERVICEACCOUNT_NAME.s3ns.svc.id.googcomo el identificador de la cuenta de servicio. Este identificador no usa la sintaxis estándar del identificador principal de IAM, lo que podría causar errores en algunas operaciones programáticas. Para obtener el identificador de la cuenta de servicio como un identificador de principal de IAM, agrega la anotacióniam.gke.io/return-principal-id-as-email: "true"a tu ServiceAccount de Kubernetes.Cuando GKE habilita el servidor de metadatos de GKE en un grupo de nodos, los Pods ya no pueden acceder al servidor de metadatos de Compute Engine. En cambio, el servidor de metadatos de GKE intercepta las solicitudes realizadas de estos Pods a los extremos de metadatos, excepto los Pods que se ejecutan en la red del host.
Cuando se usa el controlador de CSI de Cloud Storage FUSE con clústeres de GKE Standard con la versión
1.33.3-gke.1226000o posterior, los Pods que se ejecutan en la red del host (hostNetwork: true) pueden autenticarse con su propia cuenta de servicio de Kubernetes. Para obtener más información, consulta Configura el acceso para Pods con la red del host.El servidor de metadatos de GKE toma unos segundos en comenzar a aceptar solicitudes en un Pod recién creado. Por lo tanto, los intentos de autenticación mediante la federación de identidades para cargas de trabajo para GKE en los primeros segundos de la vida del Pod podrían fallar. Intentar la llamada resolverá el problema. Consulta Solución de problemas para obtener más detalles.
Los agentes integrados de supervisión y registro de GKE seguirán usando la cuenta de servicio del nodo.
La federación de identidades para cargas de trabajo para GKE requiere una configuración manual para Knative serving a fin de continuar lanzando métricas de solicitudes.
Workload Identity Federation for GKE establece un límite de 500 conexiones simultáneas al servidor de metadatos de GKE para cada nodo. Las llamadas simultáneas adicionales que superen este límite se colocarán en una cola de espera para su procesamiento posterior. Este mecanismo de cola puede generar errores
HTTP/499si se alcanza el tiempo de espera del cliente antes de que el servidor de metadatos de GKE pueda procesar la solicitud.El servidor de metadatos de GKE usa recursos de memoria de forma proporcional a la cantidad total de cuentas de servicio de Kubernetes en tu clúster. Si tu clúster tiene más de 3,000 cuentas de servicio de Kubernetes, kubelet podría finalizar los Pods del servidor de metadatos. Para conocer las mitigaciones, consulta Solución de problemas.
Workload Identity Federation for GKE opera dentro de un perímetro de Controles del servicio de VPC, lo que permite el acceso a los recursos que se encuentran dentro de él. También puedes configurar Workload Identity Federation for GKE para las principales en las reglas de entrada y salida de los Controles del servicio de VPC (versión preliminar) para permitir el acceso entre perímetros sin necesidad de identidad temporal como cuenta de servicio de IAM intermedia.
Alternativas a la federación de identidades para cargas de trabajo para GKE
Puedes usar una de las siguientes alternativas a Workload Identity Federation for GKE para que GKE acceda a las APIs deCloud de Confiance by S3NS desde GKE. Te recomendamos que uses la federación de identidades para cargas de trabajo para GKE, ya que estas alternativas requieren que realices compromisos de seguridad determinados.
Usa la cuenta de servicio predeterminada de Compute Engine de tus nodos. Puedes ejecutar grupos de nodos como cualquier cuenta de servicio de IAM en tu proyecto. Si no especificas una cuenta de servicio durante la creación del grupo de nodos, GKE usa la cuenta de servicio predeterminada de Compute Engine para el proyecto. Todas las cargas de trabajo implementadas en ese nodo comparten la cuenta de servicio de Compute Engine. Esto puede generar un aprovisionamiento excesivo de permisos, lo que infringe el principio de privilegio mínimo y es inapropiado para los clústeres de multiusuario.
Exporta claves de cuenta de servicio y almacénalas como secretos de Kubernetes que actives en los Pods como volúmenes.
¿Qué sigue?
- Obtén más información sobre cómo habilitar y configurar la federación de identidades para cargas de trabajo para GKE.
- Obtén más información sobre el servidor de metadatos de Compute Engine.
- Obtén más información sobre la federación de identidades para cargas de trabajo en otros entornos.
- Proporciona asistencia para la federación de identidades para cargas de trabajo para clústeres en flotas con Workload Identity de flota.