

Le connecteur Hive-BigQuery Open Source permet à vos charges de travail Apache Hive de lire et d'écrire des données depuis et vers des tables BigQuery et BigLake. Vous pouvez stocker des données dans l'espace de stockage BigQuery ou dans des formats de données Open Source sur Cloud Storage.
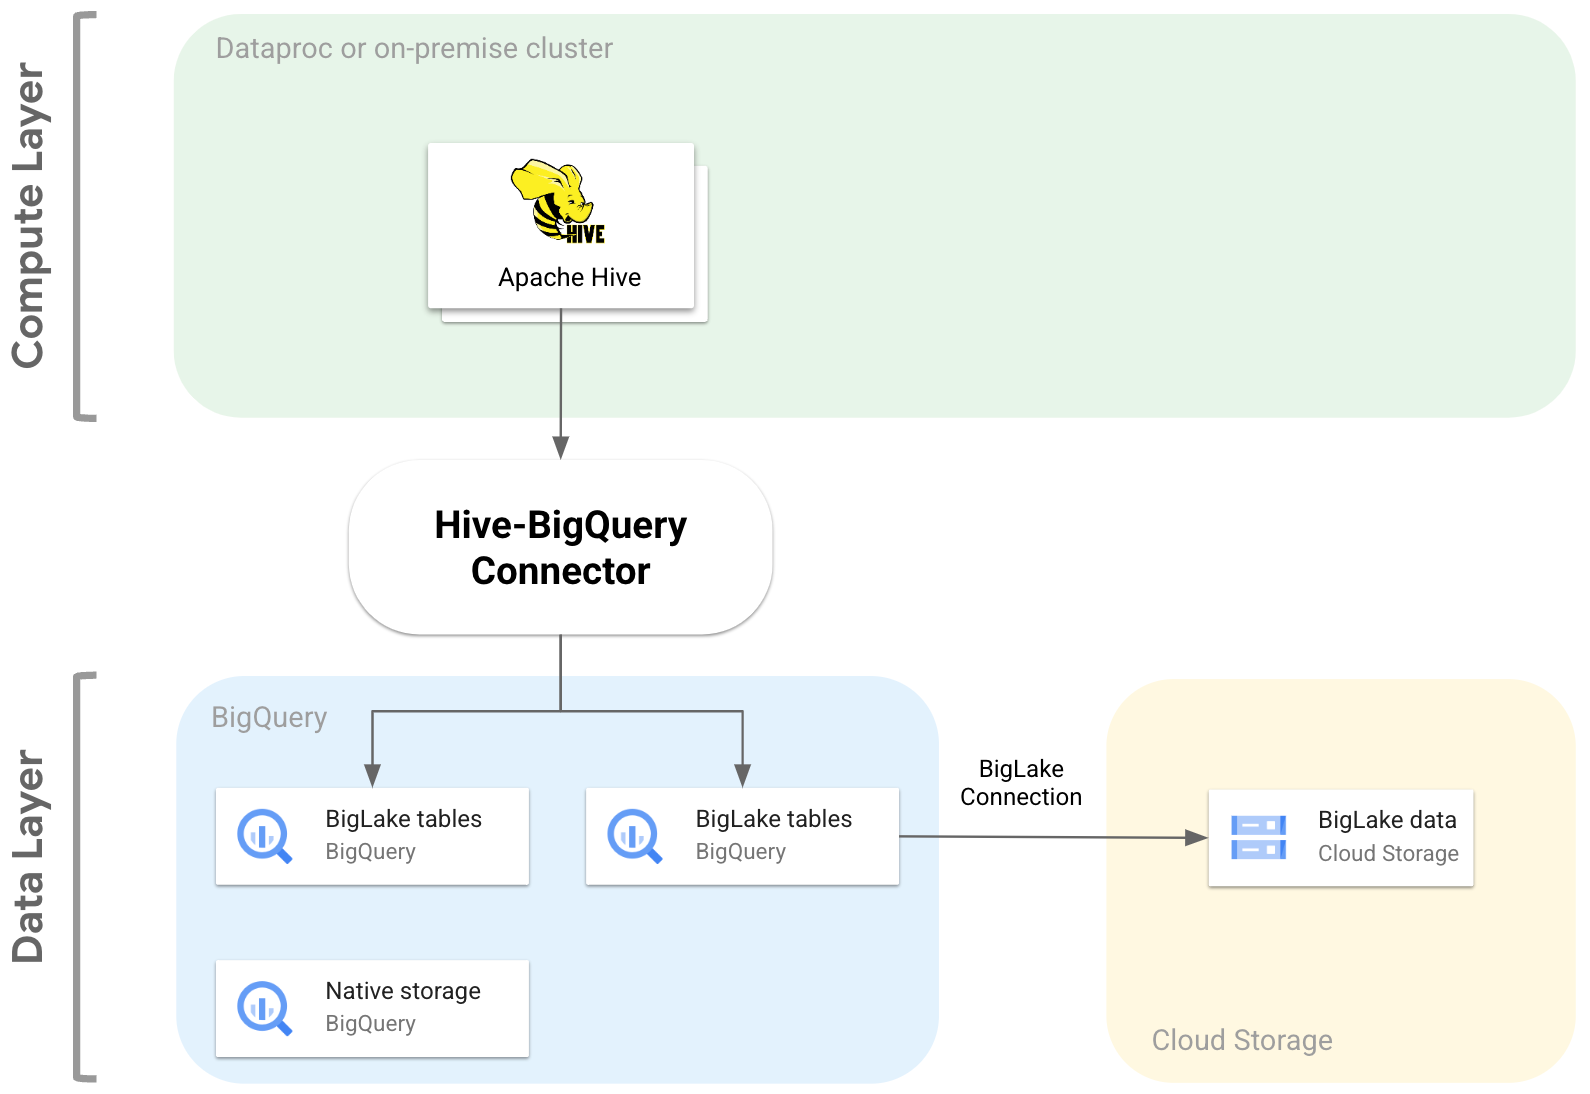
Le connecteur Hive-BigQuery implémente l'API Hive Storage Handler pour permettre aux charges de travail Hive de s'intégrer aux tables BigQuery et BigLake. Le moteur d'exécution Hive gère les opérations de calcul, telles que les agrégations et les jointures, et le connecteur gère les interactions avec les données stockées dans BigQuery ou dans les buckets Cloud Storage connectés à BigLake.
Le schéma suivant illustre l'intégration du connecteur Hive-BigQuery entre les couches de calcul et de données.
Cas d'utilisation
Voici quelques-unes des façons dont le connecteur Hive-BigQuery peut vous aider dans les scénarios courants basés sur les données :
Migration de données. Vous prévoyez de migrer votre entrepôt de données Hive vers BigQuery, puis de traduire progressivement vos requêtes Hive dans le dialecte SQL de BigQuery. Vous vous attendez à ce que la migration prenne beaucoup de temps en raison de la taille de votre entrepôt de données et du grand nombre d'applications connectées, et vous devez assurer la continuité pendant les opérations de migration. Voici le workflow :
- Vous déplacez vos données vers BigQuery.
- Le connecteur vous permet d'accéder à vos requêtes Hive d'origine et de les exécuter, tout en les traduisant progressivement vers le dialecte SQL conforme à la norme ANSI de BigQuery.
- Une fois la migration et la traduction terminées, vous retirez Hive.
Workflows Hive et BigQuery. Vous prévoyez d'utiliser Hive pour certaines tâches et BigQuery pour les charges de travail qui bénéficient de ses fonctionnalités, telles que BigQuery BI Engine ou BigQuery ML. Vous utilisez le connecteur pour joindre des tables Hive à vos tables BigQuery.
Dépendance vis-à-vis d'une pile de logiciels Open Source (OSS). Pour éviter la dépendance vis-à-vis d'un fournisseur, vous utilisez une pile OSS complète pour votre entrepôt de données. Voici votre forfait Internet :
Vous migrez vos données dans leur format OSS d'origine, tel qu'Avro, Parquet ou ORC, vers des buckets Cloud Storage à l'aide d'une connexion BigLake.
Vous continuez à utiliser Hive pour exécuter et traiter vos requêtes en dialecte SQL Hive.
Vous utilisez le connecteur selon vos besoins pour vous connecter à BigQuery afin de bénéficier des fonctionnalités suivantes :
- Mise en cache des métadonnées pour améliorer les performances des requêtes
- Protection contre la perte de données
- Contrôle des accès au niveau des colonnes
- Masquage dynamique des données pour la sécurité et la gouvernance à grande échelle.
Fonctionnalités
Vous pouvez utiliser le connecteur Hive-BigQuery pour travailler avec vos données BigQuery et effectuer les tâches suivantes :
- Exécuter des requêtes avec les moteurs d'exécution MapReduce et Tez
- Créer et supprimer des tables BigQuery à partir de Hive.
- Joindre des tables BigQuery et BigLake à des tables Hive
- Effectuer des lectures rapides à partir de tables BigQuery à l'aide des flux de l'API Storage Read et du format Apache Arrow
- Écrivez des données dans BigQuery à l'aide des méthodes suivantes :
- Écritures directes à l'aide de l'API BigQuery Storage Write en mode en attente. Utilisez cette méthode pour les charges de travail qui nécessitent une faible latence d'écriture, comme les tableaux de bord en temps quasi réel avec des périodes d'actualisation courtes.
- Écritures indirectes en stockant des fichiers Avro temporaires dans Cloud Storage, puis en chargeant les fichiers dans une table de destination à l'aide de l'API Load Job. Cette méthode est moins coûteuse que la méthode directe, car les jobs de chargement BigQuery n'entraînent pas de frais. Comme cette méthode est plus lente, elle est plus adaptée aux charges de travail qui ne sont pas urgentes,
Accédez aux tables BigQuery partitionnées par date et groupées. L'exemple suivant définit la relation entre une table Hive et une table partitionnée et en cluster dans BigQuery.
CREATE TABLE my_hive_table (int_val BIGINT, text STRING, ts TIMESTAMP)
STORED BY 'com.google.cloud.hive.bigquery.connector.BigQueryStorageHandler'
TBLPROPERTIES (
'bq.table'='myproject.mydataset.mytable',
'bq.time.partition.field'='ts',
'bq.time.partition.type'='MONTH',
'bq.clustered.fields'='int_val,text'
);
Éliminez les colonnes pour éviter de récupérer des colonnes inutiles de la couche de données.
Utilisez des pushdowns de prédicats pour préfiltrer les lignes de données au niveau de la couche de stockage BigQuery. Cette technique peut améliorer considérablement les performances globales des requêtes en réduisant la quantité de données transitant par le réseau.
Convertissez automatiquement les types de données Hive en types de données BigQuery.
Lire les vues et les instantanés de table BigQuery.
Intégrer à Spark SQL.
Intégrer Apache Pig et HCatalog
Commencer
Consultez les instructions pour installer et configurer le connecteur Hive-BigQuery sur un cluster Hive.