

המחבר של Hive ל-BigQuery בקוד פתוח מאפשר לעומסי העבודה ב-Apache Hive לקרוא נתונים מטבלאות ב-BigQuery וב-BigLake ולכתוב אליהן נתונים. אתם יכולים לאחסן נתונים ב-BigQuery או בפורמטים של נתונים בקוד פתוח ב-Cloud Storage.
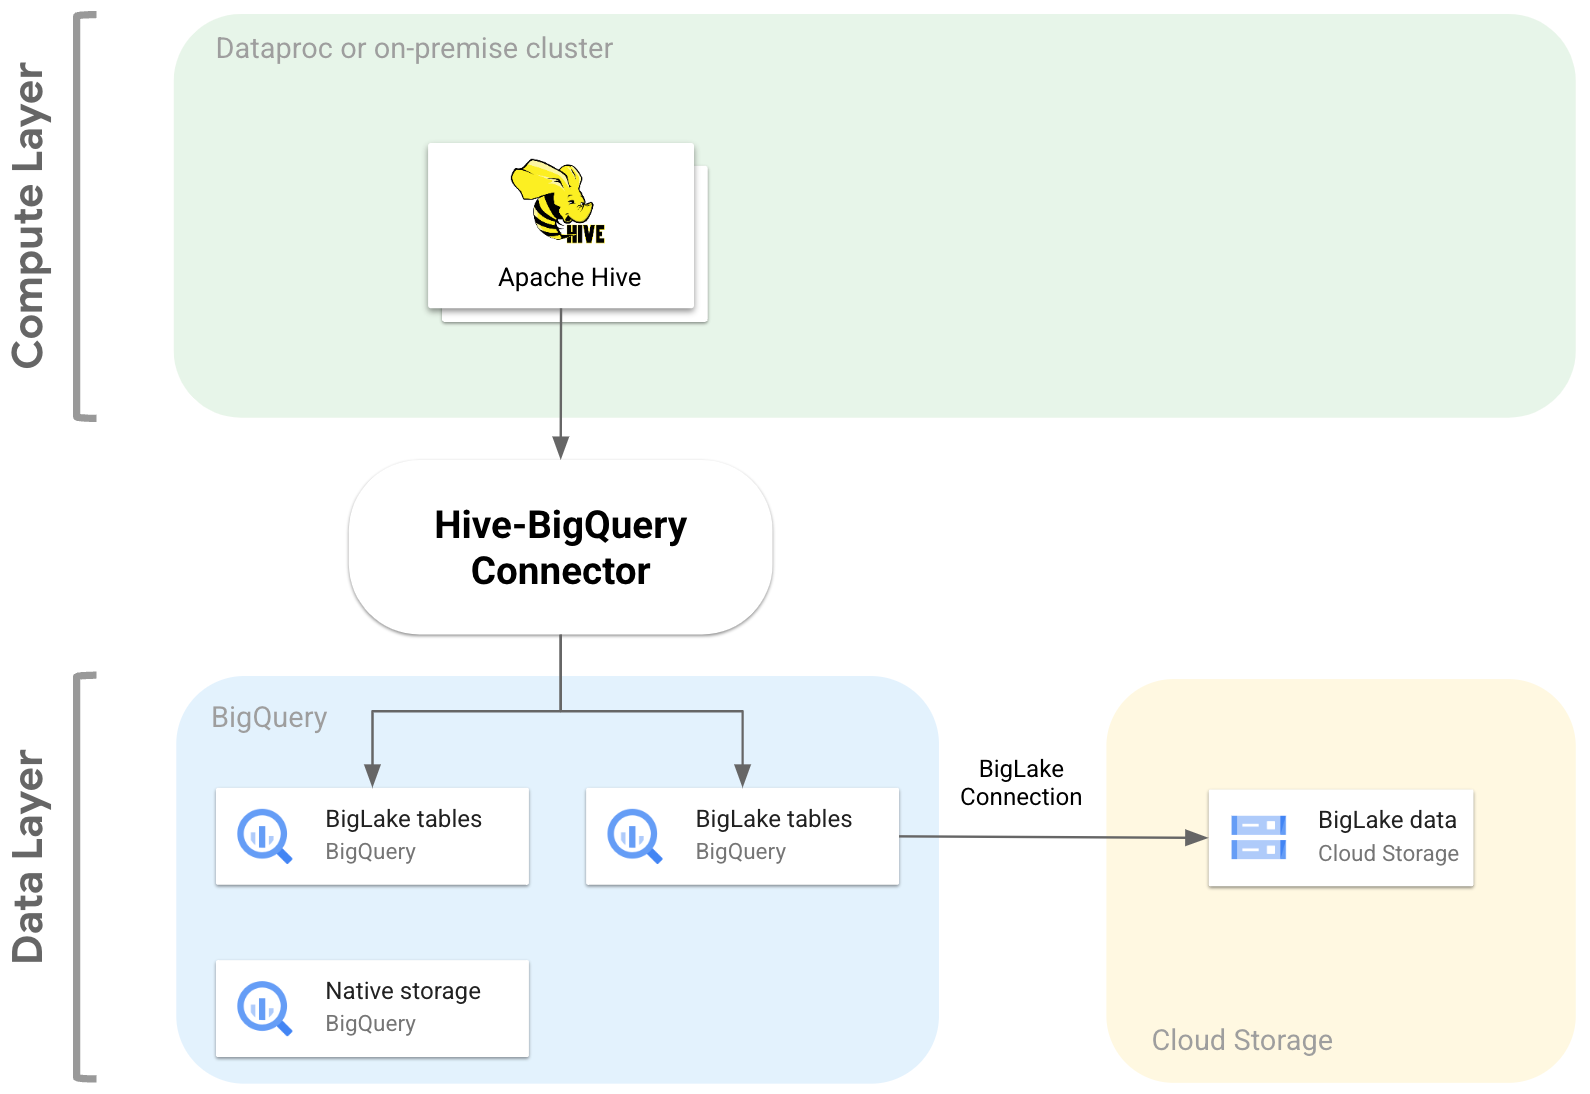
המחבר של Hive ל-BigQuery מטמיע את Hive Storage Handler API כדי לאפשר לעומסי העבודה של Hive להשתלב עם טבלאות BigQuery ו-BigLake. מנוע הביצוע של Hive מטפל בפעולות המחשוב, כמו צבירות וצירופים, והמחבר מנהל את האינטראקציות עם הנתונים שמאוחסנים ב-BigQuery או בקטגוריות של Cloud Storage שמחוברות ל-BigLake.
בתרשים הבא מוצג איך המחבר של Hive ל-BigQuery משתלב בין שכבת המחשוב לשכבת הנתונים.
תרחישים לדוגמה
הנה כמה דוגמאות לתרחישים נפוצים שבהם המחבר של Hive ל-BigQuery יכול לעזור לכם:
העברת נתונים. אתם מתכננים להעביר את מחסן הנתונים של Hive ל-BigQuery, ואז לתרגם בהדרגה את השאילתות של Hive לניב SQL של BigQuery. אתם צופים שההעברה תימשך זמן רב בגלל הגודל של מחסן הנתונים ומספר האפליקציות המחוברות, ואתם צריכים להבטיח המשכיות במהלך פעולות ההעברה. ככה זה עובד:
- אתם מעבירים את הנתונים ל-BigQuery
- באמצעות המחבר, אתם יכולים לגשת לשאילתות המקוריות של Hive ולהריץ אותן, תוך כדי שאתם מתרגמים בהדרגה את השאילתות של Hive לניב SQL שתואם ל-ANSI של BigQuery.
- אחרי שמשלימים את ההעברה והתרגום, מוציאים את Hive משימוש.
תהליכי עבודה ב-Hive וב-BigQuery. אתם מתכננים להשתמש ב-Hive למשימות מסוימות, וב-BigQuery לעומסי עבודה שמתאימים לתכונות שלו, כמו BigQuery BI Engine או BigQuery ML. אתם משתמשים במחבר כדי לצרף טבלאות Hive לטבלאות ב-BigQuery.
הסתמכות על מחסנית תוכנה בקוד פתוח (OSS). כדי להימנע מלקוח שבוי, אתם משתמשים במחסן נתונים עם מחסנית OSS מלאה. זו חבילת הגלישה שלך:
אתם מעבירים את הנתונים בפורמט המקורי של OSS, כמו Avro, Parquet או ORC, לקטגוריות של Cloud Storage באמצעות חיבור BigLake.
אתם ממשיכים להשתמש ב-Hive כדי להריץ ולעבד את השאילתות שלכם בניב Hive SQL.
אתם יכולים להשתמש במחבר לפי הצורך כדי להתחבר ל-BigQuery וליהנות מהתכונות הבאות:
- שמירת מטא-נתונים במטמון לשיפור ביצועי השאילתות
- מניעת אובדן נתונים
- בקרת גישה ברמת העמודה
- הסתרת מידע דינמית לאבטחה ומשילות בקנה מידה נרחב.
תכונות
אתם יכולים להשתמש במחבר Hive-BigQuery כדי לעבוד עם הנתונים ב-BigQuery ולבצע את המשימות הבאות:
- להריץ שאילתות באמצעות מנועי הביצוע MapReduce ו-Tez.
- ליצור ולמחוק טבלאות ב-BigQuery מ-Hive.
- איחוד טבלאות BigQuery ו-BigLake עם טבלאות Hive.
- לבצע קריאות מהירות מטבלאות ב-BigQuery באמצעות הסטרימינג של Storage Read API והפורמט Apache Arrow
- כתיבת נתונים ב-BigQuery באמצעות השיטות הבאות:
- כתיבה ישירה באמצעות BigQuery Storage Write API במצב המתנה. השיטה הזו מתאימה לעומסי עבודה שדורשים זמן אחזור קצר בכתיבה, כמו מרכזי בקרה שמתעדכנים כמעט בזמן אמת עם חלונות זמן קצרים לרענון.
- כתיבה עקיפה על ידי העלאת קובצי Avro זמניים ל-Cloud Storage, ואז טעינת הקבצים לטבלת יעד באמצעות Load Job API. השיטה הזו זולה יותר מהשיטה הישירה, כי לא נצברות עלויות על משימות טעינה ב-BigQuery. השיטה הזו איטית יותר, והיא מתאימה בעיקר לעומסי עבודה שלא דורשים זמן תגובה מהיר.
גישה לטבלאות מחולקות למחיצות לפי זמן ומסודרות באשכולות ב-BigQuery. בדוגמה הבאה מוגדר הקשר בין טבלת Hive לבין טבלה שמחולקת למחיצות ולאשכולות ב-BigQuery.
CREATE TABLE my_hive_table (int_val BIGINT, text STRING, ts TIMESTAMP)
STORED BY 'com.google.cloud.hive.bigquery.connector.BigQueryStorageHandler'
TBLPROPERTIES (
'bq.table'='myproject.mydataset.mytable',
'bq.time.partition.field'='ts',
'bq.time.partition.type'='MONTH',
'bq.clustered.fields'='int_val,text'
);
כדאי לצמצם את העמודות כדי להימנע משליפת עמודות מיותרות משכבת הנתונים.
משתמשים ב-predicate pushdowns כדי לסנן מקדים שורות נתונים בשכבת האחסון של BigQuery. השיטה הזו יכולה לשפר משמעותית את הביצועים הכוללים של השאילתות, כי היא מפחיתה את כמות הנתונים שעוברים ברשת.
להמיר באופן אוטומטי סוגי נתונים של Hive לסוגי נתונים של BigQuery.
לקרוא תצוגות מפורטות ותמונות מצב של טבלאות ב-BigQuery.
שילוב עם Spark SQL.
שילוב עם Apache Pig ו-HCatalog.