

La fonctionnalité IAM granulaire de Managed Service pour Apache Spark vous permet d'accorder des autorisations au niveau du cluster, des jobs, des opérations, du modèle de workflow ou de la règle d'autoscaling.
Exemple : Vous pouvez attribuer à un utilisateur un rôle de lecteur de cluster, qui lui permet d'afficher un cluster dans un projet, et attribuer à un autre utilisateur un rôle d'éditeur de jobs, qui lui permet de mettre à jour, d'annuler et d'afficher le job. Pour comprendre les commandes Google Cloud CLI spécifiques activées par chaque rôle IAM précis de Managed Service pour Apache Spark, consultez Commandes du SDK activées par IAM précis.
Rôles et autorisations IAM précis pour Managed Service pour Apache Spark
La gestion de l'IAM de manière précise dans Managed Service pour Apache Spark permet de définir les rôles suivants avec les autorisations suivantes sur les ressources Managed Service pour Apache Spark.
Rôles de cluster
| Rôle | Autorisations |
|---|---|
| Lecteur | dataproc.clusters.get |
| Éditeur | dataproc.clusters.get dataproc.clusters.list dataproc.clusters.delete dataproc.clusters.update dataproc.clusters.use dataproc.clusters.start dataproc.clusters.stop |
| Propriétaire | dataproc.clusters.get dataproc.clusters.list dataproc.clusters.delete dataproc.clusters.update dataproc.clusters.use dataproc.clusters.start dataproc.clusters.stop dataproc.clusters.setIamPolicy dataproc.clusters.getIamPolicy |
Rôles du poste
| Rôle | Autorisations |
|---|---|
| Lecteur | dataproc.jobs.get |
| Éditeur | dataproc.jobs.get dataproc.jobs.cancel dataproc.jobs.delete dataproc.jobs.update |
| Propriétaire | dataproc.jobs.get dataproc.jobs.cancel dataproc.jobs.delete dataproc.jobs.update dataproc.jobs.setIamPolicy dataproc.jobs.getIamPolicy |
Rôles d'opération
| Rôle | Autorisations |
|---|---|
| Lecteur | dataproc.operations.get |
| Éditeur | dataproc.jobs.get dataproc.operations.cancel dataproc.operations.delete |
| Propriétaire | dataproc.jobs.get dataproc.operations.cancel dataproc.operations.delete dataproc.operations.setIamPolicy dataproc.operations.getIamPolicy |
Rôles de modèle de workflow
| Rôle | Autorisations |
|---|---|
| Lecteur | dataproc.workflowTemplates.get |
| Éditeur | dataproc.workflowTemplates.get dataproc.workflowTemplates.delete dataproc.workflowTemplates.update |
| Propriétaire | dataproc.workflowTemplates.get dataproc.workflowTemplates.delete dataproc.workflowTemplates.update dataproc.workflowTemplates.setIamPolicy dataproc.workflowTemplates.getIamPolicy |
Rôles de règle d'autoscaling
| Rôle | Autorisations |
|---|---|
| Lecteur | dataproc.autoscalingPolicies.get |
| Éditeur | dataproc.autoscalingPolicies.get dataproc.autoscalingPolicies.use dataproc.autoscalingPolicies.delete dataproc.autoscalingPolicies.update |
| Propriétaire | dataproc.autoscalingPolicies.get dataproc.autoscalingPolicies.use dataproc.autoscalingPolicies.delete dataproc.autoscalingPolicies.update dataproc.autoscalingPolicies.setIamPolicy dataproc.autoscalingPolicies.getIamPolicy |
Utiliser IAM de manière précise avec Managed Service pour Apache Spark
Cette section explique comment utiliser IAM de manière précise dans Managed Service pour Apache Spark afin d'attribuer des rôles aux utilisateurs sur une ressource Managed Service pour Apache Spark existante. Pour en savoir plus sur la mise à jour et la suppression des rôles Identity and Access Management (IAM), consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Commande gcloud
- Récupérez la stratégie IAM de la ressource, puis enregistrez-la dans un fichier JSON. Le paramètre resource-type prend l'une des valeurs suivantes : "clusters", "jobs" (tâches), "operations", "workflow-templates" (modèles de workflow) ou "autoscaling-policies" (stratégies d'autoscaling) :
gcloud dataproc resource-type get-iam-policy  resource-id \
    --region=region \
    --format=json > iam.json
- Le fichier JSON affiche un contenu identique au texte ci-dessous :
{ "bindings": [ { "role": "roles/editor", "members": [ "user:mike@example.com", "group:admins@example.com", "domain:google.com", "serviceAccount:my-other-app@appspot.s3ns-system.iam.gserviceaccount.com" ] } ], "etag": "string" } - À l'aide d'un éditeur de texte, ajoutez un nouvel Objet de liaison au tableau de liaisons qui définit les utilisateurs et le rôle d'accès aux ressources de ces derniers. Par exemple, pour accorder le rôle de lecteur (
roles/viewer) à l'utilisateursean@example.com, vous devez modifier l'exemple précédent pour ajouter un nouvel objet de liaison (indiqué en gras dans l'exemple suivant). Remarque : Veillez à renvoyer la valeuretagque vous avez reçue degcloud dataproc resource-type get-iam-policy. Consultez la documentation sur les etags.{ "bindings": [ { "role": "roles/editor", "members": [ "user:mike@example.com", "group:admins@example.com", "domain:google.com", "serviceAccount:my-other-app@appspot.s3ns-system.iam.gserviceaccount.com" ] }, { "role": "roles/viewer", "members": [ "user:sean@example.com" ] } ], "etag": "value-from-get-iam-policy" } - Mettez à jour la stratégie du cluster avec le nouveau tableau de liaisons en exécutant la commande ci-dessous. Le paramètre resource-type prend l'une des valeurs suivantes : "clusters", "jobs" (tâches), "operations", "workflow-templates" (modèles de workflow) ou "autoscaling-policies" (stratégies d'autoscaling) :
gcloud dataproc resource-type set-iam-policy resource-name \
    --region=region \
    --format=json iam.json
- La commande génère la règle mise à jour :
{
  "bindings": [
    {
      "role": "roles/editor",
      "members": [
        "user:mike@example.com",
        "group:admins@example.com",
        "domain:google.com",
        "serviceAccount:my-other-app@appspot.s3ns-system.iam.gserviceaccount.com"
      ]
    },
    {
      "role": "roles/viewer",
      "members": [
        "user:sean@example.com"
      ]
    }
  ],
  "etag": "string"
}
API REST
- Envoyez une requête getIamPolicy resource-type ("clusters" or "jobs" or "operations" or "workflowTemplates" or "autoscalingPolicies") pour obtenir la stratégie IAM de la ressource.
Exemple de cluster getIamPolicy :
GET https://dataproc.googleapis.com/v1/projects/projectName/regions/region/clusters/clusterName:getIamPolicy
- Le fichier JSON affiche un contenu identique au texte ci-dessous :
{ "bindings": [ { "role": "roles/editor", "members": [ "user:mike@example.com", "group:admins@example.com", "domain:google.com", "serviceAccount:my-other-app@appspot.s3ns-system.iam.gserviceaccount.com" ] } ], "etag": "string" } - À l'aide d'un éditeur de texte, créez l'objet de stratégie JSON suivant pour inclure le tableau de liaisons que vous venez de recevoir du service Managed Service pour Apache Spark. Assurez-vous d'indiquer la valeur "etag" que vous avez reçue dans la réponse getIamPolicy (consultez la Documentation sur etag).
Ajoutez maintenant un nouvel objet de liaison au tableau de liaisons qui définit les utilisateurs et le rôle d'accès au cluster pour ces derniers. Par exemple, pour accorder le rôle de lecteur (
roles/viewer) à l'utilisateursean@example.com, vous devez modifier l'exemple ci-dessus pour ajouter un objet de liaison (en gras), ci-dessous.{ "policy": { "version": "", "bindings": [ { "role": "roles/editor", "members": [ "user:mike@example.com", "group:admins@example.com", "domain:google.com", "serviceAccount:my-other-app@appspot.s3ns-system.iam.gserviceaccount.com" ] }, { "role": "roles/viewer", "members": [ "user:sean@example.com" ] } ], "etag": "value-from-getIamPolicy" } } - Définissez la stratégie mise à jour sur la ressource en envoyant une requête
setIamPolicy.Exemple de cluster setIamPolicy :
POST https://dataproc.googleapis.com/v1/projects/projectName/regions/region/clusters/clusterName:setIamPolicy Request body
{ "policy": { "version": "", "bindings": [ { "role": "roles/editor", "members": [ "user:mike@example.com", "group:admins@example.com", "domain:google.com", "serviceAccount:my-other-app@appspot.s3ns-system.iam.gserviceaccount.com" ] }, { "role": "roles/viewer", "members": [ "user:sean@example.com" ] } ], "etag": "value-from-getIamPolicy" } } - La réponse JSON affiche un contenu identique au texte ci-dessous :
Réponse
{
  "bindings": [
    {
      "role": "roles/editor",
      "members": [
        "user:mike@example.com",
        "group:admins@example.com",
        "domain:google.com",
        "serviceAccount:my-other-app@appspot.s3ns-system.iam.gserviceaccount.com"
      ]
    },
    {
      "role": "roles/viewer",
      "members": [
        "user:sean@example.com"
      ]
    }
  ],
  "etag": "string"
}
Console
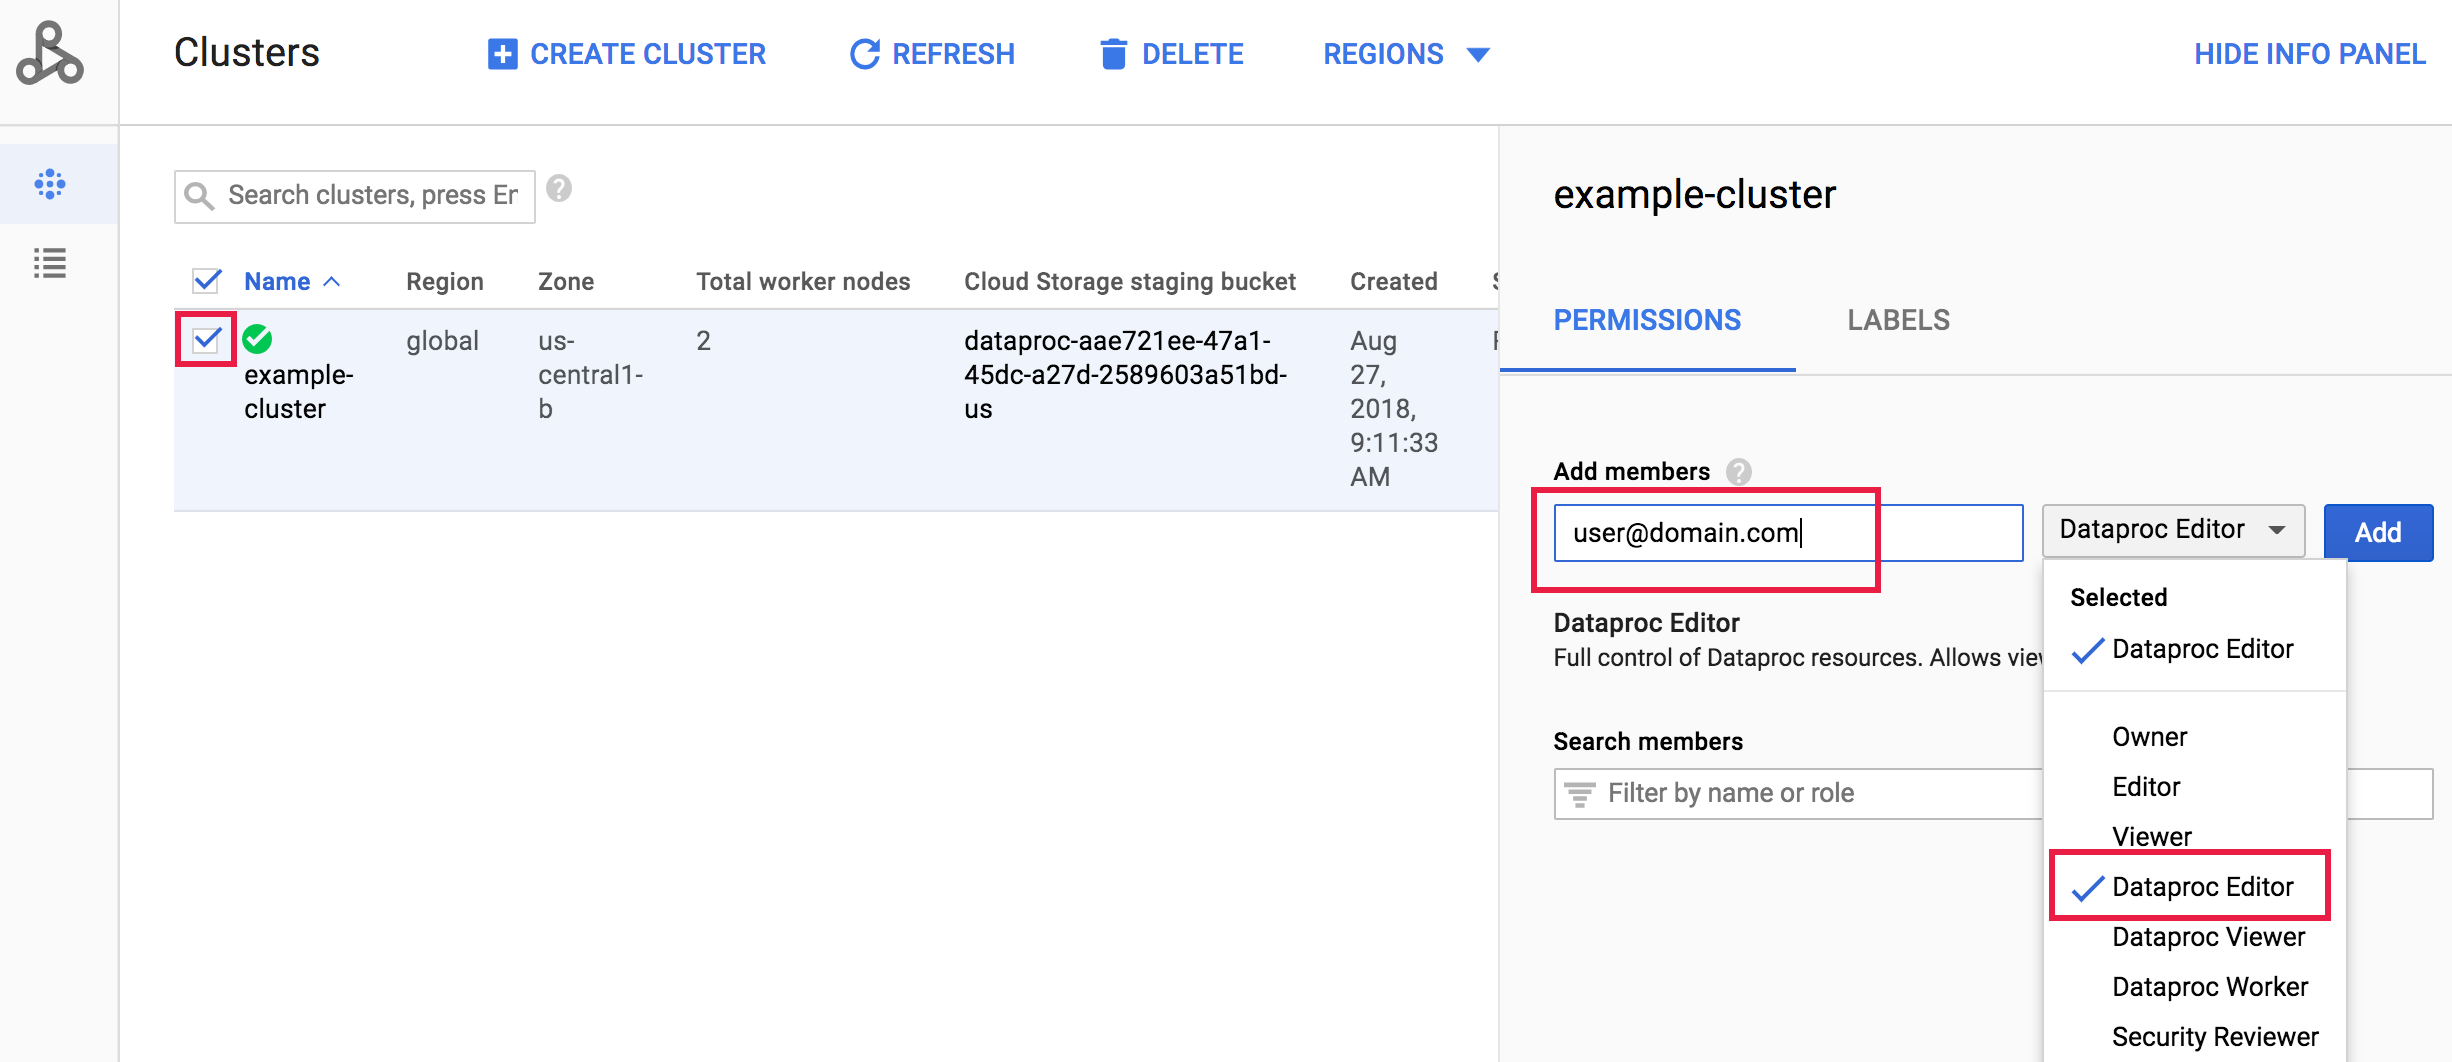
Accédez à la page Clusters Managed Service pour Apache Spark dans la console Cloud de Confiance , puis cliquez sur la case à gauche du nom du cluster pour ouvrir le panneau Autorisations/Libellés (si le panneau ne s'affiche pas, cliquez sur AFFICHER LE PANNEAU D'INFORMATIONS en haut à droite de la page). Dans l'onglet "Autorisations", sélectionnez le rôle Managed Service pour Apache Spark, ajoutez une ou plusieurs adresses de compte dans le champ Ajouter des comptes principaux, puis cliquez sur Ajouter.
Commandes du SDK activées par IAM précis
Cette section décrit les commandes gcloud dataproc activées sur les ressources Managed Service pour Apache Spark par chaque rôle IAM précis.
Clusters
| Rôle IAM | Commande |
|---|---|
| Lecteur | gcloud dataproc clusters describe cluster-name |
| Éditeur | gcloud dataproc clusters describe cluster-namegcloud dataproc clusters listgcloud dataproc clusters delete cluster-namegcloud dataproc clusters diagnose cluster-namegcloud dataproc clusters update cluster-namegcloud beta dataproc clusters start cluster-namegcloud beta dataproc clusters stop cluster-name |
| Propriétaire | gcloud dataproc clusters describe cluster-namegcloud dataproc clusters listgcloud dataproc clusters delete cluster-namegcloud dataproc clusters diagnose cluster-namegcloud dataproc clusters update cluster-namegcloud beta dataproc clusters start cluster-namegcloud beta dataproc clusters stop cluster-namegcloud dataproc clusters get-iam-policy cluster-namegcloud dataproc clusters set-iam-policy cluster-name |
Tâches
| Rôle IAM | Commande |
|---|---|
| Lecteur | gcloud dataproc jobs describe job-id |
| Éditeur | gcloud dataproc jobs delete job-idgcloud dataproc jobs describe job-idgcloud dataproc jobs kill job-idgcloud dataproc jobs update job-idgcloud dataproc jobs wait job-id |
| Propriétaire | gcloud dataproc jobs delete job-idgcloud dataproc jobs describe job-idgcloud dataproc jobs kill job-idgcloud dataproc jobs update job-idgcloud dataproc jobs wait job-idgcloud dataproc jobs get-iam-policy job-idgcloud dataproc jobs set-iam-policy job-id |
Opérations
| Rôle IAM | Commande |
|---|---|
| Lecteur | gcloud dataproc operations describe operation-id |
| Éditeur | gcloud dataproc operations delete operation-idgcloud dataproc operations describe operation-idgcloud dataproc operations cancel operation-id |
| Propriétaire | gcloud dataproc operations delete operation-idgcloud dataproc operations describe operation-idgcloud dataproc operations cancel operation-idgcloud dataproc operations get-iam-policy operation-idgcloud dataproc operations set-iam-policy operation-id |
Modèles de workflows
| Rôle IAM | Commande |
|---|---|
| Lecteur | gcloud dataproc workflow-templates describe template-id |
| Éditeur | gcloud dataproc workflow-templates delete template-idgcloud dataproc workflow-templates describe template-idgcloud dataproc workflow-templates remove-job template-idgcloud dataproc workflow-templates run template-id |
| Propriétaire | gcloud dataproc workflow-templates delete template-idgcloud dataproc workflow-templates describe template-idgcloud dataproc workflow-templates remove-job template-idgcloud dataproc workflow-templates run template-idgcloud dataproc workflow-templates get-iam-policy template-idgcloud dataproc workflow-templates set-iam-policy template-id |
Stratégies d'autoscaling
| Rôle IAM | Commande |
|---|---|
| Lecteur | gcloud dataproc autoscaling-policies describe policy-id |
| Éditeur | gcloud dataproc autoscaling-policies delete policy-idgcloud dataproc autoscaling-policies describe policy-idgcloud dataproc autoscaling-policies update policy-idgcloud dataproc clusters create cluster-name --autoscaling-policy policy-id |
| Propriétaire | gcloud dataproc autoscaling-policies delete policy-idgcloud dataproc autoscaling-policies describe policy-idgcloud dataproc autoscaling-policies update policy-idgcloud dataproc clusters create cluster-name --autoscaling-policy policy-idgcloud dataproc autoscaling-policies get-iam-policy policy-idgcloud dataproc autoscaling-policies set-iam-policy policy-id |
Envoyer des jobs avec IAM précis
Pour permettre à un compte principal (utilisateur, groupe ou compte de service) d'envoyer des jobs à un cluster spécifié à l'aide d'IAM granulaire Managed Service pour Apache Spark, en plus d'accorder à un utilisateur un rôle d'éditeur sur un cluster, des autorisations supplémentaires doivent être définies au niveau du projet. Voici la procédure à suivre pour autoriser un compte principal à envoyer des jobs sur un cluster Managed Service pour Apache Spark spécifié :
- Créez un bucket Cloud Storage que votre cluster peut utiliser pour se connecter à Cloud Storage.
- Ajoutez le compte principal à la stratégie au niveau du bucket en sélectionnant le rôle Lecteur d'objets de stockage pour le compte principal (voir
roles/storage.objectViewer), qui comprend les autorisations suivantes :storage.objects.getstorage.objects.list
- Lorsque vous créez le cluster, transmettez-lui le nom du bucket que vous venez de créer à l'aide du paramètre
--bucket(voirgcloud dataproc clusters create --bucket). - Une fois le cluster créé, définissez une stratégie sur le cluster qui accorde au compte principal un rôle d'éditeur ou de propriétaire (consultez Utiliser IAM de manière précise avec Managed Service pour Apache Spark).
- Créez un rôle personnalisé d'IAM avec les autorisations suivantes :
dataproc.jobs.createdataproc.jobs.get
- Sélectionnez ou ajoutez le compte principal sur la page IAM de la console Cloud de Confiance , puis sélectionnez le rôle personnalisé pour l'appliquer au compte principal.