

Neste documento, listamos mensagens de erro comuns de jobs e fornecemos informações de monitoramento e depuração para ajudar você a resolver problemas de jobs do Serviço Gerenciado para Apache Spark.
Mensagens de erro comuns de jobs
Nesta seção, listamos erros e soluções comuns de jobs.
A tarefa não foi adquirida
Isso indica que o agente do Serviço Gerenciado para Apache Spark no nó mestre não conseguiu adquirir a tarefa do plano de controle. Isso geralmente acontece devido a problemas de falta de memória (OOM, na sigla em inglês) ou rede. Se o job foi executado com sucesso anteriormente e você não alterou as configurações de rede, a causa mais provável é a OOM, geralmente resultante do envio de muitos jobs em execução simultânea ou jobs com drivers que consomem muita memória (por exemplo, jobs que carregam grandes conjuntos de dados na memória).
Nenhum agente nos nós mestre foi encontrado como ativo
Isso indica que o agente do Serviço Gerenciado para Apache Spark no nó mestre não está ativo e não pode aceitar novos jobs. Isso geralmente acontece devido a problemas de falta de memória (OOM) ou de rede, ou se a VM do nó mestre não estiver íntegra. Se o job foi executado com sucesso anteriormente e você não alterou as configurações de rede, a causa mais provável é a falta de memória, que geralmente resulta do envio de muitos jobs em execução simultânea ou de jobs com drivers que consomem muita memória (jobs que carregam grandes conjuntos de dados na memória).
Para resolver o problema, tente o seguinte:
- Reinicie o job.
- Conecte-se usando SSH ao nó mestre do cluster e determine qual job ou outro recurso está usando mais memória.
Se não for possível fazer login no nó mestre, verifique os registros da porta serial (console).
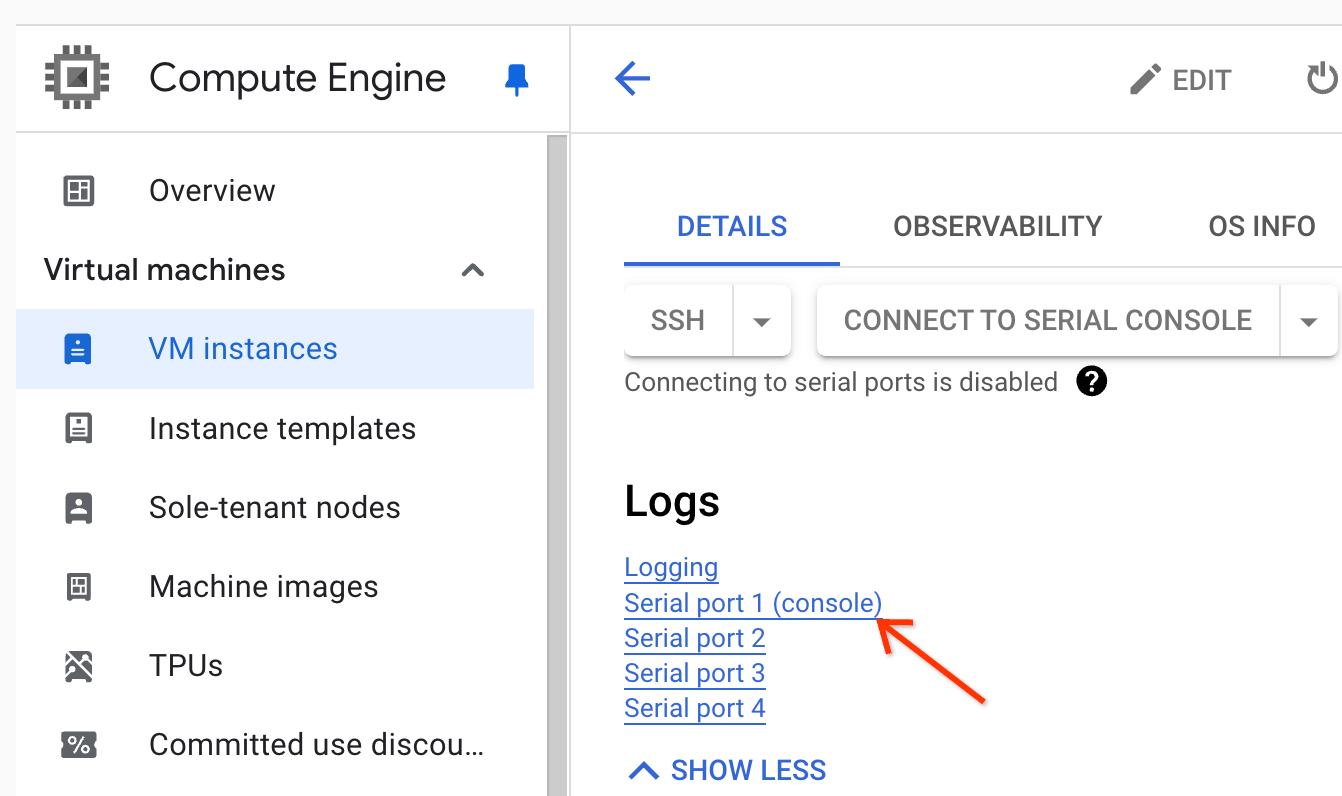
Gere um pacote de diagnóstico, que contém o syslog e outros dados.
A tarefa não foi encontrada
Esse erro indica que o cluster foi excluído enquanto um job estava em execução. É possível realizar as seguintes ações para identificar o principal que realizou a exclusão e confirmar que a exclusão do cluster ocorreu quando um job estava em execução:
Confira os registros de auditoria do Serviço Gerenciado para Apache Spark para identificar o principal que realizou a operação de exclusão.
Use o Logging ou a CLI gcloud para verificar se o último estado conhecido do aplicativo YARN era RUNNING:
- Use o seguinte filtro no Logging:
resource.type="cloud_dataproc_cluster"
resource.labels.cluster_name="CLUSTER_NAME"
resource.labels.cluster_uuid="CLUSTER_UUID"
"YARN_APPLICATION_ID State change from"
- Execute
gcloud dataproc jobs describe job-id --region=REGIONe verifiqueyarnApplications: > STATEna saída.
Se o principal que excluiu o cluster for a conta de serviço do agente de serviço do Serviço Gerenciado para Apache Spark, verifique se o cluster foi configurado com uma duração de exclusão automática menor que a duração do job.
Para evitar erros Task not found, use a automação para garantir que os clusters não sejam excluídos
antes que todos os jobs em execução sejam concluídos.
Não há espaço livre no dispositivo
O Serviço Gerenciado para Apache Spark grava dados do HDFS e de rascunho no disco. Essa mensagem de erro indica que o cluster foi criado com espaço em disco insuficiente. Para analisar e evitar esse erro:
Verifique o tamanho do disco principal do cluster listado na guia Configuração na página Detalhes do cluster no console do Cloud de Confiance . O tamanho mínimo recomendado do disco é
1000 GBpara clusters que usam o tipo de máquinan1-standard-4e2 TBpara clusters que usam o tipo de máquinan1-standard-32.Se o tamanho do disco do cluster for menor que o recomendado, recrie o cluster com pelo menos o tamanho de disco recomendado.
Se o tamanho do disco for o recomendado ou maior, use o SSH para se conectar à VM mestre do cluster e execute
df -hna VM mestre para verificar a utilização do disco e determinar se é necessário mais espaço em disco.
Monitoramento e depuração de jobs
Use a Google Cloud CLI, a API REST do Serviço Gerenciado para Apache Spark e o console do Cloud de Confiance para analisar e depurar jobs do Serviço Gerenciado para Apache Spark.
CLI da gcloud
Para examinar o status de um job em execução:
gcloud dataproc jobs describe job-id \
    --region=region
Para ver a saída do driver do job, consulte Ver a saída do job.
API REST
Chame jobs.get para examinar os campos JobStatus.State, JobStatus.Substate, JobStatus.details, e YarnApplication.
Console
Para ver a saída do driver do job, consulte Ver a saída do job.
Para ver o registro do agente do Dataproc no Logging, selecione Serviço Gerenciado para Apache Spark Cluster→Nome do cluster→UUID do cluster no seletor de clusters da Análise de registros.
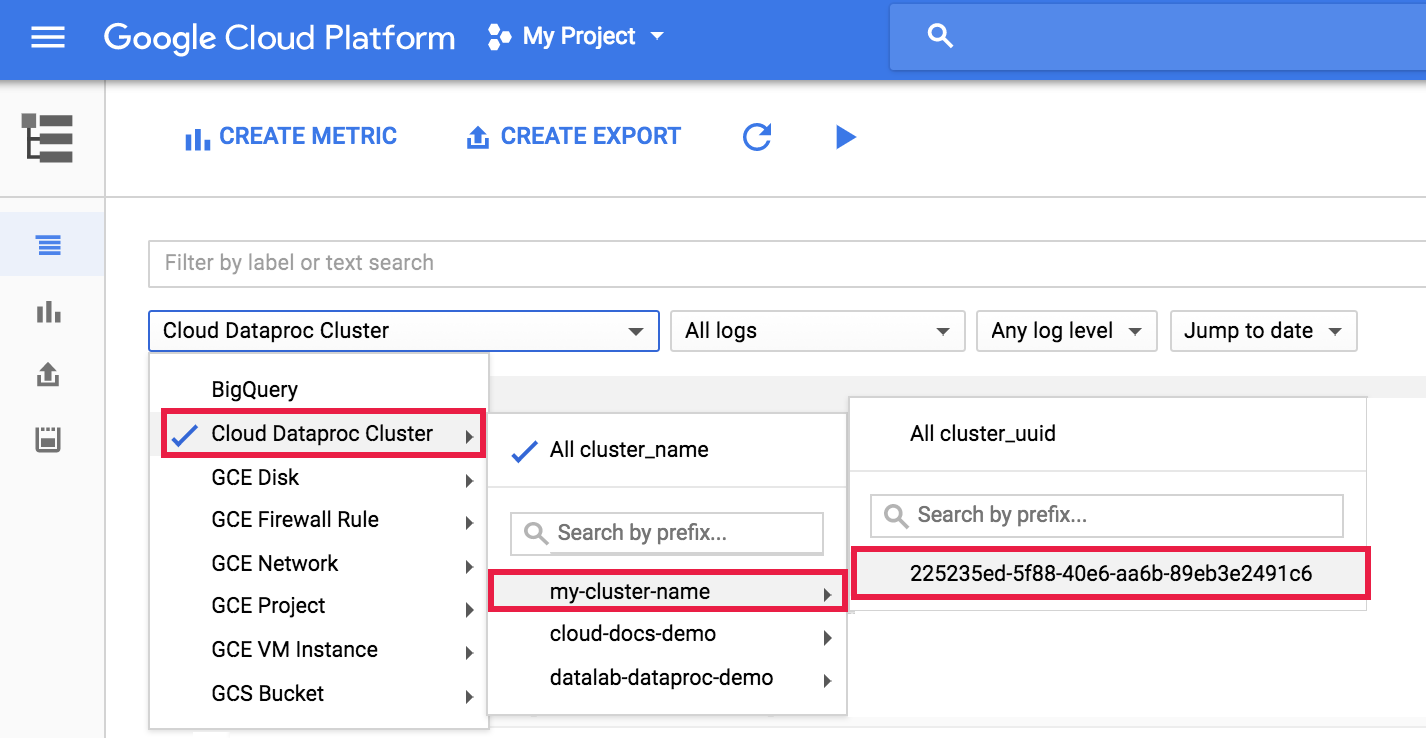
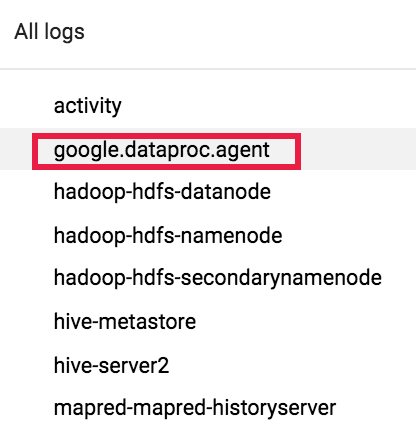
Em seguida, use o seletor para escolher registros google.dataproc.agent.
Ver registros de jobs no Logging
Se um job falhar, você poderá acessar os registros do job no Logging.
Determinar quem enviou um job
A pesquisa dos detalhes de um job mostrará quem enviou esse job no campo submittedBy. Por exemplo, a saída desse job mostra que user@domain enviou o job de exemplo para um cluster.
...
placement:
  clusterName: cluster-name
  clusterUuid: cluster-uuid
reference:
  jobId: job-uuid
  projectId: project
status:
  state: DONE
  stateStartTime: '2018-11-01T00:53:37.599Z'
statusHistory:
- state: PENDING
  stateStartTime: '2018-11-01T00:33:41.387Z'
- state: SETUP_DONE
  stateStartTime: '2018-11-01T00:33:41.765Z'
- details: Agent reported job success
  state: RUNNING
  stateStartTime: '2018-11-01T00:33:42.146Z'
submittedBy: user@domain