

Lorsque vous envoyez un job Managed Service pour Apache Spark, Managed Service pour Apache Spark collecte automatiquement le résultat du job et le met à votre disposition. Cela signifie que vous pouvez examiner rapidement le résultat d'un job sans avoir à maintenir une connexion au cluster pendant l'exécution de vos jobs ni à parcourir des fichiers journaux complexes.
Journaux Spark
Il existe deux types de journaux Spark : les journaux du pilote Spark et les journaux de l'exécuteur Spark.
Les journaux du pilote Spark contiennent la sortie du job. Les journaux de l'exécuteur Spark contiennent la sortie de l'exécutable ou du lanceur du job, comme un message spark-submit "Submitted application ... " (Application envoyée...), et peuvent être utiles pour déboguer les échecs de job.
Le pilote de job Managed Service pour Apache Spark, qui est distinct du pilote Spark, est un lanceur pour de nombreux types de jobs. Lors du lancement de jobs Spark, il s'exécute en tant que wrapper sur l'exécutable spark-submit sous-jacent, qui lance le pilote Spark. Le pilote Spark exécute le job sur le cluster Managed Service pour Apache Spark en mode Spark client ou cluster :
Mode
client: le pilote Spark exécute le job dans le processusspark-submit, et les journaux Spark sont envoyés au pilote de job Managed Service pour Apache Spark.Mode
cluster: le pilote Spark exécute le job dans un conteneur YARN. Les journaux du pilote Spark ne sont pas disponibles pour le pilote de job Managed Service pour Apache Spark.
Présentation des propriétés des jobs Managed Service pour Apache Spark et Spark
| Propriété | Valeur | Par défaut | Description |
|---|---|---|---|
dataproc:dataproc.logging.stackdriver.job.driver.enable |
"true" ou "false" | faux | Doit être défini au moment de la création du cluster. Lorsque la valeur est true, la sortie du pilote de job se trouve dans Logging, associée à la ressource de job. Lorsque la valeur est false, la sortie du pilote de job ne se trouve pas dans Logging.Remarque : Les paramètres de propriété de cluster suivants sont également requis pour activer les journaux du pilote de job dans Logging. Ils sont définis par défaut lors de la création d'un cluster : dataproc:dataproc.logging.stackdriver.enable=true et dataproc:jobs.file-backed-output.enable=true.
|
dataproc:dataproc.logging.stackdriver.job.yarn.container.enable |
"true" ou "false" | faux | Doit être défini au moment de la création du cluster.
Lorsque la valeur est true, les journaux de conteneur YARN du job sont associés à la ressource du job. Lorsque la valeur est false, les journaux de conteneur YARN du job sont associés à la ressource du cluster. |
spark:spark.submit.deployMode |
client ou cluster | Client | Contrôle le mode Spark client ou cluster. |
Jobs Spark envoyés à l'aide de l'API Managed Service pour Apache Spark jobs
Les tableaux de cette section répertorient l'effet de différents paramètres de propriété sur la destination de la sortie du pilote de job Managed Service pour Apache Spark lorsque les jobs sont envoyés via l'API Managed Service pour Apache Spark jobs, qui inclut l'envoi de jobs via la consoleCloud de Confiance , gcloud CLI et les bibliothèques clientes Cloud.
Les propriétés Managed Service pour Apache Spark et Spark listées peuvent être définies avec l'option --properties lors de la création d'un cluster et s'appliquent à tous les jobs Spark exécutés sur le cluster. Les propriétés Spark peuvent également être définies avec l'option --properties (sans le préfixe "spark:") lorsqu'un job est envoyé à l'API Managed Service pour Apache Spark jobs et ne s'appliquent qu'au job.
Sortie du pilote de job Managed Service pour Apache Spark
Les tableaux suivants listent l'effet de différents paramètres de propriété sur la destination de la sortie du pilote de job Managed Service pour Apache Spark.
dataproc: |
Sortie |
|---|---|
| false (valeur par défaut) |
|
| vrai |
|
Journaux du pilote Spark
Les tableaux suivants répertorient l'effet de différents paramètres de propriété sur la destination des journaux du pilote Spark.
spark: |
dataproc: |
dataproc: |
Sortie du pilote |
|---|---|---|---|
| Client | false (valeur par défaut) | "true" ou "false" |
|
| Client | vrai | "true" ou "false" |
|
| cluster | false (valeur par défaut) | faux |
|
| cluster | vrai | vrai |
|
Journaux de l'exécuteur Spark
Les tableaux suivants répertorient l'effet de différents paramètres de propriété sur la destination des journaux d'exécuteur Spark.
dataproc: |
Journal de l'exécuteur |
|---|---|
| false (valeur par défaut) | Dans Logging : yarn-userlogs sous la ressource de cluster |
| vrai | Dans Logging dataproc.job.yarn.container sous la ressource de job |
Jobs Spark envoyés sans l'API jobs de Managed Service pour Apache Spark
Cette section liste l'effet de différents paramètres de propriété sur la destination des journaux de jobs Spark lorsque les jobs sont envoyés sans utiliser l'API Managed Service pour Apache Spark jobs, par exemple lors de l'envoi d'un job directement sur un nœud de cluster à l'aide de spark-submit ou lors de l'utilisation d'un notebook Jupyter ou Zeppelin. Ces jobs n'ont pas d'ID de job ni de pilote Managed Service pour Apache Spark.
Journaux du pilote Spark
Les tableaux suivants listent l'effet de différents paramètres de propriété sur la destination des journaux du pilote Spark pour les jobs qui ne sont pas envoyés via l'API jobs de Managed Service pour Apache Spark.
spark: |
Sortie du pilote |
|---|---|
| Client |
|
| cluster |
|
Journaux de l'exécuteur Spark
Lorsque les jobs Spark ne sont pas envoyés via l'API Managed Service pour Apache Spark jobs, les journaux de l'exécuteur se trouvent dans Logging yarn-userlogs sous la ressource de cluster.
Afficher le résultat du job
Vous pouvez accéder au résultat du job Managed Service pour Apache Spark dans la console Cloud de Confiance , la gcloud CLI, Cloud Storage ou Logging.
Console
Pour afficher le résultat d'un job, accédez à la section Jobs de Managed Service pour Apache Spark de votre projet, puis cliquez sur l'ID du job.
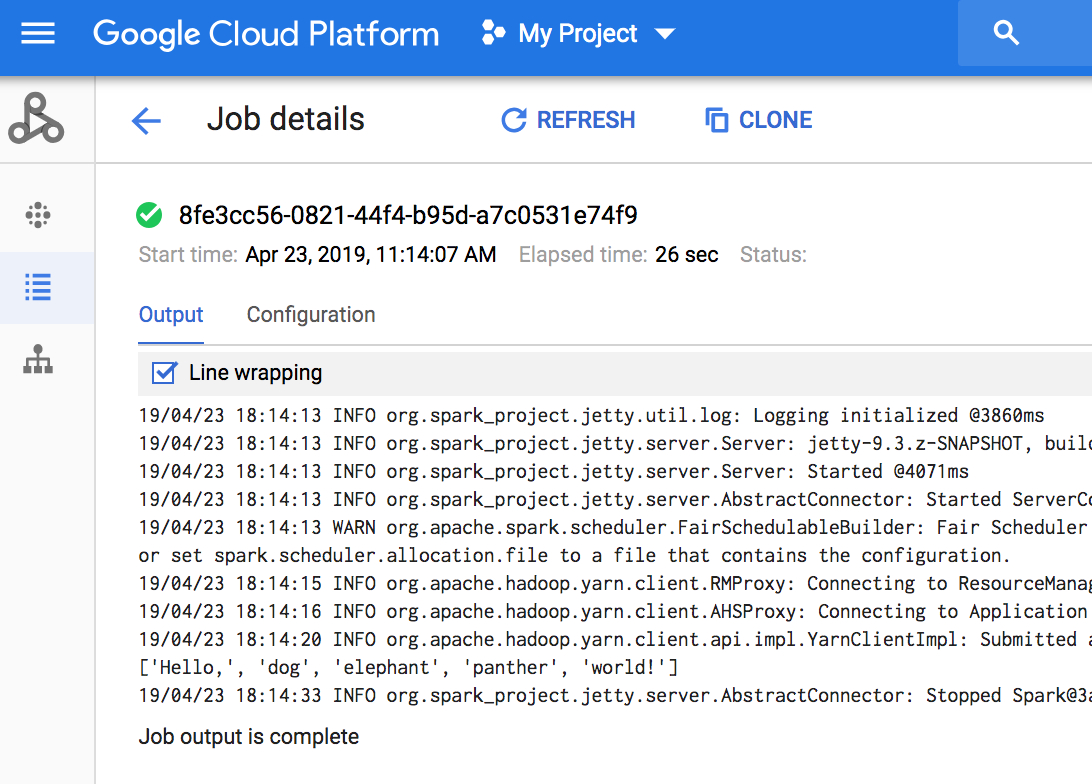
Si le job est en cours d'exécution, la sortie du job est actualisée régulièrement avec de nouveaux contenus.
Commande gcloud
Lorsque vous envoyez un job à l'aide de la commande gcloud dataproc jobs submit, le résultat du job s'affiche dans la console. Vous pouvez "rejoindre" la sortie ultérieurement, sur un autre ordinateur ou dans une nouvelle fenêtre en transmettant l'ID de votre job à la commande gcloud dataproc jobs wait. L'ID de tâche est un GUID, tel que 5c1754a5-34f7-4553-b667-8a1199cb9cab. Voici un exemple.
gcloud dataproc jobs wait 5c1754a5-34f7-4553-b667-8a1199cb9cab \
    --project my-project-id --region my-cluster-region
Waiting for job output...
... INFO gcs.GoogleHadoopFileSystemBase: GHFS version: 1.4.2-hadoop2
... 16:47:45 INFO client.RMProxy: Connecting to ResourceManager at my-test-cluster-m/
...
Cloud Storage
Le résultat du job est stocké dans Cloud Storage, soit dans le bucket de préproduction, soit dans le bucket que vous avez spécifié lors de la création de votre cluster. Un lien vers le résultat du job dans Cloud Storage est fourni dans le champ Job.driverOutputResourceUri renvoyé par :
- une requête d'API jobs.get.
- une commande gcloud dataproc jobs describe job-id.
$ gcloud dataproc jobs describe spark-pi
...
driverOutputResourceUri: gs://dataproc-nnn/jobs/spark-pi/driveroutput
...