

Un recurso NodeGroup de Managed Service para Apache Spark es un grupo de nodos de clúster de Managed Service para Apache Spark
que ejecutan un rol asignado. En esta página, se describe el
grupo de nodos controladores, que es un grupo de VMs de Compute Engine a las que se les asigna
el rol Driver con el propósito de ejecutar controladores de trabajos en el
clúster de Managed Service para Apache Spark.
Cuándo usar grupos de nodos controladores
- Usa grupos de nodos controladores solo cuando necesites ejecutar muchos trabajos simultáneos en un clúster compartido.
- Aumenta los recursos del nodo principal antes de usar grupos de nodos controladores para evitar las limitaciones de los grupos de nodos controladores.
Cómo los nodos controladores te ayudan a ejecutar trabajos simultáneos
Managed Service para Apache Spark inicia un proceso de controlador de trabajos en una instancia principal del clúster de Managed Service para Apache Spark
para cada trabajo. A su vez, el proceso del controlador
ejecuta un controlador de aplicación, como spark-submit, como su proceso secundario.
Sin embargo, la cantidad de trabajos simultáneos que se ejecutan en el nodo principal está limitada por los
recursos disponibles en el nodo principal y, como los nodos principales de Managed Service para Apache Spark
no se pueden escalar, un trabajo puede fallar o limitarse cuando los recursos del nodo principal
son insuficientes para ejecutar un trabajo.
Los grupos de nodos controladores son grupos de nodos especiales administrados por YARN, por lo que la simultaneidad de los trabajos no está limitada por los recursos del nodo principal. En los clústeres con un grupo de nodos controladores, los controladores de aplicaciones se ejecutan en los nodos controladores. Cada nodo controlador puede ejecutar varios controladores de aplicaciones si el nodo tiene recursos suficientes.
Beneficios
Usar un clúster de Managed Service para Apache Spark con un grupo de nodos controladores te permite hacer lo siguiente:
- Escala horizontalmente los recursos del controlador de trabajos para ejecutar más trabajos simultáneos
- Escala los recursos del controlador de forma independiente de los recursos de los trabajadores
- Obtén una reducción de escala más rápida en los clústeres de imágenes de Managed Service para Apache Spark 2.0 y versiones posteriores. En estos clústeres, la app principal se ejecuta dentro de un controlador de Spark en un grupo de nodos controladores (el
spark.yarn.unmanagedAM.enabledse establece entruede forma predeterminada). - Personaliza el inicio del nodo controlador. Puedes agregar
{ROLE} == 'Driver'en una secuencia de comandos de inicialización para que la secuencia de comandos realice acciones para un grupo de nodos controladores en la selección de nodos.
Limitaciones
- Los grupos de nodos no son compatibles con las plantillas de flujo de trabajo de Managed Service para Apache Spark.
- Los clústeres de grupos de nodos no se pueden detener, reiniciar ni ajustar automáticamente.
- La app principal de MapReduce se ejecuta en los nodos trabajadores. La reducción de la escala de los nodos trabajadores puede ser lenta si habilitas el retiro de servicio ordenado.
- La simultaneidad de trabajos se ve afectada por la propiedad del clúster
dataproc:agent.process.threads.job.max. Por ejemplo, con tres instancias maestras y esta propiedad establecida en el valor predeterminado de100, la simultaneidad máxima de trabajos a nivel de clúster es300.
Grupo de nodos controladores en comparación con el modo de clúster de Spark
| Función | Modo de clúster de Spark | Grupo de nodos controladores |
|---|---|---|
| Reducción de la escala verticalmente de los nodos trabajadores | Los controladores de larga duración se ejecutan en los mismos nodos trabajadores que los contenedores de corta duración, lo que hace que la reducción de escala vertical de los trabajadores con el retiro de servicio ordenado sea lenta. | Los nodos trabajadores reducen la escala verticalmente con mayor rapidez cuando los controladores se ejecutan en grupos de nodos. |
| Salida del controlador transmitida | Se requiere buscar en los registros de YARN para encontrar el nodo en el que se programó el controlador. | El resultado del controlador se transmite a Cloud Storage y se puede ver
en la consola de Cloud de Confiance y en el resultado del comando gcloud dataproc jobs wait
después de que se completa un trabajo. |
Permisos de IAM del grupo de nodos controladores
Los siguientes permisos de IAM están asociados con las acciones relacionadas con el grupo de nodos de Managed Service para Apache Spark.
| Permiso | Acción |
|---|---|
dataproc.nodeGroups.create
|
Crea grupos de nodos de Managed Service para Apache Spark. Si un usuario tiene
dataproc.clusters.create en el proyecto, se otorga
este permiso. |
dataproc.nodeGroups.get |
Obtén los detalles de un grupo de nodos de Managed Service para Apache Spark. |
dataproc.nodeGroups.update |
Cambia el tamaño de un grupo de nodos de Managed Service para Apache Spark. |
Operaciones de grupos de nodos controladores
Puedes usar gcloud CLI y la API de Managed Service para Apache Spark para crear, obtener, cambiar el tamaño, borrar y enviar un trabajo a un grupo de nodos controladores de Managed Service para Apache Spark.
Crea un clúster de grupo de nodos de controlador
Un grupo de nodos controladores se asocia con un clúster de Managed Service para Apache Spark. Creas un grupo de nodos como parte de la creación de un clúster de Managed Service para Apache Spark. Puedes usar la gcloud CLI o la API de REST de Managed Service para Apache Spark para crear un clúster de Managed Service para Apache Spark con un grupo de nodos controladores.
gcloud
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --driver-pool-size=SIZE \
    --driver-pool-id=NODE_GROUP_ID
Marcas obligatorias:
- CLUSTER_NAME: Es el nombre del clúster, que debe ser único dentro de un proyecto. El nombre debe comenzar con una letra minúscula y puede contener hasta 51 letras minúsculas, números y guiones. No puede terminar con un guion. El nombre de un clúster borrado se puede volver a usar.
- REGION: Es la región en la que se ubicará el clúster.
- SIZE: Es la cantidad de nodos controladores en el grupo de nodos. La cantidad de nodos necesarios depende de la carga del trabajo y del tipo de máquina del grupo de controladores. La cantidad mínima de nodos del grupo de controladores es igual a la memoria total o las CPU virtuales que requieren los controladores de trabajos divididas por la memoria o las CPU virtuales de la máquina de cada grupo de controladores.
- NODE_GROUP_ID: Opcional y recomendado. El ID debe ser único en el clúster. Usa este ID para identificar el grupo de controladores en operaciones futuras, como cambiar el tamaño del grupo de nodos. Si no se especifica, Managed Service para Apache Spark genera el ID del grupo de nodos.
Marca recomendada:
--enable-component-gateway: Agrega esta marca para habilitar la puerta de enlace de componentes de Managed Service para Apache Spark, que proporciona acceso a la interfaz web de YARN. En las páginas Aplicación y Programador de la IU de YARN, se muestran el estado del clúster y del trabajo, la memoria de la cola de aplicaciones, la capacidad de núcleos y otras métricas.
Marcas adicionales: Las siguientes marcas opcionales de driver-pool se pueden agregar
al comando gcloud dataproc clusters create para personalizar el grupo de nodos.
| Marca | Valor predeterminado |
|---|---|
--driver-pool-id |
Es un identificador de cadena que genera el servicio si no lo establece la marca. Este ID se puede usar para identificar el grupo de nodos cuando se realicen operaciones futuras en el grupo de nodos, como cambiar su tamaño. |
--driver-pool-machine-type |
n1-standard-4 |
--driver-pool-accelerator |
No hay predeterminado. Cuando se especifica un acelerador, se requiere el tipo de GPU; la cantidad de GPU es opcional. |
--num-driver-pool-local-ssds |
Sin opción predeterminada |
--driver-pool-local-ssd-interface |
Sin opción predeterminada |
--driver-pool-boot-disk-type |
pd-standard |
--driver-pool-boot-disk-size |
1000 GB |
--driver-pool-min-cpu-platform |
AUTOMATIC |
REST
Completa un
AuxiliaryNodeGroup
como parte de una solicitud
cluster.create
de la API de Managed Service para Apache Spark.
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Obligatorio. ID del proyecto de Google Cloud.
- REGION: Obligatorio. Región del clúster de Dataproc.
- CLUSTER_NAME: Obligatorio. El nombre del clúster, que debe ser único dentro de un proyecto. El nombre debe comenzar con una letra minúscula y puede contener hasta 51 letras minúsculas, números y guiones. No puede terminar con un guion. El nombre de un clúster borrado se puede volver a usar.
- SIZE: Obligatorio. Es la cantidad de nodos en el grupo de nodos.
- NODE_GROUP_ID: Opcional y recomendado. El ID debe ser único dentro del clúster. Usa este ID para identificar el grupo de controladores en operaciones futuras, como cambiar el tamaño del grupo de nodos. Si no se especifica, Managed Service para Apache Spark genera el ID del grupo de nodos.
Opciones adicionales: Consulta NodeGroup.
Método HTTP y URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters
Cuerpo JSON de la solicitud:
{
  "clusterName":"CLUSTER_NAME",
  "config": {
    "softwareConfig": {
      "imageVersion":""
    },
    "endpointConfig": {
      "enableHttpPortAccess": true
    },
    "auxiliaryNodeGroups": [{
        "nodeGroup":{
            "roles":["DRIVER"],
            "nodeGroupConfig": {
                "numInstances": SIZE
             }
         },
        "nodeGroupId": "NODE_GROUP_ID"
    }]
  }
}
Para enviar tu solicitud, expande una de estas opciones:
Deberías recibir una respuesta JSON similar a la que se muestra a continuación:
{
  "projectId": "PROJECT_ID",
  "clusterName": "CLUSTER_NAME",
  "config": {
    ...
    "auxiliaryNodeGroups": [
      {
        "nodeGroup": {
"name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
          "roles": [
            "DRIVER"
          ],
          "nodeGroupConfig": {
            "numInstances": SIZE,
            "instanceNames": [
              "CLUSTER_NAME-np-q1gp",
              "CLUSTER_NAME-np-xfc0"
            ],
            "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
            "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
            "diskConfig": {
              "bootDiskSizeGb": 1000,
              "bootDiskType": "pd-standard"
            },
            "managedGroupConfig": {
              "instanceTemplateName": "dataproc-2a8224d2-...",
              "instanceGroupManagerName": "dataproc-2a8224d2-..."
            },
            "minCpuPlatform": "AUTOMATIC",
            "preemptibility": "NON_PREEMPTIBLE"
          }
        },
        "nodeGroupId": "NODE_GROUP_ID"
      }
    ]
  },
}
Obtén los metadatos del clúster del grupo de nodos controladores
Puedes usar el
comando gcloud dataproc node-groups describe
o la API de Managed Service para Apache Spark para
obtener metadatos del grupo de nodos controladores.
gcloud
gcloud dataproc node-groups describe NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION
Marcas obligatorias:
- NODE_GROUP_ID: Puedes ejecutar
gcloud dataproc clusters
describe CLUSTER_NAME
para enumerar el ID del grupo de nodos. - CLUSTER_NAME: Es el nombre del clúster.
- REGION: Es la región del clúster.
REST
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Obligatorio. ID del proyecto de Google Cloud.
- REGION: Obligatorio. Es la región del clúster.
- CLUSTER_NAME: Obligatorio. Es el nombre del clúster.
- NODE_GROUP_ID: Obligatorio. Puedes ejecutar
gcloud dataproc clusters describe CLUSTER_NAMEpara enumerar el ID del grupo de nodos.
Método HTTP y URL:
GET https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAMEnodeGroups/Node_GROUP_ID
Para enviar tu solicitud, expande una de estas opciones:
Deberías recibir una respuesta JSON similar a la que se muestra a continuación:
{
  "name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
  "roles": [
    "DRIVER"
  ],
  "nodeGroupConfig": {
    "numInstances": 5,
    "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
    "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
    "diskConfig": {
      "bootDiskSizeGb": 1000,
      "bootDiskType": "pd-standard"
    },
    "managedGroupConfig": {
      "instanceTemplateName": "dataproc-driver-pool-mcia3j656h2fy",
      "instanceGroupManagerName": "dataproc-driver-pool-mcia3j656h2fy"
    },
    "minCpuPlatform": "AUTOMATIC",
    "preemptibility": "NON_PREEMPTIBLE"
  }
}
Cambia el tamaño de un grupo de nodos controladores
Puedes usar el comando
gcloud dataproc node-groups resize
o la API de Managed Service para Apache Spark
para agregar o quitar nodos controladores de un grupo de nodos controladores de clúster.
gcloud
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=SIZE
Marcas obligatorias:
- NODE_GROUP_ID: Puedes ejecutar
gcloud dataproc clusters
describe CLUSTER_NAME
para enumerar el ID del grupo de nodos. - CLUSTER_NAME: Es el nombre del clúster.
- REGION: Es la región del clúster.
- SIZE: Especifica la nueva cantidad de nodos controladores en el grupo de nodos.
Marca opcional:
--graceful-decommission-timeout=TIMEOUT_DURATION: Cuando reduces la escala verticalmente de un grupo de nodos, puedes agregar esta marca para especificar un retiro de servicio ordenado TIMEOUT_DURATION para evitar la finalización inmediata de los controladores de trabajos. Recomendación: Establece una duración del tiempo de espera que sea, al menos, igual a la duración del trabajo más largo que se ejecuta en el grupo de nodos (no se admite la recuperación de controladores con errores).
Ejemplo: Comando de escalamiento vertical de NodeGroup de gcloud CLI:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=4
Ejemplo: Comando de reducción de escala vertical de gcloud CLI NodeGroup:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=1 \
    --graceful-decommission-timeout="100s"
REST
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Obligatorio. ID del proyecto de Google Cloud.
- REGION: Obligatorio. Es la región del clúster.
- NODE_GROUP_ID: Obligatorio. Puedes ejecutar
gcloud dataproc
    clusters describe CLUSTER_NAME
para enumerar el ID del grupo de nodos. - SIZE: Obligatorio. Es la cantidad nueva de nodos en el grupo de nodos.
- TIMEOUT_DURATION: Opcional Cuando reduzcas la escala verticalmente de un grupo de nodos,
puedes agregar un
gracefulDecommissionTimeoutal cuerpo de la solicitud para evitar la finalización inmediata de los controladores de trabajos. Recomendación: Establece una duración de tiempo de espera que sea, al menos, igual a la duración del trabajo más largo que se ejecuta en el grupo de nodos (no se admite la recuperación de controladores con errores).Ejemplo:
{ "size": SIZE,
  "gracefulDecommissionTimeout": "TIMEOUT_DURATION"
}
Método HTTP y URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/Node_GROUP_ID:resize
Cuerpo JSON de la solicitud:
{
  "size": SIZE,
}
Para enviar tu solicitud, expande una de estas opciones:
Deberías recibir una respuesta JSON similar a la que se muestra a continuación:
{
  "name": "projects/PROJECT_ID/regions/REGION/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.dataproc.v1.NodeGroupOperationMetadata",
    "nodeGroupId": "NODE_GROUP_ID",
    "clusterUuid": "CLUSTER_UUID",
    "status": {
      "state": "PENDING",
      "innerState": "PENDING",
      "stateStartTime": "2022-12-01T23:34:53.064308Z"
    },
    "operationType": "RESIZE",
    "description": "Scale "up or "down" a GCE node pool to SIZE nodes."
  }
}
Borra un clúster de grupo de nodos controladores
Cuando borras un clúster de Managed Service para Apache Spark, se borran los grupos de nodos asociados al clúster.
Envía un trabajo
Puedes usar el comando gcloud dataproc jobs submit
o la API de Managed Service para Apache Spark para
enviar un trabajo a un clúster
con un grupo de nodos controladores.
gcloud
gcloud dataproc jobs submit JOB_COMMAND \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=DRIVER_MEMORY \
    --driver-required-vcores=DRIVER_VCORES \
    DATAPROC_FLAGS \
    -- JOB_ARGS
Marcas obligatorias:
- JOB_COMMAND: Especifica el comando del trabajo.
- CLUSTER_NAME: Es el nombre del clúster.
- DRIVER_MEMORY: Es la cantidad de memoria de los controladores de trabajos en MB necesaria para ejecutar un trabajo (consulta Controles de memoria de Yarn).
- DRIVER_VCORES: Es la cantidad de CPUs virtuales necesarias para ejecutar un trabajo.
Marcas adicionales:
- DATAPROC_FLAGS: Agrega cualquier marca adicional de gcloud dataproc jobs submit relacionada con el tipo de trabajo.
- JOB_ARGS: Agrega cualquier argumento (después de
--) para pasarlo al trabajo.
Ejemplos: Puedes ejecutar los siguientes ejemplos desde una sesión de terminal SSH en un clúster de grupo de nodos controladores de Managed Service para Apache Spark.
Trabajo de Spark para estimar el valor de
pi:gcloud dataproc jobs submit spark \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ --class=org.apache.spark.examples.SparkPi \ --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \ -- 1000
Trabajo de Spark de recuento de palabras:
gcloud dataproc jobs submit spark \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --class=org.apache.spark.examples.JavaWordCount \
    --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \
    -- 'gs://apache-beam-samples/shakespeare/macbeth.txt'
Trabajo de PySpark para estimar el valor de
pi:gcloud dataproc jobs submit pyspark \ file:///usr/lib/spark/examples/src/main/python/pi.py \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ -- 1000
Trabajo de MapReduce de TeraGen de Hadoop:
gcloud dataproc jobs submit hadoop \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --jar file:///usr/lib/hadoop-mapreduce/hadoop-mapreduce-examples.jar \
    -- teragen 1000 \
    hdfs:///gen1/test
REST
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Obligatorio. ID del proyecto de Google Cloud.
- REGION: Obligatorio. Región del clúster de Dataproc
- CLUSTER_NAME: Obligatorio. El nombre del clúster, que debe ser único dentro de un proyecto. El nombre debe comenzar con una letra minúscula y puede contener hasta 51 letras minúsculas, números y guiones. No puede terminar con un guion. El nombre de un clúster borrado se puede volver a usar.
- DRIVER_MEMORY: Obligatorio. Es la cantidad de memoria de los controladores de trabajos en MB necesaria para ejecutar un trabajo (consulta Controles de memoria de Yarn).
- DRIVER_VCORES: Obligatorio. Es la cantidad de CPU virtuales necesarias para ejecutar un trabajo.
pi).
Método HTTP y URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/jobs:submit
Cuerpo JSON de la solicitud:
{
  "job": {
    "placement": {
    "clusterName": "CLUSTER_NAME",
    },
    "driverSchedulingConfig": {
      "memoryMb]": DRIVER_MEMORY,
      "vcores": DRIVER_VCORES
    },
    "sparkJob": {
      "jarFileUris": "file:///usr/lib/spark/examples/jars/spark-examples.jar",
      "args": [
        "10000"
      ],
      "mainClass": "org.apache.spark.examples.SparkPi"
    }
  }
}
Para enviar tu solicitud, expande una de estas opciones:
Deberías recibir una respuesta JSON similar a la que se muestra a continuación:
{
  "reference": {
    "projectId": "PROJECT_ID",
    "jobId": "job-id"
  },
  "placement": {
    "clusterName": "CLUSTER_NAME",
    "clusterUuid": "cluster-Uuid"
  },
  "sparkJob": {
    "mainClass": "org.apache.spark.examples.SparkPi",
    "args": [
      "1000"
    ],
    "jarFileUris": [
      "file:///usr/lib/spark/examples/jars/spark-examples.jar"
    ]
  },
  "status": {
    "state": "PENDING",
    "stateStartTime": "start-time"
  },
  "jobUuid": "job-Uuid"
}
Python
- Instala la biblioteca cliente
- Configura credenciales predeterminadas de la aplicación
- Ejecuta el código
- Trabajo de Spark para estimar el valor de pi:
- Trabajo de PySpark para imprimir "hello world":
Ver registros de trabajos
Para ver el estado del trabajo y ayudar a depurar los problemas, puedes ver los registros del controlador con gcloud CLI o la consola de Cloud de Confiance .
gcloud
Los registros del controlador de trabajos se transmiten al resultado de gcloud CLI o a la consola deCloud de Confiance durante la ejecución del trabajo. Los registros del controlador persisten en el bucket de etapa de pruebas del clúster de Managed Service para Apache Spark en Cloud Storage.
Ejecuta el siguiente comando de gcloud CLI para enumerar la ubicación de los registros del controlador en Cloud Storage:
gcloud dataproc jobs describe JOB_ID \
    --region=REGION
La ubicación de Cloud Storage de los registros del controlador se indica como
driverOutputResourceUri en el resultado del comando con el siguiente formato:
driverOutputResourceUri: gs://CLUSTER_STAGING_BUCKET/google-cloud-dataproc-metainfo/CLUSTER_UUID/jobs/JOB_ID
Console
Para ver los registros del clúster de grupos de nodos, haz lo siguiente:
Puedes usar el siguiente formato de consulta del Explorador de registros para encontrar registros:
resource.type="cloud_dataproc_cluster"
resource.labels.project_id="PROJECT_ID"
resource.labels.cluster_name="CLUSTER_NAME"
log_name="projects/PROJECT_ID/logs/LOG_TYPE>"
- PROJECT_ID: Es el ID del proyecto de Cloud de Confiance .
- CLUSTER_NAME: Es el nombre del clúster.
- LOG_TYPE:
- Registros de usuarios de Yarn:
yarn-userlogs - Registros del administrador de recursos de Yarn:
hadoop-yarn-resourcemanager - Registros del administrador de nodos de Yarn:
hadoop-yarn-nodemanager
- Registros de usuarios de Yarn:
Supervisa las métricas
Los controladores de trabajos del grupo de nodos de Managed Service para Apache Spark se ejecutan en una
cola secundaria dataproc-driverpool-driver-queue en una partición
dataproc-driverpool.
Métricas del grupo de nodos controladores
En la siguiente tabla, se enumeran las métricas del controlador del grupo de nodos asociadas, que se recopilan de forma predeterminada para los grupos de nodos controladores.
| Métrica del grupo de nodos controladores | Descripción |
|---|---|
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMB |
Es la cantidad de memoria disponible en mebibytes en
dataproc-driverpool-driver-queue en la
partición dataproc-driverpool.
|
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainers |
Es la cantidad de contenedores pendientes (en cola) en
dataproc-driverpool-driver-queue en la
partición dataproc-driverpool. |
Métricas de la cola secundaria
En la siguiente tabla, se enumeran las métricas de las colas secundarias. Las métricas se recopilan de forma predeterminada para los grupos de nodos controladores y se pueden habilitar para la recopilación en cualquier clúster de Managed Service para Apache Spark.
| Métrica de la cola secundaria | Descripción |
|---|---|
yarn:ResourceManager:ChildQueueMetrics:AvailableMB |
Es la cantidad de memoria disponible en mebibytes en esta cola en la partición predeterminada. |
yarn:ResourceManager:ChildQueueMetrics:PendingContainers |
Cantidad de contenedores pendientes (en cola) en esta cola en la partición predeterminada. |
yarn:ResourceManager:ChildQueueMetrics:running_0 |
Es la cantidad de trabajos con un tiempo de ejecución de entre 0 y 60 minutos
en esta cola en todas las particiones. |
yarn:ResourceManager:ChildQueueMetrics:running_60 |
Es la cantidad de trabajos con un tiempo de ejecución de entre 60 y 300 minutos
en esta cola en todas las particiones. |
yarn:ResourceManager:ChildQueueMetrics:running_300 |
Es la cantidad de trabajos con un tiempo de ejecución de entre 300 y 1440 minutos
en esta cola en todas las particiones. |
yarn:ResourceManager:ChildQueueMetrics:running_1440 |
Es la cantidad de trabajos con un tiempo de ejecución superior a 1440 minutos
en esta cola en todas las particiones. |
yarn:ResourceManager:ChildQueueMetrics:AppsSubmitted |
Es la cantidad de aplicaciones enviadas a esta cola en todas las particiones. |
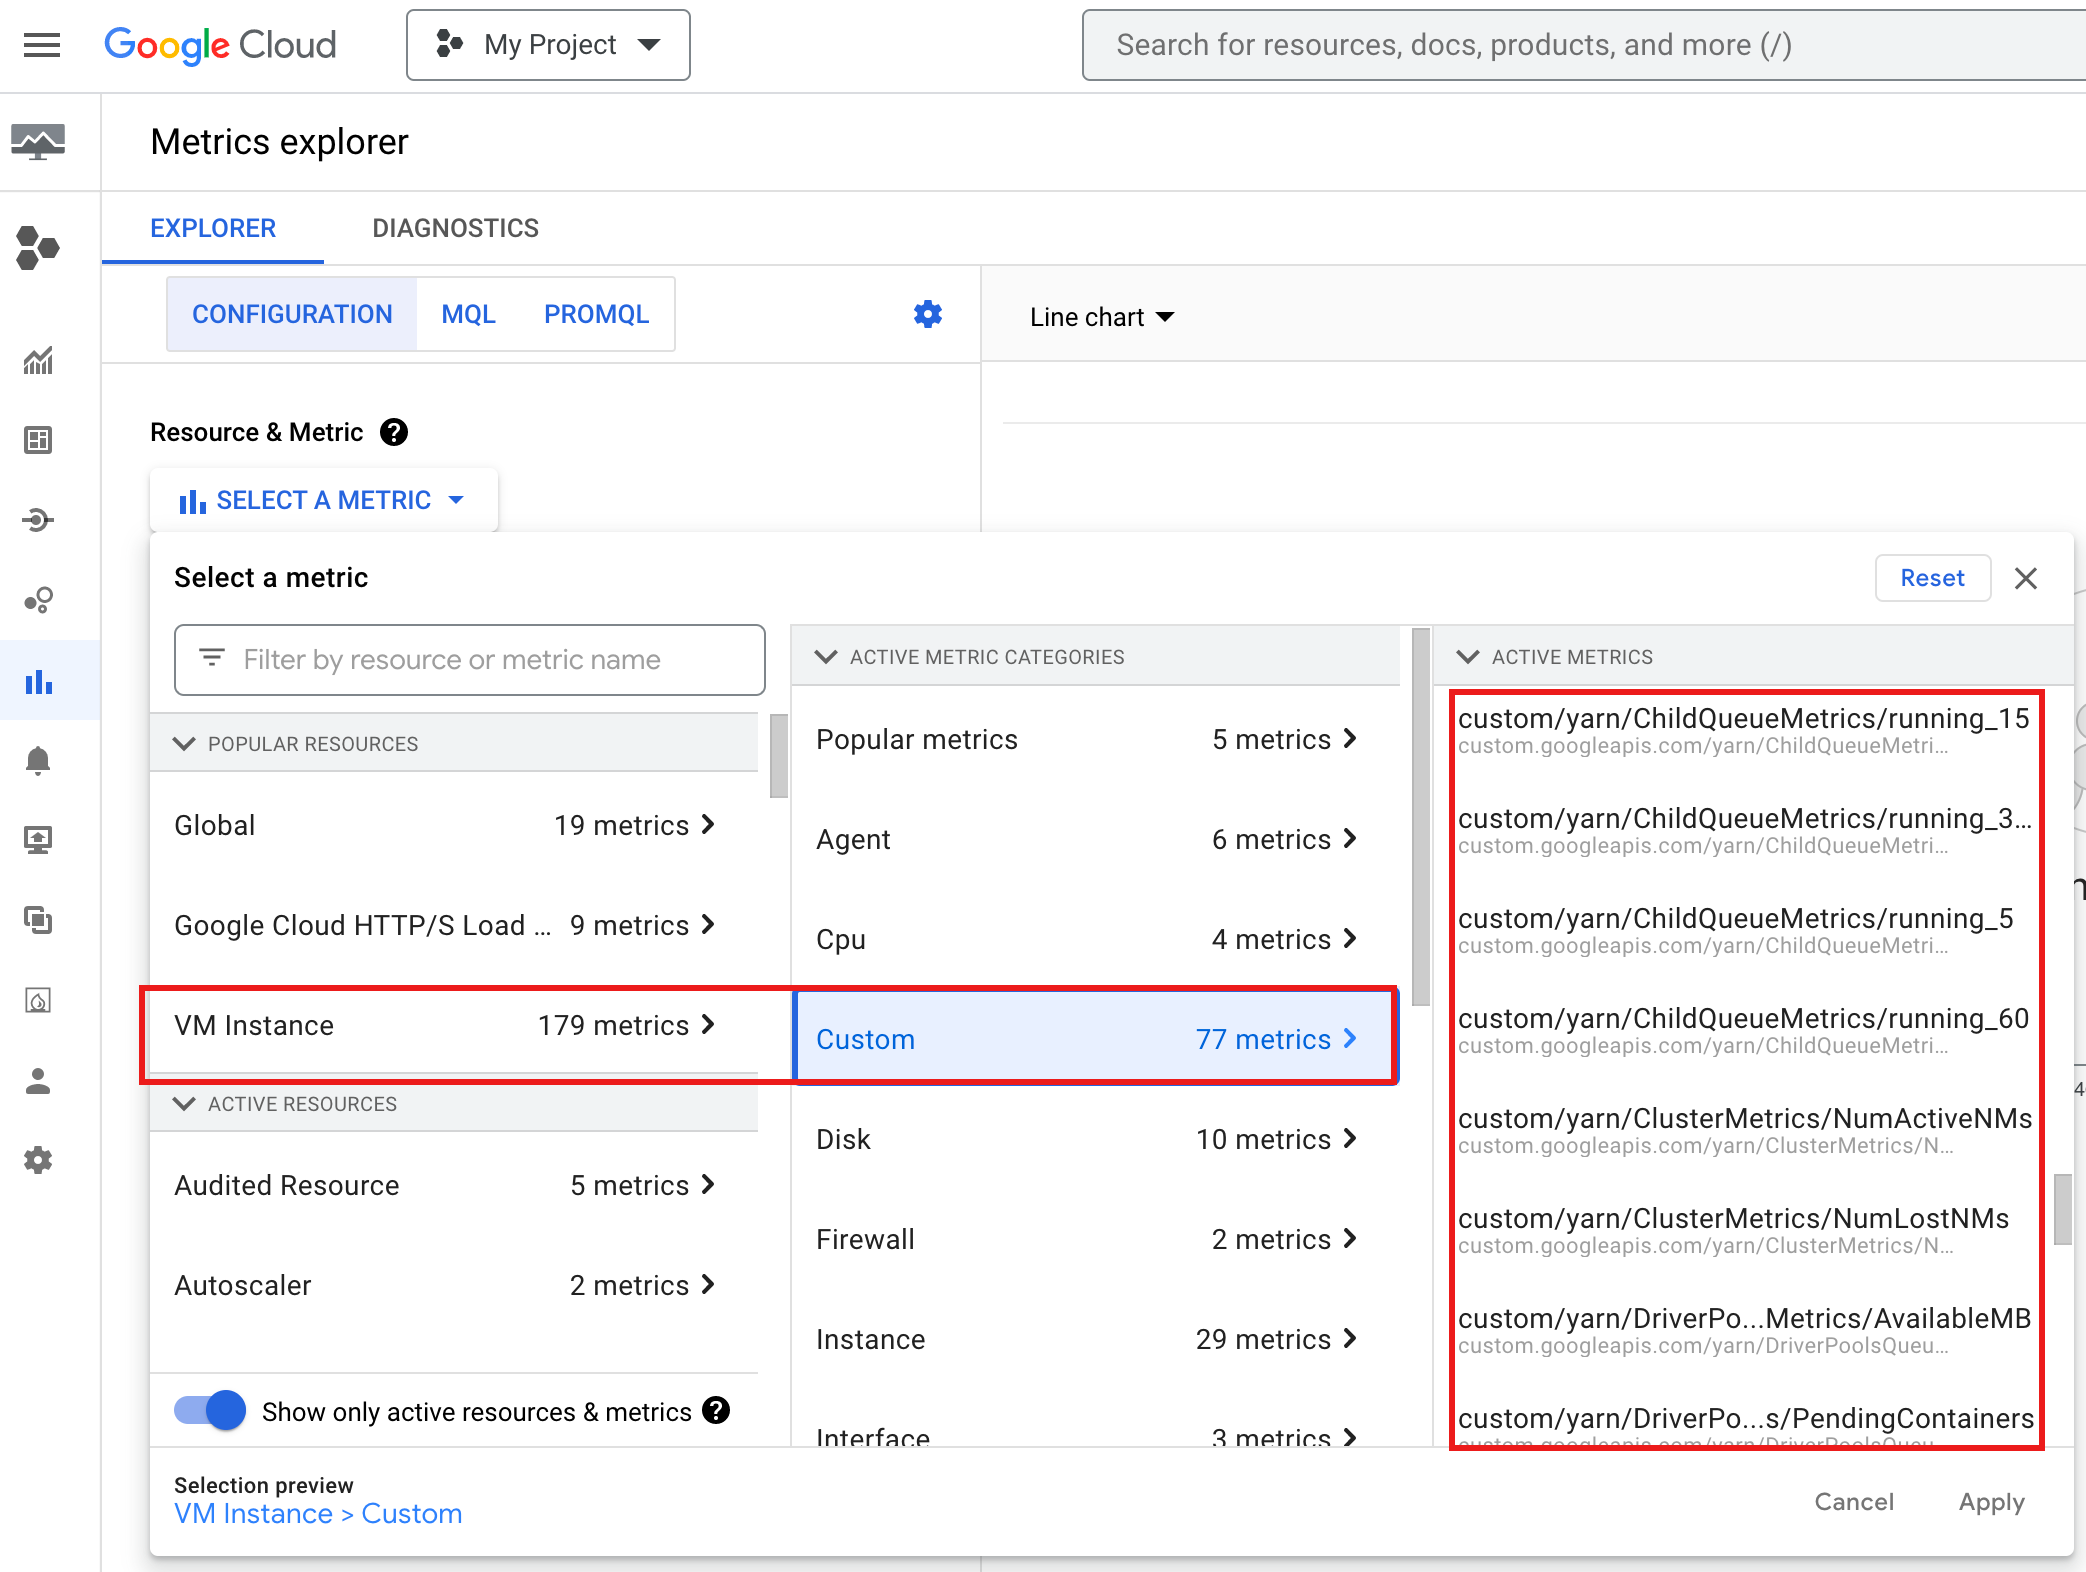
Para ver YARN ChildQueueMetrics y DriverPoolsQueueMetrics en la
consola deCloud de Confiance , sigue estos pasos:
Selecciona los recursos Instancia de VM → Personalizado en el Explorador de métricas.
Controlador de trabajos del grupo de nodos de depuración
En esta sección, se proporcionan las condiciones y los errores del grupo de nodos controladores con recomendaciones para corregir la condición o el error.
Condiciones
Condición:
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMBse acerca a0. Esto indica que la cola de grupos de controladores del clúster se está quedando sin memoria.Recomendación: Aumenta el tamaño del grupo de conductores.
Condición:
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainerses mayor que 0. Esto puede indicar que los grupos de controladores del clúster se están quedando sin memoria insuficiente y YARN está poniendo en cola los trabajos.Recomendación: Aumenta el tamaño del grupo de conductores.
Errores
Error:
Cluster <var>CLUSTER_NAME</var> requires driver scheduling config to run
SPARK job because it contains a node pool with role DRIVER.
Positive values are required for all driver scheduling config values.
Recomendación: Configura
driver-required-memory-mbydriver-required-vcorescon números positivos.Error:
Container exited with a non-zero exit code 137.Recomendación: Aumenta
driver-required-memory-mbpara el uso de memoria del trabajo.