

Une ressource NodeGroup Managed Service pour Apache Spark est un groupe de nœuds de cluster Managed Service pour Apache Spark qui exécutent un rôle attribué. Cette page décrit le groupe de nœuds pilotes, qui est un groupe de VM Compute Engine auxquelles le rôle Driver est attribué pour exécuter des pilotes de job sur le cluster Managed Service pour Apache Spark.
Quand utiliser des groupes de nœuds de pilote ?
- N'utilisez des groupes de nœuds pilotes que lorsque vous devez exécuter de nombreux jobs simultanés sur un cluster partagé.
- Augmentez les ressources du nœud maître avant d'utiliser des groupes de nœuds pilotes pour éviter les limites des groupes de nœuds pilotes.
Comment les nœuds de pilote vous aident à exécuter des jobs simultanés
Managed Service pour Apache Spark démarre un processus de pilote de job sur un nœud maître de cluster Managed Service pour Apache Spark pour chaque job. Le processus du pilote exécute à son tour un pilote d'application, tel que spark-submit, en tant que processus enfant.
Toutefois, le nombre de jobs simultanés exécutés sur le nœud maître est limité par les ressources disponibles sur ce nœud. Comme les nœuds maîtres de Managed Service pour Apache Spark ne peuvent pas être mis à l'échelle, un job peut échouer ou être limité lorsque les ressources du nœud maître sont insuffisantes pour l'exécuter.
Les groupes de nœuds pilotes sont des groupes de nœuds spéciaux gérés par YARN. La simultanéité des jobs n'est donc pas limitée par les ressources du nœud maître. Dans les clusters dotés d'un groupe de nœuds pilotes, les pilotes d'application s'exécutent sur les nœuds pilotes. Chaque nœud de pilote peut exécuter plusieurs pilotes d'application si le nœud dispose de ressources suffisantes.
Avantages
L'utilisation d'un cluster Managed Service pour Apache Spark avec un groupe de nœuds de pilote vous permet d'effectuer les opérations suivantes :
- Effectuez un scaling horizontal des ressources de pilote de job pour exécuter davantage de jobs simultanés.
- Faire évoluer les ressources de pilote séparément des ressources de nœud de calcul
- Obtenez un scaling à la baisse plus rapide sur les clusters d'images Managed Service pour Apache Spark 2.0 et versions ultérieures. Sur ces clusters, l'app master s'exécute dans un pilote Spark d'un groupe de nœuds pilotes (
spark.yarn.unmanagedAM.enabledest défini surtruepar défaut). - Personnalisez le démarrage du nœud pilote. Vous pouvez ajouter
{ROLE} == 'Driver'dans un script d'initialisation pour que le script effectue des actions pour un groupe de nœuds pilotes dans la sélection de nœuds.
Limites
- Les groupes de nœuds ne sont pas compatibles avec les modèles de workflow Managed Service pour Apache Spark.
- Les clusters de groupes de nœuds ne peuvent pas être arrêtés, redémarrés ni soumis à l'autoscaling.
- Le maître d'application MapReduce s'exécute sur les nœuds de calcul. La réduction de la capacité des nœuds de calcul peut être lente si vous activez l'abandon progressif.
- La simultanéité des jobs est affectée par la propriété de cluster
dataproc:agent.process.threads.job.max. Par exemple, avec trois maîtres et cette propriété définie sur la valeur par défaut100, la simultanéité maximale des jobs au niveau du cluster est de300.
Groupe de nœuds pilotes par rapport au mode de cluster Spark
| Fonctionnalité | Mode de cluster Spark | Groupe de nœuds pilotes |
|---|---|---|
| Scaling à la baisse des nœuds de calcul | Les pilotes de longue durée s'exécutent sur les mêmes nœuds de calcul que les conteneurs de courte durée, ce qui ralentit la réduction de la capacité des nœuds de calcul à l'aide de la mise hors service progressive. | Les nœuds de calcul sont réduits plus rapidement lorsque les pilotes s'exécutent sur des groupes de nœuds. |
| Sortie du pilote diffusée en streaming | Nécessite une recherche dans les journaux YARN pour trouver le nœud sur lequel le pilote a été planifié. | Le résultat du pilote est diffusé vers Cloud Storage et peut être consulté dans la console Cloud de Confiance et dans le résultat de la commande gcloud dataproc jobs wait une fois le job terminé. |
Autorisations IAM du groupe de nœuds du pilote
Les autorisations IAM suivantes sont associées aux actions liées au groupe de nœuds Managed Service pour Apache Spark.
| Autorisation | Action |
|---|---|
dataproc.nodeGroups.create
|
Créer des groupes de nœuds Managed Service pour Apache Spark Si un utilisateur dispose du rôle dataproc.clusters.create dans le projet, cette autorisation lui est accordée. |
dataproc.nodeGroups.get |
Obtenez les détails d'un groupe de nœuds Managed Service pour Apache Spark. |
dataproc.nodeGroups.update |
Redimensionnez un groupe de nœuds Managed Service pour Apache Spark. |
Opérations sur les groupes de nœuds de pilote
Vous pouvez utiliser la gcloud CLI et l'API Managed Service pour Apache Spark pour créer, obtenir, redimensionner, supprimer et envoyer un job à un groupe de nœuds pilotes Managed Service pour Apache Spark.
Créer un cluster de groupes de nœuds pilotes
Un groupe de nœuds de pilote est associé à un cluster Managed Service pour Apache Spark. Vous créez un groupe de nœuds lors de la création d'un cluster Managed Service pour Apache Spark. Vous pouvez utiliser la gcloud CLI ou l'API REST Managed Service pour Apache Spark afin de créer un cluster Managed Service pour Apache Spark avec un groupe de nœuds pilotes.
gcloud
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --driver-pool-size=SIZE \
    --driver-pool-id=NODE_GROUP_ID
Options obligatoires :
- CLUSTER_NAME : nom du cluster, qui doit être unique dans un projet. Le nom doit commencer par une lettre minuscule et peut contenir jusqu'à 51 lettres minuscules, chiffres et traits d'union. Il ne peut pas se terminer par un trait d'union. Le nom d'un cluster supprimé peut être réutilisé.
- REGION : région dans laquelle le cluster sera situé.
- SIZE : nombre de nœuds pilotes dans le groupe de nœuds. Le nombre de nœuds requis dépend de la charge du job et du type de machine du pool de pilotes. Le nombre minimal de nœuds du groupe de pilotes est égal à la mémoire totale ou aux processeurs virtuels requis par les pilotes de job, divisé par la mémoire ou les processeurs virtuels de la machine de chaque pool de pilotes.
- NODE_GROUP_ID : facultatif et recommandé. L'ID doit être unique au sein du cluster. Utilisez cet ID pour identifier le groupe de pilotes lors d'opérations ultérieures, telles que le redimensionnement du groupe de nœuds. Si vous ne spécifiez pas d'ID, Managed Service pour Apache Spark génère l'ID du groupe de nœuds.
Option recommandée :
--enable-component-gateway: ajoutez cette option pour activer la passerelle des composants Managed Service pour Apache Spark, qui permet d'accéder à l'interface Web YARN. Les pages "Application" et "Scheduler" de l'UI YARN affichent l'état du cluster et des jobs, la mémoire de la file d'attente des applications, la capacité des cœurs et d'autres métriques.
Options supplémentaires : les options driver-pool facultatives suivantes peuvent être ajoutées à la commande gcloud dataproc clusters create pour personnaliser le groupe de nœuds.
| Option | Valeur par défaut |
|---|---|
--driver-pool-id |
Identifiant de chaîne, généré par le service s'il n'est pas défini par l'option. Cet ID peut être utilisé pour identifier le groupe de nœuds lors de futures opérations sur le pool de nœuds, telles que le redimensionnement du groupe de nœuds. |
--driver-pool-machine-type |
n1-standard-4 |
--driver-pool-accelerator |
Aucune valeur par défaut Lorsque vous spécifiez un accélérateur, le type de GPU est obligatoire, mais le nombre de GPU est facultatif. |
--num-driver-pool-local-ssds |
Aucune valeur par défaut |
--driver-pool-local-ssd-interface |
Aucune valeur par défaut |
--driver-pool-boot-disk-type |
pd-standard |
--driver-pool-boot-disk-size |
1000 GB |
--driver-pool-min-cpu-platform |
AUTOMATIC |
REST
Remplissez un AuxiliaryNodeGroup dans le cadre d'une requête API Managed Service pour Apache Spark cluster.create.
Avant d'utiliser les données de requête, effectuez les remplacements suivants :
- PROJECT_ID : valeur obligatoire. ID du projet Google Cloud.
- REGION : valeur obligatoire. Région du cluster Dataproc.
- CLUSTER_NAME : valeur obligatoire. Nom du cluster, qui doit être unique au sein d'un projet. Le nom doit commencer par une lettre minuscule et peut contenir jusqu'à 51 lettres minuscules, chiffres et traits d'union. Il ne peut pas se terminer par un trait d'union. Le nom d'un cluster supprimé peut être réutilisé.
- SIZE : valeur obligatoire. Nombre de nœuds dans le groupe de nœuds.
- NODE_GROUP_ID : facultatif et recommandé. L'ID doit être unique dans le cluster. Utilisez cet ID pour identifier le groupe de pilotes lors d'opérations ultérieures, telles que le redimensionnement du groupe de nœuds. S'il n'est pas spécifié, Managed Service pour Apache Spark génère l'ID du groupe de nœuds.
Options supplémentaires : consultez NodeGroup.
Méthode HTTP et URL :
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters
Corps JSON de la requête :
{
  "clusterName":"CLUSTER_NAME",
  "config": {
    "softwareConfig": {
      "imageVersion":""
    },
    "endpointConfig": {
      "enableHttpPortAccess": true
    },
    "auxiliaryNodeGroups": [{
        "nodeGroup":{
            "roles":["DRIVER"],
            "nodeGroupConfig": {
                "numInstances": SIZE
             }
         },
        "nodeGroupId": "NODE_GROUP_ID"
    }]
  }
}
Pour envoyer votre requête, développez l'une des options suivantes :
Vous devriez recevoir une réponse JSON de ce type :
{
  "projectId": "PROJECT_ID",
  "clusterName": "CLUSTER_NAME",
  "config": {
    ...
    "auxiliaryNodeGroups": [
      {
        "nodeGroup": {
"name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
          "roles": [
            "DRIVER"
          ],
          "nodeGroupConfig": {
            "numInstances": SIZE,
            "instanceNames": [
              "CLUSTER_NAME-np-q1gp",
              "CLUSTER_NAME-np-xfc0"
            ],
            "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
            "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
            "diskConfig": {
              "bootDiskSizeGb": 1000,
              "bootDiskType": "pd-standard"
            },
            "managedGroupConfig": {
              "instanceTemplateName": "dataproc-2a8224d2-...",
              "instanceGroupManagerName": "dataproc-2a8224d2-..."
            },
            "minCpuPlatform": "AUTOMATIC",
            "preemptibility": "NON_PREEMPTIBLE"
          }
        },
        "nodeGroupId": "NODE_GROUP_ID"
      }
    ]
  },
}
Obtenir les métadonnées du cluster du groupe de nœuds pilote
Vous pouvez utiliser la commande gcloud dataproc node-groups describe ou l'API Managed Service pour Apache Spark pour obtenir les métadonnées du groupe de nœuds du pilote.
gcloud
gcloud dataproc node-groups describe NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION
Options obligatoires :
- NODE_GROUP_ID : vous pouvez exécuter
gcloud dataproc clusters
describe CLUSTER_NAME
pour lister l'ID du groupe de nœuds. - CLUSTER_NAME : nom du cluster.
- REGION : région du cluster.
REST
Avant d'utiliser les données de requête, effectuez les remplacements suivants :
- PROJECT_ID : valeur obligatoire. ID du projet Google Cloud.
- REGION : valeur obligatoire. Région du cluster.
- CLUSTER_NAME : valeur obligatoire. Nom du cluster.
- NODE_GROUP_ID : valeur obligatoire. Vous pouvez exécuter
gcloud dataproc clusters describe CLUSTER_NAMEpour lister l'ID du groupe de nœuds.
Méthode HTTP et URL :
GET https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAMEnodeGroups/Node_GROUP_ID
Pour envoyer votre requête, développez l'une des options suivantes :
Vous devriez recevoir une réponse JSON de ce type :
{
  "name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
  "roles": [
    "DRIVER"
  ],
  "nodeGroupConfig": {
    "numInstances": 5,
    "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
    "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
    "diskConfig": {
      "bootDiskSizeGb": 1000,
      "bootDiskType": "pd-standard"
    },
    "managedGroupConfig": {
      "instanceTemplateName": "dataproc-driver-pool-mcia3j656h2fy",
      "instanceGroupManagerName": "dataproc-driver-pool-mcia3j656h2fy"
    },
    "minCpuPlatform": "AUTOMATIC",
    "preemptibility": "NON_PREEMPTIBLE"
  }
}
Redimensionner un groupe de nœuds de pilote
Vous pouvez utiliser la commande gcloud dataproc node-groups resize ou l'API Managed Service pour Apache Spark pour ajouter ou supprimer des nœuds pilotes d'un groupe de nœuds pilotes de cluster.
gcloud
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=SIZE
Options obligatoires :
- NODE_GROUP_ID : vous pouvez exécuter
gcloud dataproc clusters
describe CLUSTER_NAME
pour lister l'ID du groupe de nœuds. - CLUSTER_NAME : nom du cluster.
- REGION : région du cluster.
- SIZE : spécifiez le nouveau nombre de nœuds pilotes dans le groupe de nœuds.
Option facultative :
--graceful-decommission-timeout=TIMEOUT_DURATION: lorsque vous réduisez la capacité d'un groupe de nœuds, vous pouvez ajouter cette option pour spécifier une mise hors service concertée TIMEOUT_DURATION afin d'éviter l'arrêt immédiat des pilotes de job. Recommandation : Définissez un délai avant expiration au moins égal à la durée du job le plus long exécuté sur le groupe de nœuds (la récupération des pilotes défaillants n'est pas possible).
Exemple : commande de scaling à la hausse de gcloud CLI NodeGroup :
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=4
Exemple : Commande de scaling à la baisse NodeGroup de la gcloud CLI :
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=1 \
    --graceful-decommission-timeout="100s"
REST
Avant d'utiliser les données de requête, effectuez les remplacements suivants :
- PROJECT_ID : valeur obligatoire. ID du projet Google Cloud.
- REGION : valeur obligatoire. Région du cluster.
- NODE_GROUP_ID : valeur obligatoire. Vous pouvez exécuter
gcloud dataproc
    clusters describe CLUSTER_NAME
pour lister l'ID du groupe de nœuds. - SIZE : valeur obligatoire. Nouveau nombre de nœuds dans le groupe de nœuds.
- TIMEOUT_DURATION : facultatif. Lorsque vous réduisez la capacité d'un groupe de nœuds, vous pouvez ajouter un
gracefulDecommissionTimeoutau corps de la requête pour éviter l'arrêt immédiat des pilotes de job. Recommandation : Définissez un délai avant expiration au moins égal à la durée du job le plus long exécuté sur le groupe de nœuds (la récupération des pilotes défaillants n'est pas possible).Exemple :
{ "size": SIZE,
  "gracefulDecommissionTimeout": "TIMEOUT_DURATION"
}
Méthode HTTP et URL :
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/Node_GROUP_ID:resize
Corps JSON de la requête :
{
  "size": SIZE,
}
Pour envoyer votre requête, développez l'une des options suivantes :
Vous devriez recevoir une réponse JSON de ce type :
{
  "name": "projects/PROJECT_ID/regions/REGION/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.dataproc.v1.NodeGroupOperationMetadata",
    "nodeGroupId": "NODE_GROUP_ID",
    "clusterUuid": "CLUSTER_UUID",
    "status": {
      "state": "PENDING",
      "innerState": "PENDING",
      "stateStartTime": "2022-12-01T23:34:53.064308Z"
    },
    "operationType": "RESIZE",
    "description": "Scale "up or "down" a GCE node pool to SIZE nodes."
  }
}
Supprimer un cluster de groupe de nœuds pilotes
Lorsque vous supprimez un cluster Managed Service pour Apache Spark, les groupes de nœuds associés au cluster sont supprimés.
Envoyer une tâche
Vous pouvez utiliser la commande gcloud dataproc jobs submit ou l'API Managed Service pour Apache Spark pour envoyer un job à un cluster avec un groupe de nœuds pilotes.
gcloud
gcloud dataproc jobs submit JOB_COMMAND \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=DRIVER_MEMORY \
    --driver-required-vcores=DRIVER_VCORES \
    DATAPROC_FLAGS \
    -- JOB_ARGS
Options obligatoires :
- JOB_COMMAND : spécifiez la commande de job.
- CLUSTER_NAME : nom du cluster.
- DRIVER_MEMORY : quantité de mémoire des pilotes de job en Mo nécessaire pour exécuter un job (voir Contrôles de mémoire Yarn).
- DRIVER_VCORES : nombre de processeurs virtuels nécessaires pour exécuter un job.
Options supplémentaires :
- DATAPROC_FLAGS : ajoutez des options gcloud dataproc jobs submit supplémentaires liées au type de mission.
- JOB_ARGS : ajoutez les arguments (après
--) à transmettre au job.
Exemples : Vous pouvez exécuter les exemples suivants à partir d'une session de terminal SSH sur un cluster de groupe de nœuds pilotes Managed Service pour Apache Spark.
Job Spark pour estimer la valeur de
pi:gcloud dataproc jobs submit spark \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ --class=org.apache.spark.examples.SparkPi \ --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \ -- 1000
Job Spark wordcount :
gcloud dataproc jobs submit spark \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --class=org.apache.spark.examples.JavaWordCount \
    --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \
    -- 'gs://apache-beam-samples/shakespeare/macbeth.txt'
Job PySpark pour estimer la valeur de
pi:gcloud dataproc jobs submit pyspark \ file:///usr/lib/spark/examples/src/main/python/pi.py \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ -- 1000
Job MapReduce Hadoop TeraGen :
gcloud dataproc jobs submit hadoop \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --jar file:///usr/lib/hadoop-mapreduce/hadoop-mapreduce-examples.jar \
    -- teragen 1000 \
    hdfs:///gen1/test
REST
Avant d'utiliser les données de requête, effectuez les remplacements suivants :
- PROJECT_ID : valeur obligatoire. ID du projet Google Cloud.
- REGION : valeur obligatoire. Région du cluster Dataproc
- CLUSTER_NAME : valeur obligatoire. Nom du cluster, qui doit être unique au sein d'un projet. Le nom doit commencer par une lettre minuscule et peut contenir jusqu'à 51 lettres minuscules, chiffres et traits d'union. Il ne peut pas se terminer par un trait d'union. Le nom d'un cluster supprimé peut être réutilisé.
- DRIVER_MEMORY : valeur obligatoire. Quantité de mémoire des pilotes de job en Mo nécessaire pour exécuter un job (voir Contrôles de mémoire Yarn).
- DRIVER_VCORES : valeur obligatoire. Nombre de processeurs virtuels nécessaires pour exécuter un job.
pi).
Méthode HTTP et URL :
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/jobs:submit
Corps JSON de la requête :
{
  "job": {
    "placement": {
    "clusterName": "CLUSTER_NAME",
    },
    "driverSchedulingConfig": {
      "memoryMb]": DRIVER_MEMORY,
      "vcores": DRIVER_VCORES
    },
    "sparkJob": {
      "jarFileUris": "file:///usr/lib/spark/examples/jars/spark-examples.jar",
      "args": [
        "10000"
      ],
      "mainClass": "org.apache.spark.examples.SparkPi"
    }
  }
}
Pour envoyer votre requête, développez l'une des options suivantes :
Vous devriez recevoir une réponse JSON de ce type :
{
  "reference": {
    "projectId": "PROJECT_ID",
    "jobId": "job-id"
  },
  "placement": {
    "clusterName": "CLUSTER_NAME",
    "clusterUuid": "cluster-Uuid"
  },
  "sparkJob": {
    "mainClass": "org.apache.spark.examples.SparkPi",
    "args": [
      "1000"
    ],
    "jarFileUris": [
      "file:///usr/lib/spark/examples/jars/spark-examples.jar"
    ]
  },
  "status": {
    "state": "PENDING",
    "stateStartTime": "start-time"
  },
  "jobUuid": "job-Uuid"
}
Python
- Installer la bibliothèque cliente
- Configurer les identifiants par défaut de l'application
- Exécutez le code.
- Job Spark pour estimer la valeur de pi :
- Job PySpark pour afficher "hello world" :
Afficher les journaux de jobs
Pour afficher l'état d'un job et faciliter le débogage des problèmes liés à un job, vous pouvez afficher les journaux du pilote à l'aide de gcloud CLI ou de la console Cloud de Confiance .
gcloud
Les journaux du pilote de job sont diffusés vers la sortie de la gcloud CLI ou de la consoleCloud de Confiance pendant l'exécution du job. Les journaux du pilote sont conservés dans le bucket de préproduction du cluster Managed Service pour Apache Spark dans Cloud Storage.
Exécutez la commande gcloud CLI suivante pour lister l'emplacement des journaux de pilote dans Cloud Storage :
gcloud dataproc jobs describe JOB_ID \
    --region=REGION
L'emplacement Cloud Storage des journaux du pilote est indiqué sous la forme driverOutputResourceUri dans le résultat de la commande, au format suivant :
driverOutputResourceUri: gs://CLUSTER_STAGING_BUCKET/google-cloud-dataproc-metainfo/CLUSTER_UUID/jobs/JOB_ID
Console
Pour afficher les journaux du cluster de groupes de nœuds :
Vous pouvez utiliser le format de requête de l'explorateur de journaux suivant pour rechercher des journaux :
resource.type="cloud_dataproc_cluster"
resource.labels.project_id="PROJECT_ID"
resource.labels.cluster_name="CLUSTER_NAME"
log_name="projects/PROJECT_ID/logs/LOG_TYPE>"
- PROJECT_ID : ID du projet Cloud de Confiance .
- CLUSTER_NAME : nom du cluster.
- LOG_TYPE :
- Journaux utilisateur Yarn :
yarn-userlogs - Journaux du gestionnaire de ressources Yarn :
hadoop-yarn-resourcemanager - Journaux du gestionnaire de nœuds Yarn :
hadoop-yarn-nodemanager
- Journaux utilisateur Yarn :
Surveiller les métriques
Les pilotes de job du groupe de nœuds Managed Service pour Apache Spark s'exécutent dans une file d'attente enfant dataproc-driverpool-driver-queue sous une partition dataproc-driverpool.
Métriques du groupe de nœuds pilotes
Le tableau suivant liste les métriques de pilote de groupe de nœuds associées, qui sont collectées par défaut pour les groupes de nœuds pilotes.
| Métrique du groupe de nœuds pilotes | Description |
|---|---|
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMB |
Quantité de mémoire disponible en mébioctets dans dataproc-driverpool-driver-queue sous la partition dataproc-driverpool.
|
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainers |
Nombre de conteneurs en attente (dans la file d'attente) dans dataproc-driverpool-driver-queue sous la partition dataproc-driverpool. |
Métriques de file d'attente enfant
Le tableau suivant liste les métriques de file d'attente enfant. Les métriques sont collectées par défaut pour les groupes de nœuds de pilote et peuvent être activées pour la collecte sur n'importe quel cluster Managed Service pour Apache Spark.
| Métrique de file d'attente enfant | Description |
|---|---|
yarn:ResourceManager:ChildQueueMetrics:AvailableMB |
Quantité de mémoire disponible en mébioctets dans cette file d'attente sous la partition par défaut. |
yarn:ResourceManager:ChildQueueMetrics:PendingContainers |
Nombre de conteneurs en attente (dans la file d'attente) dans cette file d'attente sous la partition par défaut. |
yarn:ResourceManager:ChildQueueMetrics:running_0 |
Nombre de jobs dont l'environnement d'exécution est compris entre 0 et 60 minutes dans cette file d'attente pour toutes les partitions. |
yarn:ResourceManager:ChildQueueMetrics:running_60 |
Nombre de jobs dont l'environnement d'exécution est compris entre 60 et 300 minutes dans cette file d'attente pour toutes les partitions. |
yarn:ResourceManager:ChildQueueMetrics:running_300 |
Nombre de jobs dont l'environnement d'exécution est compris entre 300 et 1440 minutes dans cette file d'attente pour toutes les partitions. |
yarn:ResourceManager:ChildQueueMetrics:running_1440 |
Nombre de jobs dont l'environnement d'exécution est supérieur à 1440 minutes dans cette file d'attente pour toutes les partitions. |
yarn:ResourceManager:ChildQueueMetrics:AppsSubmitted |
Nombre d'applications envoyées à cette file d'attente sous toutes les partitions. |
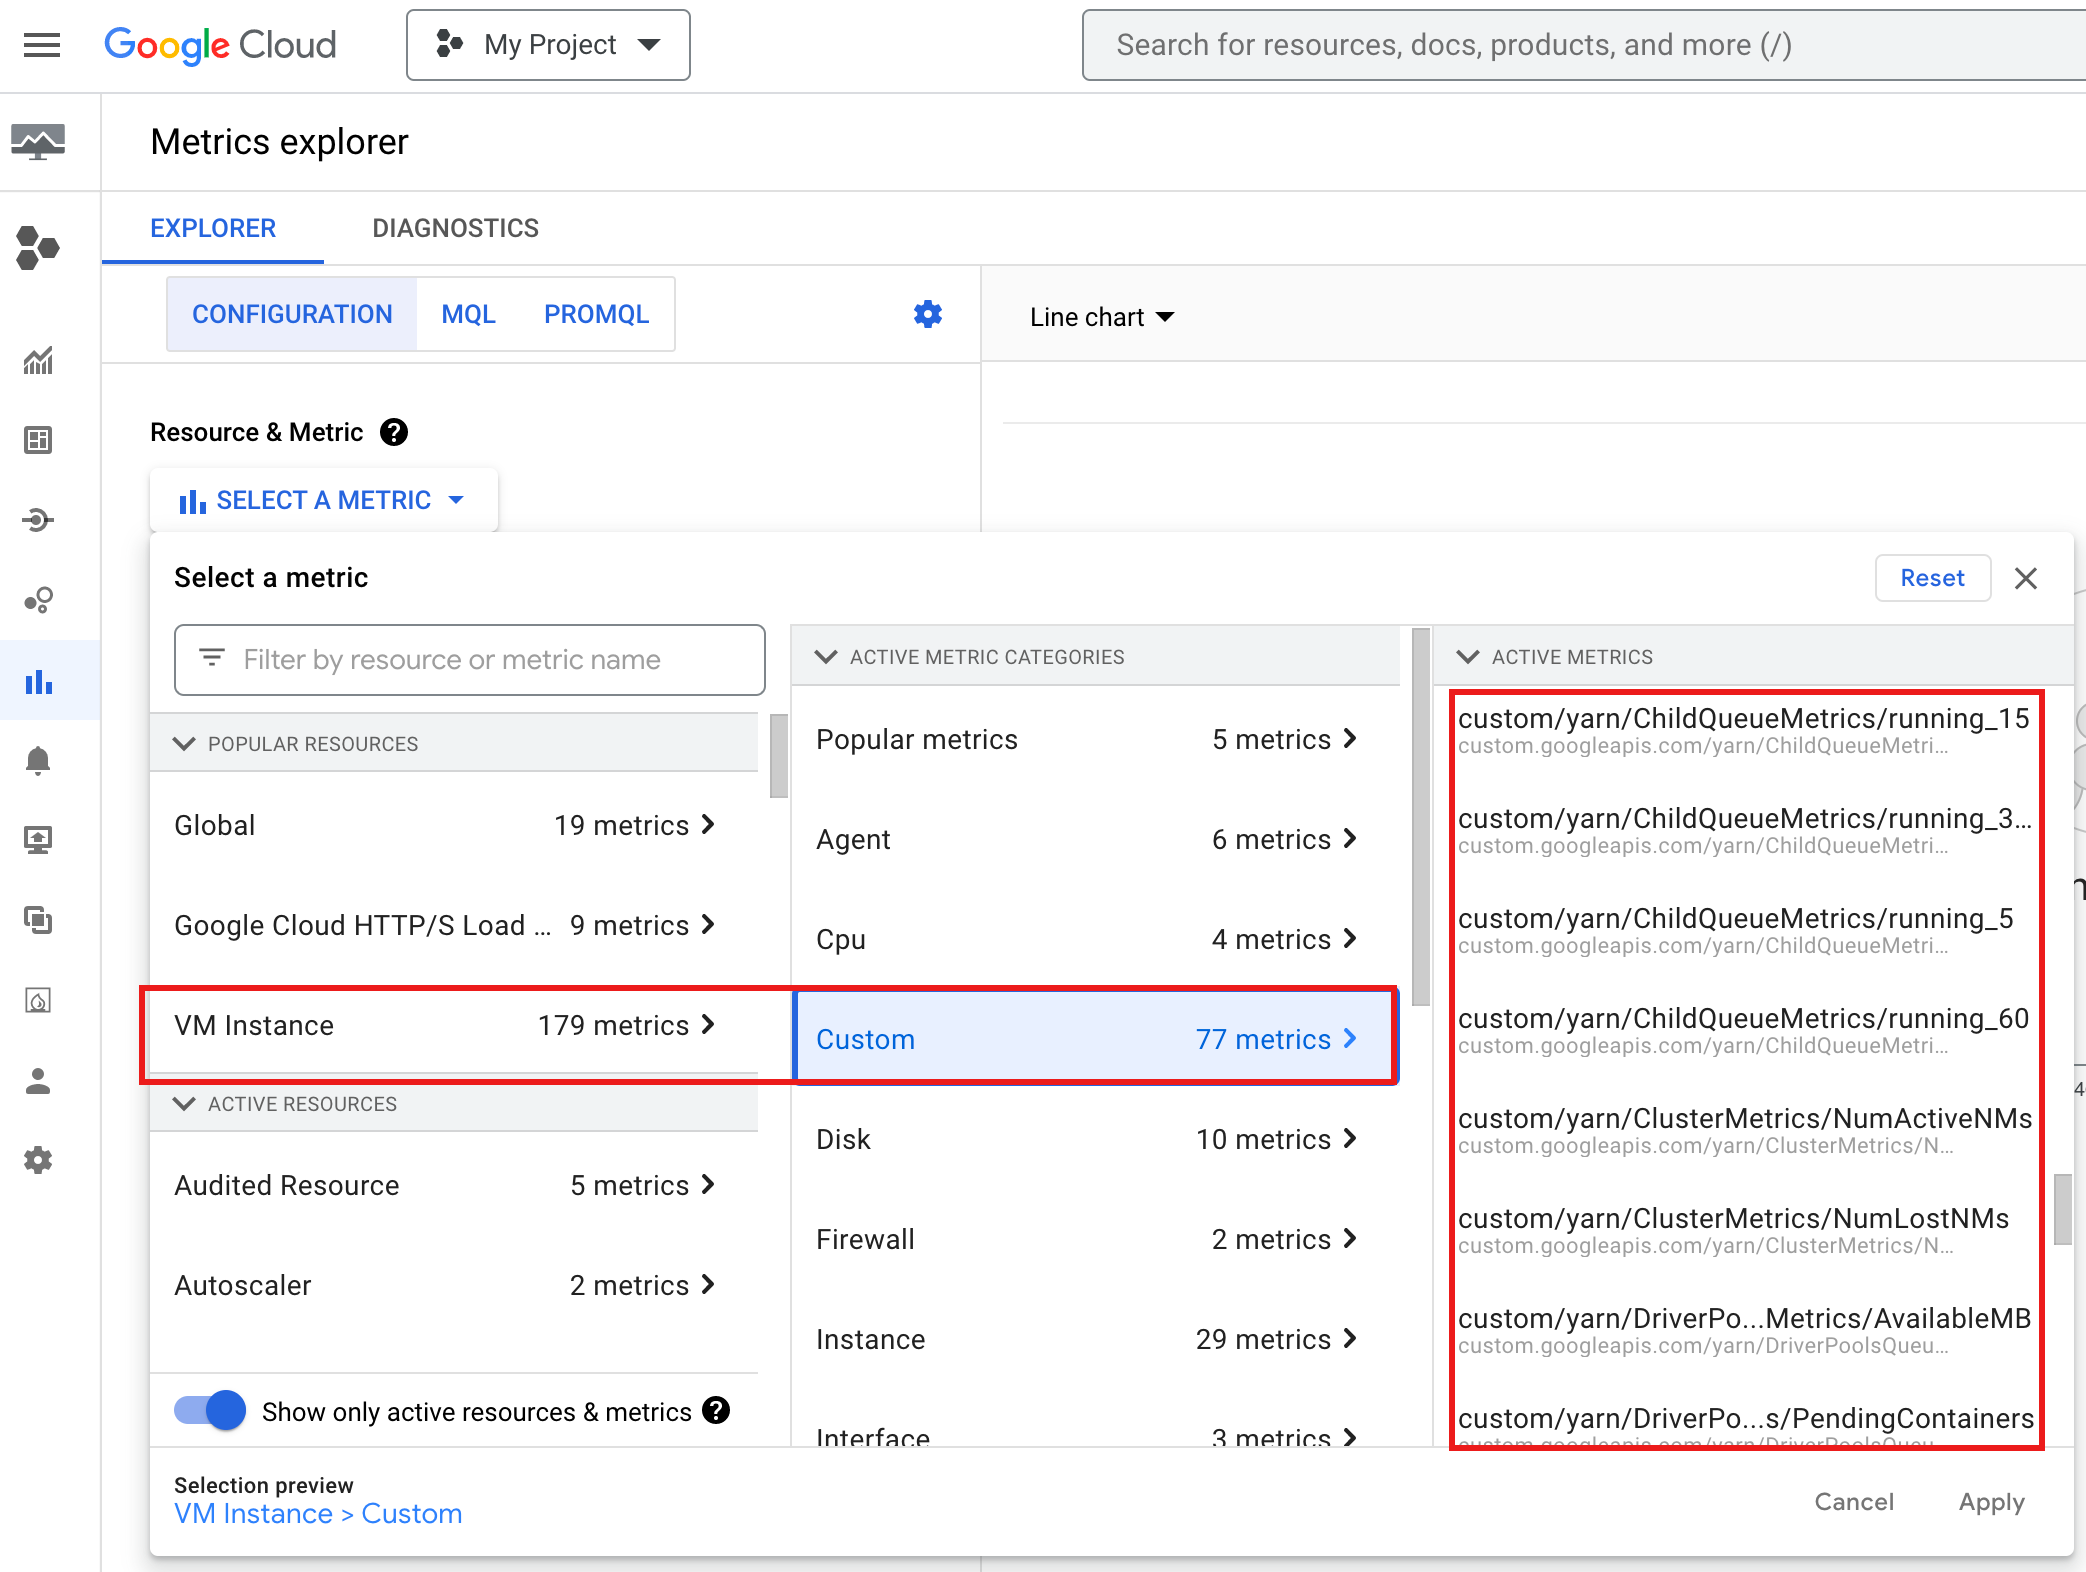
Pour afficher YARN ChildQueueMetrics et DriverPoolsQueueMetrics dans la consoleCloud de Confiance :
Sélectionnez les ressources Instance de VM → Personnalisé dans l'Explorateur de métriques.
Pilote de job de groupe de nœuds de débogage
Cette section fournit les conditions et les erreurs du groupe de nœuds pilotes, ainsi que des recommandations pour corriger la condition ou l'erreur.
Conditions
Condition :
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMBapproche de0. Cela indique que la file d'attente des pools de pilotes de cluster manque de mémoire.Recommandation : augmentez la taille du pool de pilotes.
Condition :
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainersest supérieur à 0. Cela peut indiquer que la file d'attente des pools de pilotes de cluster manque de mémoire et que YARN met les jobs en file d'attente.Recommandation : augmentez la taille du pool de pilotes.
Erreurs
Erreur :
Cluster <var>CLUSTER_NAME</var> requires driver scheduling config to run
SPARK job because it contains a node pool with role DRIVER.
Positive values are required for all driver scheduling config values.
Recommandation : Définissez
driver-required-memory-mbetdriver-required-vcoresavec des nombres positifs.Erreur :
Container exited with a non-zero exit code 137.Recommandation : Augmentez
driver-required-memory-mbpour l'utilisation de la mémoire du job.