

Um recurso NodeGroup do Serviço Gerenciado para Apache Spark é um grupo de nós de cluster do Serviço Gerenciado para Apache Spark que executam um papel atribuído. Nesta página, descrevemos o
grupo de nós de driver, que é um grupo de VMs do Compute Engine que recebem
o papel Driver para executar drivers de jobs no
cluster do Managed Service for Apache Spark.
Quando usar grupos de nós do driver
- Use grupos de nós de driver somente quando precisar executar muitos jobs simultâneos em um cluster compartilhado.
- Aumente os recursos do nó mestre antes de usar grupos de nós do driver para evitar limitações de grupos de nós do driver.
Como os nós de driver ajudam a executar jobs simultâneos
O Serviço Gerenciado para Apache Spark inicia um processo de driver de job em um nó mestre do cluster do Serviço Gerenciado para Apache Spark para cada job. O processo do driver, por sua vez,
executa um driver de aplicativo, como spark-submit, como o processo filho.
No entanto, o número de jobs simultâneos em execução no mestre é limitado pelos
recursos disponíveis no nó mestre. Como os nós mestre do Serviço Gerenciado para Apache Spark
não podem ser escalonados, um job pode falhar ou ser limitado quando os recursos do nó mestre
são insuficientes para executá-lo.
Os grupos de nós do driver são grupos de nós especiais gerenciados pelo YARN, portanto, a simultaneidade de jobs não é limitada pelos recursos do nó mestre. Em clusters com um grupo de nós do driver, os drivers de aplicativos são executados em nós do driver. Cada nó do driver pode executar vários drivers de aplicativo se o nó tiver recursos suficientes.
Vantagens
Usar um cluster do Serviço Gerenciado para Apache Spark com um grupo de nós do driver permite:
- Escalonar horizontalmente os recursos do driver de jobs para executar mais jobs simultâneos
- Escalonar recursos de driver separadamente dos recursos de worker
- Reduza a escala vertical mais rapidamente em clusters de imagem do Serviço Gerenciado para Apache Spark 2.0+ e versões mais recentes. Nesses clusters, o mestre do app é executado em um driver do Spark em um
grupo de nós do driver (o
spark.yarn.unmanagedAM.enabledé definido comotruepor padrão). - Personalizar a inicialização do nó do driver. É possível adicionar
{ROLE} == 'Driver'em um script de inicialização para que o script execute ações para um grupo de nós do driver na seleção de nós.
Limitações
- Os grupos de nós não são compatíveis com os modelos de fluxo de trabalho do Serviço Gerenciado para Apache Spark.
- Não é possível interromper, reiniciar ou escalonar automaticamente os clusters de grupos de nós.
- O mestre do app MapReduce é executado em nós de trabalho. A reduzir escala vertical dos nós de trabalho pode ser lenta se você ativar a desativação otimizada.
- A simultaneidade de jobs é afetada pela propriedade de cluster
dataproc:agent.process.threads.job.max. Por exemplo, com três mestres e essa propriedade definida como o valor padrão de100, a simultaneidade máxima de jobs no nível do cluster é300.
Grupo de nós do driver em comparação com o modo de cluster do Spark
| Recurso | Modo de cluster do Spark | Grupo de nós do driver |
|---|---|---|
| Reduzir escala vertical vertical do nó de trabalho | Os drivers de longa duração são executados nos mesmos nós de trabalho que os contêineres de curta duração, o que torna lenta a reduzir escala vertical de workers usando a desativação otimizada. | Os nós de trabalho reduzir escala vertical mais rapidamente quando os drivers são executados em grupos de nós. |
| Saída do driver transmitida | Requer pesquisa nos registros do YARN para encontrar o nó em que o driver foi programado. | A saída do driver é transmitida para o Cloud Storage e pode ser visualizada
no console do Cloud de Confiance e na saída do comando gcloud dataproc jobs wait
depois que um job é concluído. |
Permissões do IAM do grupo de nós do driver
As permissões do IAM a seguir estão associadas às ações relacionadas ao grupo de nós do Serviço Gerenciado para Apache Spark.
| Permissão | Ação |
|---|---|
dataproc.nodeGroups.create
|
Criar grupos de nós do Serviço Gerenciado para Apache Spark. Se um usuário tiver
dataproc.clusters.create no projeto, essa permissão será
concedida. |
dataproc.nodeGroups.get |
Receba os detalhes de um grupo de nós do Serviço Gerenciado para Apache Spark. |
dataproc.nodeGroups.update |
Redimensionar um grupo de nós do Serviço Gerenciado para Apache Spark. |
Operações do grupo de nós do driver
Use a CLI gcloud e a API Serviço Gerenciado para Apache Spark para criar, receber, redimensionar, excluir e enviar um job para um grupo de nós do driver do Serviço Gerenciado para Apache Spark.
Criar um cluster de grupo de nós do driver
Um grupo de nós de driver está associado a um cluster do Managed Service para Apache Spark. Você cria um grupo de nós como parte da criação de um cluster do Serviço Gerenciado para Apache Spark. Use a CLI gcloud ou a API REST do Serviço Gerenciado para Apache Spark para criar um cluster do Serviço Gerenciado para Apache Spark com um grupo de nós do driver.
gcloud
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --driver-pool-size=SIZE \
    --driver-pool-id=NODE_GROUP_ID
Flags obrigatórias:
- CLUSTER_NAME: o nome do cluster, que precisa ser exclusivo em um projeto. O nome precisa começar com uma letra minúscula e pode conter até 51 letras minúsculas, números e hifens. Não pode terminar com um hífen. O nome de um cluster excluído pode ser reutilizado.
- REGION: a região em que o cluster será localizado.
- SIZE: o número de nós do driver no grupo de nós. O número de nós necessários depende da carga do job e do tipo de máquina do pool de drivers. O número mínimo de nós do grupo de drivers é igual à memória total ou às vCPUs exigidas pelos drivers de jobs divididas pela memória ou pelas vCPUs da máquina de cada pool de drivers.
- NODE_GROUP_ID: opcional e recomendado. O ID precisa ser exclusivo no cluster. Use esse ID para identificar o grupo de drivers em operações futuras, como o redimensionamento do grupo de nós. Se não for especificado, o Serviço Gerenciado para Apache Spark vai gerar o ID do grupo de nós.
Sinalização recomendada:
--enable-component-gateway: adicione essa flag para ativar o gateway de componentes do Serviço Gerenciado para Apache Spark, que fornece acesso à interface da Web do YARN. As páginas "Aplicativo" e "Programador" da interface do YARN mostram o status do cluster e do job, a memória da fila de aplicativos, a capacidade do núcleo e outras métricas.
Sinalizações adicionais: as seguintes sinalizações opcionais de driver-pool podem ser adicionadas
ao comando gcloud dataproc clusters create para personalizar o grupo de nós.
| Flag | Valor padrão |
|---|---|
--driver-pool-id |
Um identificador de string, gerado pelo serviço se não for definido pela flag. Esse ID pode ser usado para identificar o grupo de nós ao realizar operações futuras no pool de nós, como redimensionar o grupo de nós. |
--driver-pool-machine-type |
n1-standard-4 |
--driver-pool-accelerator |
Sem padrão. Ao especificar um acelerador, o tipo de GPU é obrigatório, mas o número de GPUs é opcional. |
--num-driver-pool-local-ssds |
Sem padrão |
--driver-pool-local-ssd-interface |
Sem padrão |
--driver-pool-boot-disk-type |
pd-standard |
--driver-pool-boot-disk-size |
1000 GB |
--driver-pool-min-cpu-platform |
AUTOMATIC |
REST
Preencha um
AuxiliaryNodeGroup
como parte de uma solicitação de API
cluster.create
do Serviço Gerenciado para Apache Spark.
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: obrigatório. ID do projeto do Google Cloud.
- REGION: obrigatório. Região do cluster do Dataproc.
- CLUSTER_NAME: obrigatório. O nome do cluster, que precisa ser exclusivo em um projeto. O nome precisa começar com uma letra minúscula e pode conter até 51 letras minúsculas, números e hifens. Ele não pode terminar com um hífen. O nome de um cluster excluído pode ser reutilizado.
- SIZE: obrigatório. Número de nós no grupo.
- NODE_GROUP_ID: opcional e recomendado. O ID precisa ser exclusivo no cluster. Use esse ID para identificar o grupo de drivers em operações futuras, como o redimensionamento do grupo de nós. Se não for especificado, o Serviço Gerenciado para Apache Spark vai gerar o ID do grupo de nós.
Outras opções: consulte NodeGroup.
Método HTTP e URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters
Corpo JSON da solicitação:
{
  "clusterName":"CLUSTER_NAME",
  "config": {
    "softwareConfig": {
      "imageVersion":""
    },
    "endpointConfig": {
      "enableHttpPortAccess": true
    },
    "auxiliaryNodeGroups": [{
        "nodeGroup":{
            "roles":["DRIVER"],
            "nodeGroupConfig": {
                "numInstances": SIZE
             }
         },
        "nodeGroupId": "NODE_GROUP_ID"
    }]
  }
}
Para enviar a solicitação, expanda uma destas opções:
Você receberá uma resposta JSON semelhante a esta:
{
  "projectId": "PROJECT_ID",
  "clusterName": "CLUSTER_NAME",
  "config": {
    ...
    "auxiliaryNodeGroups": [
      {
        "nodeGroup": {
"name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
          "roles": [
            "DRIVER"
          ],
          "nodeGroupConfig": {
            "numInstances": SIZE,
            "instanceNames": [
              "CLUSTER_NAME-np-q1gp",
              "CLUSTER_NAME-np-xfc0"
            ],
            "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
            "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
            "diskConfig": {
              "bootDiskSizeGb": 1000,
              "bootDiskType": "pd-standard"
            },
            "managedGroupConfig": {
              "instanceTemplateName": "dataproc-2a8224d2-...",
              "instanceGroupManagerName": "dataproc-2a8224d2-..."
            },
            "minCpuPlatform": "AUTOMATIC",
            "preemptibility": "NON_PREEMPTIBLE"
          }
        },
        "nodeGroupId": "NODE_GROUP_ID"
      }
    ]
  },
}
Receber metadados do cluster do grupo de nós do driver
Use o comando
gcloud dataproc node-groups describe
ou a API do Serviço Gerenciado para Apache Spark para
receber metadados do grupo de nós do driver.
gcloud
gcloud dataproc node-groups describe NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION
Flags obrigatórias:
- NODE_GROUP_ID: execute
gcloud dataproc clusters
describe CLUSTER_NAME
para listar o ID do grupo de nós. - CLUSTER_NAME: o nome do cluster.
- REGION: a região do cluster.
REST
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: obrigatório. ID do projeto do Google Cloud.
- REGION: obrigatório. A região do cluster.
- CLUSTER_NAME: obrigatório. O nome do cluster.
- NODE_GROUP_ID: obrigatório. Execute
gcloud dataproc clusters describe CLUSTER_NAMEpara listar o ID do grupo de nós.
Método HTTP e URL:
GET https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAMEnodeGroups/Node_GROUP_ID
Para enviar a solicitação, expanda uma destas opções:
Você receberá uma resposta JSON semelhante a esta:
{
  "name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
  "roles": [
    "DRIVER"
  ],
  "nodeGroupConfig": {
    "numInstances": 5,
    "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
    "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
    "diskConfig": {
      "bootDiskSizeGb": 1000,
      "bootDiskType": "pd-standard"
    },
    "managedGroupConfig": {
      "instanceTemplateName": "dataproc-driver-pool-mcia3j656h2fy",
      "instanceGroupManagerName": "dataproc-driver-pool-mcia3j656h2fy"
    },
    "minCpuPlatform": "AUTOMATIC",
    "preemptibility": "NON_PREEMPTIBLE"
  }
}
Redimensionar um grupo de nós do driver
Use o comando
gcloud dataproc node-groups resize
ou a API do Serviço Gerenciado para Apache Spark
para adicionar ou remover nós do driver de um grupo de nós do driver de cluster.
gcloud
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=SIZE
Flags obrigatórias:
- NODE_GROUP_ID: execute
gcloud dataproc clusters
describe CLUSTER_NAME
para listar o ID do grupo de nós. - CLUSTER_NAME: o nome do cluster.
- REGION: a região do cluster.
- SIZE: especifique o novo número de nós do driver no grupo de nós.
Sinalização opcional:
--graceful-decommission-timeout=TIMEOUT_DURATION: ao reduzir escala vertical um grupo de nós, é possível adicionar essa flag para especificar uma desativação otimizada TIMEOUT_DURATION para evitar o encerramento imediato dos drivers de jobs. Recomendação: defina uma duração de tempo limite que seja pelo menos igual à duração do job mais longo em execução no grupo de nós (não há suporte para a recuperação de drivers com falha).
Exemplo: comando de escalonar verticalmente da CLI gcloud NodeGroup:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=4
Exemplo: comando de reduzir escala vertical da CLI gcloud NodeGroup:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=1 \
    --graceful-decommission-timeout="100s"
REST
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: obrigatório. ID do projeto do Google Cloud.
- REGION: obrigatório. A região do cluster.
- NODE_GROUP_ID: obrigatório. Execute
gcloud dataproc
    clusters describe CLUSTER_NAME
para listar o ID do grupo de nós. - SIZE: obrigatório. Novo número de nós no grupo de nós.
- TIMEOUT_DURATION: opcional. Ao reduzir escala vertical um grupo de nós,
é possível adicionar um
gracefulDecommissionTimeoutao corpo da solicitação para evitar o encerramento imediato dos drivers de jobs. Recomendação: defina uma duração de tempo limite que seja pelo menos igual à duração do job mais longo em execução no grupo de nós. A recuperação de drivers com falha não é compatível.Exemplo:
{ "size": SIZE,
  "gracefulDecommissionTimeout": "TIMEOUT_DURATION"
}
Método HTTP e URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/Node_GROUP_ID:resize
Corpo JSON da solicitação:
{
  "size": SIZE,
}
Para enviar a solicitação, expanda uma destas opções:
Você receberá uma resposta JSON semelhante a esta:
{
  "name": "projects/PROJECT_ID/regions/REGION/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.dataproc.v1.NodeGroupOperationMetadata",
    "nodeGroupId": "NODE_GROUP_ID",
    "clusterUuid": "CLUSTER_UUID",
    "status": {
      "state": "PENDING",
      "innerState": "PENDING",
      "stateStartTime": "2022-12-01T23:34:53.064308Z"
    },
    "operationType": "RESIZE",
    "description": "Scale "up or "down" a GCE node pool to SIZE nodes."
  }
}
Excluir um cluster de grupo de nós do driver
Quando você exclui um cluster do Serviço Gerenciado para Apache Spark, os grupos de nós associados a ele são excluídos.
Envie um job
Use o comando gcloud dataproc jobs submit
ou a API do Serviço Gerenciado para Apache Spark para
enviar um job a um cluster
com um grupo de nós do driver.
gcloud
gcloud dataproc jobs submit JOB_COMMAND \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=DRIVER_MEMORY \
    --driver-required-vcores=DRIVER_VCORES \
    DATAPROC_FLAGS \
    -- JOB_ARGS
Flags obrigatórias:
- JOB_COMMAND: especifique o comando do job.
- CLUSTER_NAME: o nome do cluster.
- DRIVER_MEMORY: quantidade de memória de drivers de job em MB necessária para executar um job (consulte Controles de memória do Yarn).
- DRIVER_VCORES: o número de vCPUs necessárias para executar um job.
Sinalizações adicionais:
- DATAPROC_FLAGS: adicione outras sinalizações gcloud dataproc jobs submit relacionadas ao tipo de serviço.
- JOB_ARGS: adicione argumentos (depois de
--) para transmitir ao job.
Exemplos: execute os exemplos a seguir em uma sessão de terminal SSH em um cluster de grupo de nós do driver do Serviço Gerenciado para Apache Spark.
Job do Spark para estimar o valor de
pi:gcloud dataproc jobs submit spark \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ --class=org.apache.spark.examples.SparkPi \ --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \ -- 1000
Job de contagem de palavras do Spark:
gcloud dataproc jobs submit spark \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --class=org.apache.spark.examples.JavaWordCount \
    --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \
    -- 'gs://apache-beam-samples/shakespeare/macbeth.txt'
Job do PySpark para estimar o valor de
pi:gcloud dataproc jobs submit pyspark \ file:///usr/lib/spark/examples/src/main/python/pi.py \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ -- 1000
Job MapReduce do Hadoop TeraGen:
gcloud dataproc jobs submit hadoop \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --jar file:///usr/lib/hadoop-mapreduce/hadoop-mapreduce-examples.jar \
    -- teragen 1000 \
    hdfs:///gen1/test
REST
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: obrigatório. ID do projeto do Google Cloud.
- REGION: obrigatório. Região do cluster do Dataproc
- CLUSTER_NAME: obrigatório. O nome do cluster, que precisa ser exclusivo em um projeto. O nome precisa começar com uma letra minúscula e pode conter até 51 letras minúsculas, números e hifens. Ele não pode terminar com um hífen. O nome de um cluster excluído pode ser reutilizado.
- DRIVER_MEMORY: obrigatório. Quantidade de memória de drivers de job em MB necessária para executar um job (consulte Controles de memória do Yarn).
- DRIVER_VCORES: obrigatório. O número de vCPUs necessárias para executar um job.
pi).
Método HTTP e URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/jobs:submit
Corpo JSON da solicitação:
{
  "job": {
    "placement": {
    "clusterName": "CLUSTER_NAME",
    },
    "driverSchedulingConfig": {
      "memoryMb]": DRIVER_MEMORY,
      "vcores": DRIVER_VCORES
    },
    "sparkJob": {
      "jarFileUris": "file:///usr/lib/spark/examples/jars/spark-examples.jar",
      "args": [
        "10000"
      ],
      "mainClass": "org.apache.spark.examples.SparkPi"
    }
  }
}
Para enviar a solicitação, expanda uma destas opções:
Você receberá uma resposta JSON semelhante a esta:
{
  "reference": {
    "projectId": "PROJECT_ID",
    "jobId": "job-id"
  },
  "placement": {
    "clusterName": "CLUSTER_NAME",
    "clusterUuid": "cluster-Uuid"
  },
  "sparkJob": {
    "mainClass": "org.apache.spark.examples.SparkPi",
    "args": [
      "1000"
    ],
    "jarFileUris": [
      "file:///usr/lib/spark/examples/jars/spark-examples.jar"
    ]
  },
  "status": {
    "state": "PENDING",
    "stateStartTime": "start-time"
  },
  "jobUuid": "job-Uuid"
}
Python
- Instalar a biblioteca de cliente
- Configurar as credenciais padrão do aplicativo
- Executar o código
- Job do Spark para estimar o valor de pi:
- Job do PySpark para imprimir "hello world":
Ver registros do job
Para conferir o status do job e ajudar a depurar problemas, use a CLI gcloud ou o console do Cloud de Confiance para acessar os registros do driver.
gcloud
Os registros do driver de job são transmitidos para a saída da CLI gcloud ou para o console doCloud de Confiance durante a execução do job. Os registros do driver persistem no bucket de preparo do cluster do Serviço Gerenciado para Apache Spark no Cloud Storage.
Execute o seguinte comando da CLI gcloud para listar o local dos registros do driver no Cloud Storage:
gcloud dataproc jobs describe JOB_ID \
    --region=REGION
O local do Cloud Storage dos registros do driver é listado como
driverOutputResourceUri na resposta ao comando no seguinte formato:
driverOutputResourceUri: gs://CLUSTER_STAGING_BUCKET/google-cloud-dataproc-metainfo/CLUSTER_UUID/jobs/JOB_ID
Console
Para ver os registros de cluster do grupo de nós:
Use o seguinte formato de consulta da Análise de registros para encontrar registros:
resource.type="cloud_dataproc_cluster"
resource.labels.project_id="PROJECT_ID"
resource.labels.cluster_name="CLUSTER_NAME"
log_name="projects/PROJECT_ID/logs/LOG_TYPE>"
- PROJECT_ID: o ID do projeto do Cloud de Confiance .
- CLUSTER_NAME: o nome do cluster.
- LOG_TYPE:
- Registros de usuário do Yarn:
yarn-userlogs - Registros do gerenciador de recursos do Yarn:
hadoop-yarn-resourcemanager - Registros do gerenciador de nós do Yarn:
hadoop-yarn-nodemanager
- Registros de usuário do Yarn:
Monitorar as métricas
Os drivers de job do grupo de nós do Serviço Gerenciado para Apache Spark são executados em uma
fila filha dataproc-driverpool-driver-queue em uma partição
dataproc-driverpool.
Métricas do grupo de nós do driver
A tabela a seguir lista as métricas associadas ao nó do driver do grupo, que são coletadas por padrão para grupos de nós do driver.
| Métrica do grupo de nós do driver | Descrição |
|---|---|
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMB |
A quantidade de memória disponível em mebibytes em
dataproc-driverpool-driver-queue na partição
dataproc-driverpool.
|
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainers |
O número de contêineres pendentes (na fila) em
dataproc-driverpool-driver-queue na partição
dataproc-driverpool. |
Métricas da fila filha
A tabela a seguir lista as métricas de fila filha. As métricas são coletadas por padrão para grupos de nós do driver e podem ser ativadas para coleta em qualquer cluster do Serviço Gerenciado para Apache Spark.
| Métrica de fila filha | Descrição |
|---|---|
yarn:ResourceManager:ChildQueueMetrics:AvailableMB |
A quantidade de memória disponível em mebibytes nessa fila na partição padrão. |
yarn:ResourceManager:ChildQueueMetrics:PendingContainers |
Número de contêineres pendentes (em fila) nesta fila na partição padrão. |
yarn:ResourceManager:ChildQueueMetrics:running_0 |
O número de jobs com um ambiente de execução entre 0 e 60 minutos
nessa fila em todas as partições. |
yarn:ResourceManager:ChildQueueMetrics:running_60 |
O número de jobs com um ambiente de execução entre 60 e 300 minutos
nessa fila em todas as partições. |
yarn:ResourceManager:ChildQueueMetrics:running_300 |
O número de jobs com um ambiente de execução entre 300 e 1440 minutos
nessa fila em todas as partições. |
yarn:ResourceManager:ChildQueueMetrics:running_1440 |
O número de jobs com um tempo de execução maior que 1440 minutos
nessa fila em todas as partições. |
yarn:ResourceManager:ChildQueueMetrics:AppsSubmitted |
Número de aplicativos enviados para essa fila em todas as partições. |
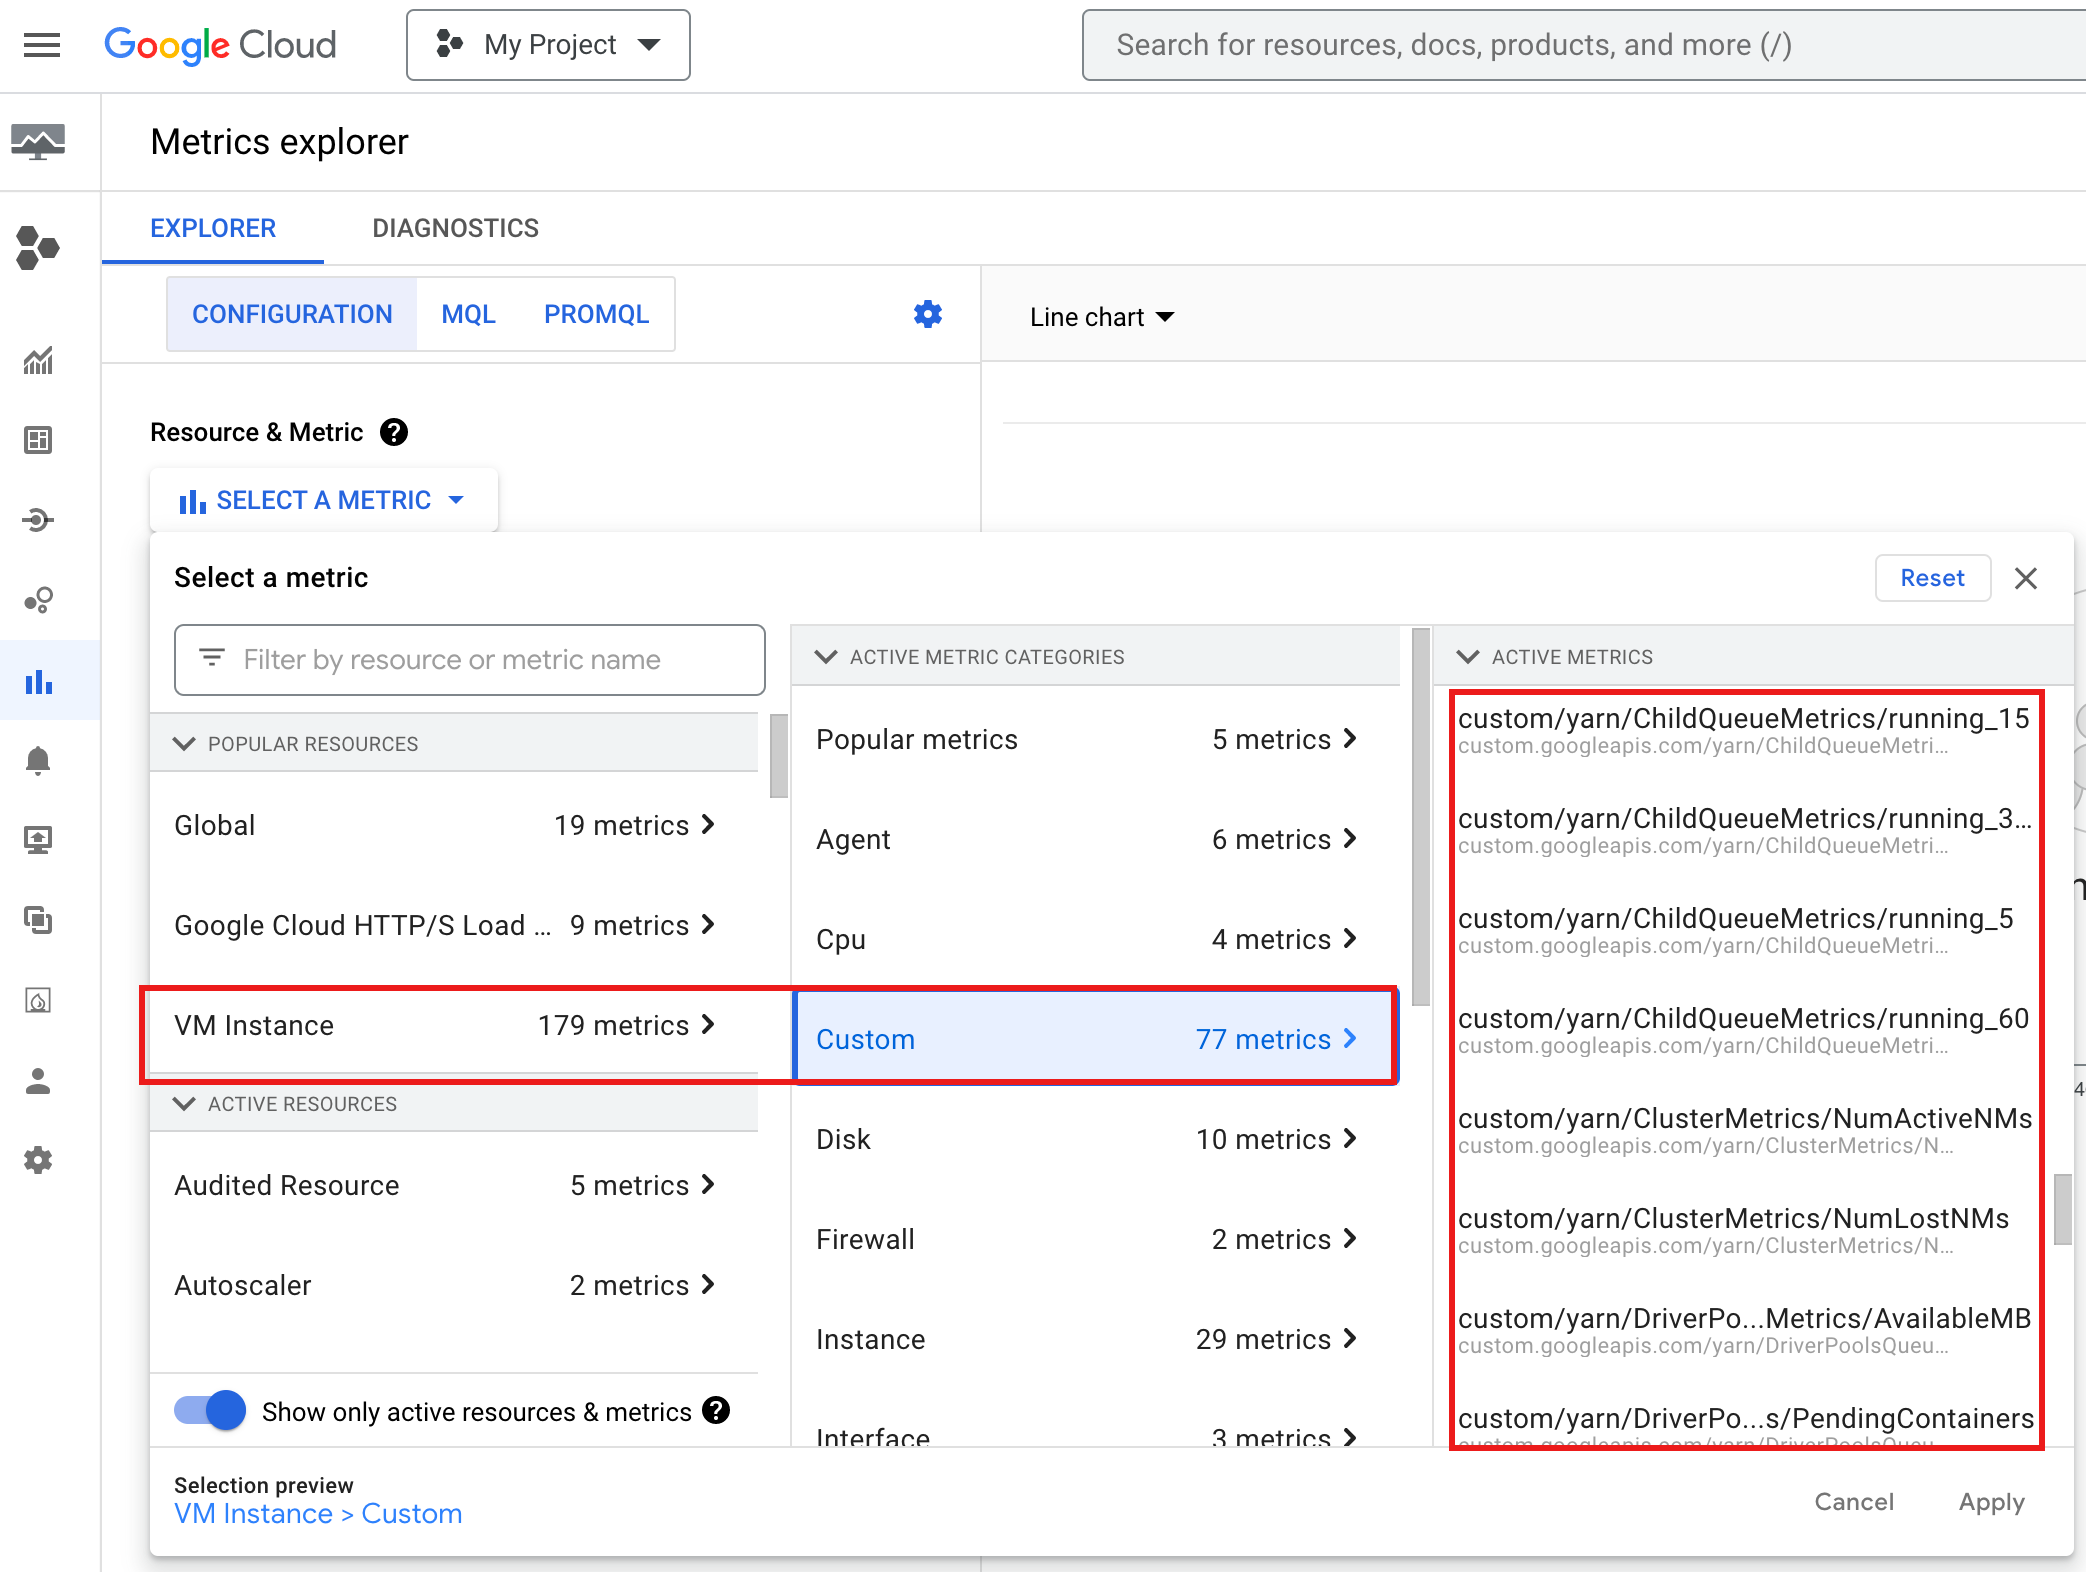
Para ver YARN ChildQueueMetrics e DriverPoolsQueueMetrics no console doCloud de Confiance :
Selecione os recursos Instância de VM → Personalizado no Metrics Explorer.
Depurar o driver de job do grupo de nós
Nesta seção, apresentamos as condições e os erros do grupo de nós do driver com recomendações para corrigir a condição ou o erro.
Condições
Condição:
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMBestá se aproximando de0. Isso indica que a fila de pools de drivers do cluster está ficando sem memória.Recomendação: aumente o tamanho do pool de drivers.
Condição:
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainersé maior que 0. Isso pode indicar que a fila de pools de drivers do cluster está ficando sem memória e o YARN está colocando jobs na fila.Recomendação: aumente o tamanho do pool de drivers.
Erros
Erro:
Cluster <var>CLUSTER_NAME</var> requires driver scheduling config to run SPARK job because it contains a node pool with role DRIVER. Positive values are required for all driver scheduling config values.Recomendação: defina
driver-required-memory-mbedriver-required-vcorescom números positivos.Erro:
Container exited with a non-zero exit code 137.Recomendação: aumente
driver-required-memory-mbpara o uso da memória do job.