

Lorsque vous utilisez Managed Service pour Apache Spark pour créer des clusters et exécuter des jobs sur vos clusters, le service configure les rôles et autorisations Managed Service pour Apache Spark nécessaires dans votre projet pour accéder aux ressources Cloud de Confiance by S3NS dont il a besoin pour accomplir ces tâches et les utiliser. Notez toutefois que si vous travaillez avec plusieurs projets (afin d'accéder aux données d'un autre projet, par exemple), vous devez configurer les rôles et autorisations nécessaires pour accéder aux ressources des différents projets.
Pour vous aider à travailler efficacement sur plusieurs projets, ce document liste les différents comptes principaux qui utilisent Managed Service pour Apache Spark et les rôles qui contiennent les autorisations nécessaires pour que ces comptes principaux puissent accéder aux ressources Cloud de Confiance et les utiliser.
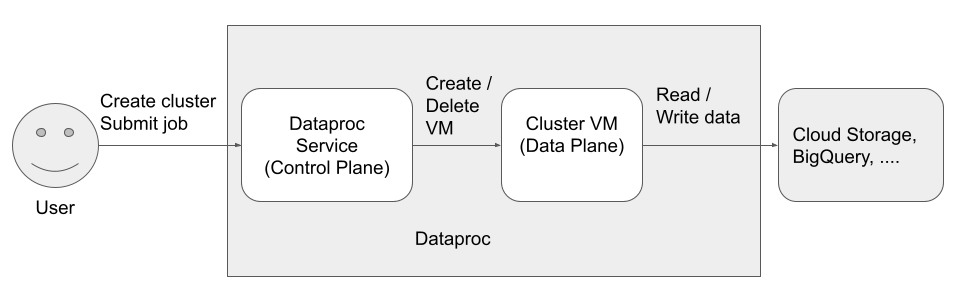
Trois comptes principaux (identités) accèdent à Managed Service pour Apache Spark et l'utilisent :
- Identité des utilisateurs
- Identité du plan de contrôle
Identité du plan de données
Utilisateur de l'API Dataproc (identité d'utilisateur)
Exemple : nom_utilisateur@example.com
Il s'agit de l'utilisateur qui appelle Managed Service pour Apache Spark pour créer des clusters, envoyer des jobs et envoyer d'autres requêtes au service. L'utilisateur est généralement une personne physique, mais il peut également s'agir d'un compte de service si Managed Service pour Apache Spark est appelé via un client API ou depuis un autre serviceCloud de Confiance by S3NS tel que Compute Engine, Cloud Run Functions ou Managed Service pour Apache Airflow.
Rôles associés
Remarques
- Les jobs envoyés via l'API Dataproc s'exécutent en tant que
rootsous Linux. Les clusters Managed Service pour Apache Spark héritent des métadonnées SSH Compute Engine à l'échelle du projet, sauf si elles sont explicitement bloquées en définissant
--metadata=block-project-ssh-keys=truelors de la création de votre cluster (voir Métadonnées du cluster).Les répertoires d'utilisateurs HDFS sont créés pour chaque utilisateur SSH au niveau du projet. Ces répertoires HDFS sont créés au moment du déploiement du cluster, et un nouvel utilisateur SSH (après le déploiement) ne se verra pas attribuer un répertoire HDFS sur les clusters existants.
Agent de service Managed Service pour Apache Spark (identité du plan de contrôle)
Exemple : service-project-number@dataproc-accounts.s3ns-system.iam.gserviceaccount.com
Le compte de service de l'agent de service Managed Service pour Apache Spark permet d'effectuer un large éventail d'opérations système sur les ressources situées dans le projet où un cluster Managed Service pour Apache Spark est créé, y compris :
- Créer des ressources Compute Engine, telles que des instances de VM, des groupes d'instances et des modèles d'instances
- Opérations
getetlistpour confirmer la configuration des ressources telles que les images, les pare-feu, les actions d'initialisation de Managed Service pour Apache Spark et les buckets Cloud Storage - Création automatique des buckets de préproduction et temporaires de Managed Service pour Apache Spark si l'utilisateur ne les spécifie pas
- Écrire des métadonnées de configuration de cluster dans le bucket de préproduction
- Accéder aux réseaux VPC d'un projet hôte
Rôles associés
Compte de service de VM Managed Service pour Apache Spark (identité du plan de données)
Exemple : project-number-compute@developer.s3ns-system.iam.gserviceaccount.com
Le code de votre application s'exécute en tant que compte de service de VM sur les VM Managed Service pour Apache Spark. Les jobs utilisateur se voient attribuer les rôles (avec leurs autorisations associées) de ce compte de service.
Le compte de service de la VM effectue les opérations suivantes :
- Communique avec le plan de contrôle de Managed Service pour Apache Spark.
- Il lit et écrit des données dans les buckets de préproduction et temporaires de Managed Service pour Apache Spark.
- Selon les besoins de vos jobs Managed Service pour Apache Spark, il lit et écrit des données depuis et vers Cloud Storage, BigQuery, Cloud Logging et d'autres ressources Cloud de Confiance by S3NS .
Rôles associés
Étapes suivantes
- En savoir plus sur les rôles et autorisations Managed Service pour Apache Spark
- En savoir plus sur les comptes de service Managed Service pour Apache Spark
- Consultez Contrôle des accès BigQuery.
- Consultez Options de contrôle des accès Cloud Storage.