

Le connecteur spark-bigquery est utilisé avec Apache Spark pour lire et écrire des données depuis et vers BigQuery. Le connecteur exploite l'API BigQuery Storage lors de la lecture de données à partir de BigQuery.
Ce tutoriel fournit des informations sur la disponibilité du connecteur préinstallé et vous explique comment rendre une version de connecteur spécifique disponible pour les jobs Spark. Un exemple de code vous montre comment utiliser le connecteur Spark BigQuery dans une application Spark.
Utiliser le connecteur préinstallé
Le connecteur Spark-BigQuery est préinstallé et disponible pour les jobs Spark exécutés sur des clusters Managed Service pour Apache Spark créés avec les versions d'image 2.1 et ultérieures. La version du connecteur préinstallée est indiquée sur les pages de publication des versions d'image.
Rendre une version de connecteur spécifique disponible pour les jobs Spark
Si vous souhaitez utiliser une version de connecteur différente d'une version préinstallée sur un cluster de version d'image 2.1 ou ultérieure, ou si vous souhaitez installer le connecteur sur un cluster de version d'image antérieure à 2.1, suivez les instructions de cette section.
Important : La version de spark-bigquery-connector doit être compatible avec la version de l'image du cluster Managed Service pour Apache Spark. Consultez la matrice de compatibilité des images du connecteur à Managed Service pour Apache Spark.
Clusters de version d'image 2.1 et versions ultérieures
Lorsque vous créez un cluster Managed Service pour Apache Spark avec une version d'image 2.1 ou ultérieure, spécifiez la version du connecteur en tant que métadonnées du cluster.
Exemple gcloud CLI :
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --image-version=2.2 \
    --metadata=SPARK_BQ_CONNECTOR_VERSION or SPARK_BQ_CONNECTOR_URL\
    other flags
Remarques :
SPARK_BQ_CONNECTOR_VERSION : spécifiez une version de connecteur. Les versions du connecteur Spark BigQuery sont répertoriées sur la page spark-bigquery-connector/releases de GitHub.
Exemple :
--metadata=SPARK_BQ_CONNECTOR_VERSION=0.42.1
SPARK_BQ_CONNECTOR_URL : spécifiez une URL qui pointe vers le fichier JAR dans Cloud Storage. Vous pouvez spécifier l'URL d'un connecteur répertorié dans la colonne Lien de la section Télécharger et utiliser le connecteur sur GitHub ou le chemin d'accès à un emplacement Cloud Storage où vous avez placé un fichier JAR de connecteur personnalisé.
Exemples :
--metadata=SPARK_BQ_CONNECTOR_URL=gs://spark-lib/bigquery/spark-3.5-bigquery-0.42.1.jar
--metadata=SPARK_BQ_CONNECTOR_URL=gs://PATH_TO_CUSTOM_JAR
Clusters de version d'image 2.0 et versions antérieures
Vous pouvez rendre le connecteur Spark BigQuery disponible pour votre application de l'une des manières suivantes :
Installez le connecteur spark-bigquery-connector dans le répertoire des fichiers JAR Spark de chaque nœud à l'aide de l'action d'initialisation des connecteurs Managed Service pour Apache Spark lorsque vous créez votre cluster.
Indiquez l'URL du fichier JAR du connecteur lorsque vous envoyez votre job au cluster à l'aide de la console Cloud de Confiance , de gcloud CLI ou de l'API Managed Service pour Apache Spark.
Console
Utilisez l'élément Fichiers JAR du job Spark sur la page Envoyer un job de Managed Service pour Apache Spark.
gcloud
Utilisez l'option
gcloud dataproc jobs submit spark --jars.API
Utilisez le champ
SparkJob.jarFileUris.Spécifier le fichier JAR du connecteur lors de l'exécution de jobs Spark sur des clusters de version d'image antérieure à la version 2.0
- Spécifiez le fichier JAR du connecteur en remplaçant les informations de version de Scala et du connecteur dans la chaîne d'URI suivante :
gs://spark-lib/bigquery/spark-bigquery-with-dependencies_SCALA_VERSION-CONNECTOR_VERSION.jar
- Utilisez Scala
2.12avec les versions d'image Managed Service pour Apache Spark1.5+.gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-CONNECTOR_VERSION.jar
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-0.23.2.jar \
    -- job args
- Utilisez Scala
2.11avec les versions d'image Managed Service pour Apache Spark1.4et antérieures :gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.11-CONNECTOR_VERSION.jar
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.11-0.23.2.jar \
    -- job-args
- Spécifiez le fichier JAR du connecteur en remplaçant les informations de version de Scala et du connecteur dans la chaîne d'URI suivante :
Incluez le fichier JAR du connecteur dans votre application Scala ou Java Spark en tant que dépendance (consultez la section Compiler avec le connecteur).
Calculer les coûts
Dans ce document, vous utilisez les composants facturables de Cloud de Confiance by S3NSsuivants :
- Managed Service for Apache Spark
- BigQuery
- Cloud Storage
Lire et écrire des données depuis et vers BigQuery
Cet exemple lit les données de BigQuery dans un DataFrame Spark pour effectuer un décompte de mots à l'aide de l'API de source de données standard.
Le connecteur lit les données de BigQuery à l'aide de l'API BigQuery Storage Read, qui lit directement les fichiers de données de la table de manière distribuée.
Le connecteur écrit les données dans BigQuery selon l'un des deux modes suivants : DIRECT ou INDIRECT.
- DIRECT : utilise l'API BigQuery Storage Write. Chaque exécuteur écrit ses données, et le pilote valide toutes les données en attente dans la table.
- INDIRECT : met en mémoire tampon les données dans une table temporaire Cloud Storage, puis déclenche un job de chargement BigQuery pour copier les données dans BigQuery en une seule opération.
En mode INDIRECT, le connecteur tente de supprimer les fichiers temporaires une fois l'opération de chargement BigQuery réussie, puis une nouvelle fois lorsque l'application Spark se termine. Si le job échoue, supprimez manuellement les fichiers Cloud Storage temporaires restants. En règle générale, les fichiers BigQuery temporaires se trouvent dans gs://[bucket]/.spark-bigquery-[jobid]-[UUID].
Configurer la facturation
Par défaut, le projet associé aux identifiants ou au compte de service est facturé pour l'utilisation de l'API. Pour facturer un autre projet, définissez la configuration suivante : spark.conf.set("parentProject", "<BILLED-GCP-PROJECT>").
Il peut également être ajouté à une opération de lecture ou d'écriture, comme suit : .option("parentProject", "<BILLED-GCP-PROJECT>").
Exécuter le code
Avant d'exécuter cet exemple, créez un ensemble de données nommé "wordcount_dataset" ou remplacez l'ensemble de données de sortie dans le code par un ensemble de données BigQuery existant dans votre projetCloud de Confiance by S3NS .
Utilisez la commande bq pour créer l'élément wordcount_dataset :
bq mk wordcount_dataset
Utilisez la commande Google Cloud CLI pour créer un bucket Cloud Storage, qui sera utilisé pour l'exportation vers BigQuery :
gcloud storage buckets create gs://[bucket]
Scala
- Examinez le code et remplacez l'espace réservé [bucket] par le bucket Cloud Storage que vous avez créé précédemment.
/*
 * Remove comment if you are not running in spark-shell.
 *
import org.apache.spark.sql.SparkSession
val spark = SparkSession.builder()
  .appName("spark-bigquery-demo")
  .getOrCreate()
*/

// Use the Cloud Storage bucket for temporary BigQuery export data used
// by the connector.
val bucket = "[bucket]"
spark.conf.set("temporaryGcsBucket", bucket)
// Enable reading from BigQuery views and materializing query results.
spark.conf.set("viewsEnabled", "true")
spark.conf.set("materializationDataset", "wordcount_dataset")

// Load data in from BigQuery. See
// https://github.com/GoogleCloudDataproc/spark-bigquery-connector#properties
// for option information.
val wordsDF =
  spark.read.bigquery("bigquery-public-data:samples.shakespeare")
  .cache()

wordsDF.createOrReplaceTempView("words")

// Perform word count.
val wordCountDF = spark.sql(
  "SELECT word, SUM(word_count) AS word_count FROM words GROUP BY word")
wordCountDF.show()
wordCountDF.printSchema()

// Saving the data to BigQuery.
(wordCountDF.write.format("bigquery")
  .save("wordcount_dataset.wordcount_output"))
- Exécutez le code sur votre cluster.
- Utilisez SSH pour vous connecter au nœud maître du cluster Managed Service pour Apache Spark.
- Accédez à la page Clusters de Managed Service pour Apache Spark dans la console Cloud de Confiance , puis cliquez sur le nom de votre cluster
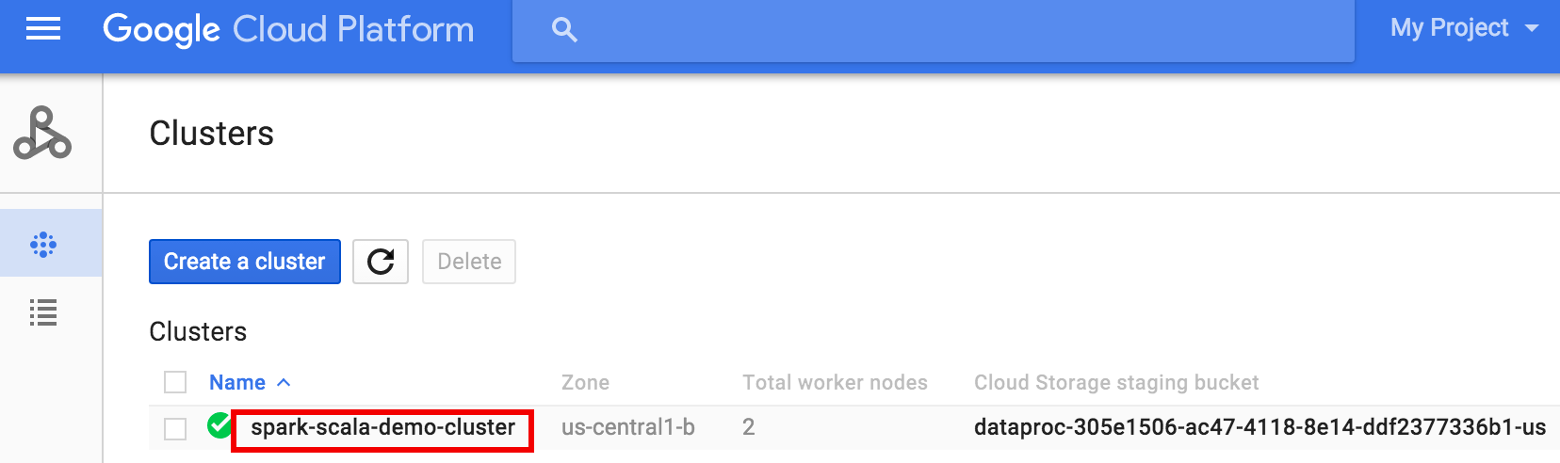 .
- Sur la page Détails du cluster, sélectionnez l'onglet "Instances de VM". Cliquez ensuite sur
SSHà droite du nom du maître de cluster >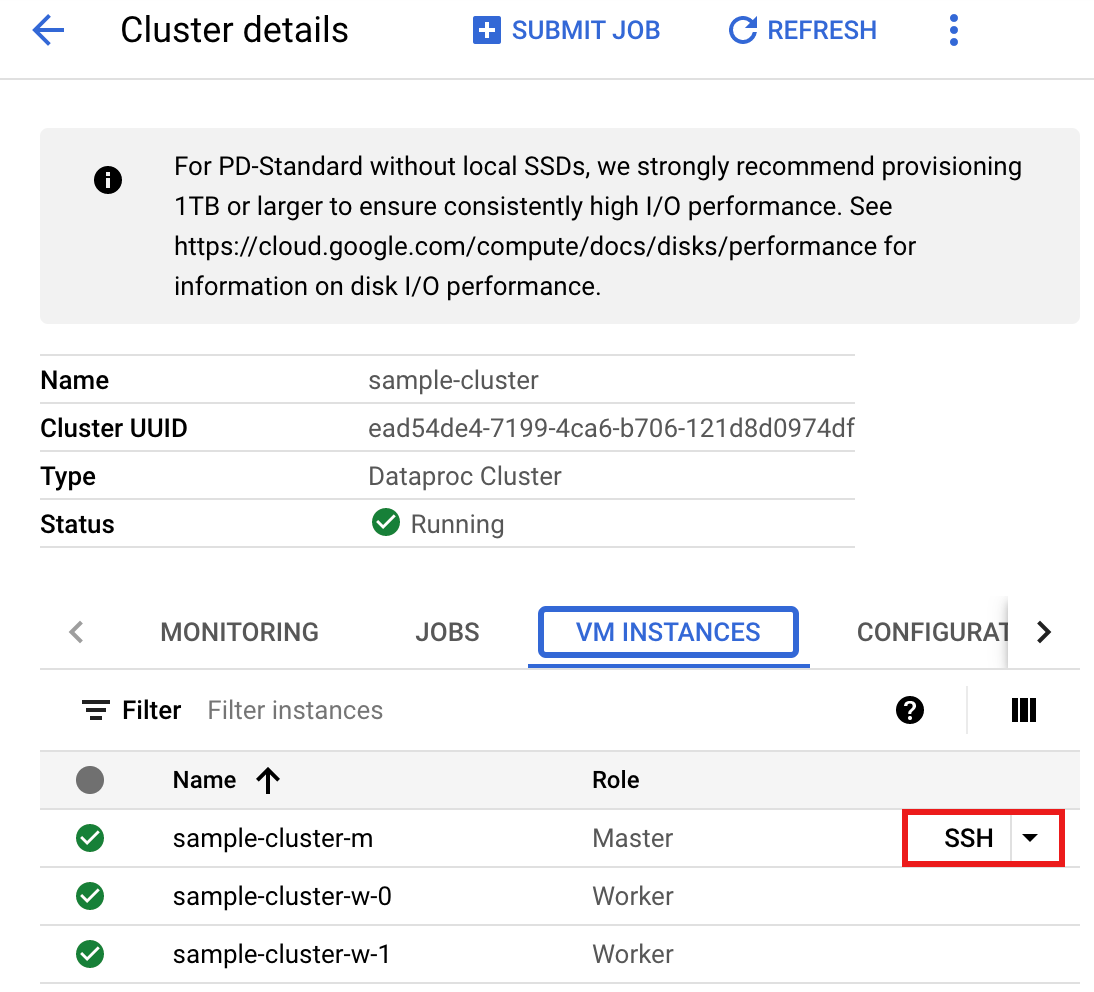 .
Une fenêtre de navigateur s'ouvre dans votre répertoire d'accueil sur le nœud maître.Connected, host fingerprint: ssh-rsa 2048 ... ... user@clusterName-m:~$
- Accédez à la page Clusters de Managed Service pour Apache Spark dans la console Cloud de Confiance , puis cliquez sur le nom de votre cluster
- Créez le fichier
wordcount.scalaavec l'éditeur de textevi,vimounanopréinstallé, puis collez le code Scala à partir de la liste de codes Scala.nano wordcount.scala
- Lancez le REPL
spark-shell.$ spark-shell --jars=gs://spark-lib/bigquery/spark-bigquery-latest_2.12.jar ... Using Scala version ... Type in expressions to have them evaluated. Type :help for more information. ... Spark context available as sc. ... SQL context available as sqlContext. scala>
- Exécutez "WordCount.scala" avec la commande
:load wordcount.scalapour créer la table BigQuerywordcount_output. La liste de sortie affiche 10 lignes du résultat de la commande "wordcount".:load wordcount.scala ... +---------+----------+ | word|word_count| +---------+----------+ | XVII| 2| | spoil| 28| | Drink| 7| |forgetful| 5| | Cannot| 46| | cures| 10| | harder| 13| | tresses| 3| | few| 62| | steel'd| 5| | tripping| 7| | travel| 35| | ransom| 55| | hope| 366| | By| 816| | some| 1169| | those| 508| | still| 567| | art| 893| | feign| 10| +---------+----------+ only showing top 20 rows root |-- word: string (nullable = false) |-- word_count: long (nullable = true)
Pour prévisualiser la table de sortie, ouvrez la pageBigQuery, sélectionnez la tablewordcount_output, puis cliquez sur Aperçu.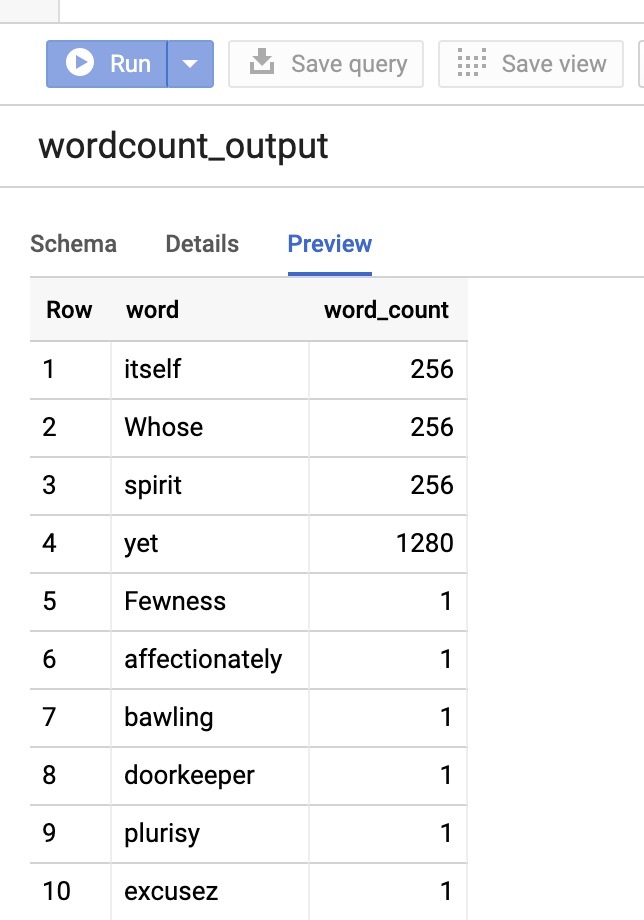
- Utilisez SSH pour vous connecter au nœud maître du cluster Managed Service pour Apache Spark.
PySpark
- Examinez le code et remplacez l'espace réservé [bucket] par le bucket Cloud Storage que vous avez créé précédemment.
#!/usr/bin/env python

"""BigQuery I/O PySpark example."""

from pyspark.sql import SparkSession

spark = SparkSession \
  .builder \
  .master('yarn') \
  .appName('spark-bigquery-demo') \
  .getOrCreate()

# Use the Cloud Storage bucket for temporary BigQuery export data used
# by the connector.
bucket = "[bucket]"
spark.conf.set('temporaryGcsBucket', bucket)
# Enable reading from BigQuery views and materializing query results.
spark.conf.set('viewsEnabled', 'true')
spark.conf.set('materializationDataset', 'wordcount_dataset')

# Load data from BigQuery.
words = spark.read.format('bigquery') \
  .load('bigquery-public-data:samples.shakespeare')
words.createOrReplaceTempView('words')

# Perform word count.
word_count = spark.sql(
    'SELECT word, SUM(word_count) AS word_count FROM words GROUP BY word')
word_count.show()
word_count.printSchema()

# Save the data to BigQuery
word_count.write.format('bigquery') \
  .save('wordcount_dataset.wordcount_output')
- Exécutez le code sur votre cluster.
- Utilisez SSH pour vous connecter au nœud maître du cluster Managed Service pour Apache Spark.
- Accédez à la page Clusters de Managed Service pour Apache Spark dans la console Cloud de Confiance , puis cliquez sur le nom de votre cluster .
- Sur la page Détails du cluster, sélectionnez l'onglet "Instances de VM". Cliquez ensuite sur
SSHà droite du nom du nœud maître du cluster
Une fenêtre de navigateur s'ouvre dans votre répertoire d'accueil sur le nœud maître.Connected, host fingerprint: ssh-rsa 2048 ... ... user@clusterName-m:~$
- Accédez à la page Clusters de Managed Service pour Apache Spark dans la console Cloud de Confiance , puis cliquez sur le nom de votre cluster
- Créez le fichier
wordcount.pyavec l'éditeur de textevi,vimounanopréinstallé, puis collez le code PySpark à partir de la liste de code PySpark.nano wordcount.py
- Exécutez "wordcount" avec
spark-submitpour créer la table BigQuerywordcount_output. La liste de sortie affiche 10 lignes du résultat de la commande "wordcount".spark-submit --jars gs://spark-lib/bigquery/spark-bigquery-latest_2.12.jar wordcount.py ... +---------+----------+ | word|word_count| +---------+----------+ | XVII| 2| | spoil| 28| | Drink| 7| |forgetful| 5| | Cannot| 46| | cures| 10| | harder| 13| | tresses| 3| | few| 62| | steel'd| 5| | tripping| 7| | travel| 35| | ransom| 55| | hope| 366| | By| 816| | some| 1169| | those| 508| | still| 567| | art| 893| | feign| 10| +---------+----------+ only showing top 20 rows root |-- word: string (nullable = false) |-- word_count: long (nullable = true)
Pour prévisualiser la table de sortie, ouvrez la pageBigQuery, sélectionnez la tablewordcount_output, puis cliquez sur Aperçu.
- Utilisez SSH pour vous connecter au nœud maître du cluster Managed Service pour Apache Spark.
Conseils de dépannage
Vous pouvez examiner les journaux de jobs dans Cloud Logging et dans l'explorateur de jobs BigQuery pour résoudre les problèmes liés aux jobs Spark qui utilisent le connecteur BigQuery.
Les journaux du pilote Managed Service pour Apache Spark contiennent une entrée
BigQueryClientavec des métadonnées BigQuery qui incluentjobId:ClassNotFoundException
INFO BigQueryClient:.. jobId: JobId{project=PROJECT_ID, job=JOB_ID, location=LOCATION} Les jobs BigQuery contiennent les étiquettes
Managed Service for Apache Spark_job_idetManaged Service for Apache Spark_job_uuid:- Journalisation :
protoPayload.serviceData.jobCompletedEvent.job.jobConfiguration.labels.dataproc_job_id="JOB_ID"
protoPayload.serviceData.jobCompletedEvent.job.jobConfiguration.labels.dataproc_job_uuid="JOB_UUID"
protoPayload.serviceData.jobCompletedEvent.job.jobName.jobId="JOB_NAME"
- Explorateur de jobs BigQuery : cliquez sur un ID de job pour afficher les détails du job sous Libellés dans Informations sur le job.
- Journalisation :
Étapes suivantes
- Consultez BigQuery Storage et Spark SQL – Python.
- Découvrez comment créer un fichier de définition de table pour une source de données externe.
- Découvrez comment interroger des données partitionnées en externe.
- Consultez Conseils pour le réglage des jobs Spark.