

Der hierarchische Namespace ist eine Funktion von Cloud Storage, mit der Sie Objekte in Ordnern organisieren und Ihre Daten in einer logischen Dateisystemstruktur speichern können. So lassen sich Datenmanagementaufgaben einfacher optimieren. Der hierarchische Namespace bietet die leistungsstarke Verzeichnissemantik und die atomaren Ordneroperationen, die für die Beschleunigung datenintensiver KI/ML- und Analysearbeitslasten erforderlich sind.
Auf dieser Seite erhalten Sie einen Überblick über den hierarchischen Namespace und seine Anwendungsfälle, einschließlich seiner Funktionen, Vorteile und Einschränkungen.
Funktionsweise
Wenn Sie Ordner in einem Bucket verwenden möchten, müssen Sie beim Erstellen des Buckets den hierarchischen Namespace aktivieren. Die Einstellung für den hierarchischen Namespace des Buckets kann nach dem Erstellen nicht mehr geändert werden. Informationen zum Aktivieren des hierarchischen Namespace für Ihren Bucket finden Sie unter Buckets mit aktiviertem hierarchischen Namespace erstellen und verwalten.
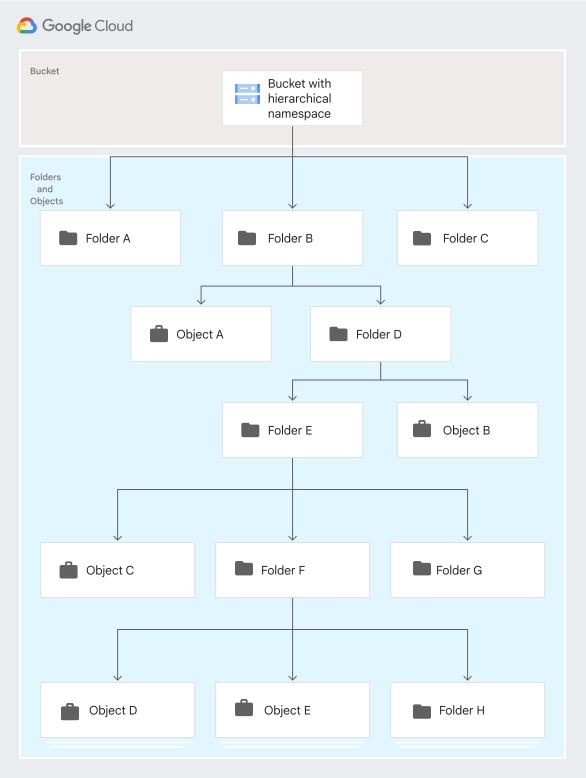
Das folgende Diagramm zeigt ein Beispiel für einen Bucket mit aktiviertem hierarchischem Namespace, in dem Objekte in einer hierarchischen Ordnerstruktur organisiert sind. Ein Ordner in einem Bucket mit aktiviertem hierarchischen Namespace kann sowohl Objekte als auch untergeordnete Ordner enthalten.
Funktionen und Vorteile
Der hierarchische Namespace bietet folgende Funktionen und Vorteile:
Höhere anfängliche Abfragen pro Sekunde (QPS): Buckets mit aktiviertem hierarchischem Namespace bieten bis zu achtmal höhere anfängliche QPS-Limits für das Lesen und Schreiben von Objekten im Vergleich zu Buckets ohne aktivierten hierarchischen Namespace. Die höheren anfänglichen Abfragen pro Sekunde erleichtern die Skalierung datenintensiver Arbeitslasten und sorgen für einen höheren Durchsatz. Informationen zu Methoden zur Leistungsoptimierung bei der Verwendung von Ordnern in Buckets mit aktiviertem hierarchischen Namespace finden Sie unter Ordnerverwaltung.
Möglichkeit, Ordner zu verwenden: Ordner dienen als Container für Objekte und untergeordnete Ordner und ermöglichen eine echte Verzeichnisstruktur in Cloud Storage-Buckets. Wenn Sie Ihre Daten in einer Ordnerstruktur speichern, verbessert sich die Leistung, die Konsistenz wird gewährleistet und die Verwaltung datenintensiver und dateiorientierter Arbeitslasten wird vereinfacht.
Ordner-Vorgänge bieten Zuverlässigkeit und Verwaltungsfunktionen, einschließlich Erstellen, Auflisten, Löschen und atomares Umbenennen.
Ordner umbenennen: Mit dem Vorgang „Ordner umbenennen“ können Sie den Pfad eines Ordners und seiner zugrunde liegenden Ordner atomar umbenennen, ohne Objekte zu löschen. Diese Methode ist effizient und zeitsparend, insbesondere bei großen Ordnern mit mehreren Objekten.
Ordner auflisten: Mit dem Vorgang „Ordner auflisten“ werden alle Ordner im Bucket oder unter einem bestimmten Ordner aufgelistet. So können Sie die Struktur Ihrer gespeicherten Daten besser verwalten und nachvollziehen.
Wann sollten Sie einen hierarchischen Namespace verwenden?
Sie sollten den hierarchischen Namespace aktivieren, wenn Sie mit Anwendungen arbeiten, die eine Dateisystemhierarchie und -semantik erwarten. Der hierarchische Namespace eignet sich für datenintensive Aufgaben wie Analysen und KI/ML-Arbeitslasten. Hier sind einige häufige Szenarien, in denen Sie den hierarchischen Namespace verwenden sollten:
Hadoop-basierte Verarbeitung: Hadoop- und Spark-Arbeitslasten erwarten herkömmlicherweise eine Dateisystem-Speicherstruktur und eine zeitbasierte Benennung für Dateien und Ordner. Der hierarchische Namespace lässt sich in den Cloud Storage-Connector einbinden, um den Durchsatz zu erhöhen und atomare Ordnerumbenennungen zu ermöglichen. So werden die Datenintegrität und ‑konsistenz für viele Datenverarbeitungspipelines verbessert.
Verarbeitung dateiorientierter Arbeitslasten: Arbeitslasten wie die Batch-Analyse, Finanzdienstleistungen oder Hochleistungs-Computing sind basierend auf einer Hierarchie von Ordnern und Dateien in Partitionen strukturiert. Der hierarchische Namespace unterstützt die Verwaltung dieser Umgebungen mit einer speziellen API für die Ordnerverwaltung. Außerdem vereinfacht ein hierarchischer Namespace die Verwaltung von Ordnern, die andere Ordner und Objekte enthalten. Mit einem einzigen API-Befehl können Sie einen Ordner und alle seine Inhalte schnell umbenennen und so wertvolle Zeit und Ressourcen sparen.
KI-/ML-Verarbeitung: KI-/ML-Tools wie TensorFlow, Pandas und PyTorch erwarten Zugriffssteuerung und Semantik für das Dateisystem. Der hierarchische Namespace bietet, insbesondere in Kombination mit Cloud Storage FUSE, einen höheren Durchsatz und einen effizienten Datenzugriff. Daher verbessert der hierarchische Namespace die Leistung und Zuverlässigkeit der ML-Modelliteration.
Bevor Sie den hierarchischen Namespace für Ihren Bucket aktivieren, sollten Sie die Einschränkungen des hierarchischen Namespaces berücksichtigen. Informationen zu Einschränkungen für hierarchische Namespaces finden Sie unter Einschränkungen.
Vorteile des hierarchischen Namespaces
Wenn Sie den hierarchischen Namespace für Ihre Buckets aktivieren, können Sie Folgendes tun:
Organisation optimieren: Sie können Ihre Daten in einer hierarchischen Ordnerstruktur organisieren, um Dateien oder Datasets einfacher zu verwalten und zu finden.
Dateisystem-Ökosystem einrichten: Der hierarchische Namespace bietet Dateisystemfunktionen wie Ordner, Ordnerumbenennung und Ordnerauflistung, die für dateiorientierte Anwendungen wie das Hadoop-Ökosystem und KI/ML-Arbeitslasten nützlich sind.
Leistungsverbesserung: Durch die Skalierung datenintensiver Arbeitslasten für einen höheren Durchsatz können Sie die Gesamtleistung Ihrer Anwendung verbessern.
Plattform-Support
Buckets mit hierarchischem Namespace unterstützen die folgenden Cloud Storage-Plattformfunktionen:
Alle Cloud Storage-Objekt-APIs und häufig verwendete Cloud Storage-Funktionen. Weitere Informationen zu nicht unterstützten Funktionen finden Sie unter Einschränkungen.
Datenübertragung von einem Standard-Bucket in einen Bucket mit hierarchischem Namespace mithilfe von Storage Transfer Service.
Integration in die folgenden Produkte:
Cloud Storage-Connector, der von Managed Service for Apache Spark für Hadoop-Arbeitslasten verwaltet wird. Weitere Informationen finden Sie unter Buckets mit aktiviertem hierarchischen Namespace für Hadoop-Arbeitslasten verwenden.
Cloud Storage FUSE für den Zugriff auf Buckets wie auf ein Dateisystem über Clients.
GCSFS-Python-Bibliothek für den Zugriff auf Buckets wie auf ein Dateisystem. Der hierarchische Namespace wird von den GCSFS-Python-Bibliotheksversionen 2026.3.0 und höher unterstützt.
Kompatibilität mit Cloud Storage-Vorgängen und -Funktionen
Buckets mit aktiviertem hierarchischen Namespace interagieren anders mit Cloud Storage-Vorgängen als Buckets ohne hierarchischen Namespace.
Interaktionen mit Objektvorgängen
Buckets mit aktiviertem hierarchischen Namespace verarbeiten Objektvorgänge so:
- Bei Vorgängen wie
Upload,RewriteundComposewerden fehlende übergeordnete Ordner automatisch erstellt, sofern Sie die erforderlichen Berechtigungen haben. Daher müssen Sie keine Ordner vorab erstellen, bevor Sie Objekte hochladen. - Ordner können zwar automatisch während Objektvorgängen erstellt werden, Sie müssen sie jedoch explizit mit dem Vorgang
DeleteFolderlöschen. - Wenn Sie den Vorgang
ListObjectsmit dem Parameterdelimiterverwenden, geben Buckets jeden untergeordneten Ordner alsprefix.zurück. Leere Ordner werden jedoch standardmäßig ausgeschlossen. Wenn Sie leere Ordner wie in einer typischen Dateisystemliste einbeziehen möchten, müssen Sie den ParameterincludeFoldersAsPrefixesfestlegen. Informationen zu Methoden zur Leistungsoptimierung beim Auflisten von Objekten in Buckets mit aktiviertem hierarchischen Namespace finden Sie unter Objekte auflisten.
Interaktionen mit Bucket-Vorgängen
In den folgenden Abschnitten wird beschrieben, wie Bucket-Vorgänge verarbeitet werden, wenn der hierarchische Namespace aktiviert ist.
Sie können alle Buckets mit aktiviertem hierarchischen Namespace auflisten, unabhängig von ihrem Speicherlayout. Das Speicherlayout eines Buckets beschreibt, wie Objekte in einem Bucket angeordnet sind, entweder in einem flachen Namespace oder einem hierarchischen Namespace. Eine Anleitung zum Aufrufen des Speicherlayouts eines Buckets finden Sie unter Speicherlayout eines Buckets abrufen. Wenn Sie alle Buckets auflisten möchten, folgen Sie der Anleitung unter Buckets auflisten.
Sie können Buckets mit aktiviertem hierarchischen Namespace löschen, solange der Bucket leer ist. Leere Buckets enthalten keine Objekte oder verwalteten Ordner. Leere Buckets können leere Ordner (ohne Objekte) enthalten.
Interaktionen mit Vorgängen zur Verwaltung des Objektlebenszyklus
Mit der Verwaltung des Objektlebenszyklus können Sie Aktionen für Objekte basierend auf Bedingungen wie Alter oder Präfix automatisieren. Aufgrund des Vorgangs RenameFolder können sich Regeln für die Verwaltung des Objektlebenszyklus in Buckets mit hierarchischem Namespace und in Buckets mit flachem Namespace jedoch unterschiedlich verhalten:
Regeln für die Verwaltung des Objektlebenszyklus für Buckets mit einem flachen Namespace: Beim Umbenennen wird jedes Objekt mithilfe von Tools umbenannt. Dazu wird jedes Objekt an einen Zielspeicherort kopiert und das ursprüngliche Objekt am Quellspeicherort gelöscht. Daher werden am Zielort neue Objekte mit neuen Erstellungszeiten erstellt. Wenn für den Zielspeicherort altersbasierte Regeln zur Verwaltung des Objektlebenszyklus gelten, werden sie nicht sofort auf die neuen Objekte angewendet, da deren Erstellungszeiten zurückgesetzt werden.
Regeln zur Verwaltung des Objektlebenszyklus für Buckets mit aktiviertem hierarchischen Namespace: Das Umbenennen eines Ordners erfolgt auf Ordnerebene, ohne dass jedes einzelne Objekt umbenannt werden muss. Daher bleibt die Erstellungszeit der Objekte erhalten. Das bedeutet, dass die altersbasierten Regeln für die Verwaltung des Objektlebenszyklus sofort auf umbenannte Objekte angewendet werden, wenn sie die Alterskriterien erfüllen.
Zugriffssteuerung für Ordner mit verknüpften verwalteten Ordnern
In Cloud Storage ist ein Ordner das eigentliche Verzeichnis, in dem Ihre Daten gespeichert sind, während ein verwalteter Ordner eine separate, spezialisierte Ressource ist, mit der IAM-Berechtigungen auf das Verzeichnis angewendet werden. Wenn Sie den Zugriff auf einen Ordner und die darin enthaltenen Ressourcen steuern möchten, erstellen Sie einen zugehörigen verwalteten Ordner und legen IAM-Richtlinien für den zugehörigen verwalteten Ordner fest. Ein verknüpfter verwalteter Ordner ist ein verwalteter Ordner, der denselben Namen und Pfad wie Ihr tatsächlicher Ordner hat.
Der zugehörige verwaltete Ordner fungiert als Verwaltungsebene über dem vom Ordner erstellten Verzeichnis. Das bedeutet, dass ein Ordner und der zugehörige verwaltete Ordner untrennbar miteinander verbunden sind. Wenn Sie beispielsweise einen Ordner löschen, der einen zugehörigen verwalteten Ordner hat, wird der zugehörige verwaltete Ordner zusammen mit seinen IAM-Richtlinien ebenfalls gelöscht. Weitere Informationen dazu, wie sich Ordnervorgänge auf zugehörige verwaltete Ordner auswirken, finden Sie unter Interaktionen zwischen Ordnern und zugehörigen verwalteten Ordnern.
Benennung von Ordnern mit zugehörigen verwalteten Ordnern
Beim Erstellen von Ordnern mit zugehörigen verwalteten Ordnern gelten sowohl die Regeln für die Ordnerbenennung als auch die Regeln für die Benennung verwalteter Ordner. Ordnernamen können bis zu 50 Ebenen tief verschachtelt sein, verwaltete Ordnernamen jedoch nur bis zu 15 Ebenen tief. Die maximale Größe für den Namen eines verwalteten Ordners beträgt 512 Byte, wenn er UTF-8-codiert ist. Wenn Sie also einen Ordner und einen zugehörigen verwalteten Ordner erstellen möchten, kann der Ordner nur 15 verschachtelte untergeordnete Ordner haben und die maximale Namensgröße beträgt 512 Byte, wenn er UTF-8-codiert ist.
Preise
Preisinformationen finden Sie unter Cloud Storage – Preise.
Beschränkungen
Hier sind die Einschränkungen für den hierarchischen Namespace:
Sie müssen beim Erstellen des Buckets auswählen, ob der hierarchische Namespace verwendet werden soll. Die Einstellung für den hierarchischen Namespace des Buckets kann nach dem Erstellen nicht mehr geändert werden.
Damit der hierarchische Namespace verwendet werden kann, muss für den Bucket auch der einheitliche Zugriff auf Bucket-Ebene aktiviert sein.
In Buckets mit aktiviertem hierarchischen Namespace beträgt die maximale Größe des Namens eines Objekts 1.024 Byte, wenn er UTF-8-codiert ist. Dabei gilt für das Ordnernamensegment und das Basisnamensegment jeweils ein Limit von 512 Byte, wenn sie UTF-8-codiert sind. In Buckets mit flachem Namespace enthalten Objektnamen keine Ordnernamensegmente und sind auf 1.024 Byte beschränkt, wenn sie mit UTF-8 codiert sind. Weitere Informationen zu Limits für Objektnamen finden Sie unter Informationen zu Objekten.
Ordnernamen können bis zu 50 Ebenen tief verschachtelt sein (oder 15 Ebenen tief, wenn der Ordner einen zugehörigen verwalteten Ordner hat).
Die folgenden Cloud Storage-Funktionen werden für Buckets mit hierarchischem Namespace nicht unterstützt:
- Bucket-Sperre
- Verschieben von Buckets mit Schreibausfallzeit
- Bucket-übergreifende Replikation
- Objekt-Holds
- Access Control Lists (ACLs) auf Objektebene
- Objektaufbewahrungssperre
- Objektversionierung