

Puoi utilizzare gli arricchimenti degli oggetti per generare automaticamente metadati strutturati senza creare pipeline di machine learning personalizzate. Gli arricchimenti degli oggetti applicano i modelli di machine learning preaddestrati di Google direttamente agli oggetti archiviati per aiutarti a cercare, curare e gestire i tuoi dati non strutturati su larga scala.
Per iniziare a generare metadati per i tuoi oggetti, consulta Configura gli enrichment degli oggetti.
Come funziona
Per utilizzare gli arricchimenti degli oggetti, devi utilizzare le seguenti parti del sistema:
- Configurazione delle funzionalità (
FeatureConfig): crei una configurazione delle funzionalità per specificare i bucket o i progetti monitorati da Cloud Storage. - Modelli di machine learning: nella configurazione, scegli i modelli che vuoi applicare, ad esempio modelli che rilevano oggetti, etichettano immagini, analizzano volti o classificano documenti PDF.
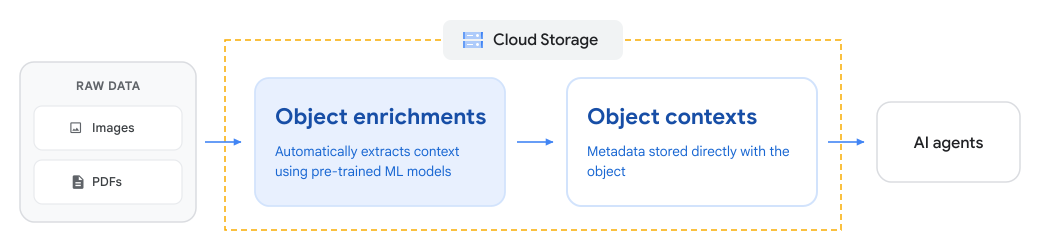
- Arricchimenti degli oggetti (metadati): Cloud Storage analizza i tuoi oggetti in modo asincrono e valuta gli oggetti idonei con i modelli selezionati. Cloud Storage allega quindi i metadati risultanti direttamente agli oggetti come contesti degli oggetti.
Dopo che Cloud Storage ha collegato i metadati di arricchimento agli oggetti, i metadati sono pronti per l'uso. Puoi ispezionare i singoli arricchimenti degli oggetti o utilizzare i set di dati di Storage Insights per analizzare i metadati di milioni di oggetti utilizzando SQL in BigQuery.
Il seguente diagramma mostra come Cloud Storage utilizza gli arricchimenti degli oggetti per estrarre il contesto dai dati non strutturati e archiviarlo come contesti degli oggetti per i workflow di AI e analisi downstream:
Modelli supportati
Quando crei una configurazione delle funzionalità, selezioni i modelli di machine learning più adatti ai tuoi dati e ai tuoi obiettivi di analisi. Cloud Storage valuta gli oggetti idonei utilizzando i modelli scelti e genera metadati strutturati in contexts.custom.
La tabella dei modelli supportati elenca ogni modello, ciò che rileva e i dati di output di esempio. Per definizioni dettagliate degli schemi e delle chiavi di contesto, consulta Modelli e schemi supportati.
| Modello | Descrizione | Dati di output di esempio |
|---|---|---|
| Rilevamento di oggetti | Rileva più oggetti all'interno di un'immagine e ne fornisce le posizioni e i confini rettangolari. | Prodotto, Animale, Persona |
| Etichettatura delle immagini | Rileva ed estrae informazioni sulle entità in un'immagine in un ampio gruppo di categorie, come oggetti, località e attività. | Paesaggio, urbano, notturno |
| Riconoscimento facciale | Rileva i volti nelle immagini, inclusi i poligoni di delimitazione, i punti di riferimento facciali (occhi, naso, bocca), gli angoli di orientamento e le probabilità di espressione. | Numero di volti, angolo di rotazione e inclinazione |
| Rilevamento di contenuti espliciti | Valuta le immagini per rilevare contenuti sensibili o inappropriati, inclusi materiali per adulti o violenti. | Valutazioni della probabilità di contenuti per adulti e violenti |
| Classificazione PDF | Classifica i documenti PDF in categorie aziendali e di settore standard in base ai loro contenuti. | Finanza, tasse, fatture (categorie e punteggi) |
Casi d'uso
Puoi utilizzare gli arricchimenti degli oggetti per semplificare la gestione dei dati non strutturati e preparare gli oggetti per i seguenti workflow di analisi e AI downstream:
- Organizza e cataloga oggetti non organizzati: classifica automaticamente raccolte di documenti PDF (come fatture, estratti conto bancari e moduli fiscali) e immagini. Puoi utilizzare queste classificazioni per creare Data Catalog ricercabili nei tuoi bucket senza scrivere codice personalizzato.
- Fonda gli agenti AI e migliora la ricerca: trasforma i repository di documenti disorganizzati in knowledge base strutturate. Puoi utilizzare le categorie di documenti e le etichette delle immagini per migliorare il recupero durante la Retrieval Augmented Generation (RAG) e fare il grounding delle tue applicazioni di AI generativa.
- Campiona e prepara i dati per l'AI generativa: distingui tra i tipi di documenti per eseguire il campionamento stratificato prima di indirizzare i contenuti ai modelli linguistici di grandi dimensioni (LLM) o alla revisione umana.
- Seleziona i set di dati di addestramento di machine learning: filtra e segmenta immagini e documenti in base alla tassonomia o alle etichette visive per assemblare set di dati di addestramento specifici per il dominio per l'ottimizzazione del modello.
- Scansione di contenuti sensibili o espliciti: esamina automaticamente le immagini caricate per rilevare materiale inappropriato, al fine di supportare le tue norme di moderazione dei contenuti e sicurezza.
- Migliora i prompt multimodali: passa metadati strutturati, come riquadri di delimitazione e categorie di documenti, come contesto quando utilizzi prompt per modelli multimodali come Gemini.
- Semplifica le architetture dei dati: elimina le pipeline di importazione personalizzate e l'infrastruttura di computing generando i metadati direttamente in Cloud Storage.
Esegui query e analizza i metadati
Cloud Storage associa gli arricchimenti degli oggetti direttamente ai tuoi oggetti come contesti degli oggetti. A seconda della scalabilità e del flusso di lavoro, puoi accedere a questi metadati e analizzarli nei seguenti modi:
- Ispeziona singoli oggetti: utilizza la console Cloud de Confiance o le API Cloud Storage per ispezionare gli arricchimenti per oggetti specifici. Per le istruzioni, consulta Gestisci gli arricchimenti degli oggetti.
- Analisi su larga scala con SQL: utilizza i set di dati di Storage Insights per esportare i metadati di milioni o miliardi di oggetti direttamente in BigQuery. Dopo che Storage Insights ha esportato i metadati, puoi eseguire query sulla vista
object_contexts_catalog_viewutilizzando SQL standard. Ad esempio, puoi cercare etichette, filtrare per categoria o trovare oggetti con punteggi di confidenza elevati.
Per iniziare a utilizzare le query SQL e le formule di esempio, consulta Analizza gli arricchimenti degli oggetti in BigQuery.
Considerazioni e limitazioni
Prima di configurare gli arricchimenti degli oggetti, esamina le seguenti considerazioni operative:
Località di elaborazione
Gli enrichment degli oggetti elaborano i dati in tre posizioni geografiche:
us, eu e asia. Quando selezioni una località di elaborazione, tieni presente quanto segue:
- Conformità: assicurati che la località di elaborazione scelta soddisfi i tuoi requisiti normativi e di sovranità dei dati.
- Prestazioni: scegli la località di elaborazione più vicina alla regione di archiviazione del bucket.
- Costo: per evitare addebiti duplicati, configura una sola località di elaborazione per ogni bucket e modello. Se configuri più località per lo stesso bucket e lo stesso modello, Cloud Storage elabora gli oggetti in ogni località e ti addebita ogni esecuzione.
Elaborazione e prestazioni
Esamina i seguenti vincoli relativi ai tipi di contenuti, alle dimensioni degli oggetti e alle tempistiche di elaborazione:
Elaborazione asincrona: Cloud Storage elabora gli oggetti in modo asincrono.
Limite di dimensioni degli oggetti: gli oggetti (sia immagini che PDF) devono avere una dimensione massima di 20 MiB.
Tipi di contenuti supportati: Cloud Storage utilizza il campo dei metadati
Content-Typeimpostato su un oggetto per determinare se valutarlo. Se un oggetto ha unContent-Typenon valido o mancante, Cloud Storage non lo elabora, anche se i dati sottostanti sono un'immagine o un PDF validi. Per assicurarti che Cloud Storage elabori l'oggetto, aggiorna i metadatiContent-Typea uno dei seguenti tipi supportati:- Immagini: BMP, GIF, ICO, JPEG, PNG, TIFF e WEBP.
- Documenti: PDF (
application/pdf).
Funzionalità non supportate
Gli arricchimenti degli oggetti non sono compatibili con i seguenti tipi di bucket e operazioni:
- Rilocalizzazione dei bucket: gli enrichment degli oggetti non sono compatibili con la rilocalizzazione dei bucket. Rimuovi il bucket dalle configurazioni delle funzionalità prima di spostarlo.
Configurazione e gestione dell'ambito
Quando definisci e gestisci i bucket target nelle configurazioni delle funzionalità, si applicano i seguenti requisiti:
- Ambito dei bucket: specifica i nomi esatti dei bucket nella configurazione della funzionalità. Cloud Storage non supporta espressioni regolari o pattern con caratteri jolly.
- Ciclo di vita dei bucket: Cloud Storage non aggiunge automaticamente i bucket appena creati, ricreati o spostati alle configurazioni esistenti. Devi aggiornare la configurazione della funzionalità per includere questi bucket.
Costi e sicurezza
Esamina i seguenti dettagli operativi relativi alle chiavi di crittografia e alle tariffe di accesso ai dati:
- Chiavi fornite dal cliente (CSEK): gli arricchimenti degli oggetti non supportano gli oggetti criptati con chiavi di crittografia fornite dal cliente.
- Accesso allo spazio di archiviazione e Autoclass: per generare i metadati, gli arricchimenti degli oggetti leggono i dati degli oggetti. Queste operazioni di lettura comportano addebiti standard per l'accesso ai dati. Inoltre, se per il bucket è abilitata la funzionalità Autoclass, queste letture attivano le transizioni delle classi di archiviazione.
Prezzi
L'utilizzo degli enrichment degli oggetti comporta addebiti per l'inferenza del modello, l'archiviazione dei metadati, le operazioni di accesso ai dati e il networking. Per saperne di più, consulta i prezzi.
Monitora e risolvi i problemi
Per monitorare l'avanzamento della generazione dei metadati e risolvere i problemi durante la configurazione degli arricchimenti degli oggetti, utilizza le seguenti risorse:
- Monitora le operazioni: per monitorare gli oggetti in attesa, i conteggi delle esecuzioni dei modelli e lo stato di elaborazione in Cloud Monitoring, consulta Monitora le metriche di Enrichment degli oggetti.
- Risolvi i problemi: se mancano gli enrichment o se si verificano errori di autorizzazione, consulta Risoluzione dei problemi relativi agli enrichment degli oggetti.